Aprendizaje Federado y Privacidad: Protección de Datos

Índice de contenidos
- Puntos clave
- Qué es el aprendizaje federado
- Desafíos de la privacidad en el aprendizaje federado
- Técnicas de protección de datos
- Privacidad diferencial
- Agregación segura
- Encriptación homomórfica
- Computación multiparte segura
- Ataques específicos del paradigma federado
- Aplicaciones y futuro
- Conclusión
- Preguntas frecuentes
- ¿El aprendizaje federado garantiza la privacidad de los datos por sí solo?
- ¿Qué diferencia hay entre privacidad diferencial y agregación segura?
- ¿Qué pasa si un participante del entrenamiento federado actúa de mala fe?
- Fuentes
El aprendizaje federado es una técnica de aprendizaje automático distribuido que permite que organizaciones distintas colaboren en la creación de modelos de IA sin compartir sus datos privados. En lugar de centralizar los datos en un servidor común, cada participante entrena localmente un modelo con sus propios datos. Después envía al servidor central únicamente las actualizaciones del modelo (gradientes o pesos), y allí se combinan. Esto preserva la privacidad de los datos en origen mientras permite construir modelos más robustos gracias a la diversidad de los datos distribuidos.
Puntos clave
-
El aprendizaje federado separa los datos del modelo: las organizaciones retienen sus datos localmente y solo comparten actualizaciones del modelo.
-
La privacidad no está garantizada por defecto: las actualizaciones del modelo pueden filtrar información sobre los datos de entrenamiento si no se aplican defensas adicionales.
-
Las principales técnicas de protección son la privacidad diferencial (añadir ruido a los gradientes) y la agregación segura (combinar actualizaciones sin que el servidor vea las individuales).
-
Los ataques de envenenamiento federado son un riesgo específico de este paradigma: participantes maliciosos pueden corromper el modelo global.
-
El aprendizaje federado es compatible con regulaciones como el RGPD porque los datos nunca salen del entorno del propietario.
Qué es el aprendizaje federado
Investigadores de Google formalizaron el aprendizaje federado en un paper de 2016 (publicado en AISTATS 2017). Lo pensaron originalmente para entrenar modelos de predicción de texto en móviles sin enviar el historial de escritura a los servidores. Los autores reportaron una reducción de entre 10 y 100 veces en las rondas de comunicación necesarias frente al SGD sincronizado clásico. El proceso básico es:
-
El servidor central distribuye una versión del modelo global a los participantes.
-
Cada participante entrena localmente el modelo con sus datos.
-
Cada participante envía las actualizaciones (gradientes o diferencias de pesos) al servidor.
-
El servidor agrega las actualizaciones (por defecto mediante FedAvg, Federated Averaging) y actualiza el modelo global.
-
El ciclo se repite hasta que el modelo converge.
Los datos nunca salen del entorno del propietario. Eso hace el paradigma compatible con regulaciones como el RGPD (Reglamento General de Protección de Datos, en vigor en la UE desde el 25 de mayo de 2018). También encaja con los requisitos de soberanía de datos en sectores como salud, finanzas y energía.
Desafíos de la privacidad en el aprendizaje federado
A pesar de que los datos en bruto no se comparten, el aprendizaje federado no garantiza privacidad por defecto. Los riesgos principales son:
-
Ataques de inferencia de gradiente: analizando los gradientes enviados por un participante, un adversario puede reconstruir parcialmente los datos de entrenamiento originales. Esto es especialmente problemático cuando los lotes de entrenamiento son pequeños.
-
Ataques de inferencia de membresía: determinar si un ejemplo específico formó parte del conjunto de entrenamiento de un participante, a partir del comportamiento del modelo.
-
Servidor central no confiable: el servidor que agrega los modelos puede ser comprometido o actuar de forma maliciosa, accediendo a actualizaciones individuales.
Además, los entornos federados presentan heterogeneidad de datos (los conjuntos de datos de los participantes tienen distribuciones distintas) que puede hacer el entrenamiento inestable o ineficiente.
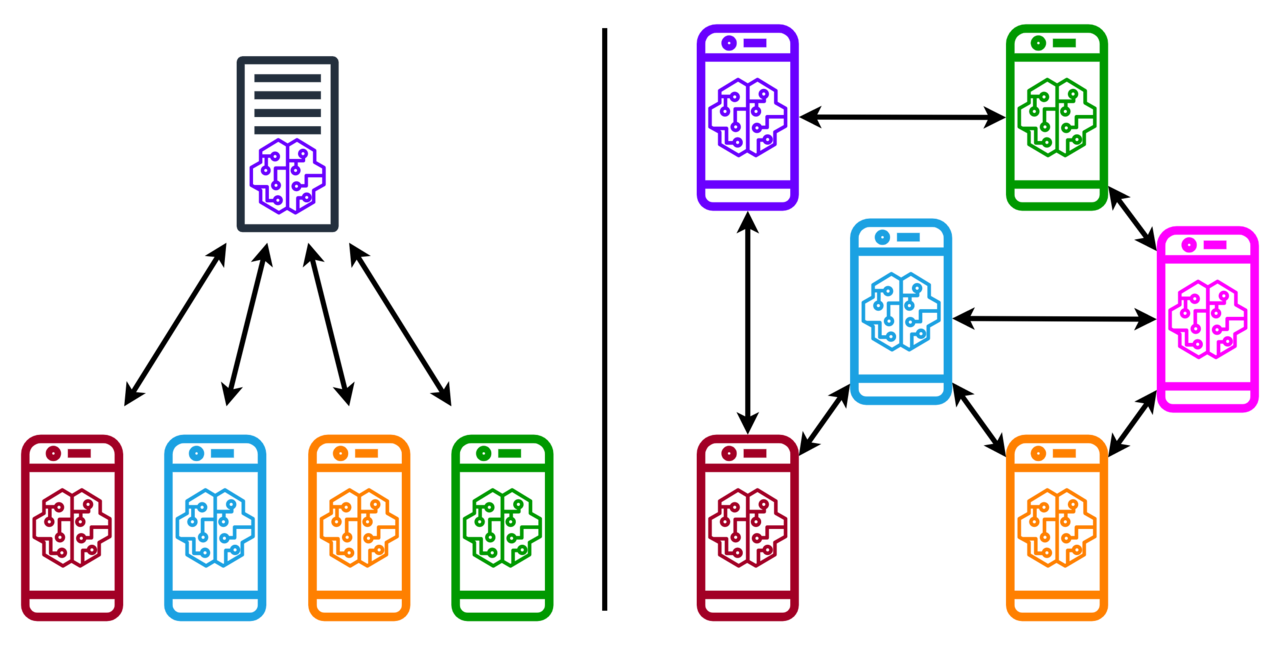 Comparativa de aprendizaje federado centralizado frente a descentralizado: en el centralizado hay un servidor de agregación; en el descentralizado los participantes se coordinan entre sí (Imagen: MarcT0K (icons by JGraph), CC BY-SA 4.0, vía Wikimedia Commons)
Técnicas de protección de datos
Privacidad diferencial
La privacidad diferencial (DP) añade ruido aleatorio calibrado a los gradientes antes de enviarlos al servidor. Así el servidor no puede deducir si un ejemplo específico estuvo en los datos de entrenamiento. El parámetro ε (épsilon) controla la cantidad de privacidad garantizada: cuanto menor es ε, mayor es la privacidad pero menor la utilidad del modelo. La variante DP-SGD (Differentially Private Stochastic Gradient Descent), descrita en 2016 por investigadores de Google en «Deep Learning with Differential Privacy»[1], es la implementación más usada en la práctica.
Agregación segura
La agregación segura (Secure Aggregation) utiliza técnicas criptográficas para que el servidor pueda calcular la suma de las actualizaciones individuales sin ver ninguna de ellas por separado. El servidor solo obtiene el agregado final, no las contribuciones individuales. Esto protege frente a un servidor central curioso o comprometido; el protocolo de referencia se publicó en CCS 2017 bajo el título «Practical Secure Aggregation for Privacy-Preserving Machine Learning»[2].
Encriptación homomórfica
La encriptación homomórfica permite realizar operaciones matemáticas, como la suma de gradientes, directamente sobre datos cifrados, sin desencriptarlos. El resultado desencriptado es equivalente al que se obtendría operando sobre los datos en claro. Su principal limitación práctica es el alto coste computacional, que la hace difícil de escalar a modelos grandes.
Computación multiparte segura
La computación multiparte segura (MPC, Multi-Party Computation) permite que dos o más partes computen juntas una función sobre sus datos combinados sin que ninguna aprenda los datos de las demás. Es más general que la agregación segura y puede combinarse con otras defensas.
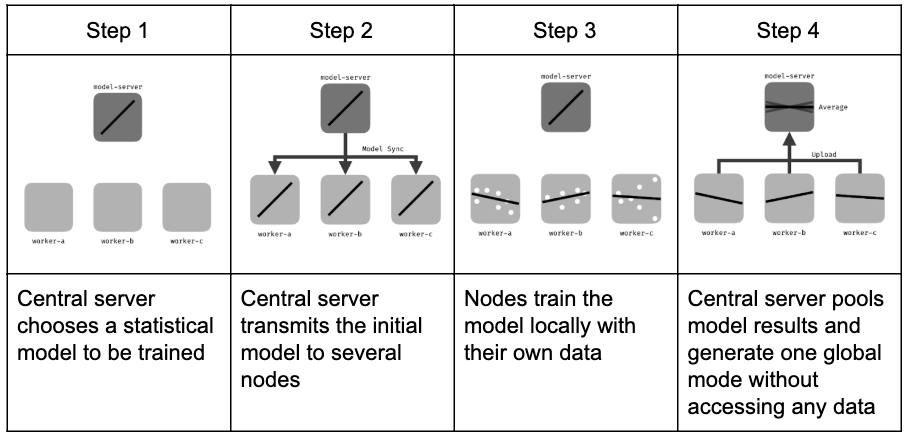 Proceso de aprendizaje federado centralizado: los dispositivos entrenan localmente y envían actualizaciones al servidor central que agrega el modelo global (Imagen: Jeromemetronome, CC BY-SA 4.0, vía Wikimedia Commons)
Ataques específicos del paradigma federado
El aprendizaje federado introduce vectores de ataque que no existen en el entrenamiento centralizado:
-
Envenenamiento federado: un participante malicioso envía actualizaciones falsas diseñadas para degradar el modelo global o insertar comportamientos de puerta trasera. La defensa habitual es la detección de valores atípicos en las actualizaciones (Byzantin-robust aggregation) y el uso de funciones de agregación robustas como RFA o Krum.
-
Free-riding: un participante que envía actualizaciones aleatorias para beneficiarse del modelo global sin contribuir. Detectable con técnicas de verificación de actualizaciones.
Estos riesgos se solapan con los estudiados en el campo del aprendizaje de máquina adversarial, que aborda más ampliamente los ataques sobre sistemas de IA.
Aplicaciones y futuro
El aprendizaje federado tiene aplicaciones consolidadas y emergentes en:
-
Salud: hospitales que entrenan modelos de diagnóstico por imagen compartiendo gradientes, sin exponer historiales de pacientes.
-
Finanzas: detección colaborativa de fraude entre bancos competidores sin revelar transacciones privadas.
-
Móviles y edge computing: Google Gboard, el teclado predictivo de Android, usa aprendizaje federado para mejorar predicciones de texto sin enviar datos al servidor.
-
IoT industrial: sensores de múltiples plantas que entrenan modelos de mantenimiento predictivo sin centralizar datos de producción propietarios, un caso de uso de Industria 4.0.
Para entornos donde los datos visuales son parte del entrenamiento, como sistemas de visión computarizada distribuidos, el aprendizaje federado permite construir modelos de calidad sin exponer imágenes sensibles.
Conclusión
El aprendizaje federado redefine el equilibrio entre utilidad y privacidad en el entrenamiento de modelos de IA: permite colaboración sin centralización de datos. Sin embargo, la privacidad real requiere defensas adicionales (privacidad diferencial, agregación segura o encriptación homomórfica), porque las actualizaciones del modelo por sí solas no garantizan la protección de los datos subyacentes. La combinación de estas técnicas con regulaciones sólidas como el RGPD es el camino hacia una IA colaborativa y responsable.
Versión en inglés: Federated Learning and Privacy: Data Protection.
Fuentes:
- McMahan et al. Communication-Efficient Learning of Deep Networks from Decentralized Data (arXiv, AISTATS 2017)[3]
- Abadi et al. Deep Learning with Differential Privacy (arXiv, 2016)[1]
- Bonawitz et al. Practical Secure Aggregation for Privacy-Preserving Machine Learning (Google Research, CCS 2017)[2]
- Reglamento General de Protección de Datos (RGPD), texto oficial[4]
Preguntas frecuentes
¿El aprendizaje federado garantiza la privacidad de los datos por sí solo?
No. Aunque los datos en bruto nunca salen del entorno del propietario, las actualizaciones del modelo (gradientes o pesos) pueden filtrar información. Un adversario puede reconstruir parcialmente los datos de entrenamiento analizando los gradientes, sobre todo con lotes pequeños; también puede determinar si un ejemplo concreto estuvo en el conjunto de entrenamiento. La privacidad real exige defensas adicionales como privacidad diferencial, agregación segura o encriptación homomórfica.
¿Qué diferencia hay entre privacidad diferencial y agregación segura?
La privacidad diferencial añade ruido aleatorio calibrado a los gradientes antes de enviarlos, controlado por el parámetro ε. Cuanto menor es ε, mayor privacidad pero menor utilidad del modelo. Su variante práctica más usada es DP-SGD. La agregación segura, en cambio, usa criptografía para que el servidor calcule la suma de las actualizaciones sin ver ninguna por separado, lo que protege frente a un servidor central curioso o comprometido.
¿Qué pasa si un participante del entrenamiento federado actúa de mala fe?
Puede envenenar el modelo global enviando actualizaciones falsas diseñadas para degradarlo o insertar una puerta trasera, o practicar free-riding: mandar actualizaciones aleatorias para beneficiarse del modelo sin contribuir. La defensa habitual contra el envenenamiento es detectar valores atípicos en las actualizaciones (agregación robusta a fallos bizantinos) con funciones como RFA o Krum. El free-riding se detecta con técnicas de verificación de actualizaciones.