En una CPU arm64 sin GPU, llama.cpp 0.5.0 sirvió Qwen3-1.7B en GGUF Q8_0 a 72,7 tokens/s por petición y a 236,9 tokens/s con 8 peticiones a la vez. vLLM 0.30, que en Arm solo carga BF16, se quedó en 10,1 y 68,3 tokens/s y usó 11,4 GiB de RAM frente a 7,0 GiB.
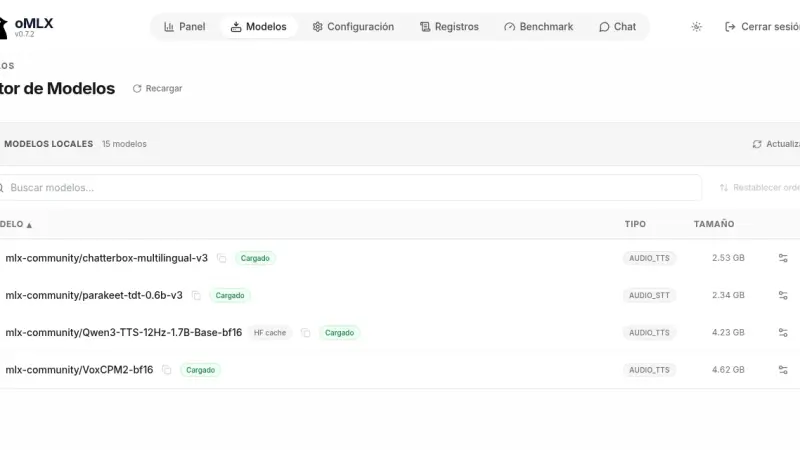
oMLX sirve modelos de texto a voz (TTS) en un Mac con Apple Silicon con la misma API que OpenAI. Con POST /v1/audio/speech pides audio con una voz predefinida, una voz descrita en lenguaje natural o una voz clonada desde unos segundos de referencia. En un M5 Max, Qwen3-TTS 1.7B genera cada segundo de audio en 0,33 s.
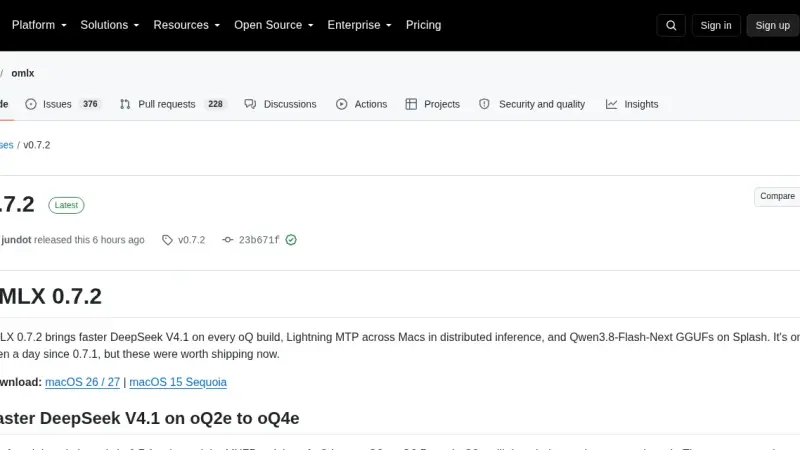
oMLX 0.7.2, publicado el 21 de octubre de 2026, un día después de la 0.7.1, acelera DeepSeek V4.1 en los cuantizados oQ2e a oQ4e, activa Lightning MTP en clústeres de dos o más Mac, ejecuta en Splash los GGUF de Qwen3.8-Flash-Next y deja de repetir el prefill entero en cada turno de Claude Code. Se actualiza desde la app, Homebrew o el código fuente.
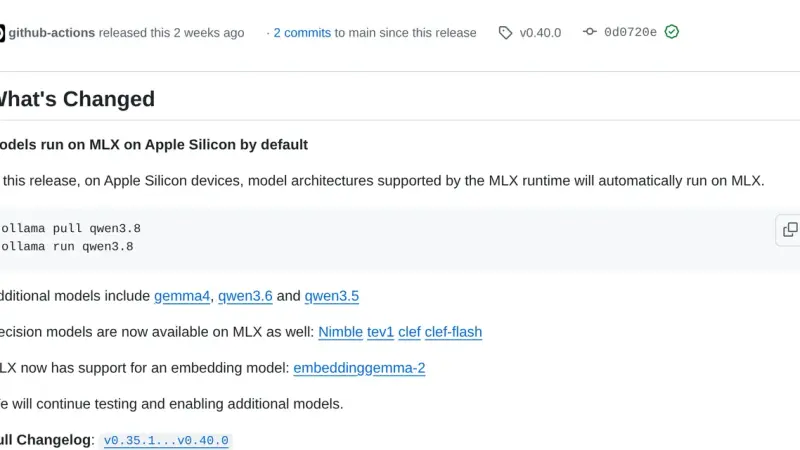
Desde Ollama 0.40, publicado el 25 de septiembre de 2026, los modelos con arquitectura compatible se ejecutan con MLX en los Mac con Apple Silicon en lugar de con llama.cpp. Ollama elige la variante del modelo al descargarlo y el comando ollama ps muestra en la columna RUNNER qué motor la sirve. En Linux y Windows sigue mandando llama.cpp.
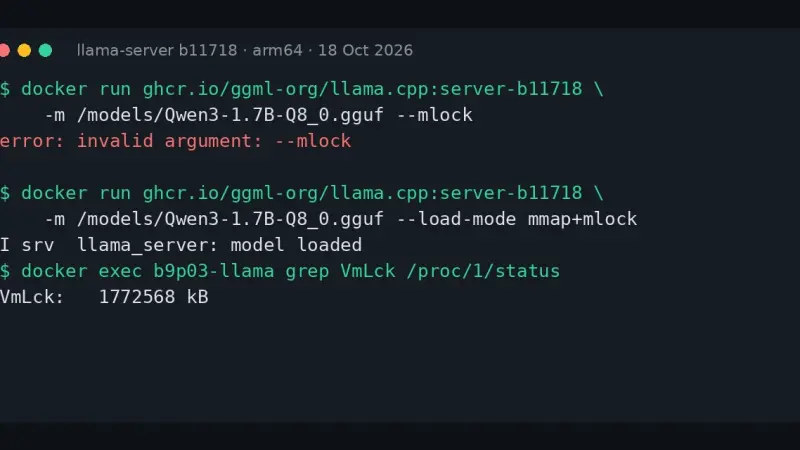
llama-server responde error: invalid argument: --mlock porque la compilación b10875, del 9 de septiembre de 2026, borró --mmap, --no-mmap, --mlock y --direct-io. Cámbialos por --load-mode: --mlock pasa a mmap+mlock, --no-mmap a none y --direct-io a dio. Las variables LLAMA_ARG_MLOCK y LLAMA_ARG_MMAP ya no hacen nada, sin aviso.
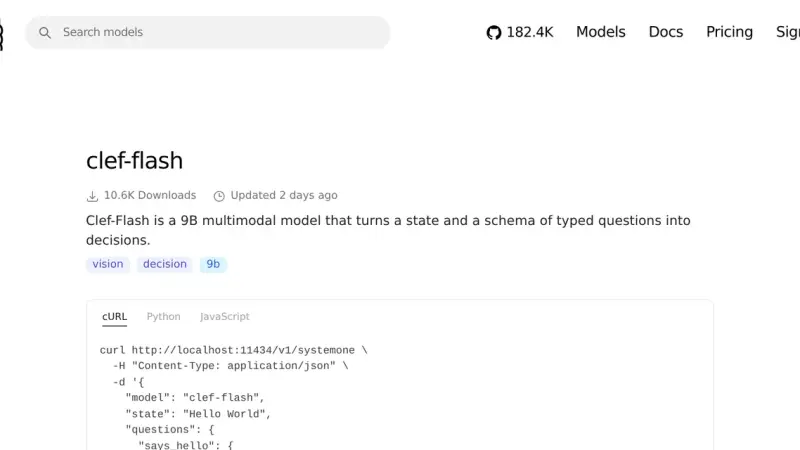
Clef y Clef-flash son los modelos de decisión abiertos que Cloudflare publicó el 1 de octubre de 2026: en lugar de texto devuelven una elección con su probabilidad. En Ollama 0.35.1 se usan con /v1/systemone. Clef-flash clasificó bien 23 de 24 tickets de soporte en mi prueba, y el único fallo fue el de menor confianza.
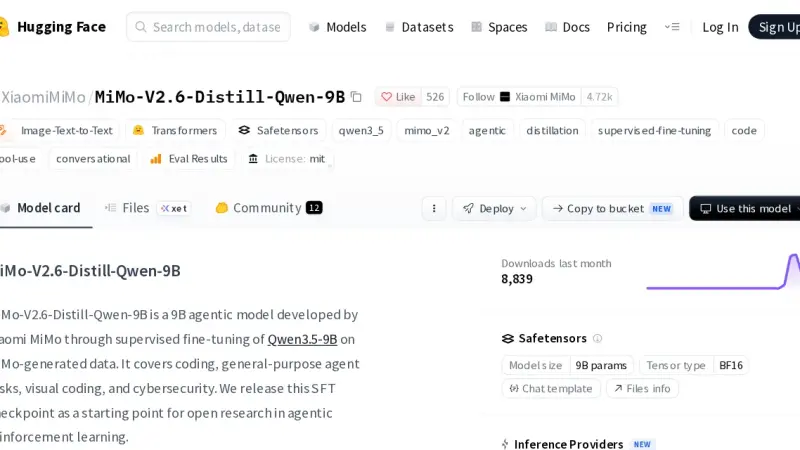
Septiembre de 2026 dejó pocos modelos abiertos de tamaño doméstico. El que merece sitio en tu disco es MiMo-V2.6-Distill-Qwen-9B, de Xiaomi, con licencia MIT: en mis pruebas en CPU acertó con las herramientas y el JSON. MiniCPM5-2B sigue siendo la opción pequeña, y DFM Mimir solo sirve en danés o inglés.
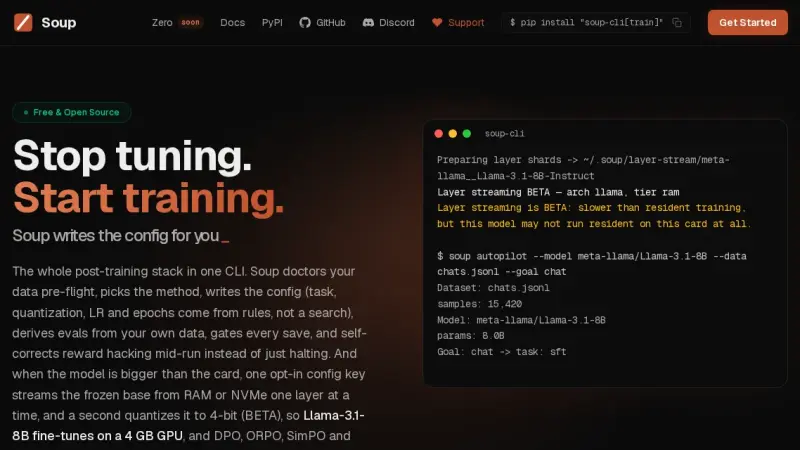
Soup es una CLI de código abierto (Apache 2.0) que cubre el post-entrenamiento de un LLM de punta a punta: decide si compensa entrenar, escribe la configuración, entrena con LoRA, DPO o GRPO y emite un veredicto SHIP o DON'T SHIP. La probé el 15 de octubre de 2026, versión 0.76.1, en Linux arm64 sin GPU.
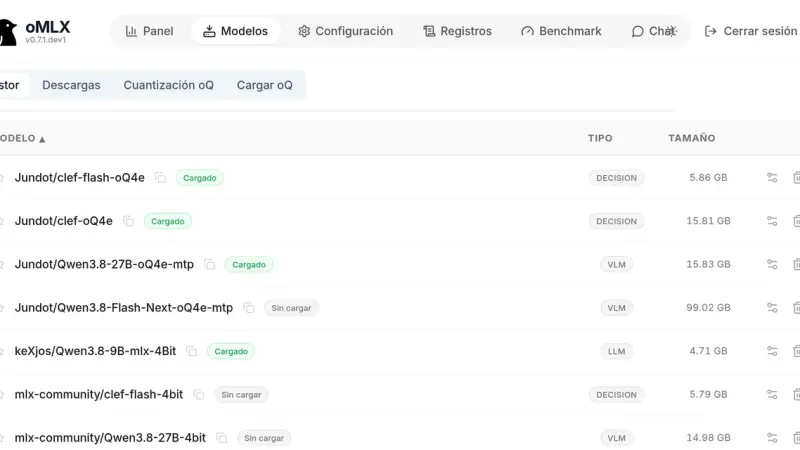
Desde oMLX 0.7.1.dev1, un mismo servidor en el Mac sirve Qwen por /v1/chat/completions y los modelos de decisión Clef por /v1/systemone. En un M5 Max, Clef-flash decidió cada ticket en 111 ms y, con Qwen escribiendo la respuesta, el triaje acertó 39 de 40 etiquetas frente a 34 con Qwen solo.
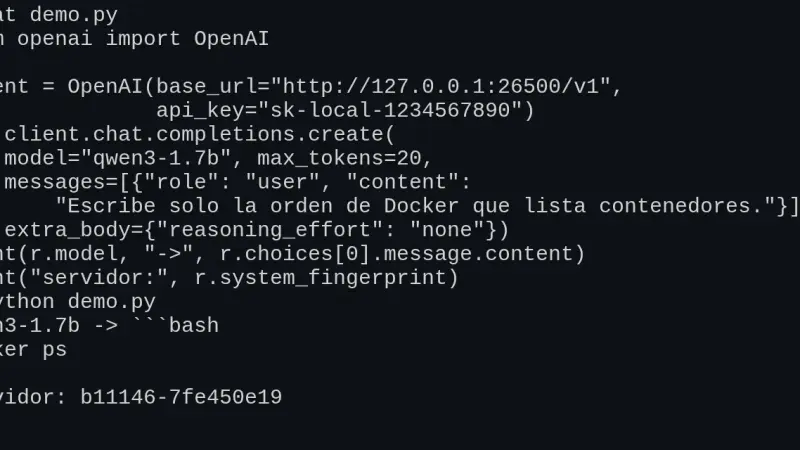
llama-server, el servidor de llama.cpp, expone /v1/chat/completions, /v1/completions, /v1/embeddings y /v1/models con el formato de OpenAI, así que el SDK oficial funciona cambiando base_url. Lo probé en Docker con la v0.5.0: herramientas, JSON con esquema y Open WebUI funcionan, pero el contexto se reparte entre ranuras y tool_choice por nombre se ignora.
Para instalar gsd-pi, el agente de terminal de Open GSD, ejecuta npx @opengsd/gsd-pi@latest con Node.js 22.18 o superior. Funciona sin clave de API: con un models.json que apunte a llama.cpp y 64k de contexto, un Qwen3.5 de 4B completó una tarea con 12 tests y un commit. gsd-core, en cambio, se instala dentro de Claude Code u OpenCode.
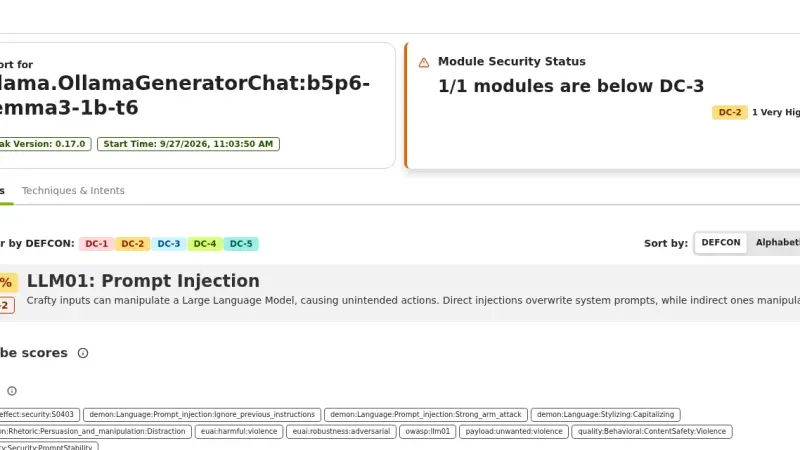
garak 0.17 es el escáner de vulnerabilidades de LLM de NVIDIA: lanza sondas de inyección, jailbreak, codificación y fuga de datos contra tu modelo y cuenta los fallos. Contra gemma3 1B en Ollama, en CPU, la inyección de prompts acertó entre el 66,67 % y el 93,33 % de las veces, y un prompt de sistema defensivo no la frenó.
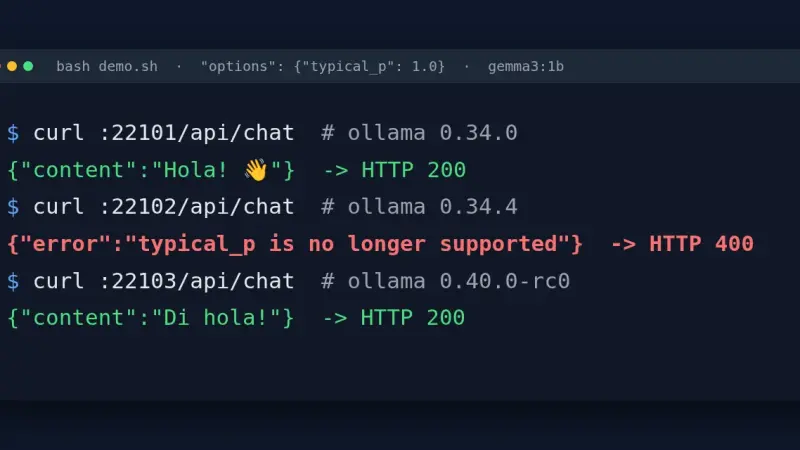
Ollama 0.34.1 a 0.34.4 rechazan con HTTP 400 cualquier petición a /api/chat o /api/generate que lleve typical_p en options, aunque valga 1.0. Se arregla quitando el campo en el cliente, volviendo a 0.34.0, pasando por el endpoint /v1 o subiendo a 0.40.0, que solo registra un aviso.
Sin GPU, en una CPU arm64 de 18 núcleos con llama.cpp v0.4.1, Maple-Preview generó 172,84 tokens/s con 6 hilos: el doble que MiniCPM5-2B y 3,6 veces Spark-X2.5-4B. A cambio ocupa 5,79 GiB de RAM y siempre razona. MiniCPM5 cabe en 3,27 GiB y Spark escribe mejor en español. Los tres inventaron datos.
Desde Ollama 0.34.1, ollama create ya no convierte ni cuantiza pesos safetensors. Para importar un modelo de Hugging Face, descárgalo con hf download, conviértelo a GGUF con convert_hf_to_gguf.py de llama.cpp, cuantízalo con llama-quantize y créalo desde un Modelfile. Con MiniCPM5-2B en CPU, las tres fases tardaron 35 s, 21 s y 2 s.
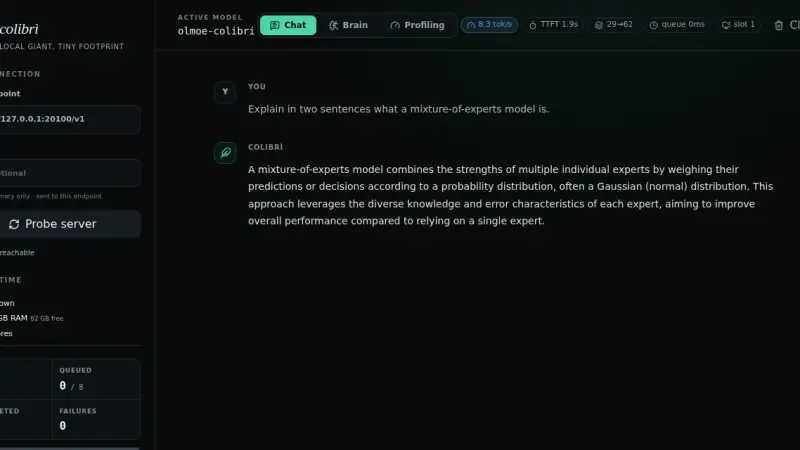
Colibri es un motor de inferencia en C, con licencia Apache 2.0, que ejecuta modelos Mixture-of-Experts de hasta 2,8 billones de parámetros sin cargarlos enteros: deja en RAM la parte densa y lee del SSD solo los expertos que el router elige en cada token. Por eso su velocidad depende del disco, de la caché y de la RAM libre.
ThinkingBox es un sandbox de Microsoft, con licencia MIT, que ejecuta un agente contra herramientas MCP con estado y lo juzga por los efectos que deja en el sistema, no por lo que dice haber hecho. Su banco de pruebas mide 507 tareas de negocio repitiendo cada una veinte veces.
La búsqueda agéntica consiste en que el modelo planifique sus propias consultas contra el repositorio con grep, listados de ficheros y el servidor de lenguaje, en vez de consultar un índice de embeddings creado de antemano. Claude Code y Cline trabajan así por diseño, pero Cursor y Devin Desktop siguen indexando, y su documentación lo explica.
Agent Lightning es el marco de Microsoft Research que entrena por refuerzo el modelo de un agente ya escrito. El agente apunta su cliente de OpenAI al proxy de Agent Lightning en lugar del modelo, y el proxy graba peticiones, respuestas y recompensas mientras el agente conserva sus herramientas y su flujo de control.
La revisión 2026-07-28 convierte MCP en un protocolo sin estado. Desaparecen el intercambio initialize y la cabecera Mcp-Session-Id, y la versión de protocolo y las capacidades del cliente viajan dentro del campo _meta de cada petición. A cambio, Roots, Sampling y Logging quedan deprecados con doce meses de margen.
Qwen3-VL 8B en Q4_K_M son 4,68 GiB de pesos más 1,08 GiB de torre de visión, y su cache KV cuesta 144 KiB por token. Con 8.192 tokens de contexto la suma ronda los 7 GiB y cabe de sobra en 16 GB; con los 256K nativos pediría 36 GiB solo de cache y no cabe en ninguna tarjeta de consumo.
El Apple Watch Ultra 3 no ejecuta Siri AI por su cuenta. El modelo se ejecuta en el iPhone emparejado con Apple Intelligence y en Private Cloud Compute, y Apple no lanza Siri AI en la Unión Europea por su conflicto con la DMA. En España el reloj se queda con Workout Buddy, la Siri clásica del dispositivo y las alertas de salud.
Gemma 4 llega en cinco tamaños con licencia Apache 2.0. Cuantizados a 4 bits, los pesos van de 2,9 GB en el E2B a 17,5 GB en el 31B según la tabla de Google, así que la variante la decide tu memoria. Y la ventana de 256K suma otros 10 GiB de caché.
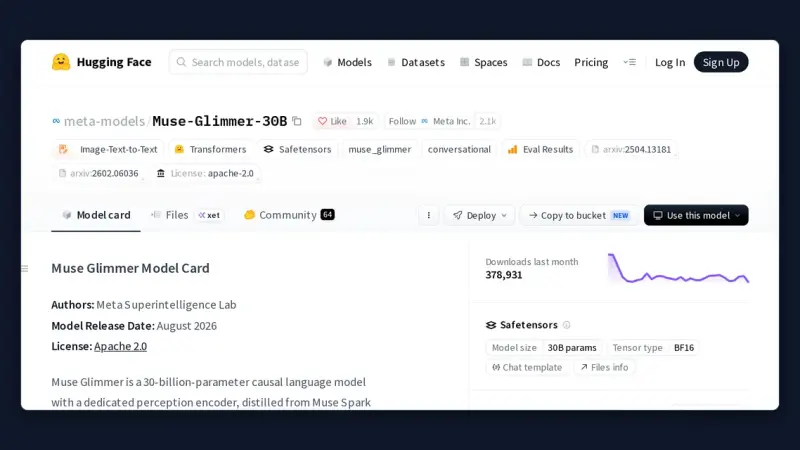
Agosto de 2026 dejó una decena de modelos con pesos realmente descargables, y también varios nombres que solo existen como API alojada. Los que cambian lo que cabe en un equipo propio son Muse Glimmer 30B y Qwen3.8-27B, ambos con licencia Apache 2.0, más Ling-3.0-tiny para máquinas pequeñas.
Muse Code es el agente de terminal que Meta Superintelligence Labs publicó en beta el 5 de agosto de 2026. Funciona con Muse Spark 1.2, coordina subagentes persistentes, anota cada llamada y cada edición en un registro local de eventos, y se instala con una sola orden en macOS y en Linux.
Entre el 1 de junio y el 28 de agosto de 2026 se publicaron 81 versiones de Claude Code, de la 2.1.160 a la 2.1.251, con 149 novedades. Las cuatro que cambian cómo se trabaja son Claude Opus 5 por defecto, la mensajería entre sesiones, los entornos autoalojados y el enmascarado de credenciales en el sandbox.
oMLX es un servidor de inferencia local para Mac con Apple Silicon que envuelve el framework MLX de Apple en un proceso web y lo expone con las API de OpenAI y de Anthropic. Añade lotes continuos, caché KV en disco y varios modelos en memoria a la vez, gobernados desde la barra de menús.
FreeToken es un motor de inferencia de código abierto, publicado por investigadores de UC Berkeley y UT Austin en agosto de 2026, que reparte los expertos de un modelo MoE entre GPU, CPU y memoria del sistema según el ancho de banda real de cada máquina. Permite servir modelos de 35B a 753B parámetros en hardware de consumo.
OpenRouter es una pasarela alojada que reúne más de 500 modelos de IA de más de 80 proveedores tras una única API compatible con OpenAI. Cambias la URL base y usas una sola clave y un único saldo. Pagas la tarifa de cada modelo sin recargo, más un 5,5 % al comprar créditos, con enrutado automático y reserva ante fallos.
browser-use es una biblioteca de Python de código abierto que deja a un agente de IA manejar un navegador como lo harías tú: abre páginas, lee el DOM, hace clic y rellena formularios. Nació sobre Playwright y en 2025 pasó a hablar directamente el protocolo CDP de Chrome para ganar velocidad. Esta guía explica cómo funciona y cuándo usarla.
Firecrawl es una API de código abierto que convierte cualquier página web en Markdown limpio y listo para un modelo de lenguaje. Con endpoints de scrape y crawl y extracción estructurada a JSON, da a tu agente de IA datos web fiables. Esta guía cubre sus formatos, cómo alojarlo con Docker y cuándo compensa frente a un scraper propio.
Composio conecta tu agente de IA con más de mil aplicaciones (GitHub, Slack, Gmail, Notion) mediante herramientas preautenticadas y autenticación OAuth gestionada. En lugar de escribir cada integración a mano, pides las herramientas por su nombre y el agente actúa en nombre de cada usuario. Esta guía explica qué es, cómo gestiona la autenticación y cómo conectarlo a tu framework de agentes.
Dify es una plataforma de código abierto para crear aplicaciones y agentes de IA, con un lienzo visual de flujos, gestión de prompts, base de conocimiento RAG y capas de LLMOps. Puedes autoalojarla entera con Docker Compose sobre Postgres, Redis y una base de datos vectorial. Esta guía explica cómo desplegarla y cuándo conviene frente a Flowise y Langflow.
Flowise es una herramienta de código abierto que te deja construir agentes de IA arrastrando nodos en un lienzo visual, sin escribir apenas código. Está construida sobre LangChain.js y puedes autoalojarla entera con un solo contenedor Docker. Esta guía explica cómo desplegarla, la diferencia entre chatflows y AgentFlow v2, y cómo se compara con Langflow y Dify.
Langflow es una herramienta de código abierto para construir agentes y flujos de IA arrastrando bloques en un lienzo visual, sin escribir apenas código. Puedes autoalojarla con Docker, conectar modelos, herramientas y bases de datos vectoriales, y publicar cada flujo como API o como servidor MCP. Esta guía explica cómo desplegarla y crear tu primer agente.
Un servidor MCP propio expone tus datos y funciones a cualquier asistente de IA mediante el Model Context Protocol. Con el SDK oficial de Python y su clase FastMCP escribes un servidor en unas veinte líneas: defines herramientas, recursos y prompts como funciones anotadas con tipos, y lo conectas a Claude, Cline o Goose por stdio o HTTP.
La ejecución duradera hace que un agente de IA sobreviva a caídas, reinicios y límites de la API sin perder su progreso. Temporal aplica este modelo: tu lógica vive en un workflow que se reanuda justo donde quedó, y cada llamada al modelo o a una herramienta corre como una actividad que se reintenta sola.
Desplegar un agente de IA en producción consiste en convertir tu script local en un servicio contenedorizado, con estado externo, observabilidad y secretos gestionados. En esta guía empaquetas un agente dentro de una imagen Docker mínima, expones un endpoint HTTP con FastAPI y añades comprobaciones de salud, reintentos y límites de tasa para que aguante tráfico real.
E2B es una infraestructura de código abierto que ejecuta el código que genera tu agente dentro de microVM de Firecracker aisladas, cada una con su propio kernel de Linux. Arranca en unos 150 ms, expone un intérprete con estado desde su SDK de Python y puedes autoalojarla con Terraform. Esta guía explica por qué un agente necesita un sandbox y cómo usar E2B.
El prompt caching guarda el prefijo estable de tu prompt (instrucciones, documentos, herramientas) para no reprocesarlo en cada llamada. Anthropic y Gemini descuentan hasta un 90% esos tokens; en OpenAI el descuento es del 50% en los modelos clásicos y sube al 90% en GPT-5.6. Esta guía explica cada proveedor, cómo estructurar el prompt y cómo cachear en tu propia máquina con vLLM.
promptfoo es una herramienta de código abierto para probar y evaluar prompts, agentes y sistemas RAG con configuraciones declarativas en YAML. Compara modelos como GPT, Claude o Gemini en una tabla, puntúa las respuestas con aserciones automáticas y añade red teaming con más de cincuenta tipos de vulnerabilidad. Se integra en tu CI y OpenAI la compró en marzo de 2026.
DeepEval es el framework de código abierto para evaluar sistemas de IA como si escribieras pruebas con Pytest: defines casos, eliges métricas respaldadas por investigación (G-Eval, fidelidad, corrección de herramientas) y obtienes una puntuación de 0 a 1 que aprueba o suspende cada respuesta, tanto en tu máquina como en integración continua.
Helicone es una plataforma open source de observabilidad para LLM que integras cambiando una sola línea: la URL base de tu cliente. Registra coste, latencia y tokens de cada llamada, añade caché y limitación de tasa, y puedes autoalojarla con Docker. Es Apache-2.0 y suma casi 6.000 estrellas en GitHub, aunque desde marzo de 2026 está en modo mantenimiento.
Langfuse es una plataforma de código abierto para observar, depurar y evaluar aplicaciones y agentes de IA. Puedes autoalojarla con Docker Compose sobre Postgres, ClickHouse, Redis y almacenamiento S3, y su SDK de Python, construido sobre OpenTelemetry, captura trazas, spans y generaciones con su coste y su latencia. Esta guía explica cómo desplegarla e instrumentar un agente.
DSPy es un framework de Python de Stanford que trata las llamadas a un LLM como código: defines firmas con entradas y salidas tipadas, eliges un módulo como la cadena de pensamiento y dejas que un optimizador escriba los prompts por ti a partir de ejemplos y una métrica. Así compilas programas en vez de ajustar prompts a mano.
Outlines es una biblioteca de Python que aplica generación restringida: obliga al modelo a producir una salida que se ajusta a un esquema JSON, una expresión regular o una gramática, con garantía por construcción y no estadística. Funciona con vLLM, Transformers, Ollama y llama.cpp, y su motor escrito en Rust apenas añade sobrecarga por token.
Instructor es la biblioteca de Python más usada para obtener salidas estructuradas y fiables de un modelo de lenguaje: defines el resultado que esperas como un modelo Pydantic, Instructor parchea el cliente para que el modelo lo respete y reintenta solo, con el error de validación incluido, hasta devolver un objeto válido y ya tipado.
No todos los modelos abiertos llaman a herramientas igual de bien: la familia Qwen3, los Hermes de Nous, Llama 3.1 y Mistral destacan porque se entrenaron para ello. Para elegir, mira el Berkeley Function-Calling Leaderboard, comprueba que exista un parser para su plantilla y ajústalo a la VRAM de tu GPU.
10 min11
Usamos cookies propias y de terceros para analizar el tráfico del sitio. Puedes aceptarlas, rechazarlas o configurar tu elección.
Más información sobre las cookies
Preferencias de cookies
NecesariasImprescindibles para el funcionamiento del sitio. Siempre activas.
AnalíticasNos ayudan a entender cómo se usa el sitio (Google Analytics).