Cerebras-GPT: 7 Modelos LLM Open-Source listos para su uso

Índice de contenidos
- Puntos clave
- Los 7 modelos de Cerebras-GPT
- El hardware detrás: CS-2 y el chip WSE-2
- Características técnicas y rendimiento
- Usos prácticos de Cerebras-GPT
- Limitaciones conocidas
- Cerebras-GPT en el ecosistema open-source de LLMs
- Conclusión
- Preguntas frecuentes
- ¿Puedo usar Cerebras-GPT en español?
- ¿Qué modelo de Cerebras-GPT puedo ejecutar en hardware convencional?
- ¿Con qué licencia se publican los pesos y para qué se pueden usar?
- Fuentes
Cerebras-GPT demostró que el hardware especializado puede cambiar la ecuación del entrenamiento de modelos de lenguaje grandes. Mientras la comunidad debatía si los LLM open-source podían alcanzar el rendimiento de los propietarios, Cerebras Systems publicó una familia completa de siete modelos. Van desde 111M de parámetros hasta 13B, y se entrenaron de forma eficiente en sus procesadores CS-2.
Puntos clave
-
Cerebras-GPT es una familia de 7 modelos de lenguaje open-source, disponibles en Hugging Face y GitHub.
-
Los modelos van de 111 millones a 13.000 millones de parámetros, todos entrenados con la misma metodología escalable.
-
El hardware Cerebras CS-2 permite entrenar modelos grandes sin la fragmentación de modelo que requieren las GPUs convencionales.
-
Los modelos siguen la arquitectura GPT-3 estándar y son compatibles con el ecosistema Hugging Face.
-
Limitación conocida al lanzamiento: entrenados solo en inglés sobre el dataset Pile.
Los 7 modelos de Cerebras-GPT
Cerebras Systems[1] publicó los siguientes modelos en Hugging Face:
| Modelo | Parámetros | Capas | Heads de atención |
|---|---|---|---|
| Cerebras-GPT-111M | 111 millones | 10 | 10 |
| Cerebras-GPT-256M | 256 millones | 14 | 16 |
| Cerebras-GPT-590M | 590 millones | 18 | 16 |
| Cerebras-GPT-1.3B | 1.300 millones | 24 | 16 |
| Cerebras-GPT-2.7B | 2.700 millones | 32 | 32 |
| Cerebras-GPT-6.7B | 6.700 millones | 32 | 32 |
| Cerebras-GPT-13B | 13.000 millones | 40 | 40 |
Todos los modelos pueden descargarse desde:
-
Hugging Face[2]: organización oficial de Cerebras.
-
GitHub[3]: repositorio Cerebras Model Zoo.
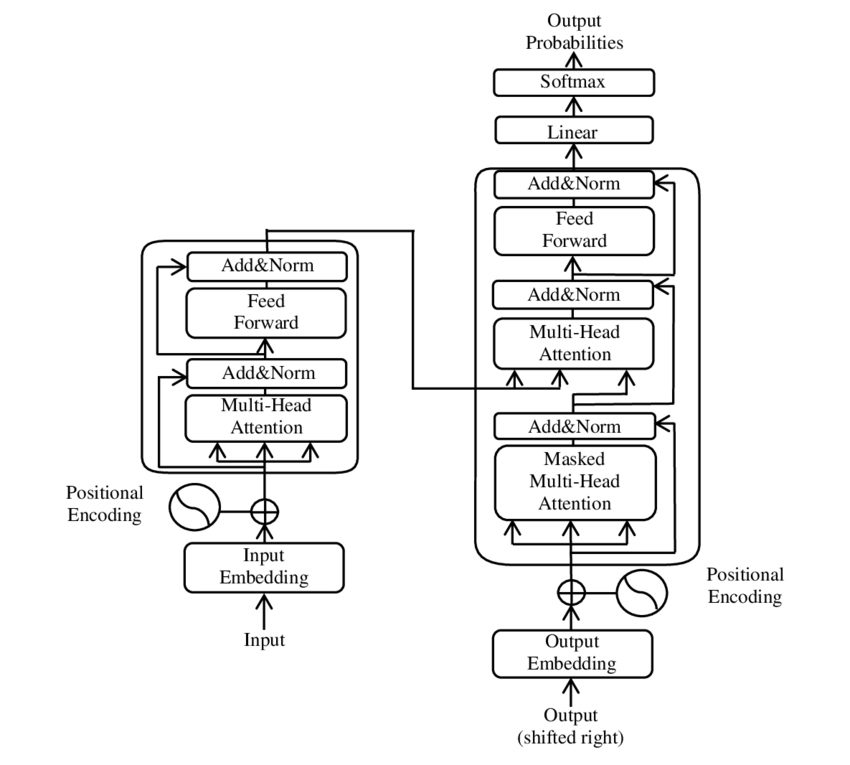 Arquitectura Transformer estándar con codificador-decodificador, mecanismo de atención y capas feed-forward usada por Cerebras-GPT (Imagen: Yuening Jia, CC BY-SA 3.0, vía Wikimedia Commons)
El hardware detrás: CS-2 y el chip WSE-2
La propuesta de Cerebras no se limita al modelo: incluye también la infraestructura de entrenamiento. El chip Wafer-Scale Engine 2 (WSE-2) es el procesador de IA más grande jamás fabricado en un único die de silicio. Reúne 2,6 billones de transistores y 850.000 núcleos de IA en un solo chip del tamaño de una oblea de fabricación.
Esta arquitectura resuelve un problema fundamental del entrenamiento de LLMs en GPUs. Entrenar en GPUs obliga a fragmentar el modelo en múltiples dispositivos (model parallelism) y a gestionar la comunicación entre ellos, que se convierte en cuello de botella a escala. El WSE-2 puede alojar modelos completos de miles de millones de parámetros en un único chip, eliminando esa fricción.
El resultado es que Cerebras-GPT puede escalar el entrenamiento de forma casi lineal al aumentar el tamaño del modelo. Las curvas de scaling law publicadas junto con los modelos lo reflejan.
Características técnicas y rendimiento
Cerebras-GPT sigue la arquitectura GPT-3 estándar (transformer decoder-only) con:
-
Tokenizador BPE compatible con GPT-2.
-
Longitud de contexto de 2048 tokens.
-
Entrenamiento en el dataset Pile (825 GB de texto en inglés de fuentes heterogéneas).
-
Hiperparámetros de entrenamiento publicados en el paper oficial[4].
Cerebras-GPT se evaluó en los benchmarks estándar de LLMs: HellaSwag, PIQA, Winogrande y ARC. Ahí muestra que un modelo de 6.7B bien entrenado puede igualar o superar a modelos propietarios más grandes en ciertas tareas. Esto valida la hipótesis de los autores: la eficiencia del entrenamiento importa tanto como el tamaño del modelo.
Usos prácticos de Cerebras-GPT
Al ser modelos open-source con pesos publicados bajo licencia Apache 2.0, Cerebras-GPT puede usarse para:
-
Fine-tuning supervisado: adaptar el modelo base a un dominio específico (legal, médico, código, soporte al cliente) con conjuntos de datos propios.
-
Investigación de NLP: estudiar el comportamiento de los modelos a diferentes escalas usando la misma familia.
-
Inferencia local: ejecutar modelos pequeños (111M-590M) en hardware convencional para aplicaciones con requisitos de privacidad o latencia estrictos.
-
Comparativas de scaling: la publicación simultánea de 7 tamaños con la misma metodología facilita el estudio de las leyes de escalado.
Para contexto más amplio sobre el ecosistema de LLMs y modelos preentrenados, ver modelos preentrenados en IA y avances en NLP. Para herramientas de asistencia de código basadas en LLMs, ver GitHub Copilot.
Limitaciones conocidas
Idioma: todos los modelos están entrenados exclusivamente en inglés. No tienen capacidad de comprensión o generación en español ni otros idiomas.
Dataset de entrenamiento: el Pile incluye texto de internet, libros y código, pero con los sesgos inherentes a ese tipo de datos. Los modelos pueden reproducir estereotipos o información inexacta presente en el dataset.
Alineación: los modelos base no están alineados con instrucciones humanas (RLHF). Para uso en producción como asistentes conversacionales, requieren fine-tuning con técnicas de alineación adicionales.
Ventana de contexto: los 2048 tokens bastan para prompts cortos, pero limitan las aplicaciones que requieren procesar documentos largos. Los modelos posteriores (Claude, GPT-4, Gemini) llegan a ventanas de contexto mucho mayores.
Cerebras-GPT en el ecosistema open-source de LLMs
La publicación de Cerebras-GPT en 2023 coincidió con una oleada de modelos open-source que cambió el mercado de los LLM: LLaMA de Meta, Falcon del Technology Innovation Institute, MPT de MosaicML. Todos comparten la misma motivación: hacer accesible la investigación y el desarrollo con LLMs sin depender de APIs propietarias.
Esta tendencia conecta directamente con el desarrollo de aplicaciones que aprovechan modelos abiertos para tareas de desarrollo con GitHub Codespaces o análisis de datos avanzado.
Este artículo también está disponible en inglés: Cerebras-GPT: 7 Open-Source LLM Models Ready to Use.
Conclusión
Cerebras-GPT aportó dos cosas valiosas al ecosistema de IA: modelos open-source de calidad y evidencia de que el hardware alternativo a las GPUs puede cambiar la eficiencia del entrenamiento. Para equipos que necesitan LLMs controlables, auditables y ajustables sin depender de APIs externas, esta familia de modelos, junto con las que vinieron después, representa una alternativa real. El futuro de los LLMs no pasa solo por hacerlos más grandes sino por hacerlos más eficientes, y Cerebras demostró que hay más de un camino para lograrlo.
Fuentes:
Preguntas frecuentes
¿Puedo usar Cerebras-GPT en español?
No. Los siete modelos están entrenados exclusivamente en inglés sobre el dataset Pile (825 GB de texto), y no tienen capacidad de comprensión ni generación en español u otros idiomas. Además, los modelos base no están alineados con instrucciones humanas (RLHF), así que para usarlos como asistentes conversacionales en producción hace falta fine-tuning con técnicas de alineación adicionales.
¿Qué modelo de Cerebras-GPT puedo ejecutar en hardware convencional?
Los tamaños pequeños, de 111M a 590M parámetros (Cerebras-GPT-111M, 256M y 590M), están pensados para inferencia local en hardware convencional en aplicaciones con requisitos estrictos de privacidad o latencia. La familia completa llega hasta 13B parámetros, todos con arquitectura GPT-3 decoder-only, tokenizador BPE compatible con GPT-2 y contexto de 2048 tokens. Se descargan desde Hugging Face y el repositorio Cerebras Model Zoo en GitHub.
¿Con qué licencia se publican los pesos y para qué se pueden usar?
Los pesos se publican bajo licencia Apache 2.0. Eso permite fine-tuning supervisado a dominios específicos (legal, médico, código, soporte al cliente), investigación de NLP a distintas escalas e inferencia local. Y como los 7 tamaños comparten la misma metodología, sirven para comparar leyes de escalado. La ventana de 2048 tokens limita el procesamiento de documentos largos frente a modelos posteriores.