La función lineal como función de activación
Índice de contenidos
- Puntos clave
- ¿Qué es la función lineal de activación?
- Fórmula, derivada y rango
- ¿Por qué no sirve en las capas ocultas?
- ¿Cuándo conviene usar la función lineal?
- La relación entre la función lineal y ReLU
- Cómo se escribe en PyTorch y en Keras
- La salida lineal y los valores atípicos
- Preguntas frecuentes
- ¿Por qué no se usa la función lineal en las capas ocultas?
- ¿Qué diferencia hay entre la función lineal y la función identidad?
- ¿La función lineal sufre el problema del gradiente desvanecido?
- Conclusión
- Fuentes
La función lineal de activación es f(x) = ax + b y, en la forma que usan las redes, la identidad f(x) = x: la neurona entrega su suma ponderada tal cual. Tiene derivada constante y un rango sin límites, y por eso es la activación estándar de la capa de salida en regresión. En las capas ocultas no aporta nada, porque dos capas lineales seguidas equivalen a una sola. Esta guía explica las dos cosas con la fórmula, una comprobación en código y los casos en los que sí conviene. La misma explicación está disponible en inglés.
Puntos clave
- La función lineal de activación es
f(x) = ax + b; cona = 1yb = 0es la identidadf(x) = x, la forma que usan PyTorch y Keras. - Su derivada es la constante
a: el gradiente que atraviesa la capa no se satura ni se desvanece. - Componer capas lineales da otra capa lineal:
W₂(W₁x + b₁) + b₂ = W'x + b', así que la profundidad no añade capacidad. - Es la activación correcta en la salida de una regresión, donde el valor a predecir puede ser cualquier número real.
- También aparece dentro de arquitecturas modernas: las proyecciones de consulta, clave y valor de un transformer son capas lineales sin activación.
¿Qué es la función lineal de activación?
La función lineal es la función de activación que no transforma nada. Una neurona calcula primero la suma ponderada z = Wx + b (explicada en pesos, sesgos y la suma ponderada) y después aplica a = f(z). Con la función lineal, a es z multiplicada por una pendiente y desplazada por una constante.
En la práctica la pendiente y el desplazamiento sobran, porque los pesos y el sesgo de la propia capa ya los absorben. Por eso las bibliotecas implementan la identidad: Keras la llama linear y la documenta como una función identidad, y PyTorch ofrece el módulo torch.nn.Identity[1], que devuelve su entrada sin cambios. Cuando una capa densa de Keras se crea sin el argumento activation, lo que aplica es esta función.
Fórmula, derivada y rango
La definición general tiene dos parámetros, la pendiente a y el término independiente b:
$$f(x) = ax + b$$
Su derivada es la misma en todos los puntos:
$$f'(x) = a$$
De ahí salen sus tres propiedades útiles. El dominio y el rango son todos los reales, así que la salida no se satura como la de la sigmoide. El gradiente que vuelve por la retropropagación se multiplica siempre por a (por 1 en la identidad), sin el desvanecimiento que sufren las activaciones acotadas. Y es continua y derivable en todo su dominio, sin el vértice que ReLU tiene en el origen.
¿Por qué no sirve en las capas ocultas?
Una red cuyas capas ocultas usan activación lineal equivale a una sola capa lineal, tenga las capas que tenga. Con dos capas, la segunda recibe la salida de la primera y el resultado se reordena así:
$$W_2(W_1 x + b_1) + b_2 = (W_2 W_1)\,x + (W_2 b_1 + b_2) = W’x + b’$$
Ver el paso a paso
La primera capa calcula $h = W_1 x + b_1$ y la segunda $y = W_2 h + b_2$. Al sustituir $h$ en la segunda y aplicar la propiedad distributiva del producto de matrices queda $y = W_2 W_1 x + W_2 b_1 + b_2$. El producto $W_2 W_1$ es otra matriz y $W_2 b_1 + b_2$ es otro vector, así que la red completa es una única capa lineal $y = W’x + b’$. Con más capas el argumento se repite por inducción.
Este fragmento de Python con NumPy lo comprueba con matrices aleatorias. Construye una red de dos capas con activación lineal, calcula la capa única equivalente y compara las salidas; después repite la comparación con ReLU entre las capas:
import numpy as np

rng = np.random.default_rng(0)
W1, b1 = rng.normal(size=(4, 3)), rng.normal(size=4)
W2, b2 = rng.normal(size=(2, 4)), rng.normal(size=2)
x = rng.normal(size=3)

# Dos capas con activación lineal (identidad)
y = W2 @ (W1 @ x + b1) + b2

# Una sola capa equivalente
W, b = W2 @ W1, W2 @ b1 + b2
print(np.allclose(y, W @ x + b))  # True

# Con ReLU entre las capas ya no existe ese atajo
y_relu = W2 @ np.maximum(0, W1 @ x + b1) + b2
print(np.allclose(y_relu, W @ x + b))  # False
Lo ejecutamos el 27 de octubre de 2026 en un contenedor python:3.13-slim (Python 3.13.18 y NumPy 2.5.4) y la salida fue True y después False. La capa equivalente reproduce la red lineal exacta, pero no la red con ReLU.
Una red profunda con activaciones lineales tiene la misma capacidad que una regresión lineal: solo puede trazar fronteras de decisión planas. La no linealidad entre capas es lo que permite a la red doblar ese espacio.
¿Cuándo conviene usar la función lineal?
La función lineal tiene tres usos legítimos, y los tres están fuera de las capas ocultas de propósito general:
- Salida de una regresión: si la red predice un precio, una temperatura o una demanda, la última capa debe ser lineal. Una sigmoide limitaría la salida a
(0, 1)y una ReLU impediría los valores negativos. - Proyecciones dentro de un transformer: las matrices de consulta, clave y valor del mecanismo de atención descrito en Attention Is All You Need[2] son transformaciones lineales sin activación; la no linealidad la ponen el softmax de la atención y la red de alimentación hacia delante.
- Cuellos de botella lineales: MobileNetV2 elimina a propósito la activación de la capa estrecha de cada bloque, porque sus autores comprobaron que quitar la no linealidad en esas capas estrechas conserva su poder de representación (Sandler y otros, 2018[3]).
Para la salida de una clasificación la elección es otra. En clasificación binaria se usa la sigmoide, que devuelve una probabilidad entre 0 y 1, y en clasificación multiclase la función Softmax, que reparte la probabilidad entre todas las clases.
La relación entre la función lineal y ReLU
ReLU es una función lineal a trozos: vale 0 para x ≤ 0 y la identidad x para x > 0. Esa mitad lineal le da un gradiente de exactamente 1 en la zona activa, la misma ventaja que tiene la función lineal frente a la saturación. El pliegue en el origen es la no linealidad que le falta a la identidad, y basta para que apilar capas sí añada capacidad.
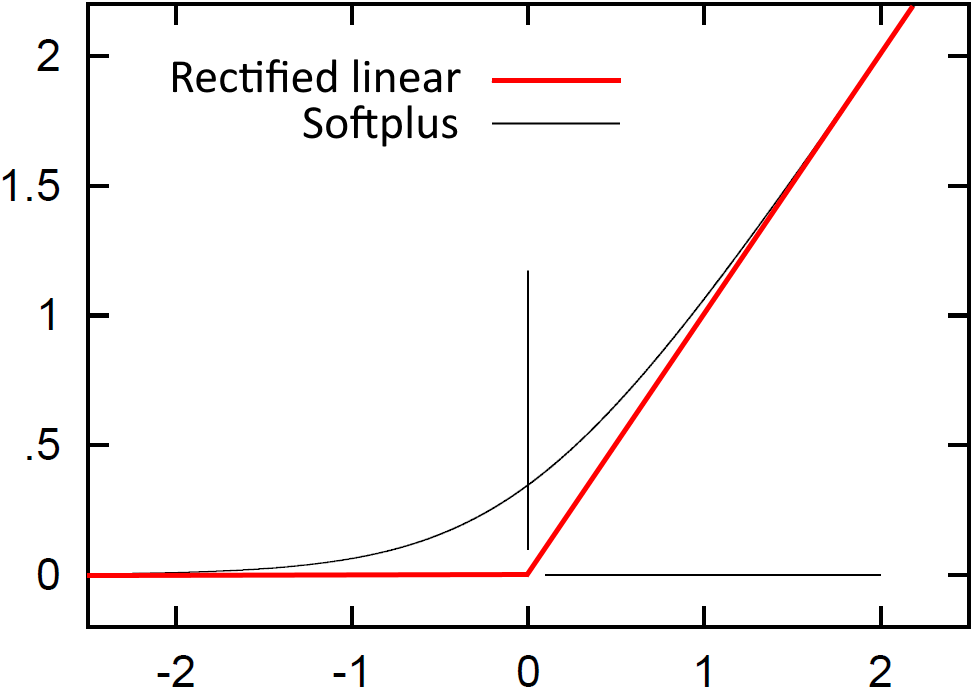
La función Softplus lleva la misma idea un paso más allá: redondea el pliegue de ReLU con ln(1 + eˣ) y se pega a la recta y = x para entradas grandes. Las tres funciones comparten el comportamiento lineal en la zona positiva y se diferencian en cómo tratan los valores negativos.
Cómo se escribe en PyTorch y en Keras
En las dos bibliotecas la activación lineal se obtiene sin escribir ninguna función. En PyTorch, una capa nn.Linear sin módulo de activación detrás ya produce una salida lineal; nn.Identity sirve cuando una arquitectura exige un módulo en esa posición. Este modelo de regresión termina así:
import torch.nn as nn

modelo = nn.Sequential(
    nn.Linear(8, 32),
    nn.ReLU(),
    nn.Linear(32, 1),  # salida lineal: cualquier número real
)
En Keras, layers.Dense(1) sin el argumento activation aplica la identidad, igual que layers.Dense(1, activation="linear"). La pérdida que acompaña a una salida lineal de regresión es el error cuadrático medio, o la pérdida de Huber[4] si los datos tienen valores atípicos.
La salida lineal y los valores atípicos
Una salida lineal no se satura, así que cada valor atípico del conjunto de entrenamiento empuja la predicción tanto como su error. Con el error cuadrático medio ese empuje crece con el cuadrado del error y unos pocos puntos extremos pueden sesgar el modelo. Hay tres mitigaciones estándar:
- Cambiar la pérdida: el error absoluto medio o la pérdida de Huber, que es cuadrática para errores pequeños y lineal para los grandes.
- Normalizar el objetivo: entrenar con la variable de salida estandarizada y deshacer la transformación al predecir.
- Limpiar los datos: acotar o retirar los atípicos que proceden de errores de medición, no los que son casos reales.
Preguntas frecuentes
¿Por qué no se usa la función lineal en las capas ocultas?
Porque componer transformaciones lineales da otra transformación lineal. Una red con activación lineal en todas sus capas equivale a una sola capa W'x + b', sin importar cuántas tenga. Para aprender relaciones no lineales hace falta una activación no lineal, como ReLU, la sigmoide o la tangente hiperbólica, entre las capas ocultas.
¿Qué diferencia hay entre la función lineal y la función identidad?
La identidad es el caso particular de la función lineal con a = 1 y b = 0, es decir, f(x) = x. Las bibliotecas implementan la identidad porque la pendiente y el desplazamiento ya los aportan los pesos y el sesgo de la capa. Keras llama linear a esta activación y PyTorch la ofrece como nn.Identity.
¿La función lineal sufre el problema del gradiente desvanecido?
No. Su derivada es constante, así que el gradiente que pasa por ella se multiplica siempre por el mismo valor, 1 en la identidad. Esa ventaja no compensa su incapacidad para modelar relaciones no lineales en las capas ocultas, y por eso ReLU, que conserva la derivada 1 en su zona positiva, ocupa ese lugar.
Conclusión
La función lineal de activación tiene un sitio preciso en una red neuronal: la salida de una regresión y las proyecciones o cuellos de botella que no deben deformar su entrada. En las capas ocultas de propósito general no sirve, porque cualquier número de capas lineales se reduce a una sola. Puedes situarla junto al resto de activaciones en el mapa de las matemáticas de las redes neuronales.
Fuentes: [1] Goodfellow, Bengio y Courville, Deep Learning, capítulo 6[5], [2] torch.nn.Identity, documentación de PyTorch[1], [3] keras.activations.linear, documentación de Keras[6], [4] Attention Is All You Need (Vaswani y otros, 2017)[2], [5] MobileNetV2: Inverted Residuals and Linear Bottlenecks (Sandler y otros, 2018)[3].