Cómo instalar Audiobookshelf con Docker para tus audiolibros y podcasts
Índice de contenidos
- Puntos clave
- Qué necesitas antes de empezar
- Cómo es el docker-compose.yml de Audiobookshelf
- Cómo crear el usuario administrador y las bibliotecas
- Cómo organizar las carpetas de audiolibros
- Qué metadatos gana: carpeta o etiquetas del MP3
- Cómo emparejar metadatos con un proveedor
- Cómo añadir un podcast por RSS
- Cómo crear usuarios con permisos limitados
- Cómo comprobar que el progreso se sincroniza por API
- Qué cambia en la versión 2.37
- Cómo escuchar desde el móvil
- Preguntas frecuentes
- ¿Audiobookshelf sustituye a Jellyfin?
- ¿Dónde guarda Audiobookshelf mis datos y cómo hago copia?
- ¿Puedo ejecutar el contenedor con mi usuario en lugar de root?
- Conclusión
- Fuentes
Audiobookshelf es un servidor de audiolibros y podcasts de código abierto que se instala con un único contenedor de Docker y cuatro carpetas. Lo he levantado el 7 de octubre de 2026 con la versión 2.37.1, he añadido un audiolibro de dominio público de LibriVox y un podcast por RSS, y he comprobado por API que cada usuario guarda su propio progreso. También tienes la versión en inglés.
Puntos clave
- Un servicio, la imagen
ghcr.io/advplyr/audiobookshelf:2.37.1(487 MB en disco) y cuatro carpetas montadas:/audiobooks,/podcasts,/configy/metadata. - La estructura de carpetas
Autor/Títulono basta: si el MP3 trae etiquetas incrustadas, ganan sobre el nombre de la carpeta. Mi audiolibro apareció comogift_of_the_magihasta que corregí los metadatos. - Un podcast se añade con su URL RSS. Mi feed tenía 564 episodios y bajé uno de 84,3 MB sin activar la descarga automática.
- Cada usuario guarda su progreso por separado y una clave de API actúa con los permisos de su usuario: la de un usuario limitado recibió un 403 al pedir la biblioteca de podcasts.
- La 2.37 sube Node.js a la versión 24, marca como explícito lo que Audible declara explícito y permite que las claves de API autentiquen websockets.
Qué necesitas antes de empezar
Necesitas Docker con el plugin Compose y un puerto libre. Yo usé Docker Engine en un Linux arm64, y la imagen oficial publica esa arquitectura. Si aún no tienes Docker, la guía para instalar Docker en Ubuntu 24.04 cubre el paso previo.
La documentación oficial[1] dice que "Docker is the recommended way to run Audiobookshelf", y define las etiquetas de imagen: latest (la última estable), edge (cada commit de la rama principal) y #.#.# para fijar una versión. Fija la versión: así una actualización es una decisión tuya y no un efecto de docker compose pull.
Cómo es el docker-compose.yml de Audiobookshelf
El fichero necesita un servicio, un puerto y cuatro montajes. Este es el que ejecuté, con el puerto 29900 de mi rango de pruebas (el oficial es el 13378):
services:
  audiobookshelf:
    image: ghcr.io/advplyr/audiobookshelf:2.37.1
    ports:
      - "13378:80"
    volumes:
      - ./audiobooks:/audiobooks
      - ./podcasts:/podcasts
      - ./config:/config
      - ./metadata:/metadata
    environment:
      - TZ=Europe/Madrid
    restart: unless-stopped
/config guarda la base de datos SQLite (476 KB tras mi prueba) y /metadata guarda portadas, registros, copias de seguridad y un metadata.json por elemento. La documentación avisa de que /config debe estar en un disco local de la misma máquina, no en una carpeta de red, porque SQLite sobre red acaba corrompiendo la base de datos. Cada punto de montaje debe ser un directorio independiente, no contenido dentro de otro. Para saber más de este tipo de montajes, mira la guía de volúmenes y bind mounts en Docker.
Arranca con docker compose up -d. El registro mostró Listening on port :80 y curl localhost:13378/status devolvió "serverVersion":"2.37.1" con "isInit":false. La interfaz web se abrió en /audiobookshelf/ en mi prueba, mientras que la API respondió en la raíz.
Cómo crear el usuario administrador y las bibliotecas
El primer acceso crea el usuario root, que es el administrador. En el navegador aparece un formulario; yo lo hice por API para dejarlo reproducible:
curl -s -X POST localhost:13378/init \
  -H 'Content-Type: application/json' \
  -d '{"newRoot":{"username":"root","password":"tu_clave_de_admin"}}'

curl -s -X POST localhost:13378/login \
  -H 'Content-Type: application/json' \
  -H 'x-return-tokens: true' \
  -d '{"username":"root","password":"tu_clave_de_admin"}'
La primera llamada responde OK. La segunda devuelve el usuario con un accessToken, que uso como tu_token_de_acceso en las demás llamadas. Con él creé una biblioteca por tipo de contenido: mediaType vale book para audiolibros y podcast para podcasts, y cada una apunta a una de las carpetas montadas:
curl -s -X POST localhost:13378/api/libraries \
  -H 'Authorization: Bearer tu_token_de_acceso' \
  -H 'Content-Type: application/json' \
  -d '{"name":"Audiolibros","mediaType":"book",
       "folders":[{"fullPath":"/audiobooks"}]}'
Repetí la llamada con "name":"Podcasts", "mediaType":"podcast" y /podcasts. En la interfaz es lo mismo desde Settings, Libraries, Add. Una biblioteca de libros recién creada no importó el fichero que ya estaba en la carpeta hasta que lancé POST /api/libraries/<id>/scan, que respondió 1 Added.
Cómo organizar las carpetas de audiolibros
Cada libro es una carpeta, y el formato de metadatos por carpeta es Autor/Serie/Libro o Autor/Libro. La guía oficial de estructura[2] admite además un año como prefijo (1994 - Título), un número de serie (Vol 1 - Título) y el narrador entre llaves ({Nombre Apellido}).
Para la prueba descargué de LibriVox "Gift of the Magi" de O. Henry, leído por Betsie Bush: 13 min 22 s, un MP3 de 64 kb/s y 6,42 MB, con licencia de dominio público (1906). Lo dejé así:
audiobooks/
  O. Henry/
    The Gift of the Magi/
      The Gift of the Magi.mp3
Si un libro tiene más de un MP3, ponlos todos en la carpeta del libro: Audiobookshelf los trata como pistas de un solo libro. Un fichero suelto de otro libro dentro de la carpeta del autor agrupa libros distintos en uno. La documentación avisa de que solo se arregla borrando el libro en la interfaz y reescaneando, y eso borra el progreso.
Qué metadatos gana: carpeta o etiquetas del MP3
Tras el escaneo el libro apareció como gift_of_the_magi de Henry_o, no como "The Gift of the Magi" de "O. Henry", que es lo que dice la carpeta. La causa es que el MP3 de LibriVox lleva etiquetas ID3 (metadatos incrustados en el fichero) en minúsculas: ffprobe dentro del contenedor mostró title: gift_of_the_magi y artist: henry_o.
La documentación de metadatos[3] explica el orden: Audiobookshelf rellena cada campo con la fuente de menor prioridad y la sobrescribe con las siguientes. Por defecto el fichero metadata.json de Audiobookshelf tiene la prioridad más alta y la estructura de carpetas, la más baja, así que las etiquetas incrustadas vencen al nombre de la carpeta. Puedes cambiar ese orden por biblioteca en Settings, Libraries, Metadata order of precedence.
La misma página dice algo que conviene tener presente: "Matching your books against an online metadata provider is intentionally a manual action and must be performed by the server admin or through the use of the API." Es decir, nada se corrige solo, y los proveedores externos son una herramienta, no un paso automático.
Cómo emparejar metadatos con un proveedor
El emparejamiento se hace desde el menú del libro, Match, o con GET /api/search/books. Probé cuatro proveedores con título "The Gift of the Magi" y autor "O. Henry":
| Proveedor | Resultados | Primer resultado |
|---|---|---|
| Audible | 10 | Narrador Cindy Hardin Killavey, 2007 |
| Open Library | 50 | O. Henry, 1906, sin narrador |
| iTunes | 60 | "The Gift of the Magi (Unabridged)", 2026 |
| Google Books | 0 | Sin resultados |
Audible devolvió grabaciones comerciales con otros narradores, así que aplicarlas habría puesto el narrador equivocado a una grabación de LibriVox. Open Library tuvo sentido (obra de 1906), pero cuando fui a aplicar el emparejamiento sus servidores dejaron de aceptar conexiones (ECONNREFUSED en el registro del contenedor) y el servidor devolvió No openlibrary match found. Un proveedor caído no debería bloquearte: edité el libro con los datos de la ficha de LibriVox[4], que es la fuente real de esta grabación:
curl -s -X PATCH localhost:13378/api/items/id_del_libro/media \
  -H 'Authorization: Bearer tu_token_de_acceso' \
  -H 'Content-Type: application/json' \
  -d '{"metadata":{"title":"The Gift of the Magi",
       "authors":[{"name":"O. Henry"}],
       "narrators":["Betsie Bush"],
       "publishedYear":"1906","publisher":"LibriVox",
       "genres":["Fiction","Short stories"]}}'
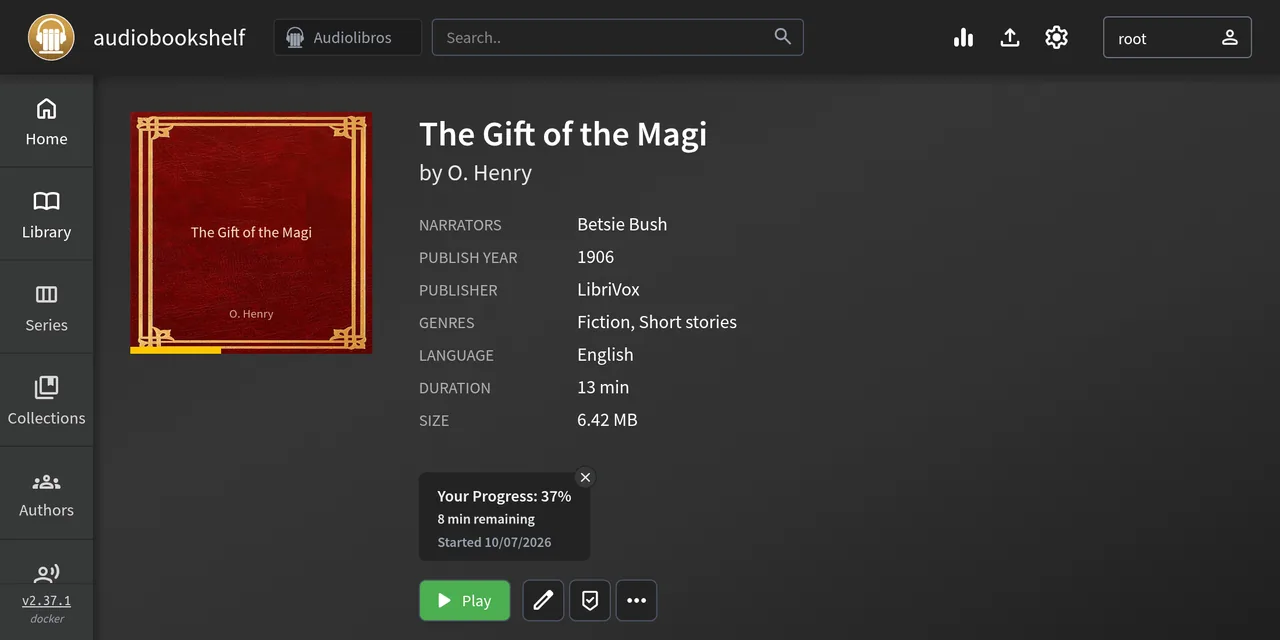
La respuesta trae "updated":true y Audiobookshelf escribió el resultado en /metadata/items/<id>/metadata.json, que la próxima vez que escanee tendrá la prioridad más alta. La ficha del libro ya muestra título, autor, narradora, año y editorial correctos, y es la captura de la portada de este artículo.
Cómo añadir un podcast por RSS
Un podcast se añade con la URL de su feed, y Audiobookshelf lee título, autor, descripción y la lista de episodios. En la interfaz, Add en la barra lateral de la biblioteca de podcasts busca por nombre (con la región de búsqueda de la biblioteca) o acepta una URL. Por API son dos pasos. El primero lee el feed:
curl -s -X POST localhost:13378/api/podcasts/feed \
  -H 'Authorization: Bearer tu_token_de_acceso' \
  -H 'Content-Type: application/json' \
  -d '{"rssFeed":"https://talkpython.fm/episodes/rss"}'
El feed de Talk Python To Me devolvió 564 episodios; el más reciente era el #565, del 2 de octubre de 2026. El segundo paso crea el podcast con POST /api/podcasts (con la carpeta, la biblioteca y "autoDownloadEpisodes":false) y pide el episodio con POST /api/podcasts/<id>/download-episodes. El fichero llegó a podcasts/Talk Python To Me/ con 84 285 350 bytes y una duración de 5 266 s.
Deja la descarga automática desactivada hasta que decidas cuánto espacio das al podcast: 564 episodios de 84 MB suman unos 47 GB. La guía de estructura de podcasts[5] añade que los podcasts usan una estructura plana, sin carpetas de temporada, y que cada fichero de audio es un episodio.
Cómo crear usuarios con permisos limitados
Cada persona de la casa tiene su cuenta y su progreso, y un administrador decide qué bibliotecas ve. Creé el usuario familia de tipo user, con descarga permitida, sin permisos de edición, borrado ni subida y con acceso solo a la biblioteca de audiolibros:
curl -s -X POST localhost:13378/api/users \
  -H 'Authorization: Bearer tu_token_de_acceso' \
  -H 'Content-Type: application/json' \
  -d '{"username":"familia","password":"tu_clave_de_familia",
       "type":"user","isActive":true,
       "permissions":{"download":true,"update":false,
         "delete":false,"upload":false,
         "accessAllLibraries":false},
       "librariesAccessible":["id_de_la_biblioteca"]}'
Después creé una clave de API para ese usuario con POST /api/api-keys (name, userId y expiresIn en segundos). La documentación de claves de API[6] dice que la clave actúa en nombre de un usuario, hereda sus permisos y se muestra una sola vez. Lo comprobé: con esa clave GET /api/libraries listó solo la biblioteca de audiolibros, y GET /api/libraries/<id de podcasts> devolvió 403.
Cómo comprobar que el progreso se sincroniza por API
Las aplicaciones y la web usan el mismo mecanismo que puedes llamar tú: abren una sesión de reproducción y envían la posición cada pocos segundos. Abrí una sesión con POST /api/items/<id>/play, sincronicé la posición 300 s y la cerré:
curl -s -X POST localhost:13378/api/session/id_de_sesion/sync \
  -H 'Authorization: Bearer tu_token_de_acceso' \
  -H 'Content-Type: application/json' \
  -d '{"currentTime":300,"timeListened":300,
       "duration":802.463667}'

curl -s localhost:13378/api/me/progress/id_del_libro \
  -H 'Authorization: Bearer tu_token_de_acceso'
La lectura devolvió "currentTime":300 y "progress":0.3738, el 37 % que muestra la interfaz en "Your Progress". Cualquier dispositivo con la misma cuenta lee ese valor. Después fijé currentTime: 120 con la clave del usuario familia mediante PATCH /api/me/progress/<id> y leí ambos: el administrador seguía en 300 s y familia quedó en 120 s (14,95 %). El progreso es por usuario, no por libro.
Qué cambia en la versión 2.37
La 2.37.0 salió el 28 de septiembre de 2026 y la 2.37.1 el 29 de septiembre. Según las notas de la versión 2.37.0[7]:
- Node.js 24: el servidor, la imagen de Docker y los scripts de compilación usan Node 24 (el contenedor reportó
v24.21.0) - Claves de API en websockets: pueden autenticar conexiones websocket
- Audible: los resultados del emparejamiento fijan el indicador de contenido explícito
- API de portadas: actualizar la portada de un elemento exige que la ruta sea un fichero que ya esté en ese elemento, y las rutas de caché de portadas e imágenes de autor exigen un identificador válido y anchura y altura positivas
- Correcciones: cierres del servidor al decodificar grupos de filtros inválidos y al contraer subseries ordenando por autor
La 2.37.1[8] corrige un error EACCES en la instalación de Debian. También limpia las sesiones de inicio por OIDC (OpenID Connect) móvil abandonadas y amplía a 10 minutos la caducidad de la cookie de retorno. Si usas Docker, el cambio que notas es Node 24; el resto afecta a scripts y a la autenticación externa. Las notas remiten a la autenticación nueva de la 2.26.0, así que si vienes de una versión anterior lee primero esa discusión[9].
Cómo escuchar desde el móvil
Las aplicaciones oficiales (Android e iOS, que la documentación llama beta) se conectan a la URL de tu servidor con tu usuario y descargan libros para escuchar sin conexión. No las instalé en un teléfono en esta prueba. Lo que sigue sale de la documentación de perfiles de conexión[10]: lo descargado queda ligado al perfil con el que lo bajaste, y el progreso solo se sincroniza si te conectas con el mismo perfil. Si guardas un perfil para la IP interna y otro para la VPN, escuchar con el segundo no sincroniza con el servidor.
Para salir de casa necesitas una URL con HTTPS y un proxy inverso; las guías oficiales cubren Nginx, Caddy y Traefik. Con Traefik y Docker Compose es una etiqueta más en el servicio. La aplicación de Android[11] está en Google Play.
Preguntas frecuentes
¿Audiobookshelf sustituye a Jellyfin?
No para el mismo uso. Audiobookshelf está hecho para audio hablado: guarda el progreso por libro, marcadores y podcasts con descarga de episodios. Si quieres películas y series en la tele, sigue siendo el trabajo de Jellyfin con Docker, y puedes ejecutar los dos en la misma máquina.
¿Dónde guarda Audiobookshelf mis datos y cómo hago copia?
La base de datos está en /config y los metadatos, portadas y copias en /metadata. Copia esas dos carpetas más las de tus audios. La interfaz también programa copias automáticas, que en mi instalación estaban desactivadas (Auto Backups are disabled).
¿Puedo ejecutar el contenedor con mi usuario en lugar de root?
Sí. La documentación indica que Audiobookshelf no usa PUID ni PGID y propone la directiva user: 1000:1000 de Compose. En mi prueba el contenedor corrió como root y la carpeta del podcast que creó quedó con propietario root en el host.
Conclusión
Audiobookshelf 2.37.1 funcionó con un servicio y cuatro carpetas. Revisa sobre todo los metadatos: las etiquetas incrustadas ganan a las carpetas, y un proveedor externo puede fallar o ofrecer otra grabación. La API confirmó que el progreso se guarda por usuario y que una clave limitada no ve bibliotecas ajenas.
Siguiente paso: fija la versión, mueve /config a un disco local, crea un usuario por persona y pon HTTPS delante antes de usar las aplicaciones fuera de casa.
Fuentes: [1] Instalación con Docker de Audiobookshelf[1], [2] Notas de la versión 2.37.0[7], [3] Notas de la versión 2.37.1[8], [4] Metadatos de libros en Audiobookshelf[3], [5] Claves de API de Audiobookshelf[6], [6] Ficha de LibriVox de The Gift of the Magi[4], [7] Perfiles de conexión de la app móvil[10].
Fuentes
Código fuente
Accede a todo el código fuente de este artículo en GitHub.
Ver en GitHub