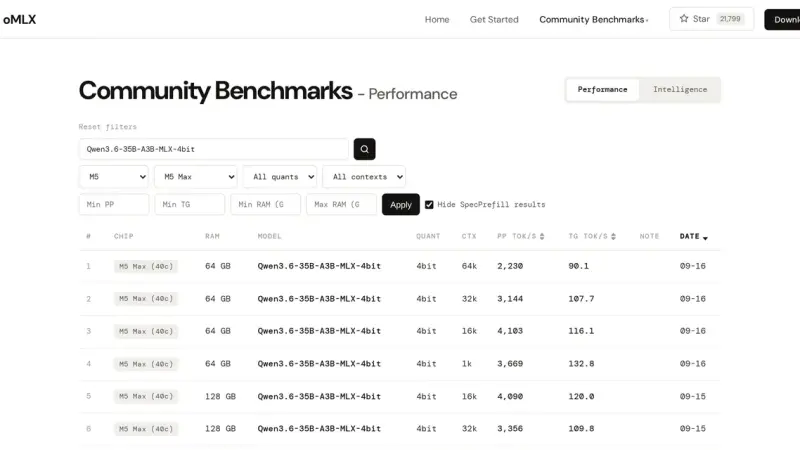
Una cifra de tokens por segundo de oMLX solo sirve si dice la longitud del prompt, la vía de medida, el estado de la caché y el del Mac. En un M5 Max, el primer token de Qwen3.8-27B pasó de 1,12 a 65,5 segundos entre 1k y 32k de prompt. El techo de memoria por defecto deja para macOS el 8 % de la RAM, entre 3 y 8 GB.
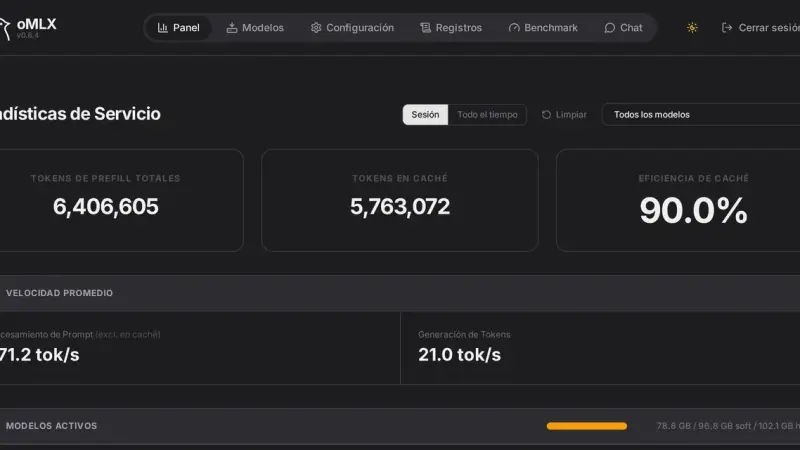
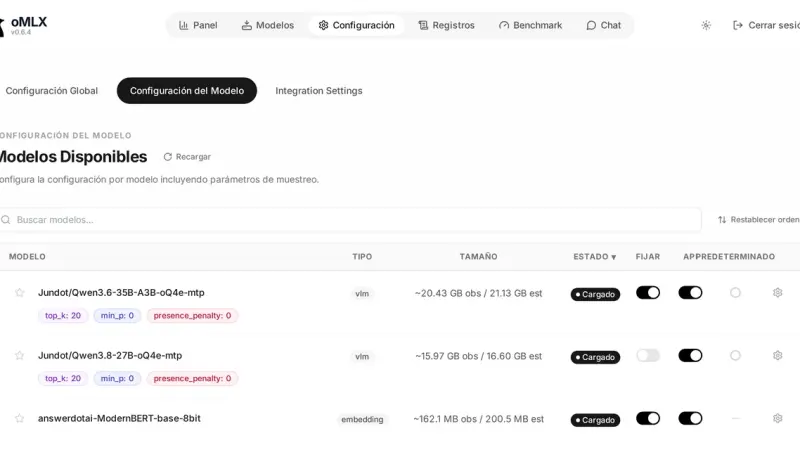
El panel de oMLX vive en localhost:8000/admin y reúne monitorización, carga y descarga de modelos, chat con historial, descargador de Hugging Face, benchmarks y ajustes por modelo. La línea de comandos cubre lo demás con cuatro órdenes: serve, start, stop y launch, esta última para conectar clientes externos.
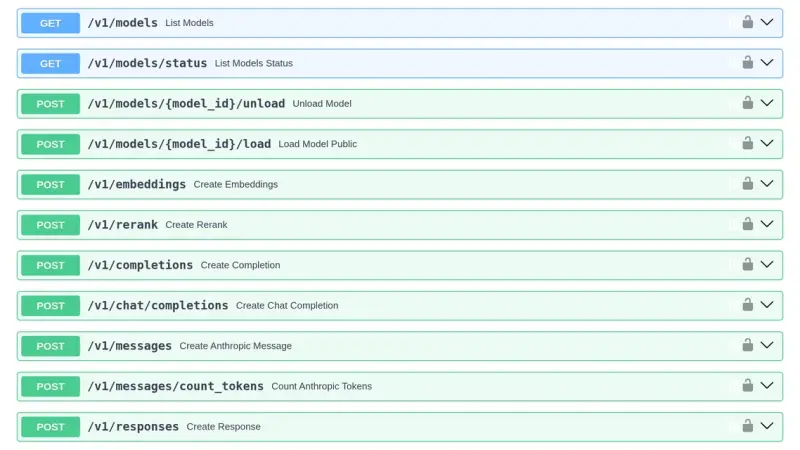
oMLX 0.7.2 escucha en 127.0.0.1:8000 y sirve la API de OpenAI y la Messages API de Anthropic en el mismo puerto. La clave viaja en Authorization: Bearer o en x-api-key y es obligatoria en cuanto el servidor escucha fuera de loopback. Los errores llegan en el formato de OpenAI, y el puerto se cambia con --port, OMLX_PORT o la sección server de settings.json.
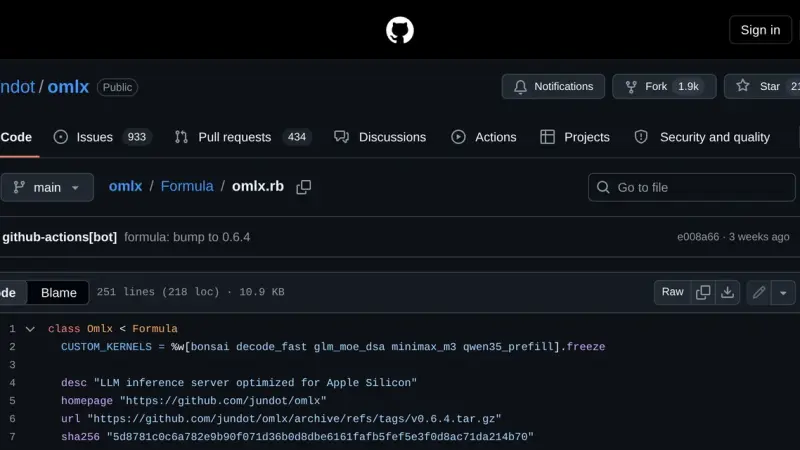
oMLX se instala con Homebrew en dos órdenes: primero el tap del repositorio de jundot y después la fórmula. Queda un servicio de launchd que arranca con omlx start, un registro en la carpeta var de Homebrew y una actualización con brew upgrade. La versión actual es la 0.6.4, del 29 de agosto de 2026.
oMLX gestiona el ciclo de vida de cada modelo con cuatro piezas: un descargador que trae pesos desde Hugging Face, alias que renombran el modelo en la API, un TTL que lo descarga tras un tiempo inactivo y una caché KV por niveles que vuelca bloques al SSD cuando la RAM se llena.
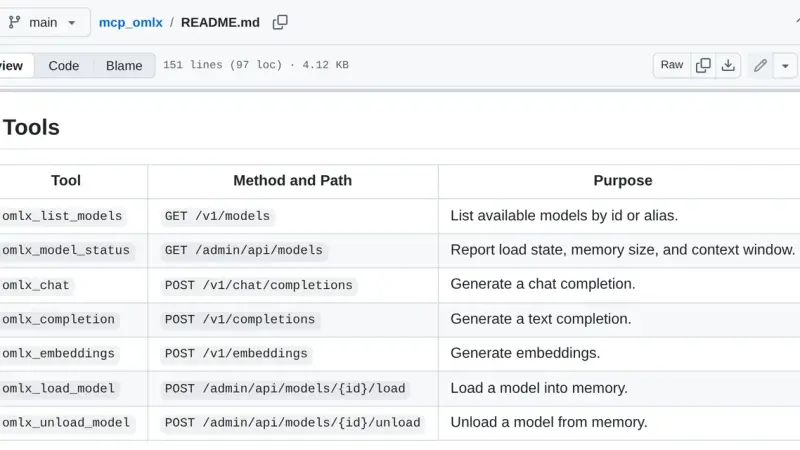
oMLX MCP es un puente que expone tu servidor local de oMLX como herramientas del Model Context Protocol. Con el paquete mcp_omlx conectas Claude Desktop a los modelos que corren en tu Mac y ganas siete herramientas para listar modelos, cargarlos y liberarlos de memoria, y lanzar inferencias sin salir del cliente.
Receta para oMLX 0.6.4 en un Mac M5 Max con 128 GB: instalación, Claude Code y ajustes avanzados con capturas (Lightning MTP, VLM MTP y DFlash). Incluye benchmarks propios de septiembre de 2026, con hasta 1,88x más tokens por segundo.
Guía de 100 aplicaciones imprescindibles para tu Mac M5, organizadas en 20 categorías: navegador, gestor de contraseñas, email, notas, terminal, IDE, contenedores, IA y muchas más. Cada selección incluye propósito, características clave, plugins esenciales, precio en euros y enlace oficial, seleccionadas por consenso comunitario y métricas verificables.
Ollama 0.5 o superior ejecuta Llama 3.3 70B y Mistral Large 2 en local sobre Ubuntu 24.04: la cuantización Q4_K_M deja que una sola GPU NVIDIA de 24 GB de VRAM, una RTX 4090 por ejemplo, mueva el modelo completo. Esta guía instala los drivers, monta Open WebUI y expone el servicio tras Traefik con TLS.
Llevo seis meses usando un MacBook Pro con M4 Pro como equipo principal de desarrollo. Cuento qué ha cambiado de verdad respecto al M2 Pro anterior, dónde se nota el salto y dónde la inversión no se justifica si ya tienes un equipo reciente.
M3 y M4 consolidaron la ventaja de Apple Silicon: memoria unificada de hasta 128 GB compartida entre CPU, GPU y Neural Engine, autonomía de 12 a 16 horas en uso real, y un Neural Engine con 38 TOPS que ejecuta modelos de lenguaje grandes en el propio portátil. Para desarrolladores, la diferencia es tangible.
Instalar Ollama en un Mac con Apple Silicon es tan simple como ejecutar un comando de Homebrew. Después, elige el modelo según la RAM disponible (Phi-3 con 8 GB, Llama 3.1 8B con 16 GB) y expón la API HTTP local, compatible con OpenAI, en el puerto 11434 para integrarla en tus propias aplicaciones.
7 min1,3K4,1
Usamos cookies propias y de terceros para analizar el tráfico del sitio. Puedes aceptarlas, rechazarlas o configurar tu elección.
Más información sobre las cookies
Preferencias de cookies
NecesariasImprescindibles para el funcionamiento del sitio. Siempre activas.
AnalíticasNos ayudan a entender cómo se usa el sitio (Google Analytics).