Escalar a cero con el HPA en Kubernetes 1.37: pruébalo en k3s
Índice de contenidos
- Puntos clave
- Qué cambia en Kubernetes 1.37 con el HPA y el escalado a cero
- Por qué un HPA por CPU no puede escalar a cero
- Qué necesitas para probarlo en k3s
- Paso 1: arrancar k3s 1.37 en un contenedor
- Paso 2: la cola de Redis y su métrica en Prometheus
- Paso 3: servir la métrica con prometheus-adapter
- Paso 4: el HPA con minReplicas: 0
- Cuánto tarda el ciclo de 0 a N y de vuelta a 0
- Tres trampas que encontré al probarlo
- HPA nativo o KEDA: cuándo usar cada uno
- Preguntas frecuentes
- ¿Puedo escalar a cero con un HPA que use CPU y una métrica externa a la vez?
- ¿Qué pasa con las peticiones HTTP que llegan cuando el despliegue está en cero?
- ¿Funciona en Kubernetes 1.36 o anteriores?
- Conclusión
- Fuentes
Desde Kubernetes 1.37, un HorizontalPodAutoscaler (HPA) puede bajar un despliegue a cero pods y volver a levantarlo sin activar ninguna feature gate. La condición es que escale con una métrica de tipo External u Object, como la longitud de una cola; con CPU o memoria la API rechaza el objeto. En esta guía lo monto en k3s 1.37 dentro de Docker, con una cola de Redis, Prometheus y prometheus-adapter, y mido el ciclo completo de 0 a N y de vuelta a 0. Tienes también la versión en inglés de esta guía.
Puntos clave
- Kubernetes 1.37, publicado el 26 de agosto de 2026, pasa el escalado a cero del HPA a beta y lo activa por defecto (feature gate
HPAScaleToZero). minReplicas: 0exige al menos una métrica External u Object; un HPA solo con CPU devuelvemust specify at least one Object or External metric.- k3s v1.37.0+k3s1 salió el 15 de septiembre de 2026 y está en el canal
latest; el canalstablesigue en v1.36.4+k3s1. - En ocho ciclos con 40 trabajos, el HPA pidió el primer pod a los 13,0 s de mediana (de 3,9 a 17,5 s, según cae la métrica en los ciclos de 5 y 15 s) y volvió a 0 a los 58,1 s, con una ventana de bajada de 30 s.
- Un despliegue creado con
replicas: 0no escala nunca: el HPA marcaScalingDisabledhasta que lo subes a 1 a mano. - Solo un servidor puede atender
external.metrics.k8s.ioen cada clúster, así que prometheus-adapter y KEDA no pueden servir métricas externas a la vez.
Qué cambia en Kubernetes 1.37 con el HPA y el escalado a cero
Kubernetes 1.37 convierte en beta una función que llevaba en alfa desde la versión 1.16: un HPA con spec.minReplicas: 0. Hasta ahora había que activar la feature gate HPAScaleToZero en el kube-apiserver y en el kube-controller-manager, algo que en un servicio gestionado no siempre puedes hacer. Desde 1.37 viene activada.
El anuncio de Kubernetes v1.37[1] acota el alcance a las métricas de objeto y externas, y apunta a consumidores de colas, trabajos por lotes y cargas con GPU. La propuesta de mejora que lo define, la KEP-2021[2], se abrió el 26 de septiembre de 2020, así que la función ha tardado seis años en pasar a beta.
La novedad visible en el estado del HPA es la condición ScaledToZero. Mientras el HPA mantiene el despliegue en cero, la marca como True; al volver a escalar, pasa a False con el motivo NotScaledToZero. Con ella el controlador distingue un despliegue que ha bajado él mismo de uno que alguien ha parado a mano con replicas: 0.
Por qué un HPA por CPU no puede escalar a cero
Un HPA por CPU calcula la media de uso de los pods que están corriendo, y con cero pods no hay ninguna muestra. La documentación del HPA[3] lo resume en que esas métricas "can only be measured on running Pods". Si el HPA bajase a cero por CPU, no tendría ningún dato para volver a subir.
La API lo impide al crear el objeto. Este HPA pide minReplicas: 0 con una única métrica de CPU:
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: worker-cpu
  namespace: cola
spec:
  scaleTargetRef: {apiVersion: apps/v1, kind: Deployment, name: worker}
  minReplicas: 0
  maxReplicas: 5
  metrics:
  - type: Resource
    resource:
      name: cpu
      target: {type: Utilization, averageUtilization: 70}
Al aplicarlo en k3s 1.37, el kube-apiserver lo rechaza con este mensaje:
The HorizontalPodAutoscaler "worker-cpu" is invalid: spec.metrics:
Forbidden: must specify at least one Object or External metric to
support scaling to zero replicas
La métrica que decide el paso de 0 a 1 tiene que existir fuera de los pods. Sirven la longitud de una cola, las peticiones pendientes en un balanceador o los mensajes sin leer de un tema, y por eso esta guía monta una cola con su propia métrica.
Qué necesitas para probarlo en k3s
La prueba corre entera en Docker, sin instalar k3s en el sistema. Usé una VM Linux arm64 de 18 núcleos (OrbStack sobre Apple silicon) compartida con otros trabajos, y estas piezas, todas en su versión más reciente el 27 de septiembre de 2026:
- k3s v1.37.0+k3s1: la imagen
rancher/k3s:v1.37.0-k3s1ocupa 84,9 MB y tiene variante arm64 - Redis 8.10.2: la cola, una lista llamada
trabajos - redis_exporter v1.92.0: publica la longitud de la lista como métrica de Prometheus
- Prometheus 3.15.0: recoge esa métrica cada 5 s
- prometheus-adapter v0.12.0: sirve la métrica en la API
external.metrics.k8s.io, que es la que consulta el HPA
Si todavía no tienes un clúster, la guía para instalar k3s en tu homelab cubre la instalación en una máquina real. La comparativa k3s vs k0s vs Talos Linux explica por qué k3s encaja en un laboratorio. Ten en cuenta que k3s 1.37 está en el canal latest, no en stable, según los canales de publicación de k3s[4]. Un script de instalación sin INSTALL_K3S_CHANNEL=latest te dará la 1.36.
Paso 1: arrancar k3s 1.37 en un contenedor
Un contenedor privilegiado con la imagen oficial basta para tener un nodo servidor completo. Desactivo Traefik y el balanceador ServiceLB porque la prueba no expone nada hacia fuera:
docker network create hpa-net
docker run -d --name hpa-k3s --hostname hpa-k3s \
  --network hpa-net --privileged \
  --tmpfs /run --tmpfs /var/run \
  -v "$PWD/manifests:/manifests" \
  rancher/k3s:v1.37.0-k3s1 \
  server --disable traefik --disable servicelb
En mi máquina el contenedor y la red llevaban otro prefijo; aquí los llamo hpa-k3s y hpa-net. El nodo pasó a Ready 5,8 s después del docker run, con la carga media en 1,6. Todas las órdenes kubectl de la guía se ejecutan dentro del contenedor con docker exec hpa-k3s kubectl …, así que no necesitas un kubeconfig en tu máquina. Antes de seguir, comprueba que la feature gate está activa:
$ docker exec hpa-k3s sh -c \
    'kubectl get --raw /metrics | grep HPAScaleToZero'
kubernetes_feature_enabled{name="HPAScaleToZero",stage="BETA"} 1
Me encontré un problema ajeno a Kubernetes. Docker Hub respondió 429 Too Many Requests tanto al containerd de k3s como al Docker del anfitrión, así que tiré de réplicas en otros registros: public.ecr.aws/docker/library/redis, quay.io/prometheus/prometheus y quay.io/oliver006/redis_exporter. Los manifiestos de abajo ya usan esos nombres.
Paso 2: la cola de Redis y su métrica en Prometheus
La carga de prueba es una cola de trabajos en una lista de Redis, y la métrica que decide el escalado es su longitud. El exportador va en el mismo pod que Redis y vigila una sola clave con --check-single-keys:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: redis
  namespace: cola
spec:
  replicas: 1
  selector:
    matchLabels: {app: redis}
  template:
    metadata:
      labels: {app: redis}
    spec:
      containers:
      - name: redis
        image: public.ecr.aws/docker/library/redis:8.10.2-alpine
      - name: exporter
        image: quay.io/oliver006/redis_exporter:v1.92.0
        args: ["--check-single-keys=db0=trabajos"]
El manifiesto completo añade el namespace cola y un Service con los puertos 6379 y 9121. Un detalle importa aquí: Redis borra una lista cuando se vacía, pero redis_exporter sigue publicando redis_key_size{key="trabajos"} 0 para la clave ausente. La métrica nunca desaparece, y eso evita que el HPA se quede sin dato justo cuando la cola está vacía.
Prometheus corre como un Deployment con esta configuración, montada desde un ConfigMap. La etiqueta namespace es la que después usa prometheus-adapter para asociar la serie al namespace del HPA:
global:
  scrape_interval: 5s
scrape_configs:
- job_name: redis
  static_configs:
  - targets: ["redis.cola.svc:9121"]
    labels: {namespace: cola}
Si prefieres un Prometheus fuera del clúster, la guía para instalar Prometheus con Docker sirve igual; prometheus-adapter solo necesita llegar a su URL.
Paso 3: servir la métrica con prometheus-adapter
El HPA no habla con Prometheus: pide la métrica a la API agregada external.metrics.k8s.io, y prometheus-adapter es quien la implementa. Esta regla convierte la serie de Redis en una métrica externa llamada trabajos_pendientes:
externalRules:
- seriesQuery: 'redis_key_size{key="trabajos"}'
  resources:
    overrides:
      namespace: {resource: namespace}
  name:
    as: trabajos_pendientes
  metricsQuery: sum(<<.Series>>{<<.LabelMatchers>>})
El adaptador arranca con --prometheus-url=http://prometheus.cola.svc:9090, --config apuntando a esa regla y --metrics-relist-interval=30s; el valor por defecto es de 10 minutos, demasiado para una prueba. Además necesita una ServiceAccount con los permisos estándar de un servidor de API agregado (system:auth-delegator y el rol extension-apiserver-authentication-reader en kube-system). La pieza que lo conecta con el kube-apiserver es el APIService:
apiVersion: apiregistration.k8s.io/v1
kind: APIService
metadata:
  name: v1beta1.external.metrics.k8s.io
spec:
  group: external.metrics.k8s.io
  version: v1beta1
  service: {name: adapter, namespace: cola}
  insecureSkipTLSVerify: true
  groupPriorityMinimum: 100
  versionPriority: 100
insecureSkipTLSVerify vale para un laboratorio, porque el adaptador genera un certificado autofirmado en --cert-dir; en producción, pon el caBundle. En cuanto el adaptador hizo su primer listado, la métrica respondió desde la API:
$ kubectl get --raw \
  /apis/external.metrics.k8s.io/v1beta1/namespaces/cola/trabajos_pendientes
{"kind":"ExternalMetricValueList",
 "apiVersion":"external.metrics.k8s.io/v1beta1","metadata":{},
 "items":[{"metricName":"trabajos_pendientes","metricLabels":{},
 "timestamp":"2026-09-27T10:50:22Z","value":"0"}]}
He partido la salida en líneas para que se lea; la API la devuelve en una sola.
Paso 4: el HPA con minReplicas: 0
El trabajador es un Deployment que saca un elemento de la lista con BLPOP, tarda 2 s en "procesarlo" y repite. El HPA apunta a él con la métrica externa y un objetivo de 5 trabajos por pod:
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: worker
  namespace: cola
spec:
  scaleTargetRef: {apiVersion: apps/v1, kind: Deployment, name: worker}
  minReplicas: 0
  maxReplicas: 5
  metrics:
  - type: External
    external:
      metric: {name: trabajos_pendientes}
      target: {type: AverageValue, averageValue: "5"}
  behavior:
    scaleDown:
      stabilizationWindowSeconds: 30
Con AverageValue, el HPA divide la métrica entre los pods y pide ceil(40 / 5) = 8 réplicas para 40 trabajos, que maxReplicas recorta a 5. La ventana de bajada de 30 s es para la demostración, porque el valor por defecto es de 300 s. En producción conviene dejarlo o subirlo para no arrancar y parar pods con cada ráfaga.
Con la cola vacía, el HPA bajó el despliegue de 1 a 0 pods 30,2 s después de crearse. Es la mediana de tres pruebas, de 30,1 a 30,7 s, con la carga media por debajo de 3. Así queda el estado:
Conditions:
  Type            Status  Reason              Message
  AbleToScale     True    SucceededRescale    the HPA controller was able
                                              to update the target scale to 0
  ScalingActive   True    ValidMetricFound    the HPA was able to
                                              successfully calculate a replica
                                              count from external metric
                                              trabajos_pendientes(nil)
  ScaledToZero    True    ScaledToZero        the HPA controller scaled the
                                              workload to zero
Events:
  Normal  SuccessfulRescale  New size: 0; reason: All metrics below target
Cuánto tarda el ciclo de 0 a N y de vuelta a 0
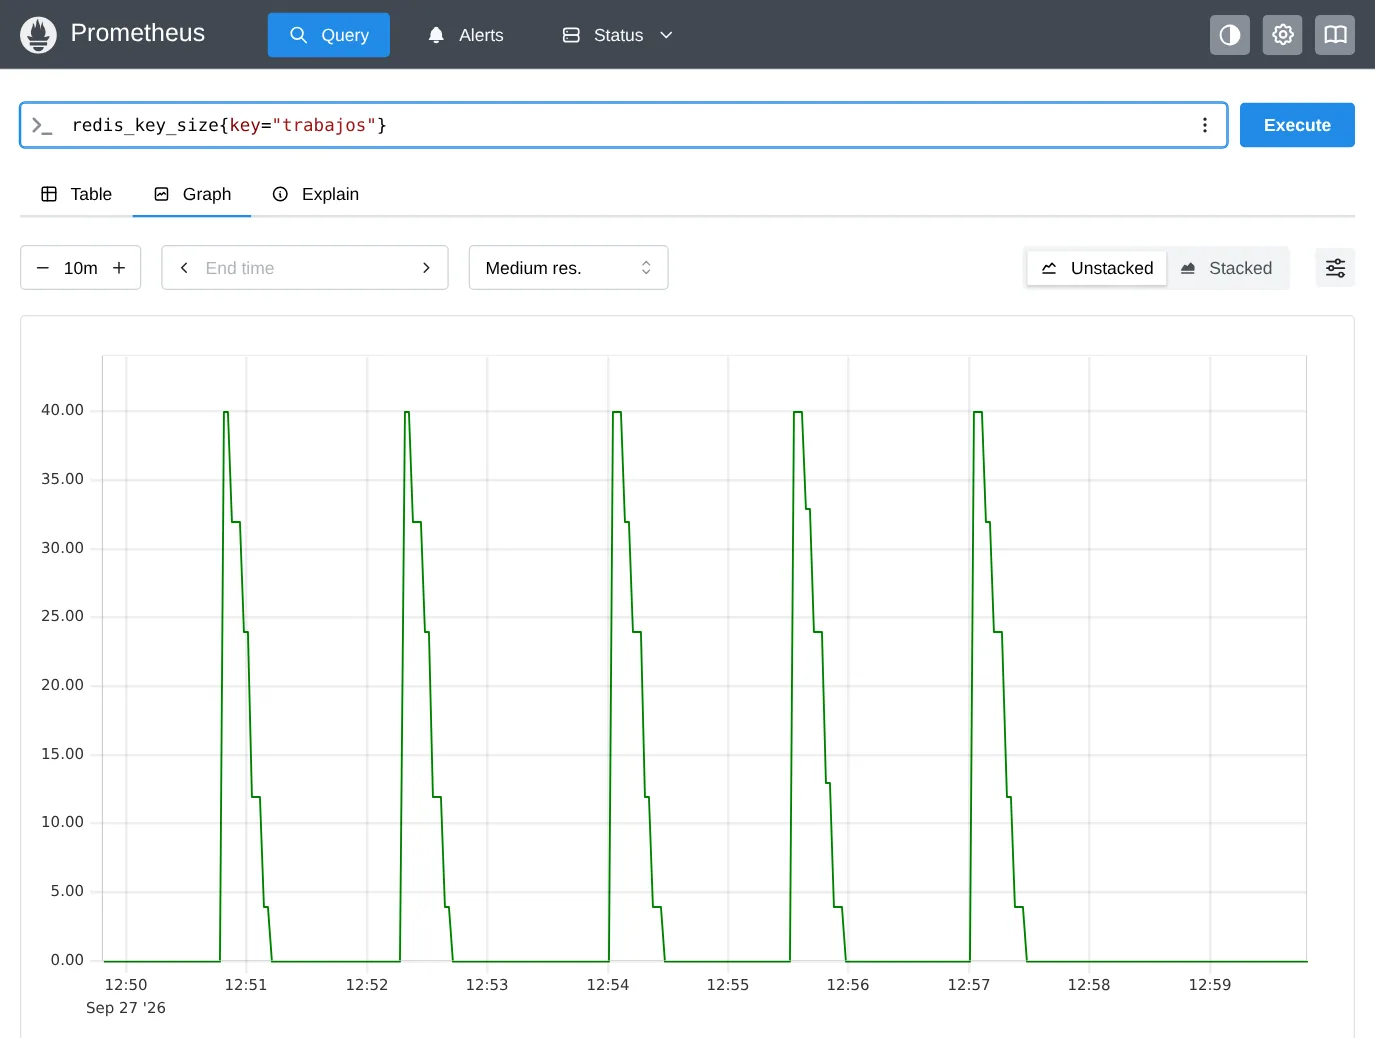
Con 40 trabajos y el despliegue en cero, el HPA pidió el primer pod a los 13,0 s de mediana, con un rango de 3,9 a 17,5 s. El despliegue volvió a cero a los 58,1 s. Son ocho ciclos con la configuración de arriba, medidos desde el RPUSH hasta cada cambio en el Deployment, con una pausa aleatoria de 40 a 55 s entre ellos:
| Ciclo | Réplicas pedidas | Primer pod listo | Cola vacía | De vuelta a 0 | Réplicas máximas |
|---|---|---|---|---|---|
| 1 | 13,3 s | 14,4 s | 32,3 s | 58,5 s | 4 |
| 2 | 17,5 s | 18,2 s | 36,0 s | 62,2 s | 4 |
| 3 | 15,1 s | 16,3 s | 34,4 s | 59,9 s | 4 |
| 4 | 6,3 s | 7,5 s | 25,5 s | 51,3 s | 4 |
| 5 | 14,6 s | 15,8 s | 33,6 s | 59,9 s | 4 |
| 6 | 12,7 s | 13,3 s | 31,3 s | 57,6 s | 4 |
| 7 | 9,7 s | 10,9 s | 29,1 s | 54,8 s | 4 |
| 8 | 3,9 s | 5,0 s | 23,4 s | 49,0 s | 4 |
Un script consultaba el Deployment cada medio segundo con kubectl, así que cada cifra tiene un margen de 1 s. Solo acepté ciclos que empezaban con la carga media de un minuto por debajo de 3 en los 18 núcleos, con k3s y el laboratorio incluidos; arrancaron entre 1,07 y 2,99. La imagen del trabajador ya estaba en caché, de modo que el arranque del pod no incluye la descarga.
El retraso de subida depende de dónde cae el RPUSH dentro de dos ciclos: Prometheus recoge la métrica cada 5 s y el controlador del HPA la consulta cada 15 s. Por eso el peor caso ronda los 20 s antes de pedir el primer pod, y mi peor ciclo se quedó en 17,5 s. Si tu cola no tolera esa espera, no la escales a cero.
Una primera tanda de seis ciclos con una pausa fija dio siempre entre 4,4 y 4,9 s. Cada ciclo duraba casi un múltiplo exacto de 15 s, así que el RPUSH caía siempre justo antes de una evaluación. No tomes esa cifra como la latencia típica.
Una vez arriba, el primer pod estuvo listo entre 0,6 y 1,2 s después de pedirse. Cuatro pods a 2 s por trabajo vaciaron la cola en unos 18 s.
La bajada fue la parte más estable: el despliegue llegó a cero entre 25,5 y 26,3 s después de vaciarse la cola. La ventana de 30 s cuenta desde la última evaluación que aún vio trabajos pendientes, que llega unos segundos antes de que la lista quede vacía. Con la ventana por defecto de 300 s, cuenta con unos cinco minutos entre la cola vacía y el cero.
Tres trampas que encontré al probarlo
La primera trampa es la que más cuesta ver: un despliegue que nace con replicas: 0 no escala nunca, aunque su HPA tenga minReplicas: 0 y la cola esté llena. La KEP-2021 ya lo avisa. Lo reproduje con un segundo despliegue creado a cero y 77 trabajos en cola:
Metrics:                          ( current / target )
  "trabajos_pendientes" (target average value):  <unknown> / 5
Conditions:
  AbleToScale    True    SucceededGetScale  the HPA controller was able
                                            to get the target's current scale
  ScalingActive  False   ScalingDisabled    scaling is disabled since the
                                            replica count of the target is zero
El HPA no sabe si ese cero lo puso él o una persona, y ante la duda no toca nada, porque replicas: 0 sigue siendo la forma de pausar un HPA. La solución es arrancar con replicas: 1 o subirlo una vez a mano: tras un kubectl scale --replicas=1, el HPA pasó a 5 pods en su siguiente evaluación y marcó ScaledToZero False.
La segunda trampa está en el primer salto: con 40 trabajos, el cálculo pedía 5 pods, pero el despliegue subió de 0 a 4. La política de subida por defecto permite, cada 15 s, el mayor de dos valores: duplicar los pods (100 %) o añadir 4. Desde cero, el 100 % son cero pods, así que manda la regla de 4. Si tu carga necesita más pods de golpe, sube el valor Pods en behavior.scaleUp.policies.
La tercera es solo cosmética, pero despista. En la evaluación que saca el despliegue de cero, el estado del HPA registra un valor medio de 9223372036854775807m, el máximo de un entero de 64 bits, porque divide 40 trabajos entre cero pods. kubectl get hpa lo enseña tal cual en la columna TARGETS hasta la siguiente evaluación, que ya vuelve a cifras normales.
HPA nativo o KEDA: cuándo usar cada uno
KEDA (Kubernetes Event-driven Autoscaling) lleva años resolviendo el escalado a cero con otra división del trabajo. Su operador decide el paso de 0 a 1 y crea un HPA que se encarga de 1 a N. La documentación de KEDA[5] llama a esas dos fases activación y escalado.
Lo comprobé con KEDA 2.21.0 en otro k3s 1.37 y la misma cola: aunque el clúster ya admite minReplicas: 0, el HPA que genera KEDA para un ScaledObject con minReplicaCount: 0 sigue teniendo minReplicas: 1. Al llegar trabajos, el evento KEDAScaleTargetActivated registró el paso de 0 a 1 y, a continuación, el HPA subió a 4. KEDA consulta la cola cada 30 s por defecto (pollingInterval) y espera 300 s (cooldownPeriod) antes de volver a cero.
| Criterio | HPA nativo en 1.37 | KEDA 2.21 |
|---|---|---|
| Quién decide el paso de 0 a 1 | El controlador del HPA | El operador de KEDA |
| Origen de la métrica | Cualquier adaptador de external.metrics.k8s.io o custom.metrics.k8s.io |
Más de 70 escaladores integrados |
| Piezas extra en el clúster | Un adaptador (aquí, Prometheus y prometheus-adapter) | Operador, servidor de métricas y webhooks de KEDA |
| Estado del proyecto | Beta en Kubernetes, activado por defecto | Proyecto graduado de la CNCF; 2.21.0 del 23 de septiembre de 2026 |
| Umbral de activación distinto del de escalado | No | Sí (prefijo activation, como activationListLength) |
Las dos opciones compiten por la misma API. La guía de operación de KEDA lo deja claro: "you can only run one active metric server in a Kubernetes cluster serving external.metrics.k8s.io which has to be the KEDA metric server". Si ya tienes prometheus-adapter sirviendo métricas externas, instalar KEDA las sustituye.
Hay otro dato a tener en cuenta: la última versión de prometheus-adapter, la v0.12.0, es del 17 de mayo de 2024. Funciona en 1.37, como muestra esta prueba, pero lleva más de dos años sin versión nueva. Mi recomendación: si ya tienes Prometheus y una o dos métricas que escalar, el HPA nativo con prometheus-adapter basta y te ahorra un operador. Si escalas por colas de servicios distintos o necesitas un umbral de activación, KEDA sigue siendo la opción.
Preguntas frecuentes
¿Puedo escalar a cero con un HPA que use CPU y una métrica externa a la vez?
Sí. La validación solo exige que haya al menos una métrica External u Object entre las del HPA. Lo probé con un HPA de CPU más la cola: bajó a cero y, con 40 trabajos, volvió a 4 pods. Mientras no hay pods, el HPA registra avisos FailedGetResourceMetric por la CPU y decide con la métrica externa; con pods en marcha, aplica el mayor de los dos cálculos.
¿Qué pasa con las peticiones HTTP que llegan cuando el despliegue está en cero?
Se pierden o esperan en el cliente, porque el HPA no retiene tráfico. La KEP-2021 deja fuera de su alcance el búfer de peticiones en el Service. Para servicios HTTP que deban escalar a cero necesitas algo delante que retenga la petición, como Knative o el complemento HTTP de KEDA; el HPA nativo encaja con colas y trabajos asíncronos.
¿Funciona en Kubernetes 1.36 o anteriores?
Sí, activando la feature gate HPAScaleToZero en el kube-apiserver y en el kube-controller-manager, porque la función existe en alfa desde la 1.16. En k3s se hace con --kube-apiserver-arg y --kube-controller-manager-arg. En un servicio gestionado que no te deje tocar las feature gates, tendrás que esperar a la 1.37.
Conclusión
El escalado a cero del HPA en Kubernetes 1.37 funciona sin opciones especiales, y en k3s v1.37.0+k3s1 lo tuve en marcha con cuatro piezas: Redis, redis_exporter, Prometheus y prometheus-adapter. Lo que exige es una métrica que exista fuera de los pods, un despliegue que no nazca con cero réplicas y una ventana de bajada pensada para tu carga. El siguiente paso es cambiar la cola de juguete por la tuya y comprobar, con kubectl describe hpa, que la condición ScaledToZero alterna como en esta prueba.
Fuentes: [1] Kubernetes v1.37: Garhwal[1], [2] KEP-2021: HPA supports scaling to/from zero pods for object/external metrics[2], [3] Kubernetes: Horizontal Pod Autoscaling[3], [4] Canales de publicación de k3s[4], [5] k3s v1.37.0+k3s1[6], [6] prometheus-adapter[7], [7] KEDA 2.21.0[8], [8] KEDA: Scaling Deployments[5], [9] KEDA: Cluster[9], [10] KEDA[10], [11] KEDA: ScaledObject specification[11].