Qué es PixelRAG y qué tal busca en Wikipedia con capturas de pantalla
Índice de contenidos
- Puntos clave
- ¿Qué es PixelRAG?
- ¿Cómo funciona la búsqueda sobre capturas de pantalla?
- ¿Cuánto mejora frente a un RAG de texto según el artículo?
- ¿Qué tal busca la API pública en inglés y en español?
- ¿Se puede instalar PixelRAG en tu propio equipo?
- ¿Cuándo compensa PixelRAG frente a un RAG de texto?
- Preguntas frecuentes
- ¿PixelRAG necesita GPU?
- ¿Busca en otros idiomas además del inglés?
- ¿La API pública responde a las preguntas?
- Conclusión
- Fuentes
PixelRAG es un sistema de búsqueda para generación aumentada por recuperación (RAG) que guarda cada página web como capturas de pantalla y busca sobre esas imágenes, sin convertir el HTML a texto. Lo publicó en junio de 2026 un equipo de Berkeley con Matei Zaharia y Joseph E. Gonzalez, y su artículo mide más aciertos que un RAG de texto en preguntas sobre Wikipedia. Probé su API pública el 28 de octubre de 2026 con 10 preguntas en inglés y en español, e intenté instalar el paquete en Linux arm64 y lo instalé en x86_64 para indexar un PDF. Aquí tienes cómo funciona, qué dicen sus cifras y qué encontré. Tienes la versión en inglés de este artículo.
Puntos clave
- PixelRAG corta cada página en teselas de 875 x 1024 píxeles y guarda un vector de 2048 dimensiones por tesela, calculado con Qwen3-VL-Embedding-2B ajustado con LoRA.
- En el artículo, la exhaustividad entre los tres primeros resultados (Recall@3) en NQ-Tables sube del 37,2 % con Trafilatura al 51,1 %.
- La API pública sirve 26,3 millones de vectores en un índice de 216 GB, sin clave.
- En mi prueba acertó el artículo entre los tres primeros en 10 de 10 preguntas en inglés y en 8 de 10 en español, con 1,9 s de mediana.
pip install pixelrag0.4.0 falla en Linux arm64 por una dependencia,cef-capi-py, que el propio código no importa. En x86_64 se instala, pero ocupa 6,3 GB con las extras de índice.
¿Qué es PixelRAG?
PixelRAG es el código del artículo PIXELRAG: Web Screenshots Beat Text for Retrieval-Augmented Generation[1], enviado a arXiv el 1 de junio de 2026. Lo firman Yichuan Wang y Zhifei Li como autores principales, con Matei Zaharia, Joseph E. Gonzalez y Sewon Min como directores, desde Sky Lab, BAIR y Berkeley NLP. El repositorio de GitHub[2] tiene licencia Apache 2.0 y sumaba 10 680 estrellas el 28 de octubre de 2026.
Un RAG de texto descarga la página, la convierte a texto plano con un analizador como Trafilatura y la trocea en fragmentos. Por el camino se pierden tablas, fichas, gráficos y maquetación. PixelRAG se salta ese paso: renderiza la página en un navegador, guarda la captura y deja que un modelo de visión y lenguaje (VLM) lea la respuesta en los píxeles. Si necesitas repasar la base, empieza por qué es un embedding vectorial.
El resumen del artículo lo plantea así: "Our results challenge the necessity of text representations in web retrieval, suggesting that web RAG can operate directly in the web’s native visual form while improving both performance and efficiency."
¿Cómo funciona la búsqueda sobre capturas de pantalla?
La búsqueda tiene tres piezas: el renderizado, el índice y el lector. Así reparte el trabajo cada una:
- Renderizado. La herramienta
pixelshotabre la página en Chromium con una anchura de 875 píxeles, la de Wikipedia, y corta la captura completa en teselas de 1024 píxeles de alto. La Wikipedia del artículo, con 7 millones de páginas, da 30 millones de teselas. - Índice. Cada tesela pasa por Qwen3-VL-Embedding-2B, ajustado con LoRA sobre capturas, y sale un único vector de 2048 dimensiones. El índice FAISS completo ocupa 120 GB en fp16. Construirlo llevó 2 días en una máquina con 128 núcleos, 2 TB de RAM y 8 GPU H100.
- Lector. La pregunta se convierte en vector con el mismo modelo, FAISS devuelve las teselas más parecidas y un VLM, Qwen3-VL-4B en el artículo, responde mirando las imágenes.
El vector único por tesela es una decisión de escala. Los recuperadores de documentos como ColPali guardan un vector por parche de imagen: unos 875 vectores de 128 dimensiones por tesela. El artículo calcula que, con 30 millones de teselas, ese índice ocuparía unos 6,5 TB. Con un vector por tesela el índice cabe en la RAM de una sola máquina.
La API pública[3] funciona en dos pasos, sin clave: buscas y luego descargas la tesela. Esta petición pide los tres mejores resultados para una pregunta:
curl -s -X POST https://api.pixelrag.ai/search \
  -H "Content-Type: application/json" \
  -d '{"queries": [{"text": "How tall is Mount Teide?"}],
       "n_docs": 3}'
Cada resultado trae url (el título del artículo), score, article_id, tile_index y chunk_index. Con esos tres identificadores descargas la imagen de la tesela:
curl -s https://pixelrag.ai/api/tile/742671/0/0 -o tesela.png
La misma petición de búsqueda acepta una imagen en base64 en el campo image, sola o junto al texto. La API solo busca: para responder necesitas pasar las teselas a un VLM tuyo.
¿Cuánto mejora frente a un RAG de texto según el artículo?
El artículo mide mejoras en los seis bancos de pruebas, y la diferencia más grande en recuperación está en las preguntas que dependen de tablas. La tabla 1 compara PixelRAG con dos RAG de texto sobre la misma Wikipedia: uno que extrae el texto con mwparserfromhell y otro con Trafilatura. El gráfico muestra la exhaustividad entre los tres primeros resultados (Recall@3) de Trafilatura y de PixelRAG ajustado:
La precisión de la respuesta final sube menos que la recuperación. En NQ pasa del 55,9 % al 58,7 %, y en SimpleQA del 71,6 % al 78,8 %. En LiveVQA, con noticias, sube del 59,0 % al 70,0 %. El resumen habla de una mejora de hasta el 18,1 % sobre las bases de texto y de hasta 3 veces menos coste en tokens al bajar la resolución de las teselas.
Hay una condición que el artículo deja clara en su sección 5.6: el lector tiene que leer bien texto en imágenes. Los modelos pequeños de Llama 3.2 Vision y Qwen2-VL quedan más de 12,5 puntos por debajo del RAG de texto. El cruce llega con Qwen3-VL-4B, con un 70,5 % frente al 69,0 %. Si en tu propio equipo usas un modelo multimodal pequeño, como los de esta comparativa de modelos multimodales con 16 GB de VRAM, comprueba primero que lee bien capturas de texto.
¿Qué tal busca la API pública en inglés y en español?
En mi prueba, la API encontró el artículo correcto en casi todas las preguntas en inglés. En español falló 2 de 10, las dos con nombres que cambian entre idiomas: Tajo y núcleo Linux. Hice 10 preguntas factuales sobre artículos de Wikipedia, cada una en inglés y en español, con n_docs a 3, el 28 de octubre de 2026 desde España. Conté un acierto cuando el artículo esperado salía primero o entre los tres primeros.
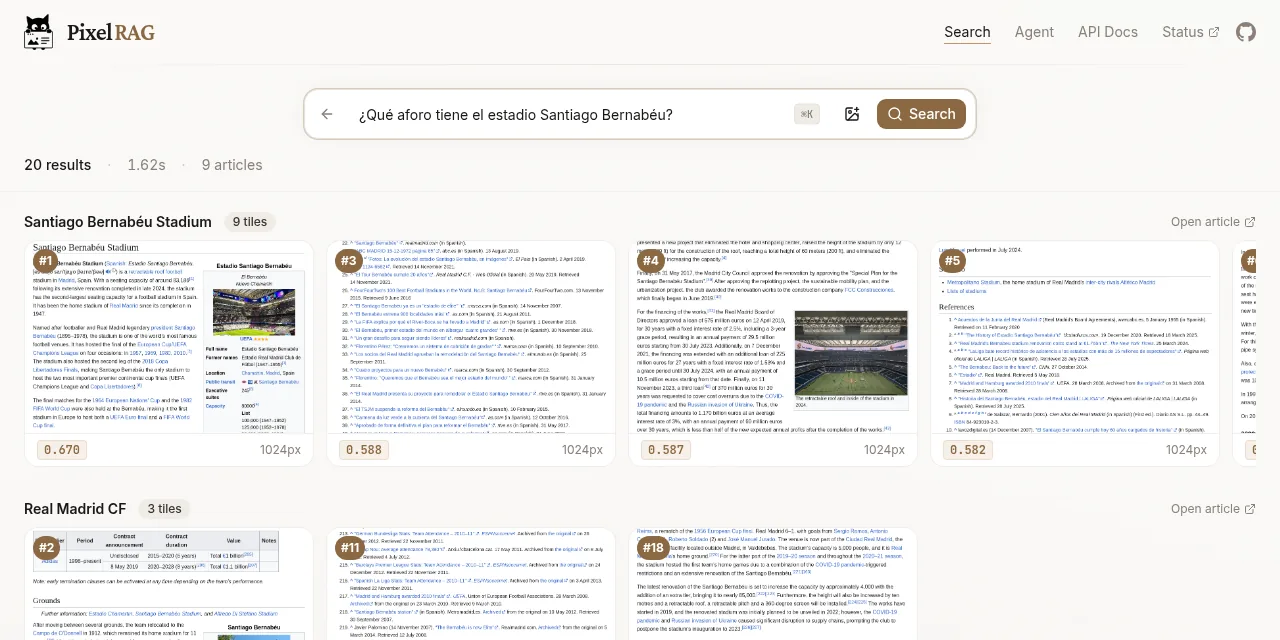
La latencia fue estable: 1,88 s de mediana en inglés y 1,90 s en español, con todas las peticiones entre 1,82 s y 2,02 s. La demo web tardó 1,62 s en la consulta de la portada.
Los fallos explican bien cómo funciona el sistema por dentro:
- "¿Cuánto mide el río Tajo?" devolvió Tagil, Taymura y Taoer River. El artículo en inglés se llama Tagus, y el vector de la pregunta cayó cerca de títulos que empiezan por "Ta". En inglés, la misma pregunta acertó a la primera
- "What license is the Linux kernel released under?" puso primero la página de desambiguación de Lennox. La tesela era su pie, con la línea "Linux, an open-source Unix-like operating-system kernel". Linux kernel salió segundo. En español no apareció entre los tres primeros
- "¿Qué aforo tiene el estadio Santiago Bernabéu?" devolvió primero la ficha del estadio, con la capacidad a la vista. Es justo el caso que vende el proyecto: el dato está en una tabla, no en un párrafo
La lección práctica es que el índice público es la Wikipedia en inglés. Las preguntas en español funcionan porque el modelo de Qwen3-VL es multilingüe, pero los nombres propios que cambian entre idiomas son donde falla. Para un corpus en español tendrías que construir tu propio índice.
¿Se puede instalar PixelRAG en tu propio equipo?
En Linux arm64 no, con la versión 0.4.0 de PyPI. La instalación se para antes de descargar nada:
Because cef-capi-py==131.3.5 has no wheels with a matching
platform tag (e.g., `manylinux_2_41_aarch64`) and
pixelrag==0.4.0 depends on cef-capi-py, we can conclude
that pixelrag==0.4.0 cannot be used.
cef-capi-py solo publica paquetes para Linux x86_64, macOS y Windows. La incidencia #197[4], del 27 de octubre, explica que ningún archivo del proyecto lo importa y que ocupa unos 296 MB. Hasta que lo quiten, en una Raspberry Pi o en un servidor Ampere no lo instalas sin tocar las dependencias. En un Mac con Apple Silicon sí hay paquete.
En x86_64 sí se instala. Lo probé en un contenedor python:3.12-slim para linux/amd64, emulado en un Mac con Apple Silicon, así que los tiempos de CPU son peores que en un x86 nativo:
pip install 'pixelrag[index,serve,pdf]==0.4.0'tardó 8 min 16 s y dejó 6,3 GB ensite-packages, casi todo PyTorch con las bibliotecas de CUDApixelshotdescarga la primera vez un Chromium sin interfaz de 81 MB, comprimido con zstd. Sin el paquetezstdfalla conzstd not found- La configuración del README con
path: ./paper.pdfrenderiza 0 documentos en la 0.4.0, porque la fuente local solo recorre carpetas. El arreglo está en la rama principal, pero aún no en PyPI: apuntapatha una carpeta con el PDF - Indexar 4 páginas del PDF del artículo tardó 20 min 27 s: 8 minutos de descarga del modelo, de 4 GB, y unos 3 minutos por página en CPU con fp32
El índice resultante ocupa 2,5 MB. Servido, el proceso usó 8,7 GB de RAM y cada búsqueda tardó entre 4,5 s y 5,5 s, porque el modelo de 2B convierte la pregunta en vector en la CPU. La consulta "Overview of PixelRAG and the diagram" devolvió la página 2, la que anuncia el README.
Al servir el índice reproduje la incidencia #196[5]: el comando del README, con solo --index-dir, se para al arrancar con FileNotFoundError: './articles.json'. El servidor busca articles.json y tiles en el directorio actual, no en el del índice. Pásale las dos rutas:
pixelrag serve --index-dir ./my_index \
  --articles-json ./my_index/articles.json \
  --tiles-dir ./my_index/tiles --port 30001
¿Cuándo compensa PixelRAG frente a un RAG de texto?
PixelRAG compensa cuando las respuestas viven en tablas, fichas, gráficos o maquetación que un extractor de texto rompe. Para documentos de texto corrido en tu idioma, un RAG de texto sigue siendo más barato de montar. Estas son las diferencias que pesan al elegir:
| Criterio | RAG de texto | PixelRAG |
|---|---|---|
| Qué guarda | Fragmentos de texto | Capturas de 875 x 1024 px |
| Tablas y fichas | Se pierden o se desordenan | Se leen en la imagen |
| Lector | Cualquier LLM | VLM de 4B o más |
| Vectores | Uno por fragmento | Uno de 2048 dimensiones por tesela |
| Índice de Wikipedia en el artículo | No lo publica | 120 GB en fp16 |
| Tokens por resultado | Pocos | Más, rebajables con menos resolución |
| Plataformas del paquete | Todas | x86_64, macOS y Windows (0.4.0) |
Si ya tienes un RAG de texto en producción, no hace falta tirarlo. Un RAG híbrido puede añadir una búsqueda por capturas solo para las páginas con tablas, y los patrones de RAG con PostgreSQL y pgvector en producción siguen valiendo para guardar los vectores. Si lo que falla es el orden de los resultados y no el formato, prueba antes un reranking local con llama.cpp y pgvector.
Preguntas frecuentes
¿PixelRAG necesita GPU?
No, pero en CPU es lento. En mi prueba con x86_64 emulado, cada página tardó unos 3 minutos en indexarse y cada búsqueda unos 5 s. Según el README, el PDF de ejemplo completo tarda unos 3 minutos en un Mac con Apple Silicon y 1 minuto con GPU.
¿Busca en otros idiomas además del inglés?
Sí, porque Qwen3-VL es multilingüe. En mi prueba, 8 de 10 preguntas en español encontraron el artículo correcto entre los tres primeros, frente a 10 de 10 en inglés. Los fallos fueron nombres que cambian entre idiomas, como Tajo y Tagus.
¿La API pública responde a las preguntas?
No. La API devuelve las teselas más parecidas y su imagen. La respuesta la genera tu VLM, o el agente de la demo web en pixelrag.ai.
Conclusión
PixelRAG demuestra que se puede buscar en la web sin convertirla a texto, y sus cifras ganan justo donde el texto falla: tablas y fichas. La API pública permite probarlo hoy sin instalar nada, y en mi prueba acertó en 10 de 10 preguntas en inglés entre los tres primeros resultados. El paquete 0.4.0 aún no se instala en Linux arm64, en x86_64 necesita dos arreglos a mano para indexar y servir, y para responder necesitas un VLM de 4B o más. Si tus documentos tienen tablas que tu RAG actual destroza, prueba la API con tus preguntas antes de construir un índice propio.
Fuentes: [1] PixelRAG en GitHub[2], [2] arXiv 2606.28344, PIXELRAG: Web Screenshots Beat Text for Retrieval-Augmented Generation[1], [3] Documentación de la API de PixelRAG[3], [4] Estado del índice público de PixelRAG[6], [5] Incidencia 197 sobre cef-capi-py[4], [6] Incidencia 196 sobre pixelrag serve[5], [7] pixelrag en PyPI[7].
Fuentes
Código fuente
Accede a todo el código fuente de este artículo en GitHub.
Ver en GitHub