Sin GPU, en una CPU arm64 de 18 núcleos con llama.cpp v0.4.1, Maple-Preview generó 172,84 tokens/s con 6 hilos: el doble que MiniCPM5-2B y 3,6 veces Spark-X2.5-4B. A cambio ocupa 5,79 GiB de RAM y siempre razona. MiniCPM5 cabe en 3,27 GiB y Spark escribe mejor en español. Los tres inventaron datos.
Desde Ollama 0.34.1, ollama create ya no convierte ni cuantiza pesos safetensors. Para importar un modelo de Hugging Face, descárgalo con hf download, conviértelo a GGUF con convert_hf_to_gguf.py de llama.cpp, cuantízalo con llama-quantize y créalo desde un Modelfile. Con MiniCPM5-2B en CPU, las tres fases tardaron 35 s, 21 s y 2 s.
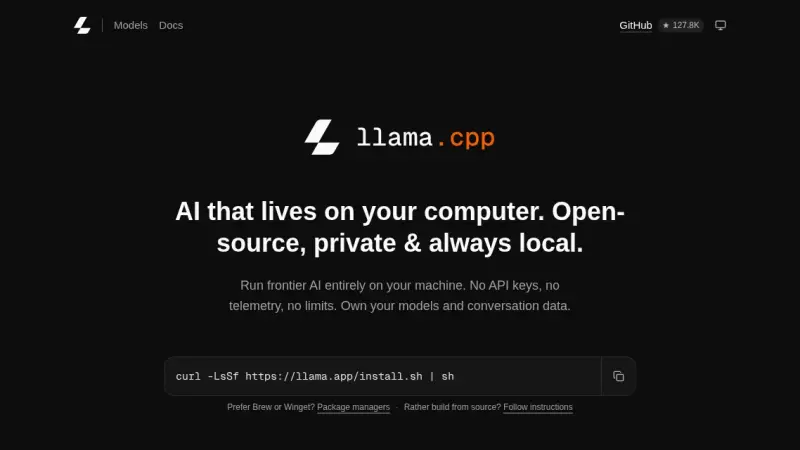
Para instalar llama.cpp tienes cuatro vías: el script de llama.app, que deja un binario llama de 15 MB en ~/.local/bin; Homebrew; la imagen Docker server-v0.4.1; o CMake. Las probé el 14 de septiembre de 2026 en Linux arm64 con Gemma 4 E2B, en la terminal con llama cli y como API compatible con OpenAI.
llama.cpp es la biblioteca en C++ que impulsa a Ollama y gran parte del ecosistema de LLM locales. En 2024 sumó decodificación especulativa con aceleraciones de dos a tres veces, un servidor RPC para repartir capas entre máquinas y un formato GGUF estable. Ollama basta para el 90% de los casos; ir directo compensa con hardware poco común.
Ollama se consolidó en 2024 como el estándar para ejecutar LLMs en local. Empaqueta llama.cpp en un binario único con interfaz de línea de comandos estilo Docker y API compatible con OpenAI. Phi-3 Mini corre en 4 GB; Llama 3.1 8B Q4 necesita 6 GB. Para tráfico de producción a escala, vLLM sigue siendo la opción correcta.
LM Studio es una aplicación de escritorio para Mac, Windows y Linux que descarga y ejecuta modelos de lenguaje grandes en tu propio equipo, con una interfaz de chat pulida y sin necesidad de terminal. Incluye una API compatible con OpenAI y RAG con tus documentos. Para uso individual gana a Ollama en experiencia de usuario; para equipos o producción conviene OpenWebUI, vLLM o TGI.
Con cuantización, los pesos de un modelo se guardan con menos bits (4, 5 u 8 en vez de 16), así que Llama 2 13B pasa de 26 GB a unos 7,5 GB. Con llama.cpp corre en un portátil normal de 16 GB de RAM sin GPU dedicada, y la pérdida de calidad es menor de lo que la intuición sugiere.
7 min3624,5
Usamos cookies propias y de terceros para analizar el tráfico del sitio. Puedes aceptarlas, rechazarlas o configurar tu elección.
Más información sobre las cookies
Preferencias de cookies
NecesariasImprescindibles para el funcionamiento del sitio. Siempre activas.
AnalíticasNos ayudan a entender cómo se usa el sitio (Google Analytics).