Cómo instalar oMLX en M5 Max 128 GB y exprimirlo al máximo
Índice de contenidos
- Preguntas rápidas
- Instalación
- Ajustes del servidor para 128 GB
- Stack de modelos para multi-LLM
- Apuntar Claude Code al endpoint local
- Benchmark del hardware real
- Ajustes avanzados para el máximo rendimiento con la 0.6.4
- Qué método de aceleración usar con cada modelo
- Descargar los borradores
- Activar Lightning MTP
- Activar VLM MTP con un borrador externo
- DFlash solo compensa con prompts cortos
- Prefill en el Neural Engine: sin ganancia con Lightning MTP
- Los ajustes globales que sí cuentan
- Lo que no acelera
- Benchmarks con la 0.6.4 en este M5 Max
- Cómo se midió
- Velocidad por la API con respuestas de código
- Velocidad por la API con 15.000 tokens de contexto
- Benchmark integrado por longitud de prompt
- Frente a la 0.3.8
- Verificación de punta a punta
- Conexión SSH desde otro Mac
- Qué ha cambiado desde la 0.3.8
- Decodificación especulativa Lightning MTP
- Núcleos propios, con una nota para M5
- Cuantización oQ y oQe
- El motor neuronal y el arranque en frío
- Endpoints nuevos
- Autenticación con subclaves
- Los nombres de los ajustes
- Otras piezas que no existían
- Fuentes y lecturas
- Qué cuesta la alternativa: el mismo modelo en la nube europea
- Por qué la inferencia local simplifica el cumplimiento
- Preguntas frecuentes
- ¿Hace falta configurar una API key para usar oMLX solo en local?
- ¿Puedo usar Claude Code desde un MacBook contra el oMLX de un Mac Studio?
- ¿Siguen valiendo los benchmarks del post si instalo la 0.6.4?
- Fuentes
Actualizado: 2026-09-15
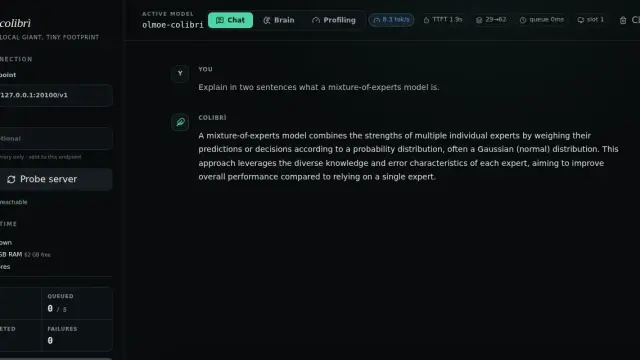
oMLX es un servidor de inferencia LLM construido sobre MLX, el framework que Apple publicó en diciembre de 2023 para Apple Silicon. Trae continuous batching, KV cache en dos niveles (RAM + SSD) y API compatible con OpenAI y Anthropic.
En un Mac M5 Max con 128 GB de memoria unificada caben tres o cuatro modelos grandes a la vez con TurboQuant 3,5-bit en KV cache. Son suficientes para alimentar chat, agente e IDE simultáneamente. Esta guía recoge la configuración probada en mayo de 2026 para sacarle el máximo a esa combinación.
Preguntas rápidas
¿Qué versión de oMLX uso y cómo se instala? La 0.6.4 (publicada el 29 de agosto de 2026, Apache 2.0). La vía directa: descárgate el .dmg desde GitHub Releases[1], ábrelo y arrastra la app a Aplicaciones. También puedes instalar con brew tap jundot/omlx https://github.com/jundot/omlx y brew install jundot/omlx/omlx.
La primera visita a http://localhost:8000/admin pide la clave de API. El recorrido completo de la vía de Homebrew, incluido el servicio que arranca solo, está en instalar, actualizar y desinstalar oMLX con Homebrew.
¿Qué ajuste de TurboQuant tiene sentido en 128 GB? 3,5-bit. El análisis independiente de vLLM publicado el 11 de mayo de 2026[2] muestra que 3,5-bit iguala la calidad de precisión completa con ~4x menos memoria para el KV cache. En M5 Max esto convierte contextos de 128k en algo que cabe junto a otros modelos cargados, en vez de saturar la RAM.
¿Cuánto más rápido va con los ajustes avanzados de la 0.6.4? Entre 1,19x y 1,88x generando código, y entre 1,07x y 1,47x con 15.000 tokens de contexto, medido por la API el 15 de septiembre de 2026. La mayor ganancia la dio Lightning MTP en Qwen3.8-27B oQ4e, de 21,1 a 39,7 tok/s, y hace falta una versión del modelo que conserve la cabeza MTP. El detalle está en los ajustes avanzados.
¿Qué modelos cargo a la vez en 128 GB?
Principal: unsloth/Qwen3.6-35B-A3B-MLX-8bit (37,7 GB, MoE con 3B activos). Ayudante rápido: Qwen3-14B-Instruct-mlx-4bit (8 GB). Visión: Qwen2.5-VL-32B-mlx-4bit (18 GB).
Embeddings: BGE-M3-mlx (1,2 GB). Reranker: ModernBERT-base-mlx (150 MB). Suma cómoda: ~65 GB con margen.
¿Cómo apunto Claude Code al endpoint local? Desde la 0.5.0 la vía corta es omlx launch claude, que exporta las variables por ti. A mano: exporta ANTHROPIC_BASE_URL=http://127.0.0.1:8000, ANTHROPIC_AUTH_TOKEN=<tu_api_key> y los tres ANTHROPIC_DEFAULT_*_MODEL (Opus/Sonnet/Haiku).
Arranca con claude --bare para reducir el system prompt a ~1.795 tokens. La sección Claude Code with oMLX del dashboard te construye el comando completo.
¿Sustituye a Claude Opus 4.7? No de uno a uno. Claude Code está afinado para el formato tool-use de Claude; un modelo no-Claude detrás del endpoint pierde fiabilidad en bucles agentic. Tiene sentido para trabajo offline, datos sensibles que no deben salir del Mac, o como fallback cuando api.anthropic.com te está limitando.
Instalación
Descarga el .dmg desde GitHub Releases[1], ábrelo y arrastra la app a la carpeta Aplicaciones. Con eso ya tienes el servidor y el panel admin. Abre la app y el daemon arrancará en segundo plano con un icono en la barra de menú.
También puedes instalar con Homebrew:
brew tap jundot/omlx https://github.com/jundot/omlx
brew install jundot/omlx/omlx
omlx start                          # servicio supervisado por launchd
omlx serve --model-dir ~/models     # o en primer plano
La primera visita a http://localhost:8000/admin pide la API key. Por defecto, oMLX arranca sin API key configurada (campo vacío), lo que es cómodo para pruebas locales. Si la instancia solo escucha en 127.0.0.1 es seguro dejarlo así; el momento en que la expongas a la LAN o la compartas, ve a Settings → Auth & Info y configura una cadena larga aleatoria. La sección admite más de una clave simultánea.

Ajustes del servidor para 128 GB
Settings → Global Settings concentra toda la configuración. Las decisiones que importan en una máquina con 128 GB:
-
Server → Host:
Localhost only (127.0.0.1). Si la abres a la LAN, pon auth real delante antes de hacerlo. -
Server → Port:
8000por defecto. -
Resource Management → Memory Limit (Total):
Auto. oMLX resta lo que reserva macOS; en 128 GB acabas con unos 110-114 GB para inferencia. -
Resource Management → Memory Limit (Models Only):
Auto. Deja un porcentaje para activaciones, KV cache y procesos auxiliares. -
Resource Management → Hot Cache Limit:
10%. Tier de KV cache intermedio en RAM. Con TurboQuant activado para los modelos que lo soportan (más abajo), 10% es el ajuste probado en la práctica para 128 GB. Con TurboQuant desactivado y un solo modelo cargado puedes bajarlo a Off, pero deja de ganar. -
Resource Management → Cold Cache Limit (SSD Cache):
10%. Unos 80 GB de SSD para tokens fríos sin saturar el disco. -
Resource Management → Max Concurrent Requests:
16. Cómodo para un usuario con un agente, una sesión de chat y un IDE pidiendo a la vez. Sube a 32 si compartes con un equipo pequeño. -
Resource Management → Idle Timeout:
None. Mantén los modelos calientes; así el primer token pasa de la escala de segundos a menos de un segundo. -
Generation Defaults → Max Context Window:
256000como default global. La familia Qwen3.6 lleva contextos largos sin desplomarse y con TurboQuant la RAM efectiva da para ello; cada modelo se puede limitar después en Model Settings. -
Generation Defaults → Max Tokens:
64000. Cota superior por respuesta. Subirla más solo tiene sentido si vas a generar libros enteros de una sentada. -
Generation Defaults → Temperature:
1.0para uso general,0.2-0.5para modelos de código. -
Model Settings → Experimental Features → TurboQuant KV Cache: actívalo a
3.5-biten los modelos densos grandes. El análisis independiente de vLLM publicado el 11 de mayo de 2026[2] analiza los modelos de Google. Ahí, 3,5-bit iguala la calidad de precisión completa con ~4x menos memoria para el KV cache. En M5 Max eso permite contextos de 128k que con FP16 no caben.En la 0.6.4 no se combina con VLM MTP, y en estas pruebas no aceleró la generación; si lo que buscas es velocidad, mira los ajustes avanzados.

Stack de modelos para multi-LLM
Con 128 GB caben juntos un modelo principal grande, un ayudante rápido, un VLM, embeddings y un reranker. Descárgalos desde Models → Downloader pegando la URL del repo en Hugging Face.
La recomendación que está aguantando en mayo de 2026 viene de la práctica de quienes ya están corriendo Claude Code contra oMLX en M5 Max (ver el gist de Diego R. Baquero[3] como referencia): la familia Qwen 3.6 35B-A3B de Unsloth, en MoE con ~3B parámetros activos por token. En 128 GB el 8-bit cabe sin pestañear:
-
Principal (chat + código + razonamiento):
unsloth/Qwen3.6-35B-A3B-MLX-8bit(~37,7 GB). MoE 35B con 3B activos. Es el todoterreno: chat largo, código, agentes. En 128 GB cabe junto con el resto sin estrechar. -
Alternativa más comprimida:
unsloth/Qwen3.6-35B-A3B-UD-MLX-4bit(~21,6 GB) si quieres tener dos modelos principales cargados a la vez. Pierde un punto de calidad respecto al 8-bit pero deja sitio para experimentar. -
Razonamiento denso (cuando el MoE no llega):
Mistral-Large-2-123B-Instruct-mlx-4bit(~70 GB) oLlama-3.3-70B-Instruct-mlx-4bit(~40 GB). Para razonamiento profundo en un solo paso, donde una arquitectura densa rinde mejor que un MoE de activación pequeña. -
Ayudante rápido:
Qwen3-14B-Instruct-mlx-4bit(~8 GB). Para tareas baratas en agentes, parsing y resúmenes. -
Visión:
Qwen2.5-VL-32B-Instruct-mlx-4bit(~18 GB) cubre OCR, descripción de imágenes y razonamiento multimodal. -
Embeddings:
BGE-M3-mlx(~1,2 GB), denso + sparse + multi-vector en un solo modelo. -
Reranker:
ModernBERT-base-mlx(~150 MB) para cerrar el bucle de un RAG decente.
Carga concurrente cómoda con Qwen3.6 35B-A3B 8-bit como principal + 14B helper + VL-32B + embeddings + reranker: unos 65-70 GB. Si añades el Mistral Large 2 123B encima para razonamiento denso, te plantas en ~135 GB nominales. La política LRU mueve los inactivos al SSD, así que la convivencia funciona en la práctica para sesiones que no usan todo a la vez. Pin del modelo principal desde Model Manager para que no lo evicte nunca.
Apuntar Claude Code al endpoint local
oMLX expone una API compatible con Anthropic en http://127.0.0.1:8000. En las versiones actuales las rutas cuelgan de /v1: POST /v1/messages y POST /v1/messages/count_tokens. Claude Code respeta ANTHROPIC_BASE_URL, así que apuntar el CLI a tu Mac es cuestión de exportar variables. Antes, desactiva el header de atribución en la config global de Claude Code para que la pasarela no añada ruido al prompt:
Desde la 0.5.0 hay un atajo que hace todo esto por ti y que no existía cuando se escribió esta receta:
omlx launch claudeFija ANTHROPIC_BASE_URL contra tu servidor, pone en ANTHROPIC_AUTH_TOKEN la clave configurada (o omlx si no hay ninguna), vacía ANTHROPIC_API_KEY para forzar el uso de la dirección base, sube API_TIMEOUT_MS a 3.000.000 y desactiva el tráfico no esencial. También ajusta CLAUDE_CODE_MAX_CONTEXT_TOKENS y CLAUDE_CODE_AUTO_COMPACT_WINDOW a lo que el motor puede de verdad, que es lo que hacía a mano la opción de escalado de contexto. Exige una ventana mínima de 48.000 tokens y no arranca si el modelo elegido no llega. Hay órdenes equivalentes para Codex, OpenCode, OpenClaw, Hermes y Pi, descritas en la guía del panel y la línea de comandos.
La receta manual de abajo sigue funcionando y es la que conviene si quieres control fino sobre cada variable.
~/.claude/settings.json:
{
  "env": {
    "CLAUDE_CODE_ATTRIBUTION_HEADER": "0"
  }
}
Y el comando de arranque:
export ANTHROPIC_BASE_URL=http://127.0.0.1:8000
export ANTHROPIC_AUTH_TOKEN=<tu_api_key>
export ANTHROPIC_DEFAULT_OPUS_MODEL=unsloth/Qwen3.6-35B-A3B-MLX-8bit
export ANTHROPIC_DEFAULT_SONNET_MODEL=unsloth/Qwen3.6-35B-A3B-MLX-8bit
export ANTHROPIC_DEFAULT_HAIKU_MODEL=Qwen3-14B-Instruct-mlx-4bit
export ANTHROPIC_DEFAULT_MODEL=unsloth/Qwen3.6-35B-A3B-MLX-8bit
export API_TIMEOUT_MS=600000
export CLAUDE_CODE_USE_BEDROCK=0
export DISABLE_NONESSENTIAL_TRAFFIC=1
claude --bare
El flag --bare salta hooks, LSP, plugin sync y auto-memory, dejando el system prompt de Claude Code en torno a 1.795 tokens (frente a los miles que ocupa con todo cargado). Para trabajo offline con un modelo local es lo más razonable: cada token del system prompt es ancho de banda que tu Mac no tiene que regalar. Quítalo cuando vuelvas a apuntar a api.anthropic.com.
El dashboard de oMLX construye este comando por ti en la sección Claude Code with oMLX. Eliges Opus, Sonnet y Haiku en tres desplegables y copias el comando listo para pegar.
La opción Context scaling for Claude Code la dejas en 64000. Claude Code pide 200k tokens por defecto, pero un modelo local rinde mejor con 64k que con 200k que no va a procesar bien. La opción escala los conteos reportados para que el auto-compact se dispare al tamaño objetivo.

Una advertencia: Claude Code está afinado para el formato de tool-use y los patrones de respuesta de Claude. Un modelo no-Claude detrás de ANTHROPIC_BASE_URL funciona para autocompletado y razonamiento, pero verás caídas en fiabilidad de tool calls y en bucles agentic. Tiene sentido para trabajo offline, datos sensibles que no deben salir del Mac, o como fallback cuando api.anthropic.com te está limitando. No es sustituto 1:1 de Claude Opus 4.7.
Benchmark del hardware real
Bench → Performance lanza pruebas contra tu hardware. El panel cubre prefill a ocho tamaños (pp1024, pp4096, pp8192, pp16384, pp32768, pp65536, pp131072, pp200000) y continuous batching a 2x, 4x y 8x de concurrencia. Los resultados van al leaderboard público de omlx.ai[4], y en My Submissions ves los tuyos junto a otras máquinas del mismo perfil. En la 0.6.4 la subida es automática al terminar cada prueba; cómo evitarla está en benchmarks con la 0.6.4.
Cifras de referencia medidas en M5 Max de 40 núcleos con 128 GB con oMLX 0.3.8, en mayo de 2026. No están extrapoladas: el leaderboard de omlx.ai[4] ya tiene envíos del propio M5 Max. El estudio independiente de vLLM sobre TurboQuant publicado el 11 de mayo de 2026[2] confirma los números para los modelos densos grandes:
- Qwen 3.6 35B-A3B 8-bit (MoE, 3B activos): 65-80 tok/s en decode con contextos cortos. Es el modelo que más cambia el día a día en este equipo. Benchmarks reales obtenidos en esta configuración:
| Test | TTFT | Decode TPS | E2E | Mem pico |
|---|---|---|---|---|
| pp1024/tg128 | 577 ms | 72,4 tok/s | 2,35s | 38,5 GB |
| pp4096/tg128 | 1.293 ms | 83,1 tok/s | 2,83s | 36,2 GB |
| pp8192/tg128 | 2.995 ms | 82,1 tok/s | 4,55s | 36,5 GB |
| pp32768/tg128 | 13.785 ms | 15,2 tok/s | 22,18s | 40,9 GB |
Continuous batching (pp1024 / tg128):
| Batch | Decode TPS | Speedup |
|---|---|---|
| 1x (baseline) | 72,4 tok/s | 1,00x |
| 2x | 87,1 tok/s | 1,20x |
| 4x | 123,8 tok/s | 1,71x |
| 8x | 237,7 tok/s | 3,28x |
-
Llama 3.3 70B 4-bit: 14-18 tok/s en decode.
-
Mistral Large 2 123B 4-bit con TurboQuant 3,5-bit en KV cache: 8-11 tok/s en decode. Lo importante para 128k de contexto es el pico de memoria: ~74 GB (con FP16 KV se va de 128 GB). El experimento de dasroot.net sobre contextos largos en M5 Max[5] documenta los mismos picos para el 104B densos.
-
gpt-oss-20b MXFP4-Q4 en M5 Max 40c según el envío público de oMLX[6] ronda los 100 tok/s en decode.
Las tablas anteriores son medición propia con la 0.3.8, y el 15 de septiembre de 2026 repetí las pruebas con la 0.6.4 en esta misma máquina. Sin ninguna aceleración, este modelo pasa de 15,2 a 77,9 tok/s con 32k de prompt. La decodificación especulativa añade entre 1,07x y 1,88x, según el modelo y el contexto. Las tablas nuevas están en benchmarks con la 0.6.4.
La compresión 4,41x del KV cache con TurboQuant (medida por vLLM en mayo de 2026) es lo que separa "tengo 128k de contexto pero no me cabe" de "lo tengo y puedo cargar otros dos modelos al lado". En 4-bit y 3,5-bit la calidad se mantiene cercana a precisión completa; en 3-bit empieza a sentirse en código y razonamiento largo.

Ajustes avanzados para el máximo rendimiento con la 0.6.4
En la 0.6.4, lo que más acelera este M5 Max es la decodificación especulativa, y el método que conviene depende del modelo. Por la API y con temperatura 0.6, Qwen3.8-27B oQ4e pasó de 21,1 a 39,7 tok/s con Lightning MTP. Con VLM MTP, Qwen3.6-35B-A3B 8-bit pasó de 79,7 a 117,5 tok/s. Todo se midió el 15 de septiembre de 2026 en la máquina de esta guía; el método y las tablas completas están en la sección de benchmarks.
Qué método de aceleración usar con cada modelo
oMLX 0.6.4 tiene tres métodos de decodificación especulativa y admite uno solo por modelo:
- Lightning MTP: usa la cabeza de predicción multitoken (MTP, multi-token prediction) que traen los propios pesos. Solo funciona si la conversión conservó los tensores
mtp.*. - VLM MTP: usa un borrador MTP externo de menos de 2 GB entrenado para ese modelo base. Solo actúa cuando no hay otra petición en curso.
- DFlash: usa un borrador de difusión por bloques de z-lab que propone hasta 16 tokens en cada pasada. Atiende las peticiones de una en una y lleva su propia caché de prefijos.
En los tres casos el modelo grande verifica cada token propuesto, así que la salida sale del modelo grande y no del borrador. Esto es lo que midió cada combinación en este M5 Max:
| Modelo | Método | Qué descargar | Tamaño | Decode generando código | Decode con 15.000 tokens de contexto |
|---|---|---|---|---|---|
| Qwen3.6-35B-A3B 8-bit | VLM MTP | mlx-community/Qwen3.6-35B-A3B-MTP-bf16 |
1,7 GB | 79,7 → 117,5 tok/s | 84,0 → 90,7 tok/s |
| Qwen3.6-35B-A3B oQ4e | Lightning MTP | Jundot/Qwen3.6-35B-A3B-oQ4e-mtp (modelo completo) |
21,6 GB | 100,2 → 119,2 tok/s | 100,2 → 115,5 tok/s |
| Qwen3.8-27B oQ4e | Lightning MTP | Jundot/Qwen3.8-27B-oQ4e-mtp (modelo completo) |
17,0 GB | 21,1 → 39,7 tok/s | 21,4 → 27,2 tok/s |
| Qwen3.8-27B 4-bit | VLM MTP | mlx-community/Qwen3.8-27B-MTP-bf16 |
0,87 GB | 24,1 → 34,5 tok/s | 21,7 → 23,2 tok/s |
| Gemma 4 12B 8-bit | VLM MTP | mlx-community/gemma-4-12B-it-assistant-bf16 |
0,88 GB | 27,4 → 50,5 tok/s | 26,6 → 39,2 tok/s |
| gpt-oss-20b | Ninguno | – | – | – | – |
Con Qwen3.6-35B-A3B, la versión oQ4e con Lightning MTP fue la más rápida en las dos pruebas y ocupa unos 15 GB menos que la de 8 bits. Con contexto largo y respuestas en prosa, todas las ganancias bajan porque el modelo grande acepta menos tokens del borrador, pero ninguna configuración fue más lenta que su base.
Si en la configuración de un Qwen aparece el aviso Config declares MTP layers but the weight files contain neither mtp.* tensors nor native nextn layers, la conversión eliminó la cabeza MTP. Es lo que hacen por defecto los conversores de mlx-lm. En este Mac les pasaba a los Qwen3.6-35B-A3B de mlx-community y a los Qwen3.8-27B de lmstudio-community. Tienes dos salidas: descargar una versión que la conserve, como las oQ4e-mtp que publica el autor de oMLX, o activar VLM MTP con un borrador externo.
Descargar los borradores
Los borradores se descargan como cualquier modelo. En Modelos → Descargas, pega el identificador del repositorio de Hugging Face y pulsa descargar. oMLX reconoce los borradores por su tipo y los marca como auxiliares; con Ocultar modelos auxiliares activado, tampoco salen en la lista de modelos de la API.
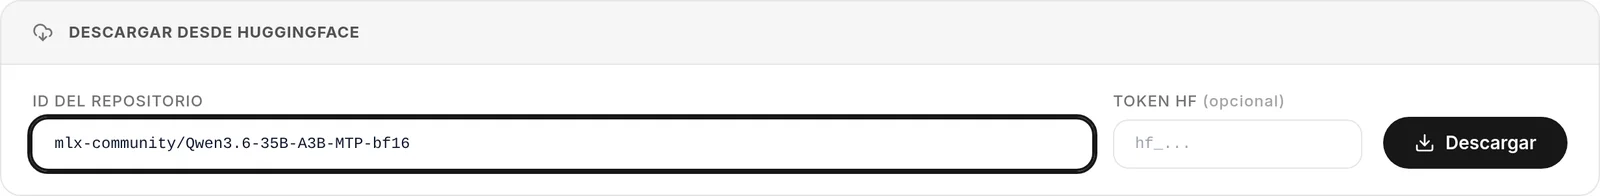
Activar Lightning MTP
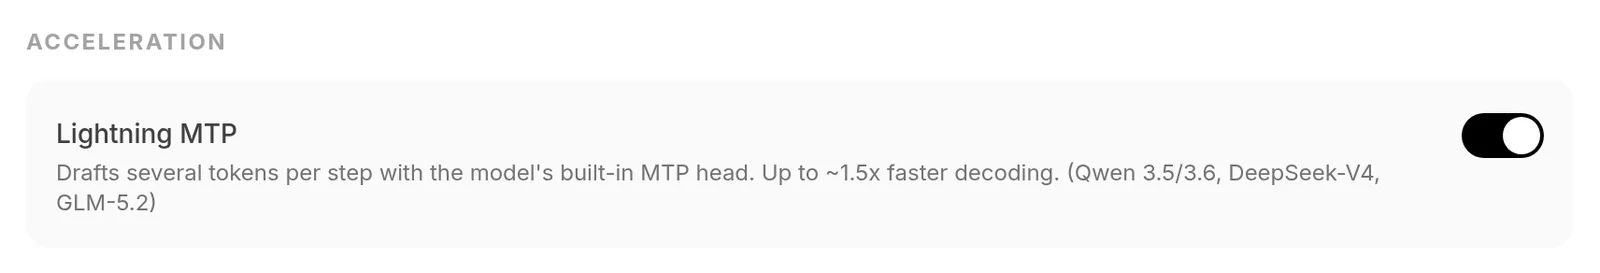
Con un modelo que conserva la cabeza MTP, abre Configuración → Configuración del Modelo, pulsa el engranaje del modelo y activa Lightning MTP en el bloque Acceleration. Al guardar, oMLX recarga el modelo.
En Qwen, el valor por defecto son 3 tokens de borrador por ciclo, y un controlador adaptativo lo ajusta según el acierto de cada respuesta. El registro de oMLX deja una línea por respuesta con ese acierto: en Qwen3.6-35B-A3B oQ4e rondó el 72-77 %, con 2,5-2,9 tokens emitidos por ciclo. Con muestreo determinista (greedy), la salida coincide con la del modelo sin MTP salvo diferencias numéricas mínimas. Con temperatura, el muestreo por rechazo mantiene la distribución del modelo grande.
Activar VLM MTP con un borrador externo
En el mismo bloque Acceleration, activa VLM MTP, elige el borrador en el desplegable y guarda. Antes conviene conocer tres condiciones del código de la 0.6.4:
- El modelo tiene que cargarse con el motor de visión. Los Qwen3.6 y Qwen3.8 multimodales lo hacen por defecto, pero en un modelo de solo texto el ajuste se ignora sin avisar.
- No se combina con TurboQuant ni con penalizaciones de repetición o de presencia. Los perfiles predefinidos de Qwen ponen
presence_penaltya 1,5 y lo desactivan. - Solo acelera cuando no hay otra petición en marcha. Con peticiones simultáneas, oMLX vuelve al batching normal.
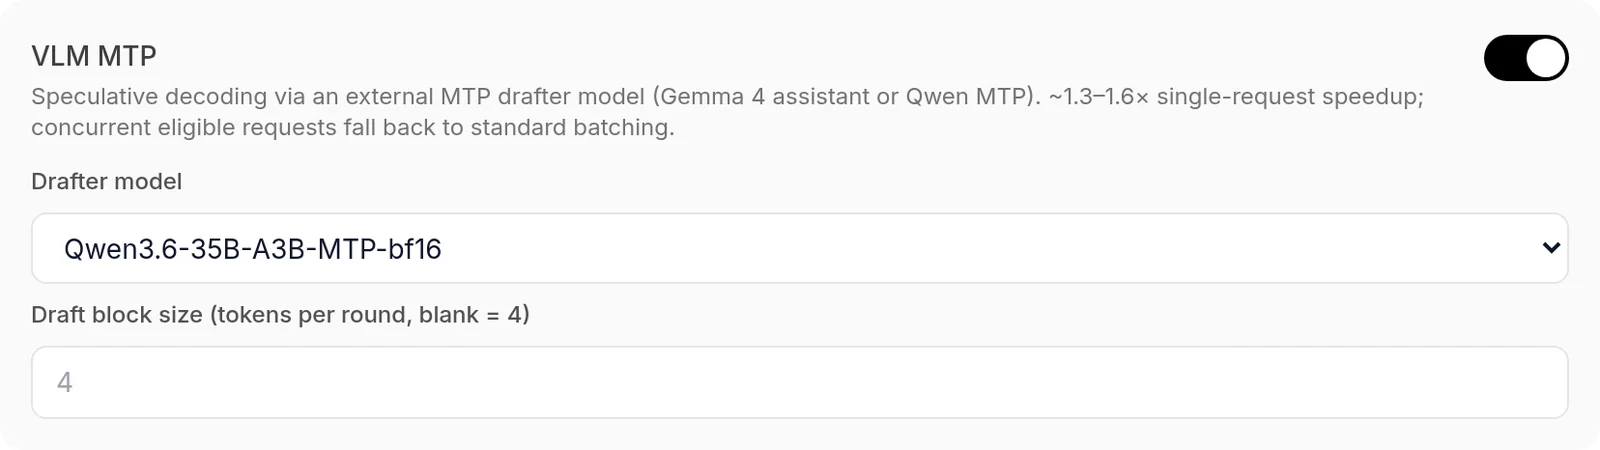
El mismo cambio se puede aplicar por la API de administración, que es lo cómodo si configuras más de un modelo o lo automatizas. El primer comando abre sesión con tu clave y guarda la cookie; el segundo actualiza los ajustes del modelo:
curl -c omlx.cookies -X POST http://127.0.0.1:8000/admin/api/login \
  -H "Content-Type: application/json" \
  -d '{"api_key": "tu_clave_de_api"}'

curl -b omlx.cookies -X PUT \
  http://127.0.0.1:8000/admin/api/models/Qwen3.6-35B-A3B-8bit/settings \
  -H "Content-Type: application/json" \
  -d '{"vlm_mtp_enabled": true,
       "vlm_mtp_draft_model": "Qwen3.6-35B-A3B-MTP-bf16"}'
El nombre del modelo en la ruta y el del borrador son los identificadores que muestra la lista de modelos. Para Lightning MTP, el cuerpo es {"mtp_enabled": true}. El endpoint rechaza cualquier campo que no conozca, así que una errata no pasa desapercibida.
DFlash solo compensa con prompts cortos
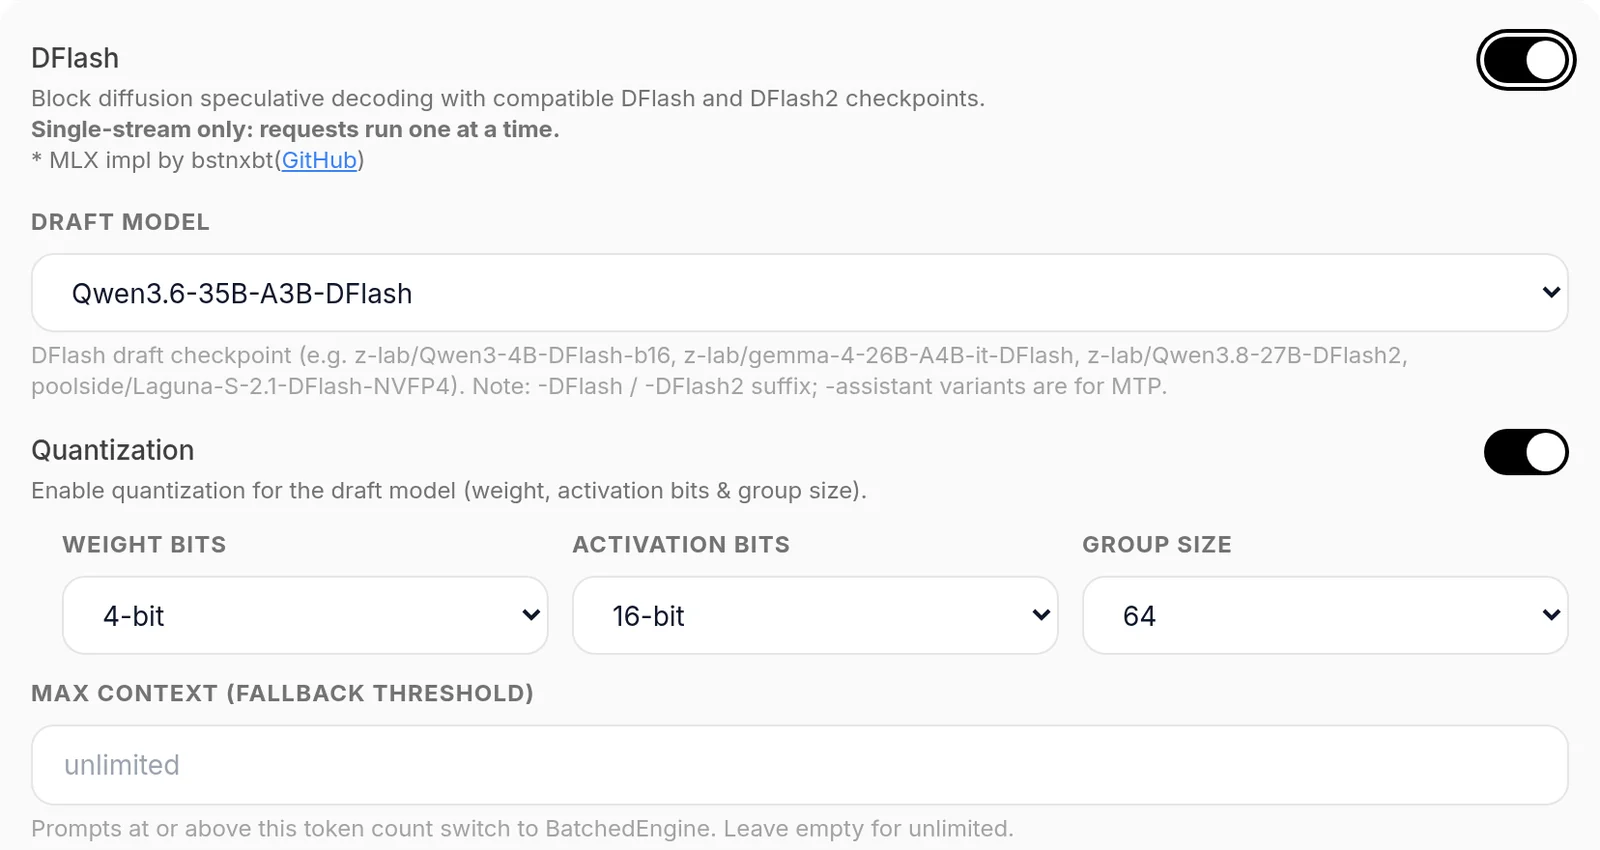
DFlash fue el método más rápido con prompts de 1.000 tokens y el peor con contexto largo. En el benchmark integrado, Qwen3.6-35B-A3B 8-bit subió de 92 a 112 tok/s con 1k de prompt, pero bajó de 78 a 17 tok/s con 32k. Qwen3.8-27B 4-bit bajó de 23,5 a 6,3 tok/s con 32k. Si usas Claude Code, que manda decenas de miles de tokens de contexto en cada turno, no lo actives.
Para un uso de prompts cortos, como chat o autocompletado, descarga el borrador de z-lab que corresponda: z-lab/Qwen3.6-35B-A3B-DFlash (0,77 GB), z-lab/Qwen3.8-27B-DFlash2 (3,85 GB) o z-lab/gemma4-12B-it-DFlash (1,46 GB). Actívalo en Acceleration → DFlash y cuantiza el borrador a 4 bits. En el 27B, el borrador a 4 bits dio 48,2 tok/s con 1k de prompt, frente a 36,9 tok/s en bf16, y ocupó 2,5 GiB menos.
Tiene dos límites más. Atiende una petición cada vez. Y aunque dflash_max_ctx manda las peticiones largas al motor normal, tras la primera de ellas DFlash queda desactivado hasta que recargas el modelo.
Prefill en el Neural Engine: sin ganancia con Lightning MTP
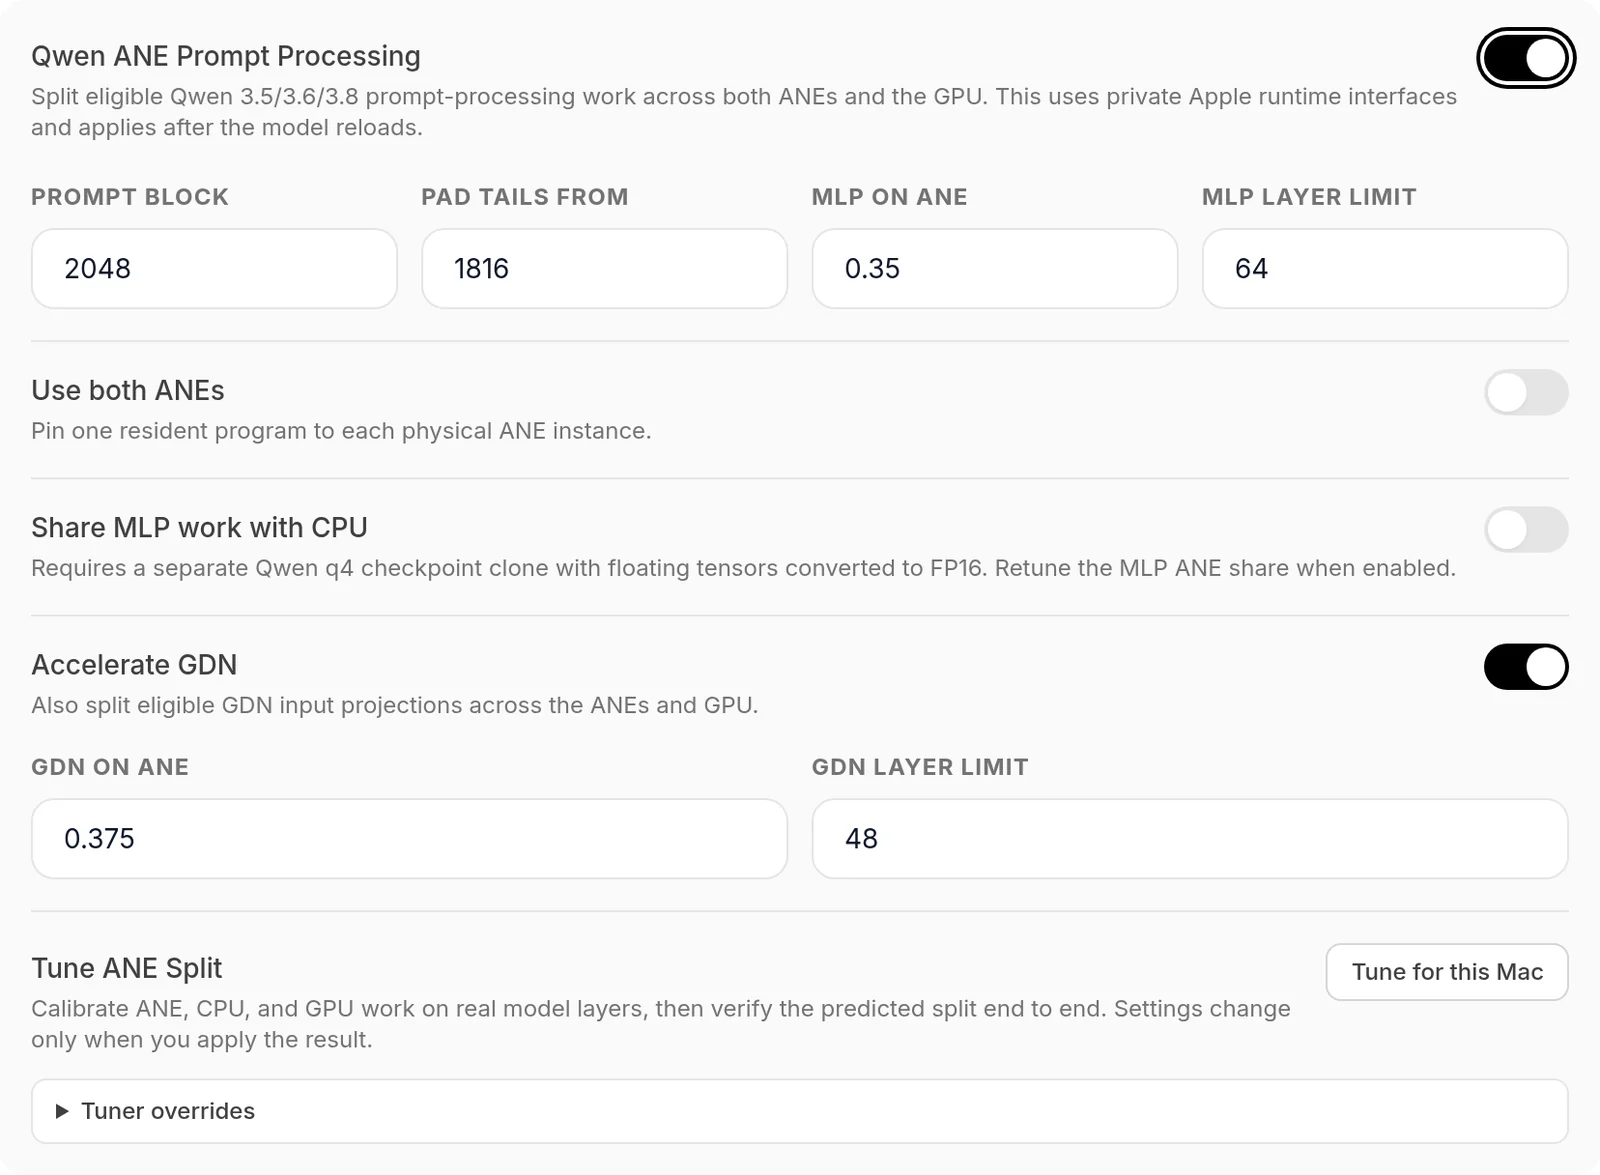
Qwen ANE Prompt Processing reparte parte del prefill de Qwen3.5, 3.6 y 3.8 entre el Neural Engine de Apple (ANE) y la GPU. El botón Tune for this Mac mide el reparto óptimo en tu máquina y no guarda nada hasta que aplicas el resultado. En Qwen3.8-27B oQ4e recomendó enviar al ANE el 35 % de los canales de las MLP y el 37,5 % de las capas GDN. Con ese reparto, el prefill de un prompt de 8.193 tokens pasó de 452 a 510 tok/s, un 12,8 % más.
Ese 12,8 % no se sostuvo con el modelo completo. Con el reparto aplicado y Lightning MTP activo, el benchmark integrado midió 505 tok/s de prefill con 4k de prompt, frente a 499 sin ANE, y 422 frente a 471 con 32k. Por la API, el primer token con 15.100 tokens de contexto tardó 34,8 s, frente a 35,2 s sin ANE. A cambio, el modelo cargado pasó de 16,0 a 20,7 GB y la carga de 2 a 20 s, así que en este Mac lo dejé desactivado.
Antes de afinarlo en un M5 Max, desactiva Use both ANEs en los ajustes del modelo. Ese modo está pensado para el M3 Ultra, que une dos chips y tiene dos ANE. Solo acelera prompts de 2.048 tokens o más; la generación sigue en la GPU.
El propio proyecto documenta tres costes. No es exacta bit a bit, porque el ANE trabaja con pesos recuantizados a INT8. Depende de interfaces privadas de Apple que una actualización de macOS puede romper, y alarga la carga del modelo. Si aun así la activas, enciende también Reuse Compiled ANE Programs en Configuración Global → Avanzado para no recompilar en cada arranque.
Los ajustes globales que sí cuentan
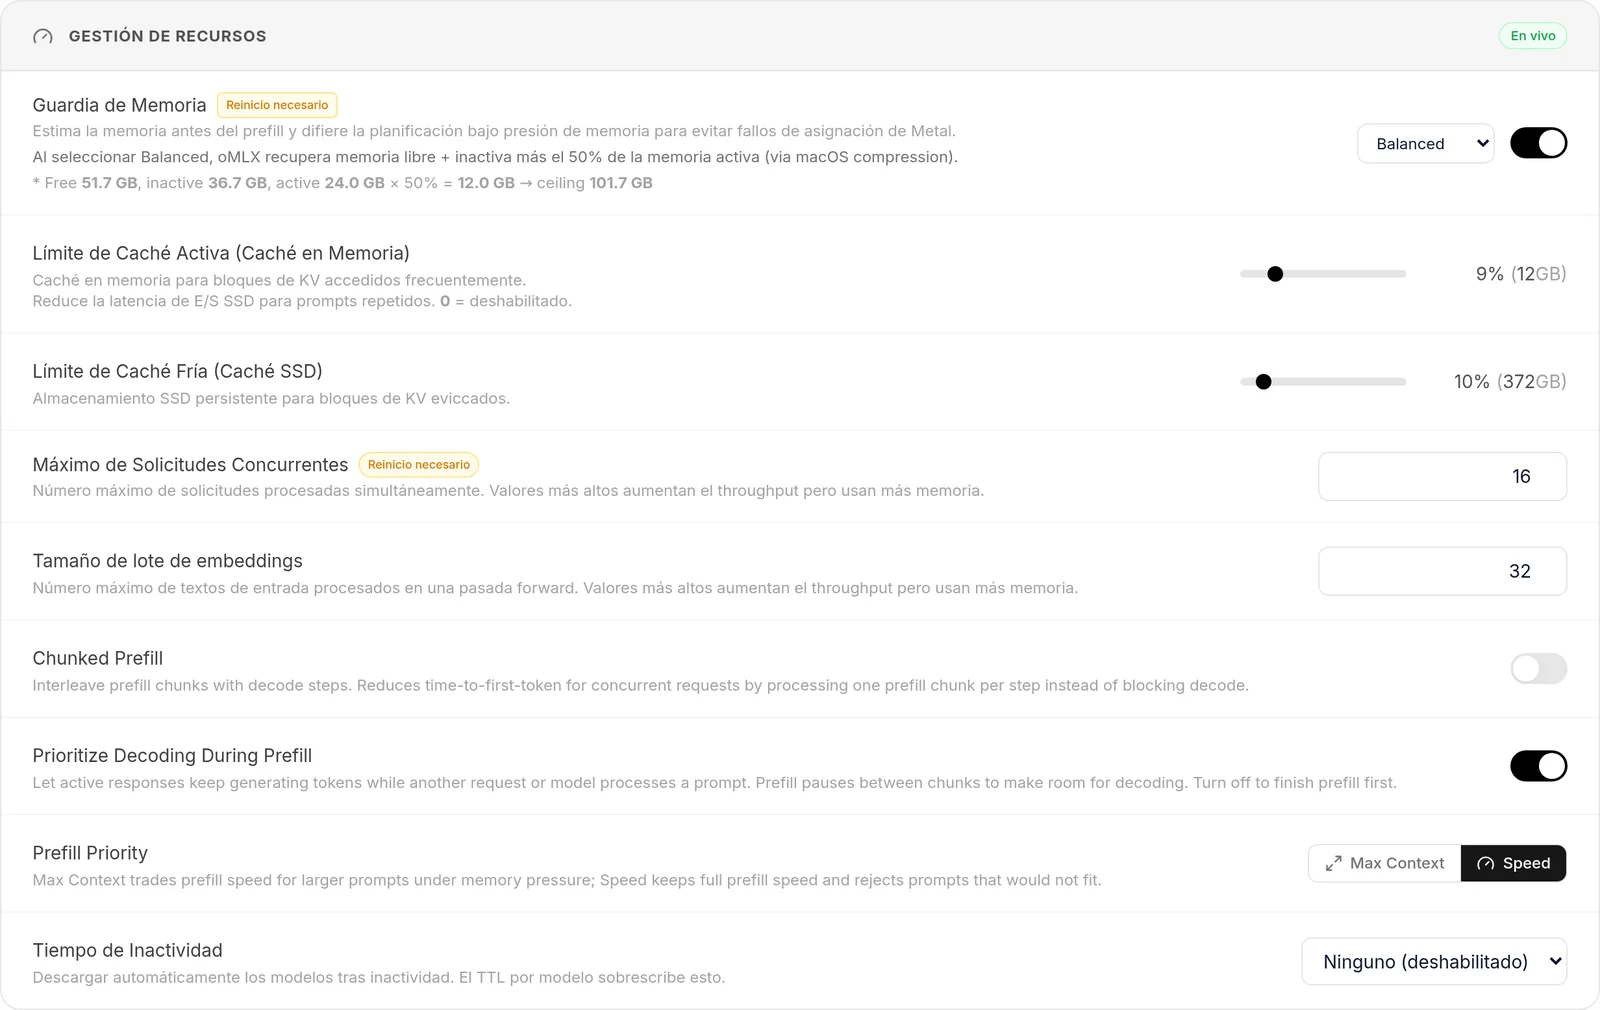
La configuración global que trae oMLX ya está bien para un solo usuario, y solo cuatro ajustes cambian algo medible:
- Límite de memoria del kernel: macOS reserva por defecto un tope de memoria fija para la GPU, y el panel avisa en rojo cuando está por debajo de lo que oMLX podría usar. Ejecuta
sudo sysctl iogpu.wired_limit_mb=124518, que en 128 GB equivale a la RAM menos un 5 %, y reinicia oMLX, que lo aplica al arrancar. El valor se pierde al reiniciar el Mac. - Prefill Priority: ponlo en
Speed. Con la memoria justa,Max Contexttrocea el prefill hasta 32 tokens por paso para que el prompt quepa, mientras queSpeedmantiene la velocidad y rechaza lo que no cabe. - Ocultar modelos auxiliares: actívalo para que los borradores no salgan en
/v1/modelsy ningún cliente los elija por error. - Máximo de Solicitudes Concurrentes: déjalo entre 8 y 16, y no lo bajes a 1. El planificador no admite una petición nueva mientras queden tantas escrituras de caché pendientes como ese límite.
Burst Decode puede quedarse en Balanced. Aggressive agrupa los tokens durante hasta 200 ms antes de enviarlos, frente a 100 ms, así que el cliente ve aparecer el primer token más tarde. Un último aviso: pulsar Guardar Configuración descarga todos los modelos cargados, aunque no hayas tocado la caché, porque el panel reenvía todos los campos.
Lo que no acelera
Tres ajustes con nombre prometedor no mejoraron la velocidad para un solo usuario:
- TurboQuant KV: con Lightning MTP en Qwen3.8-27B oQ4e, activarlo a 4 bits dejó el pico de memoria igual con 32k de prompt (24,4 GiB) y bajó el decode de 35,4 a 30,3 tok/s. En estos modelos híbridos solo las capas de atención completa guardan caché KV, así que hay poco que comprimir. Sirve para ahorrar memoria en contextos enormes, no para ir más deprisa.
- SpecPrefill: adelanta el primer token porque un modelo pequeño descarta los tokens del prompt que juzga poco importantes. El modelo grande nunca los ve, así que pierde información por diseño.
- Chunked Prefill: solo reduce el tiempo hasta el primer token cuando hay peticiones simultáneas.
Benchmarks con la 0.6.4 en este M5 Max
Con la 0.6.4 y los ajustes anteriores, este M5 Max genera entre 1,19 y 1,88 veces más tokens por segundo escribiendo código. Con 15.000 tokens de contexto, la ganancia queda entre 1,07 y 1,47 veces. Sin ninguna aceleración, Qwen3.6-35B-A3B 8-bit ya mantiene 77,9 tok/s con 32k de prompt, cuando con la 0.3.8 caía a 15,2 tok/s. Las pruebas son del 15 de septiembre de 2026.
Cómo se midió
Hay dos baterías, porque el benchmark integrado sirve para ver cómo cambia la velocidad con el contexto, pero no para comparar con y sin aceleración:
- Por la API: peticiones en streaming a
/v1/chat/completionscon temperatura 0.6 y el razonamiento desactivado. Hay dos pruebas. En la corta, cada configuración resuelve tres tareas de código (Python, TypeScript y Go) dos veces, con 768 tokens de respuesta. En la larga, responde dos preguntas sobre unos 15.100 tokens de código fuente, con 512 tokens de respuesta. El tiempo se mide desde el cliente. - Benchmark integrado: lanzado desde
POST /admin/api/bench/start, con tres repeticiones por configuración y la mediana, prompts de 1.025, 4.097, 16.385 y 32.769 tokens, 256 tokens generados y el corpuscode_python. Muestrea siempre en modo greedy, que es el mejor caso para la decodificación especulativa.
Cada petición empieza con un prefijo único, así que ninguna aprovecha la caché de prefijos. Las tablas dan la mediana. El mínimo y el máximo van entre paréntesis cuando se separan más de un 10 % en las pruebas por la API, o más de un 25 % en el benchmark integrado.
Las pruebas corrieron seguidas durante unas tres horas, con otras aplicaciones abiertas. El benchmark integrado registra la presión térmica de macOS, y 194 de sus 242 mediciones se hicieron en el nivel Heavy, el tercero de cinco (Nominal, Moderate, Heavy, Trapping y Sleeping). Solo la primera tanda de gpt-oss corrió en frío. Su prefill con 16k de prompt dio 3.140 tok/s en frío y 1.755 tok/s en caliente.
Toma las cifras absolutas como las de un Mac caliente. Las comparaciones con y sin cada ajuste se hicieron una detrás de otra, así que las ganancias relativas son más fiables que los valores absolutos.
Dos detalles del benchmark integrado de la 0.6.4 cambian cómo leerlo. El primero es que, al terminar, sube los resultados a omlx.ai con el chip, los modelos y un identificador derivado del Mac, y el panel no tiene opción para evitarlo. Con un modelo local, la única forma de dejar los resultados en el Mac es marcar ANE-aligned prompts (+1 token). Es la casilla que usé, y por eso los prompts tienen un token de más.
El segundo es que carga los modelos con visión en el motor de solo texto salvo que tengan MTP activado, así que comparar con y sin aceleración mezcla dos motores. Con prompts cortos, Qwen3.6-35B-A3B oQ4e marcó 49 tok/s en ese motor y 100 tok/s por la API. Por eso las ganancias de esta guía salen de las pruebas por la API.
Velocidad por la API con respuestas de código
| Modelo | Configuración | Decode | Primer token | Respuesta de 768 tokens |
|---|---|---|---|---|
| Qwen3.6-35B-A3B 8-bit | Sin aceleración | 79,7 tok/s | 0,37 s | 10,0 s |
| VLM MTP | 117,5 (110,5-125,5) tok/s | 0,37 s | 6,9 s | |
| Qwen3.6-35B-A3B oQ4e-mtp | Sin aceleración | 100,2 tok/s | 0,34 s | 8,0 s |
| Lightning MTP | 119,2 (108,5-139,1) tok/s | 0,46 s | 6,9 s | |
| Qwen3.8-27B 4-bit | Sin aceleración | 24,1 tok/s | 0,79 s | 32,6 s |
| VLM MTP | 34,5 tok/s | 0,65 s | 22,8 s | |
| Qwen3.8-27B oQ4e-mtp | Sin aceleración | 21,1 tok/s | 0,82 s | 37,3 s |
| Lightning MTP | 39,7 tok/s | 0,94 s | 20,4 s | |
| Gemma 4 12B 8-bit | Sin aceleración | 27,4 tok/s | 0,84 s | 28,9 s |
| VLM MTP | 50,5 (47,5-52,7) tok/s | 0,66 s | 15,9 s |
Velocidad por la API con 15.000 tokens de contexto
| Modelo | Configuración | Decode | Primer token |
|---|---|---|---|
| Qwen3.6-35B-A3B 8-bit | Sin aceleración | 84,0 tok/s | 6,20 s |
| VLM MTP | 90,7 tok/s | 5,96 s | |
| Qwen3.6-35B-A3B oQ4e-mtp | Sin aceleración | 100,2 tok/s | 5,83 s |
| Lightning MTP | 115,5 tok/s | 6,14 s | |
| Qwen3.8-27B 4-bit | Sin aceleración | 21,7 tok/s | 34,5 s |
| VLM MTP | 23,2 tok/s | 32,6 s | |
| Qwen3.8-27B oQ4e-mtp | Sin aceleración | 21,4 tok/s | 31,3 s |
| Lightning MTP | 27,2 (24,4-30,1) tok/s | 35,2 s | |
| Gemma 4 12B 8-bit | Sin aceleración | 26,6 tok/s | 20,1 s |
| VLM MTP | 39,2 tok/s | 19,3 s |
Cada fila es la mediana de dos respuestas de 512 tokens sobre el mismo contexto de código. Con este contexto, el modelo grande aceptó menos tokens del borrador que escribiendo código: en Qwen3.8-27B 4-bit, la ganancia de VLM MTP bajó de 1,43x a 1,07x.
Benchmark integrado por longitud de prompt
Velocidad de generación en tok/s según la longitud del prompt, con el prefill a 4k y el pico de memoria de MLX, que incluye los pesos:
| Modelo y configuración | 1k | 4k | 16k | 32k | Prefill 4k | Pico |
|---|---|---|---|---|---|---|
| Qwen3.6-35B-A3B 8-bit, sin aceleración | 92,1 | 91,1 | 84,1 | 77,9 | 2.426 | 38,7 GiB |
| Qwen3.6-35B-A3B 8-bit, VLM MTP | 118,3 | 106,6 | 100,2 | 94,4 | 3.113 | 41,8 GiB |
| Qwen3.6-35B-A3B 8-bit, DFlash (borrador 4 bits) | 112,4 | 110,5 | 32,6 (23,3-35,0) | 16,6 | 2.734 | 38,2 GiB |
| Qwen3.6-35B-A3B oQ4e-mtp, sin aceleración | 49,3 | 46,1 | 45,2 | 42,2 | 2.258 | 23,2 GiB |
| Qwen3.6-35B-A3B oQ4e-mtp, Lightning MTP | 77,2 (47,0-101,7) | 85,8 | 87,9 (85,7-116,6) | 82,8 (54,7-99,5) | 2.014 | 24,6 GiB |
| Qwen3.6-35B-A3B oQ4e-mtp, DFlash (borrador 4 bits) | 142,7 | 86,3 | 39,2 | 17,3 | 3.373 | 22,7 GiB |
| Qwen3.8-27B 4-bit, sin aceleración | 30,6 | 27,3 | 25,0 | 23,5 | 525 | 21,7 GiB |
| Qwen3.8-27B 4-bit, VLM MTP | 39,3 | 36,6 | 36,4 | 30,9 | 619 | 25,4 GiB |
| Qwen3.8-27B 4-bit, DFlash2 (borrador 4 bits) | 48,2 (38,7-51,1) | 43,7 | 35,8 (22,0-39,0) | 6,3 | 561 | 22,8 GiB |
| Qwen3.8-27B 4-bit, DFlash2 (borrador bf16) | 36,9 | 35,1 | 22,3 | 5,9 | 568 | 25,3 GiB |
| Qwen3.8-27B oQ4e-mtp, sin aceleración | 27,0 | 26,4 | 24,4 | 21,4 | 545 | 22,2 GiB |
| Qwen3.8-27B oQ4e-mtp, Lightning MTP | 48,0 (42,6-58,6) | 37,7 | 41,1 | 35,4 | 499 | 24,4 GiB |
| Qwen3.8-27B oQ4e-mtp, Lightning MTP + TurboQuant 4 bits | 42,2 | 37,7 | 39,7 | 30,3 | 547 | 24,4 GiB |
| Qwen3.8-27B oQ4e-mtp, Lightning MTP + prefill en ANE | 35,6 | 33,1 | 35,8 | 30,9 | 505 | 28,3 GiB |
| Qwen3.8-27B oQ4e-mtp, DFlash2 (borrador 4 bits) | 41,4 | 33,8 | 18,8 (16,6-21,9) | 5,8 | 458 | 23,3 GiB |
| Gemma 4 12B 8-bit, sin aceleración | 31,0 | 30,5 | 30,1 | 28,8 | 955 | 14,5 GiB |
| Gemma 4 12B 8-bit, VLM MTP | 65,6 | 42,7 | 50,6 | 49,0 | 940 | 15,5 GiB |
| Gemma 4 12B 8-bit, DFlash (borrador 4 bits) | 92,4 (35,5-158,0) | 34,4 | 53,4 | 51,2 | 997 | 18,1 GiB |
| gpt-oss-20b, sin aceleración | 120,2 | 106,5 | 100,4 | 78,8 | 3.491 | 12,4 GiB |
Las cifras de DFlash con 1k de prompt variaron mucho entre repeticiones: en Gemma 4 12B fueron 35,5, 92,4 y 158,0 tok/s. La velocidad depende de cuántos tokens del borrador acepta el modelo grande, y eso cambia con el texto que toca continuar.
Frente a la 0.3.8
La tabla de mayo y la de ahora no son del todo comparables. Aquella se midió con la copia Qwen3.6-35B-A3B-MLX-8bit y 128 tokens de salida; esta, con la de mlx-community y 256 tokens. Aun así, la mejora con contexto largo es demasiado grande para deberse a esas diferencias:
| Qwen3.6-35B-A3B 8-bit, benchmark integrado | 0.3.8 (mayo) | 0.6.4 (septiembre) |
|---|---|---|
| Decode con 1k de prompt | 72,4 tok/s | 92,1 tok/s |
| Decode con 4k de prompt | 83,1 tok/s | 91,1 tok/s |
| Decode con 32k de prompt | 15,2 tok/s | 77,9 tok/s |
| Primer token con 1k de prompt | 577 ms | 298 ms |
Verificación de punta a punta
Curl contra la API compatible con OpenAI para confirmar que el servidor está vivo y responde:
curl http://127.0.0.1:8000/v1/chat/completions \
  -H "Authorization: Bearer tu_clave_de_api" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "Qwen3-Coder-30B-A3B-Instruct-mlx-8bit",
    "messages": [{"role": "user", "content": "Hola desde oMLX"}]
  }'
Y desde Claude Code, una vez exportadas las variables de la sección anterior:
claude --print "¿Estás corriendo en local?"La respuesta debería llegar de local sin tocar api.anthropic.com. Para confirmarlo a nivel de red, abre Monitor de Actividad → Red, filtra por el proceso claude y comprueba que la conexión saliente apunta a 127.0.0.1:8000.
Conexión SSH desde otro Mac
Si tienes oMLX corriendo en un Mac Studio y quieres usar Claude Code desde tu MacBook, puedes hacer port forwarding con SSH:
ssh -L 8000:localhost:8000 user@mac-studioUna vez conectado, el endpoint local (127.0.0.1:8000) apunta al oMLX del Studio. Guarda este script como claude-local.sh:
#!/bin/bash
export ANTHROPIC_BASE_URL='http://localhost:8000'
export ANTHROPIC_AUTH_TOKEN=''
export ANTHROPIC_DEFAULT_OPUS_MODEL='Qwen3.6-35B-A3B-MLX-8bit'
export ANTHROPIC_DEFAULT_SONNET_MODEL='Qwen3.6-35B-A3B-MLX-8bit'
export ANTHROPIC_DEFAULT_HAIKU_MODEL='Qwen3-14B-MLX-4bit'
export ANTHROPIC_DEFAULT_MODEL='Qwen3.6-35B-A3B-MLX-8bit'
export API_TIMEOUT_MS=600000
export CLAUDE_CODE_USE_BEDROCK=0
export CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC=1
claude --bare --dangerously-skip-permissions
Hazlo ejecutable con chmod +x claude-local.sh y ejecútalo desde la sesión SSH. La API key por defecto es el campo vacío; si configuraste una clave en Settings → Auth & Info, sustituye '' por ella. El comando --bare reduce el system prompt de Claude Code a ~1.795 tokens, y --dangerously-skip-permissions omite las peticiones de permiso que no tienen sentido en un flujo pipe automático.

Qué ha cambiado desde la 0.3.8
Esta guía se escribió contra oMLX 0.3.8 en mayo de 2026. La versión actual es la 0.6.4, publicada el 29 de agosto de 2026, y entre medias han salido más de una docena de versiones que tocan justo lo que aquí se ajusta. Lo que sigue es el resumen de lo que ha cambiado, con las cifras atribuidas a quien las midió.
Decodificación especulativa Lightning MTP
Es el cambio que más afecta a esta configuración. La versión 0.5.0, del 10 de julio de 2026[7], añadió decodificación especulativa nativa de profundidad k para Qwen3.6-27B, Qwen3.6-35B-A3B, DeepSeek-V4-Flash y GLM-5.2.
Sobre un Apple M3 Ultra, el proyecto midió Qwen3.6-35B-A3B pasando de 89,6 a 140,4 tok/s, un 1,57x. Qwen3.6-27B pasó de 35,0 a 55,1 tok/s. En este M5 Max, medido por la API el 15 de septiembre de 2026, Lightning MTP llevó Qwen3.8-27B oQ4e de 21,1 a 39,7 tok/s. Cómo activarlo, y cuándo conviene otro método, está en los ajustes avanzados.
Núcleos propios, con una nota para M5
La misma 0.5.0 añadió núcleos de cálculo propios para DeepSeek V4, Qwen3.5/3.6 y GLM-5.2, con mejoras de prefill medidas en M3 Ultra. Son un 45 % en DeepSeek-V4-Flash (de 313,3 a 455,8 tok/s con 64k de contexto), un 33 % en Qwen3.6-27B y un 99 % en GLM-5.2 con 32k. Lo relevante para esta máquina es que el despacho es consciente de NAX precisamente para evitar regresiones en la serie M5, así que conviene comprobar el efecto antes de darlo por bueno.
Cuantización oQ y oQe
oMLX ya no depende solo de los pesos que descargues: trae su propio esquema de cuantización. La 0.5.0 añadió oQe, una pasada de calibración por importancia de activaciones con seguimiento de cobertura de expertos en modelos MoE. En las medidas del proyecto, oQ4e mejora la precisión media frente a oQ4 manteniendo el mismo tamaño en disco. Son 83,88 % frente a 82,83 % en Qwen3.6-35B-A3B, y 73,09 % frente a 70,01 % en Qwen3.5-9B.
El motor neuronal y el arranque en frío
La rama 0.6.3 trabajó el camino de prefill sobre el motor neuronal de Apple. Dos cifras del proyecto importan en el día a día. La memoria de compilación de bancos bajó de 35,8 GB a 4,7 GB. Una caché de compilación persistente opcional recorta entre un 53 % y un 66 % el arranque de un proceso nuevo.
La 0.6.4 siguió por ahí y mejoró Qwen3.8-Flash-Next un 33,5 % en procesamiento de prompt, con un 24,2 % menos de tiempo total de petición a 32k. Son cifras del proyecto sobre M3 Ultra, otra vez.
Endpoints nuevos
Al par compatible con OpenAI y Anthropic se le han sumado /v1/rerank para reordenación de documentos, /v1/responses para compatibilidad con Codex y /v1/mcp/tools para Model Context Protocol. Con un modelo de embeddings y un reordenador cargados a la vez, la tubería de recuperación entera cabe en el mismo servidor. El desglose completo está en la guía de la API, la clave y el puerto.
Autenticación con subclaves
Donde antes había una lista de claves equivalentes, ahora hay tres credenciales con permisos distintos. La clave principal abre la API y el panel. Las subclaves solo llaman a la API y no pueden entrar al panel ni cambiar ajustes.
Los tokens de sesión del panel se guardan en una cookie firmada. Si repartes acceso a más de una aplicación, reparte subclaves.
Los nombres de los ajustes
La configuración de memoria de la sección anterior sigue siendo válida como criterio, pero las claves se llaman distinto en ~/.omlx/settings.json. El techo de memoria es ahora memory_guard_tier, con cuatro niveles (safe, balanced, aggressive y custom), y el valor a medida va en memory_guard_custom_ceiling_gb. Por defecto el techo es la RAM del sistema menos 8 GB. Los dos niveles de caché son hot_cache_max_size y ssd_cache_max_size, y el límite de concurrencia es max_concurrent_requests.
Cuidado con uno: hot_cache_max_size viene de fábrica en "0", que desactiva la caché caliente en RAM. Lo desarrollo en benchmarks y techo de memoria.
Otras piezas que no existían
Los perfiles guardan paquetes de ajustes con nombre sobre un mismo modelo, expuestos como modelo:perfil y sin coste de memoria adicional. Los alias renombran un modelo de cara a la API. Ambos están en la guía del panel y la línea de comandos.
Además hay inferencia distribuida experimental. Reparte las capas de un modelo entre más de un Mac por SSH según la memoria de cada uno, y tiene en cuenta si el enlace es Thunderbolt o 10GbE.
Fuentes y lecturas
Qué cuesta la alternativa: el mismo modelo en la nube europea
Ejecutar el modelo en el Mac que ya tienes hace que el coste marginal parezca cero. Por eso conviene mirar el precio de la alternativa: es lo que mide de verdad si la memoria unificada de la máquina está bien aprovechada.
En Scaleway, una instancia L4-1-24G (una GPU NVIDIA L4 con 24 GB de VRAM y 48 GB de RAM) cuesta 0,79 € por hora. La de ocho GPU cuesta 6,3 € por hora, precios antes de impuestos (tarifas de instancias GPU de Scaleway, consultadas el 5 de septiembre de 2026[8]).
La comparación con Apple Silicon no es de potencia bruta, sino de memoria. Un Mac con 32 GB de memoria unificada puede cargar modelos que no caben en los 24 GB de VRAM de una L4, y lo hace sin pagar por hora. A cambio, el ancho de banda de memoria y el rendimiento sostenido en cargas largas siguen siendo mejores en la GPU dedicada. Dicho de otro modo: el Mac gana en «qué modelos puedo cargar» y en coste para uso intermitente; la instancia alquilada gana en «cuántos tokens por segundo saco de una tanda larga».
Si acabas necesitando la nube para tandas puntuales, Scaleway y OVHcloud son las opciones europeas más directas desde España. Facturan en euros y sus regiones están dentro de la UE, así que el mismo flujo de trabajo no cambia de jurisdicción al escalar.
Por qué la inferencia local simplifica el cumplimiento
El motivo que más pesa para ejecutar en local no suele ser el precio, sino que los datos no salen del equipo. Si los prompts incluyen datos personales, el Reglamento (UE) 2016/679 (RGPD) se aplica de todos modos: sigue habiendo tratamiento. Lo que no hay es transferencia a un tercero ni un encargado del tratamiento al que auditar y contratar.
A eso se suma el Reglamento (UE) 2024/1689, el Reglamento de IA de la Unión Europea. Sus obligaciones recaen sobre quien comercializa o despliega un sistema de IA y se gradúan según el riesgo de ese uso. Ejecutar un modelo en tu portátil para tu propio trabajo no es lo mismo que integrarlo en un producto que usan terceros. Merece la pena tenerlo claro antes de que el prototipo se convierta en lo segundo.
Fuentes:
-
Gist de Diego R. Baquero, "Running Claude Code with a local LLM"[3]: la receta de configuración probada en la que se basan los ajustes de este post. De ahí salen el TurboQuant 3,5-bit, el contexto 64k, la atribución off y los modelos Qwen 3.6 35B-A3B.
-
A First Comprehensive Study of TurboQuant, blog de vLLM, 11 mayo 2026[2]: análisis independiente que confirma que 3,5-bit iguala la calidad de precisión completa.
-
omlx.ai/benchmarks[4]: leaderboard público con envíos reales de M5 Max y otros equipos.
-
Maxing Out M5 Max Context Windows: Memory Fragmentation and TurboQuant Benchmarks (dasroot.net, abril 2026)[5]: el otro experimento detallado sobre contextos largos en M5 Max con TurboQuant.
-
Repositorios: jundot/omlx[9], ml-explore/mlx[10], ml-explore/mlx-lm[11], huggingface.co/mlx-community[12], huggingface.co/unsloth[13].
Si vienes buscando qué es esto exactamente y en qué se diferencia del framework MLX de Apple, lo separo en qué es oMLX. Si quieres una alternativa multiplataforma fuera de Apple Silicon, la guía de Ollama para LLM locales cubre catálogo y API compatible con OpenAI. Para meter el endpoint dentro de un agente, el tutorial del SDK de Anthropic y los patrones MCP multi-vendor ya hablan con este mismo formato sin cambios.
Preguntas frecuentes
¿Hace falta configurar una API key para usar oMLX solo en local?
No. Por defecto oMLX arranca con el campo de API key vacío, y si la instancia solo escucha en 127.0.0.1 es seguro dejarlo así para pruebas locales. En cuanto la expongas a la LAN o compartas el endpoint, ve a Settings → Auth & Info y configura una cadena larga aleatoria. En las versiones actuales hay además subclaves que solo llaman a la API y no pueden entrar al panel ni cambiar ajustes, pensadas para repartir acceso entre más de una aplicación.
¿Puedo usar Claude Code desde un MacBook contra el oMLX de un Mac Studio?
Sí, con port forwarding por SSH: ssh -L 8000:localhost:8000 user@mac-studio hace que 127.0.0.1:8000 en el portátil apunte al oMLX del Studio. Después exportas las mismas variables (ANTHROPIC_BASE_URL, ANTHROPIC_AUTH_TOKEN y los ANTHROPIC_DEFAULT_*_MODEL) en un script como claude-local.sh, lo haces ejecutable con chmod +x y lanzas claude --bare desde la sesión SSH. Si configuraste una clave en Settings → Auth & Info, sustituye la cadena vacía por ella.
¿Siguen valiendo los benchmarks del post si instalo la 0.6.4?
Las tablas de mayo, no: se midieron con la 0.3.8, y al repetirlas el 15 de septiembre de 2026 la 0.6.4 fue más deprisa en esta misma máquina. Sin aceleración, Qwen3.6-35B-A3B 8-bit pasa de 15,2 a 77,9 tok/s con 32k de prompt. Lightning MTP o VLM MTP añaden entre 1,07x y 1,88x, según el modelo y el contexto. Si mides en tu Mac, compara por la API y no solo con Bench → Performance, que ejecuta los modelos con visión en otro motor cuando MTP está apagado.
Fuentes
- GitHub Releases
- análisis independiente de vLLM publicado el 11 de mayo de 2026
- gist de Diego R. Baquero
- leaderboard público de omlx.ai
- experimento de dasroot.net sobre contextos largos en M5 Max
- gpt-oss-20b MXFP4-Q4 en M5 Max 40c según el envío público de oMLX
- versión 0.5.0, del 10 de julio de 2026
- tarifas de instancias GPU de Scaleway, consultadas el 5 de septiembre de 2026
- jundot/omlx
- ml-explore/mlx
- ml-explore/mlx-lm
- huggingface.co/mlx-community
- huggingface.co/unsloth