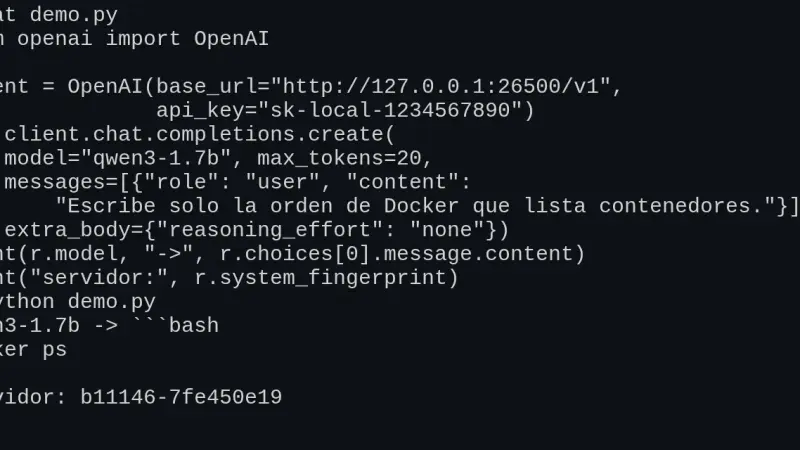
llama-server, el servidor de llama.cpp, expone /v1/chat/completions, /v1/completions, /v1/embeddings y /v1/models con el formato de OpenAI, así que el SDK oficial funciona cambiando base_url. Lo probé en Docker con la v0.5.0: herramientas, JSON con esquema y Open WebUI funcionan, pero el contexto se reparte entre ranuras y tool_choice por nombre se ignora.
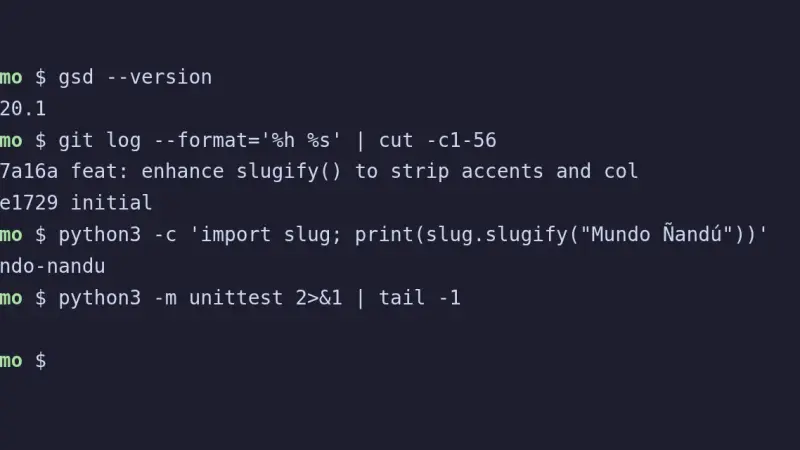
Para instalar gsd-pi, el agente de terminal de Open GSD, ejecuta npx @opengsd/gsd-pi@latest con Node.js 22.18 o superior. Funciona sin clave de API: con un models.json que apunte a llama.cpp y 64k de contexto, un Qwen3.5 de 4B completó una tarea con 12 tests y un commit. gsd-core, en cambio, se instala dentro de Claude Code u OpenCode.
Shieldstral es el clasificador de seguridad de 3B que Mistral publicó en agosto de 2026: responde sí o no a una política escrita en lenguaje natural. Convertido a GGUF Q8_0 con llama.cpp y servido en CPU, no bloqueó ninguno legítimo de los 100 prompts que preparé en español e inglés, pero dejó pasar 8 de 17 inyecciones.
OpenCode usa un modelo local si declaras en opencode.json un proveedor @ai-sdk/openai-compatible con la URL de llama-server u Ollama y el límite de contexto del modelo. La versión 1.18.31 envía 7.516 tokens en su primer turno, así que los 4k que Ollama asigna por defecto sin GPU grande no bastan: reserva 32k.
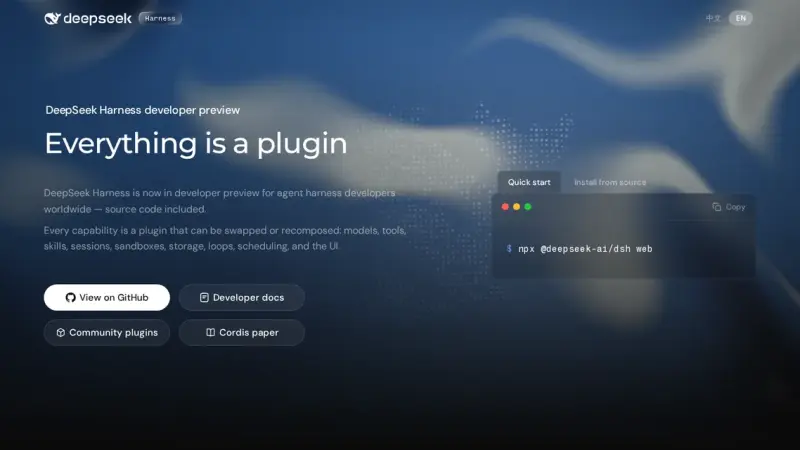
DeepSeek Harness (dsh) es el arnés de agentes de código abierto que DeepSeek publicó en agosto de 2026. Funciona con un modelo local si declaras en settings.yaml un proveedor openai-completions que apunte a llama-server, con una clave de relleno y el contexto real. Con Qwen3.5-4B en CPU dejó los tests en verde en 4 de 5 intentos, pero despacio.
Sin GPU, en una CPU arm64 de 18 núcleos con llama.cpp v0.4.1, Maple-Preview generó 172,84 tokens/s con 6 hilos: el doble que MiniCPM5-2B y 3,6 veces Spark-X2.5-4B. A cambio ocupa 5,79 GiB de RAM y siempre razona. MiniCPM5 cabe en 3,27 GiB y Spark escribe mejor en español. Los tres inventaron datos.
OpenClaw 2026.9.4 se instala con Docker Compose desde la imagen oficial de GHCR, que existe para amd64 y arm64. Para usarlo sin API en la nube, conéctalo a un llama-server en la red interna del compose. Publica el puerto 18789 solo en 127.0.0.1, porque el compose del repositorio lo abre en todas las interfaces.
Desde Ollama 0.34.1, ollama create ya no convierte ni cuantiza pesos safetensors. Para importar un modelo de Hugging Face, descárgalo con hf download, conviértelo a GGUF con convert_hf_to_gguf.py de llama.cpp, cuantízalo con llama-quantize y créalo desde un Modelfile. Con MiniCPM5-2B en CPU, las tres fases tardaron 35 s, 21 s y 2 s.
Para instalar llama.cpp tienes cuatro vías: el script de llama.app, que deja un binario llama de 15 MB en ~/.local/bin; Homebrew; la imagen Docker server-v0.4.1; o CMake. Las probé el 14 de septiembre de 2026 en Linux arm64 con Gemma 4 E2B, en la terminal con llama cli y como API compatible con OpenAI.
Qwen3-VL 8B en Q4_K_M son 4,68 GiB de pesos más 1,08 GiB de torre de visión, y su cache KV cuesta 144 KiB por token. Con 8.192 tokens de contexto la suma ronda los 7 GiB y cabe de sobra en 16 GB; con los 256K nativos pediría 36 GiB solo de cache y no cabe en ninguna tarjeta de consumo.
llama.cpp es la biblioteca en C++ que impulsa a Ollama y gran parte del ecosistema de LLM locales. En 2024 sumó decodificación especulativa con aceleraciones de dos a tres veces, un servidor RPC para repartir capas entre máquinas y un formato GGUF estable. Ollama basta para el 90% de los casos; ir directo compensa con hardware poco común.
Ollama se consolidó en 2024 como el estándar para ejecutar LLMs en local. Empaqueta llama.cpp en un binario único con interfaz de línea de comandos estilo Docker y API compatible con OpenAI. Phi-3 Mini corre en 4 GB; Llama 3.1 8B Q4 necesita 6 GB. Para tráfico de producción a escala, vLLM sigue siendo la opción correcta.
Con cuantización, los pesos de un modelo se guardan con menos bits (4, 5 u 8 en vez de 16), así que Llama 2 13B pasa de 26 GB a unos 7,5 GB. Con llama.cpp corre en un portátil normal de 16 GB de RAM sin GPU dedicada, y la pérdida de calidad es menor de lo que la intuición sugiere.
7 min3634,5
Usamos cookies propias y de terceros para analizar el tráfico del sitio. Puedes aceptarlas, rechazarlas o configurar tu elección.
Más información sobre las cookies
Preferencias de cookies
NecesariasImprescindibles para el funcionamiento del sitio. Siempre activas.
AnalíticasNos ayudan a entender cómo se usa el sitio (Google Analytics).