Cómo montar Grafana Tempo 3.1 con Docker Compose y Alloy
Índice de contenidos
- Puntos clave
- Qué cambia en Tempo 3.1 respecto a la 3.0
- Qué monté y con qué versiones
- Cómo se configura Tempo 3.1 en modo monolítico
- Cómo recibe Alloy las trazas y las reenvía a Tempo
- El docker-compose.yml del stack de trazas
- Cómo instrumentar una app Python sin tocar su código
- Qué consultas TraceQL ejecuté y qué devolvieron
- Cómo calcular una tasa de error con la aritmética de TraceQL metrics
- Grafo de servicios y métricas de span con el metrics-generator
- Cómo actualizar de Tempo 2.x a 3.1
- Qué no he probado
- Preguntas frecuentes
- ¿Necesito Kafka para usar Grafana Tempo 3 con Docker?
- ¿Puedo enviar trazas a Tempo sin Alloy?
- ¿Tengo que convertir mis bloques vParquet4 a vParquet5?
- Conclusión
- Fuentes
Grafana Tempo 3.1 corre en Docker Compose como un único contenedor en modo monolítico, sin Kafka, y recibe las trazas de tus aplicaciones a través de Grafana Alloy. Lo he montado entero el 30 de septiembre de 2026 con Tempo 3.1.0, Alloy v1.20.1, Grafana 13.2.3 y Prometheus 3.15.0, y le he enviado 1225 peticiones desde una tienda de ejemplo en Flask instrumentada con OpenTelemetry. Aquí están los ficheros que usé, las consultas TraceQL que ejecuté con su resultado y lo que me encontré al migrar una configuración de Tempo 2.10. También está la versión en inglés de esta guía.
Puntos clave
- Tempo 3.1.0 escribe los bloques nuevos en vParquet5 y sigue leyendo vParquet4 y vParquet3 sin migrar datos; con
vParquet3configurado como formato de escritura ya no arranca. - En modo monolítico no necesitas Kafka: un contenedor con
-target=all, almacenamiento local y el metrics-generator activado basta para un laboratorio o un servidor pequeño. - La 3.1 admite aritmética en TraceQL metrics: una sola consulta dividió los errores del inventario entre sus peticiones y devolvió 0,047.
- El metrics-generator creó en Prometheus las métricas de span y el grafo de servicios, con la base de datos SQLite como nodo propio.
- Al migrar desde 2.x,
tempo-cli migrate configse niega a trabajar con overrides en formato antiguo y no eliminatraces_storage: hay que retocar dos bloques a mano antes. Tras actualizar, las 200 trazas de la 2.x se leyeron sin convertir nada. - Dos dificultades del SDK de Python con las que me he topado: sin
OTEL_EXPORTER_OTLP_PROTOCOLla app arranca sin trazas, yConnection.execute()de sqlite3 no genera spans.
Qué cambia en Tempo 3.1 respecto a la 3.0
Tempo 3.1 es una versión menor sobre la 3.0, la que cambió la arquitectura.
La 3.0.0, publicada el 28 de mayo de 2026[1], eliminó los ingesters. En modo microservicios los distribuidores escriben en Kafka, y dos componentes nuevos (block-builder y live-store) construyen los bloques y sirven los datos recientes. El compactor desapareció en favor de un backend-scheduler y un backend-worker. En modo monolítico no hace falta Kafka, porque el distribuidor entrega los spans directamente al live-store dentro del mismo proceso.
Sobre esa base, las notas de la versión 3.1.0[2] destacan cuatro cambios que notarás en un despliegue pequeño:
- vParquet5 por defecto: los bloques nuevos se escriben en vParquet5 (antes vParquet4)
- Aritmética en TraceQL metrics:
+,-,*y/entre agregaciones en una sola consulta - Extrapolación por muestreo: la pista
with(extrapolate=true)corrige los recuentos usando la probabilidad de muestreo que el span lleva entracestate - Borrado por consulta: los trabajos de redacción aceptan un selector TraceQL en lugar de una lista de identificadores de traza
El cambio de formato no exige migración. En palabras del changelog: "No data migration is required. After upgrading, Tempo writes new blocks in vParquet5 while continuing to read existing vParquet4 and vParquet3 blocks." En mi laboratorio, los 15 bloques que Tempo escribió llevan "format":"vParquet5" en su meta.json y ocupaban 2,9 MB tras las 1225 peticiones.
Qué monté y con qué versiones
El laboratorio corre en Docker 29.5.2 con Compose 2.40.3 sobre una máquina Linux arm64 de 18 núcleos, compartida con otros trabajos. Todas las imágenes tienen variante arm64 y estas eran las versiones del 30 de septiembre de 2026:
| Pieza | Imagen | Papel |
|---|---|---|
| Tempo | grafana/tempo:3.1.0 |
Guarda y consulta trazas |
| Alloy | grafana/alloy:v1.20.1 |
Recibe OTLP y lo reenvía |
| Prometheus | prom/prometheus:v3.15.0 |
Guarda las métricas del generador |
| Grafana | grafana/grafana:13.2.3 |
Explora trazas y métricas |
| App de ejemplo | python:3.13-slim + SDK OTel 1.45.0 |
Genera trazas |
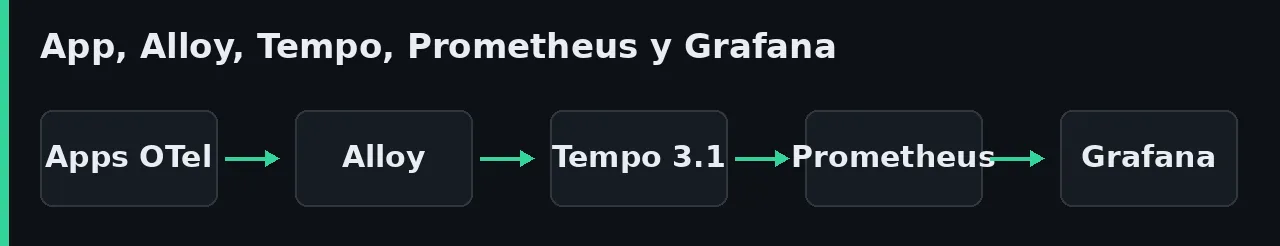
La app son dos servicios Flask: tienda recibe /comprar/<producto> y llama a inventario, que consulta una tabla SQLite. El inventario falla a propósito en el 5 % de las peticiones y tarda 0,4 s más con los productos múltiplos de 10, para que haya errores y trazas lentas que buscar. Grafana consulta a Tempo y a Prometheus por separado; el diagrama simplifica esa parte.
El ejemplo oficial de Tempo, en la carpeta example/docker-compose del repositorio[3], también usa Alloy. En la etiqueta v3.1.0 todavía fija las imágenes de Tempo 3.0.0, así que conviene cambiar la etiqueta a mano.
Cómo se configura Tempo 3.1 en modo monolítico
Tempo en modo monolítico necesita cuatro bloques de configuración: el receptor OTLP, el metrics-generator, el almacenamiento y los overrides que activan los procesadores. Este es el tempo.yaml que usé:
stream_over_http_enabled: true
server:
  http_listen_port: 3200

distributor:
  receivers:
    otlp:
      protocols:
        grpc:
          endpoint: "0.0.0.0:4317"

metrics_generator:
  registry:
    external_labels:
      source: tempo
  storage:
    path: /var/tempo/generator/wal
    remote_write:
      - url: http://prometheus:9090/api/v1/write
        send_exemplars: true
El distribuidor solo escucha OTLP por gRPC en el puerto 4317, porque Alloy es el único que le envía datos. stream_over_http_enabled deja que Grafana reciba los resultados de búsqueda por streaming. El metrics-generator calcula métricas a partir de los spans y las escribe en Prometheus por remote write.
La segunda mitad fija el almacenamiento en disco local y activa los dos procesadores del generador en los overrides por defecto:
storage:
  trace:
    backend: local
    wal:
      path: /var/tempo/wal
    local:
      path: /var/tempo/blocks

overrides:
  defaults:
    metrics_generator:
      processors: ["span-metrics", "service-graphs"]

usage_report:
  reporting_enabled: false
No hay ningún bloque ingester: ni compactor:, y el formato de bloque no aparece porque vParquet5 ya es el valor por defecto. La retención por defecto es de 336 horas (14 días) según la referencia de configuración[4]; en la 3.x se cambia en backend_worker.compaction.block_retention. usage_report desactiva el envío de estadísticas anónimas a Grafana Labs.
Cómo recibe Alloy las trazas y las reenvía a Tempo
Alloy hace de recolector OpenTelemetry entre tus aplicaciones y Tempo: recibe OTLP por gRPC y por HTTP, agrupa los spans en lotes y los envía a Tempo. Así las aplicaciones no conocen la dirección de Tempo y puedes añadir filtros o muestreo en un único punto. El config.alloy tiene tres componentes encadenados:
otelcol.receiver.otlp "apps" {
  grpc { endpoint = "0.0.0.0:4317" }
  http { endpoint = "0.0.0.0:4318" }
  output { traces = [otelcol.processor.batch.default.input] }
}

otelcol.processor.batch "default" {
  output { traces = [otelcol.exporter.otlp.tempo.input] }
}

otelcol.exporter.otlp "tempo" {
  client {
    endpoint = "tempo:4317"
    tls { insecure = true }
  }
}
otelcol.receiver.otlp abre los puertos 4317 y 4318, otelcol.processor.batch agrupa y otelcol.exporter.otlp envía a Tempo sin TLS, algo aceptable solo porque ambos comparten la red interna de Compose. Si ya usas Alloy para logs, este bloque se suma a tu configuración actual; la migración de Promtail a Grafana Alloy explica cómo llegar hasta ahí.
El docker-compose.yml del stack de trazas
El fichero de Compose tiene cuatro servicios y un volumen para los datos de Tempo. Publica los puertos solo en 127.0.0.1: ni Tempo ni Alloy tienen autenticación en esta configuración. La primera mitad levanta Tempo y Alloy:
services:
  tempo:
    image: grafana/tempo:3.1.0
    command: ["-target=all", "-config.file=/etc/tempo.yaml"]
    volumes:
      - ./tempo.yaml:/etc/tempo.yaml:ro
      - tempo-data:/var/tempo
    ports:
      - "127.0.0.1:3200:3200"

  alloy:
    image: grafana/alloy:v1.20.1
    command: ["run", "/etc/alloy/config.alloy",
              "--server.http.listen-addr=0.0.0.0:12345"]
    volumes:
      - ./config.alloy:/etc/alloy/config.alloy:ro
    ports:
      - "127.0.0.1:12345:12345"
    depends_on: [tempo]
-target=all arranca todos los componentes en un proceso. La interfaz web de Alloy, en el puerto 12345, enseña el grafo de componentes y su estado. La segunda mitad añade Prometheus con el receptor de remote write activado y Grafana con acceso anónimo:
  prometheus:
    image: prom/prometheus:v3.15.0
    command: ["--config.file=/etc/prometheus/prometheus.yml",
              "--web.enable-remote-write-receiver",
              "--enable-feature=exemplar-storage"]
    volumes:
      - ./prometheus.yml:/etc/prometheus/prometheus.yml:ro

  grafana:
    image: grafana/grafana:13.2.3
    environment:
      GF_AUTH_ANONYMOUS_ENABLED: "true"
      GF_AUTH_ANONYMOUS_ORG_ROLE: Admin
    volumes:
      - ./grafana-datasources.yaml:/etc/grafana/provisioning/datasources/ds.yaml:ro
    ports:
      - "127.0.0.1:3000:3000"

volumes:
  tempo-data:
El acceso anónimo como administrador sirve para un laboratorio local y para nada más. En un servidor real, sigue la guía para instalar Grafana con Docker con usuario y contraseña. El prometheus.yml solo necesita un trabajo que lea las métricas de Tempo en tempo:3200; si Prometheus es nuevo para ti, la instalación de Prometheus con Docker cubre lo básico.
La fuente de datos de Tempo en Grafana se aprovisiona con un YAML. serviceMap le dice a Grafana en qué Prometheus están las métricas del grafo de servicios:
apiVersion: 1
datasources:
  - name: Prometheus
    type: prometheus
    uid: prometheus
    url: http://prometheus:9090
  - name: Tempo
    type: tempo
    uid: tempo
    url: http://tempo:3200
    isDefault: true
    jsonData:
      serviceMap:
        datasourceUid: prometheus
      streamingEnabled:
        search: true
        metrics: true
Arranca todo con docker compose up -d y comprueba que Tempo responde. /ready devolvió ready y /api/status/buildinfo confirmó la versión:
$ curl -s localhost:3200/api/status/buildinfo
{"version":"v3.1.0","revision":"77fc4563d","branch":"HEAD",
 "buildUser":"","buildDate":"","goVersion":"go1.27.1"}
Cómo instrumentar una app Python sin tocar su código
La instrumentación automática de OpenTelemetry para Python envuelve Flask, requests y sqlite3 desde fuera: instalas los paquetes y arrancas la app con opentelemetry-instrument. La documentación de instrumentación sin código[5] lo describe con más detalle. El Dockerfile de la app instala estas versiones:
flask==3.1.3
requests==2.34.2
opentelemetry-distro==0.66b0
opentelemetry-exporter-otlp-proto-http==1.45.0
opentelemetry-instrumentation-flask==0.66b0
opentelemetry-instrumentation-requests==0.66b0
opentelemetry-instrumentation-sqlite3==0.66b0
El servicio de Compose de la tienda pasa la configuración por variables de entorno; el del inventario es igual con otro OTEL_SERVICE_NAME:
  tienda:
    build: ./app
    command: ["opentelemetry-instrument", "flask", "--app", "tienda",
              "run", "--host", "0.0.0.0", "--port", "8000"]
    environment:
      OTEL_SERVICE_NAME: tienda
      OTEL_EXPORTER_OTLP_ENDPOINT: http://alloy:4318
      OTEL_EXPORTER_OTLP_PROTOCOL: http/protobuf
      OTEL_METRICS_EXPORTER: none
      OTEL_LOGS_EXPORTER: none
Me he topado con dos dificultades, y ninguna produce un error visible en las peticiones:
- Sin
OTEL_EXPORTER_OTLP_PROTOCOL, la app arranca sin trazas. El exportador por defecto es gRPC; como solo instalé el de HTTP, el arranque imprimeRuntimeError: Requested component 'otlp_proto_grpc' not found in entry point 'opentelemetry_traces_exporter'yFailed to auto initialize OpenTelemetry, pero Flask sigue sirviendo peticiones como si nada. Connection.execute()de sqlite3 no genera spans. La instrumentación envuelve la conexión, pero solo traza las consultas lanzadas desde un cursor. Condb.execute(...)las 600 primeras peticiones no dejaron ni un span de base de datos; al cambiar acursor.execute(...)apareció el spanSELECTcondb.system = sqlite.
La segunda dificultad también vacía el grafo de servicios, porque sin ese span Tempo no sabe que el inventario usa una base de datos. Para el contexto general de OpenTelemetry, el artículo sobre cómo unifica logs, métricas y trazas sirve de introducción.
Qué consultas TraceQL ejecuté y qué devolvieron
TraceQL filtra spans por atributos, estado, duración y relación entre ellos. Lancé estas consultas contra la API de búsqueda (/api/search) y en el editor de Grafana, sobre las trazas de los últimos 15 minutos:
| Consulta | Qué busca | Resultado |
|---|---|---|
{ resource.service.name = "inventario" && status = error } |
Spans del inventario con error | 53 trazas |
{ span.http.route = "/stock/<int:producto>" && duration > 300ms } |
Llamadas lentas al inventario | 100, el límite pedido |
{ resource.service.name = "tienda" } >> { span.db.system = "sqlite" } |
Trazas en las que la tienda desciende hasta SQLite | 5, el límite pedido |
{ span.http.status_code = 502 } >> { status = error } |
Respuestas 502 con un error debajo | 53 trazas |
{ resource.service.name = "inventario" && status = error } && { span.db.system = "sqlite" } |
Error y consulta en la misma traza | 0 trazas |
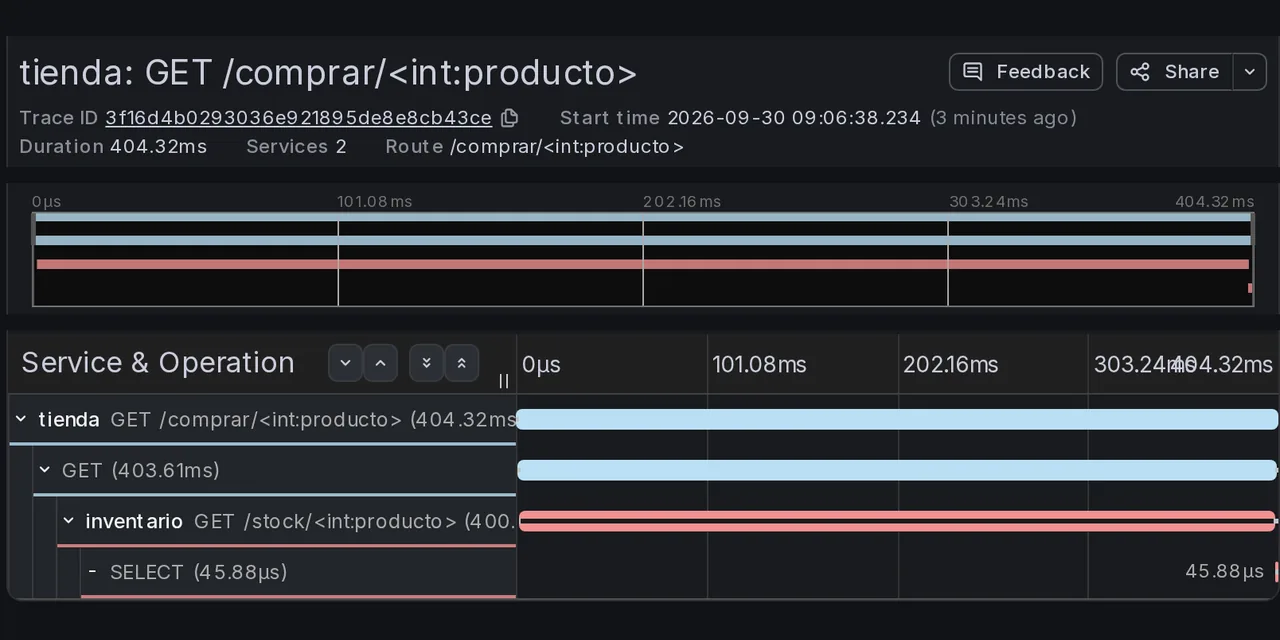
El operador >> pide que el segundo span sea descendiente del primero, y && entre dos conjuntos exige que ambos aparezcan en la misma traza. La última consulta devolvió cero porque el inventario falla antes de consultar la base de datos: TraceQL confirma la lógica del código sin leerlo. La imagen de portada es una de esas trazas lentas, con los cuatro spans en cascada.
Cómo calcular una tasa de error con la aritmética de TraceQL metrics
TraceQL metrics convierte una consulta en una serie temporal, y la 3.1 deja combinar dos de ellas con operadores aritméticos. Esta consulta instantánea sobre los últimos 30 minutos divide los spans de servidor con error del inventario entre todos sus spans de servidor:
({ resource.service.name = "inventario" && span:kind = server
   && status = error } | count_over_time())
/
({ resource.service.name = "inventario" && span:kind = server }
   | count_over_time())
Tempo devolvió una sola serie etiquetada (count_over_time / count_over_time) con valor 0,047. Las dos consultas por separado dieron 54 errores y 1143 spans, y 54 entre 1143 da ese mismo 0,047, cerca del 5 % de fallos que programé. Antes de la 3.1 esa división había que hacerla en Grafana con dos consultas y una transformación.
Las notas de la versión 3.1 en la documentación[6] combinan la aritmética con with(extrapolate=true) para corregir el muestreo. En mi laboratorio no hay muestreo, así que la pista no cambia nada. Según esas notas, a un 10 % de muestreo { } | rate() mostraría unos 50 spans por segundo cuando el tráfico real es de 500.
Grafo de servicios y métricas de span con el metrics-generator
El metrics-generator lee cada span al ingerirlo y escribe dos familias de métricas en Prometheus: traces_spanmetrics_* (llamadas, latencia y tamaño por servicio y operación) y traces_service_graph_* (peticiones entre servicios). Tras las 1225 peticiones, esta consulta en Prometheus devolvió las tres aristas del grafo:
sum by (client, server, connection_type)
  (traces_service_graph_request_total)
| Cliente | Servidor | Tipo | Peticiones |
|---|---|---|---|
| user | tienda | virtual_node | 1225 |
| tienda | inventario | (normal) | 1225 |
| inventario | sqlite | database | 600 |
La arista inventario → sqlite solo cuenta 600 porque el span de base de datos apareció al cambiar al cursor, en la segunda tanda. Tempo reconoce una base de datos cuando un span de tipo cliente lleva db.namespace, db.name, db.system o db.system.name, según la página del grafo de servicios[7]. La instrumentación de sqlite3 de Python aún emite el nombre antiguo db.system, y Tempo lo acepta.
En Grafana, la pestaña Service Graph de Explore dibuja el grafo con esas métricas y una tabla de tasa, errores y duración por operación. Las métricas traces_spanmetrics_calls_total dieron 56 spans con error en el inventario y 1169 sin error.
Cómo actualizar de Tempo 2.x a 3.1
La guía oficial para migrar de Tempo 2.x a 3.0[8] distingue dos caminos. En modo monolítico migras la configuración y cambias la imagen; en microservicios tienes que desplegar la 3.x en paralelo con Kafka y cambiar el tráfico. No hay vuelta atrás: la guía avisa de que no existe una bajada de versión in situ de la 3.0 a la 2.x.
Lo probé con un Tempo 2.10.8 monolítico configurado con las piezas típicas de la 2.x: bloques ingester: y compactor:, el procesador local-blocks y overrides en el formato plano antiguo. Al arrancar la imagen 3.1.0 con ese fichero, Tempo se detuvo al leer la configuración:
failed parsing config: failed to parse configFile /etc/tempo.yaml:
  line 12: field ingester not found in type app.Config
  line 15: field compactor not found in type app.Config
  line 22: field traces_storage not found in type generator.Config
La herramienta prevista es tempo-cli migrate config, de la imagen grafana/tempo-cli:3.1.0. Con mi fichero falló dos veces antes de funcionar:
- Con overrides planos (
metrics_generator_processors) respondelegacy overrides format detected ... run 'tempo-cli migrate overrides-config' first. Peromigrate overrides-configde la 3.1 tampoco puede leer un fichero coningester:. Sal del bucle reescribiendo los overrides a mano en formato con ámbito (overrides.defaults.metrics_generator.processors), que la 2.x ya acepta. - Con los overrides corregidos, falla con
field traces_storage not found: la herramienta quitalocal-blockspero no su bloquemetrics_generator.traces_storage. Bórralo a mano.
En el tercer intento la herramienta avisó de que había eliminado ingester, compactor y el procesador local-blocks, y añadió compaction_disabled: true. Ese ajuste está pensado para convivir con un 2.x en paralelo; en monolítico quítalo, o Tempo no compactará. Tampoco conserva la retención de 48 horas que tenía el bloque compactor:: vuelve a ponerla en backend_worker.compaction.block_retention, o pasará a 336 horas.
Revisa además estos cambios de la 3.0 y la 3.1 antes de actualizar:
- vParquet3: si tu configuración lo fija como formato de escritura, la 3.1 no arranca; cámbialo a vParquet4 o quita la línea
- Receptor OpenCensus: eliminado en la 3.0; los clientes tienen que enviar OTLP
- Modo SSB (scalable single binary): eliminado; elige monolítico o microservicios
- Caché Redis: reescrita en la 3.1, con Redis Cluster por defecto y Sentinel eliminado
query_shards: sustituido porblocks_per_sharden las búsquedas por identificador de traza
Con la configuración migrada, Tempo 3.1 arrancó sobre el mismo volumen que usaba la 2.10.8. Las 200 trazas que había escrito la 2.x, en un bloque vParquet4, se recuperaron las 200 por identificador, y las 100 trazas nuevas quedaron al lado en un bloque vParquet5.
Hubo dos matices. Justo después de actualizar, la búsqueda no devolvía ninguna traza antigua. Los rangos más recientes que query_backend_after (15 minutos por defecto) solo se buscan en el live-store, y el live-store no tiene lo que ingirió la 2.x. Pasados esos 15 minutos, la misma búsqueda devolvió las 300 trazas.
El segundo matiz lo avisa la guía de migración: TraceQL metrics solo lee bloques con factor de replicación 1, y un count_over_time() sobre la tienda contó 100 spans, solo los posteriores a la actualización.
Qué no he probado
Todo lo anterior es un despliegue monolítico con almacenamiento local en una sola máquina arm64. No he probado el modo microservicios con Kafka, un backend S3, la caché Redis ni la redacción por consulta. Tampoco doy cifras de latencia o memoria: la máquina ejecutaba otros trabajos a la vez y cualquier medida de tiempo saldría contaminada. Las duraciones que aparecen en la portada reflejan sobre todo la pausa de 0,4 s que puse en el código.
Si prefieres una sola herramienta para logs, métricas y trazas en vez de cuatro contenedores, la instalación de OpenObserve con Docker es la alternativa que he probado. Para ver cómo encaja Tempo con Loki y Mimir, tienes el repaso al stack de observabilidad de Grafana.
Preguntas frecuentes
¿Necesito Kafka para usar Grafana Tempo 3 con Docker?
No en modo monolítico. La guía de migración lo dice expresamente: el modo monolítico no necesita Kafka, porque el distribuidor entrega los spans al live-store y al metrics-generator dentro del mismo proceso. Kafka solo es obligatorio en modo microservicios.
¿Puedo enviar trazas a Tempo sin Alloy?
Sí. Tempo recibe OTLP directamente en el puerto 4317 (gRPC) o 4318 (HTTP) si activas ese protocolo en distributor.receivers. Alloy añade un punto único donde agrupar, filtrar o muestrear, y evita que cada aplicación conozca la dirección de Tempo.
¿Tengo que convertir mis bloques vParquet4 a vParquet5?
No. Tempo 3.1 lee vParquet4 y vParquet3 tal como están y escribe los bloques nuevos en vParquet5. Si quieres seguir escribiendo vParquet4, fija storage.trace.block.version: vParquet4.
Conclusión
Tempo 3.1 en Docker Compose es un contenedor, un fichero de configuración de 36 líneas y un volumen, con Alloy delante como recolector. La aritmética de TraceQL metrics da una tasa de error en una sola consulta, y el metrics-generator llena Prometheus con el grafo de servicios sin instrumentación extra. La parte delicada es la migración desde 2.x: prepara los overrides en formato con ámbito, quita traces_storage y compaction_disabled, y vuelve a fijar la retención antes de cambiar la imagen.
Como siguiente paso, instrumenta un servicio real y comprueba que su span de base de datos aparece en el grafo; si no aparece, revisa primero las dos dificultades del SDK.
Fuentes: [1] Grafana Tempo v3.1.0, notas de la versión[2], [2] Grafana Tempo v3.0.0, notas de la versión[1], [3] Migrate from Tempo 2.x to 3.0[8], [4] Tempo 3.1 release notes[6], [5] Referencia de configuración de Tempo[4], [6] Service graphs en Tempo[7], [7] Ejemplo single-binary de Tempo con Docker Compose[3], [8] OpenTelemetry: instrumentación de Python sin código[5].
Fuentes
Código fuente
Accede a todo el código fuente de este artículo en GitHub.
Ver en GitHub