Cómo instalar OpenClaw con Docker y un modelo local
Índice de contenidos
- Puntos clave
- Qué es OpenClaw y qué cambió en la versión 2.0
- Qué imagen de Docker elegir
- Cómo queda el despliegue
- Instalar OpenClaw con Docker Compose
- Configurar el modelo local con el onboarding
- Primera conversación y una llamada a herramienta
- Conectar Ollama en lugar de llama-server
- Abrir el Control UI con el token
- Bastionar OpenClaw en Docker
- No publiques el puerto 18789 en todas las interfaces
- Trata el token como la contraseña de root
- Revisa cada skill y cada plugin antes de instalarlo
- Deja al agente las herramientas justas
- Conectar Telegram, WhatsApp o Discord
- Actualizar sin perder el estado
- Preguntas frecuentes
- ¿Puedo usar OpenClaw sin pagar una API?
- ¿Funciona la imagen de OpenClaw en arm64?
- ¿Es seguro exponer OpenClaw a internet?
- Conclusión
- Fuentes
OpenClaw es un asistente de IA de código abierto que se ejecuta en tu máquina como un proceso llamado gateway: guarda las sesiones, llama al modelo y ejecuta herramientas como la shell o el sistema de ficheros. Esta guía instala la versión estable 2026.9.4 con Docker Compose, la conecta a un modelo local servido por llama-server para que funcione sin API en la nube y la bastiona, porque el compose del repositorio publica el gateway en todas las interfaces. Todo lo que sigue lo ejecuté el 14 de septiembre de 2026 en una máquina linux/arm64 de 18 núcleos y 121 GB de memoria, sin GPU.
Puntos clave
- La estable del 14 de septiembre de 2026 es la 2026.9.4, publicada el 11 de septiembre. OpenClaw 2.0 es la v2026.8.1 del 31 de agosto, y la
2026.9.1-beta.1es una beta mal numerada, anterior a esa estable. - La imagen
ghcr.io/openclaw/openclaw:2026.9.4existe para amd64 y arm64, pesa 1,12 GB comprimida y ocupa 4,43 GB en disco. Hoylatestyslimapuntan al mismo digest. - El
docker-compose.ymloficial publica el puerto 18789 en todas las interfaces, y las reglas de UFW no lo frenan. Publica en127.0.0.1y entra por túnel o VPN. - El token del gateway equivale a acceso de administrador: al pegarlo en el navegador, el dispositivo quedó emparejado sin aprobación y con alcance
operator.admin. - Con un modelo de 4B en CPU, el primer turno de agente se cortó dos veces a los 300 s. Subir
timeoutSecondsy activar Tool Search bajó el prompt de unos 24.000 a 11.899 tokens, y el turno terminó con una llamada a herramienta. openclaw security auditmarcó como crítico un modelo pequeño conweb_fetchy sin sandbox. Cinco ajustes lo dejaron en 0 críticos y 0 avisos.
Qué es OpenClaw y qué cambió en la versión 2.0
OpenClaw es un agente de IA personal que se ejecuta en tu hardware. El gateway es un proceso de Node.js que escucha en el puerto 18789, sirve el Control UI (la interfaz web), guarda las sesiones en SQLite y conecta canales como Telegram, WhatsApp o Discord. Tiene licencia MIT a nombre de la OpenClaw Foundation, y el repositorio sumaba 389.686 estrellas el día que escribí esto.
La 2.0 es el apodo de la v2026.8.1, que GitHub fecha el 31 de agosto de 2026. Su página de notas la resume en 16.977 pull requests, 698 commits directos y 987 contribuidores. El artículo de Hannes Rudolph que la anunció el 30 de agosto daba 933 contribuidores; me quedo con la cifra de la documentación, que es la referencia de la versión. Lo que más se nota al instalar es la interfaz web reconstruida, un onboarding más corto y el paso de sesiones y transcripciones a SQLite.
Desde el 1 de septiembre han salido cinco versiones más, de la 2026.8.2 a la 2026.9.4 del 11 de septiembre, que GitHub marca como Latest. Ojo con la lista de etiquetas: la 2026.9.1-beta.1 se publicó el 28 de agosto y, según la propia documentación, "corresponds to 2026.8.1-beta.4; it is not newer than stable 2026.8.1". Si ordenas por número, esa beta parece más nueva que todo lo de agosto y no lo es.
Qué imagen de Docker elegir
Fija ghcr.io/openclaw/openclaw:2026.9.4. El registro de GitHub es el principal y Docker Hub publica un espejo en openclaw/openclaw. Inspeccioné el manifiesto con docker buildx imagetools inspect y trae variantes linux/amd64 y linux/arm64, así que la misma etiqueta sirve en un servidor x86, en uno ARM o en un Mac con Apple Silicon.
| Etiqueta | Qué es | Cuándo usarla |
|---|---|---|
2026.9.4 |
Estable fijada e inmutable | Cualquier instalación que quieras reproducir |
latest y slim |
Hoy, el mismo digest que 2026.9.4; se reconstruyen cada semana |
Pruebas desechables |
2026.9.4-browser |
Añade Chromium; 1,60 GB comprimida en amd64 | Si el agente usa el navegador del gateway |
extended-stable |
Canal lento; hoy apunta a la 2026.6.35 | Si prefieres menos cambios al mes |
2026.9.4-arm64 y 2026.9.4-amd64 |
Una sola arquitectura, sin índice multiplataforma | Registros o herramientas que no leen índices |
La etiqueta slim no es más pequeña. 2026.9.4, 2026.9.4-slim, latest y slim devolvieron el mismo digest, sha256:cc596b84…. La documentación también anuncia etiquetas fechadas del tipo 2026.8.1-r20260820 tras cada reconstrucción semanal, pero su propio ejemplo no existe en GHCR y no encontré ninguna entre las 288 etiquetas del espejo de Docker Hub. La imagen parte de node:24-bookworm-slim, lleva Node 24.19.0 y se ejecuta como el usuario node, con uid 1000.
Cómo queda el despliegue
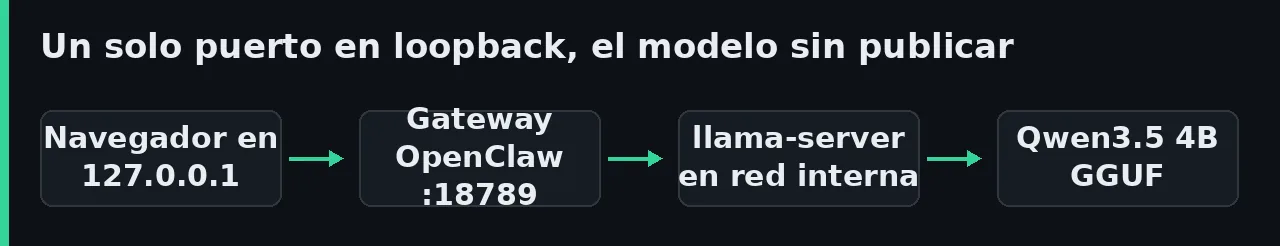
El despliegue son tres servicios en un mismo compose. El servicio llama ejecuta llama-server con el modelo y no publica ningún puerto. El gateway es el único que publica, y lo hace en 127.0.0.1. El cliente de línea de comandos comparte la red del gateway y solo existe mientras dura cada comando.
Necesitas Docker Engine con Compose v2 y unos 8 GB de disco para las dos imágenes y el modelo. En reposo, docker stats dio 465 MiB para el gateway en tres lecturas seguidas, y llama-server ocupó entre 5,1 y 6,1 GiB con 65.536 tokens de contexto. Uso llama-server en lugar de Ollama porque carga el GGUF directamente, sin importarlo, y admite una clave de API; la guía para instalar llama.cpp explica el servidor y sus opciones.
Instalar OpenClaw con Docker Compose
La instalación son cinco pasos:
- Crea el directorio y el fichero
.envcon dos secretos. - Descarga el modelo GGUF y comprueba su suma.
- Escribe
compose.yaml. - Instala el proveedor de llama.cpp y ejecuta el onboarding sin asistente.
- Arranca el gateway y comprueba que responde.
Los dos secretos se generan con openssl y no salen del .env. El token del gateway es la llave del Control UI y la clave de llama-server protege el modelo:
mkdir -p ~/openclaw/{config,workspace,auth-secrets,models}
cd ~/openclaw
umask 077
echo "OPENCLAW_GATEWAY_TOKEN=$(openssl rand -hex 32)" > .env
echo "LLAMA_SERVER_API_KEY=$(openssl rand -hex 24)" >> .env
La imagen se ejecuta con uid 1000. Si tu usuario tiene otro, cambia el propietario de config, workspace y auth-secrets con sudo chown -R 1000:1000, o el gateway fallará con EACCES al escribir su estado.
El modelo es Qwen3.5 4B en Q4_K_M, el que la documentación de OpenClaw recomienda para CPU con un mínimo de 8 GiB de memoria. Son 2.740.937.888 bytes, y la suma SHA-256 tiene que coincidir con la que publica Hugging Face:
HF=https://huggingface.co/unsloth/Qwen3.5-4B-GGUF/resolve/main
curl -L -o models/Qwen3.5-4B-Q4_K_M.gguf "$HF/Qwen3.5-4B-Q4_K_M.gguf"
sha256sum models/Qwen3.5-4B-Q4_K_M.gguf
La suma que obtuve, igual a la publicada, es 00fe7986ff5f6b463e62455821146049db6f9313603938a70800d1fb69ef11a4.
El compose.yaml va en tres partes. La primera son dos anclas de YAML con el entorno y los volúmenes que comparten el gateway y el cliente:
x-oc-env: &oc-env
  HOME: /home/node
  OPENCLAW_HOME: /home/node
  OPENCLAW_STATE_DIR: /home/node/.openclaw
  OPENCLAW_CONFIG_PATH: /home/node/.openclaw/openclaw.json
  OPENCLAW_WORKSPACE_DIR: /home/node/.openclaw/workspace
  OPENCLAW_GATEWAY_PORT: "18789"
  OPENCLAW_GATEWAY_TOKEN: ${OPENCLAW_GATEWAY_TOKEN:?}
  LLAMA_SERVER_API_KEY: ${LLAMA_SERVER_API_KEY:?}

x-oc-vols: &oc-vols
  - ./config:/home/node/.openclaw
  - ./workspace:/home/node/.openclaw/workspace
  - ./auth-secrets:/home/node/.config/openclaw
Las rutas de estado se fijan dentro del contenedor por el mismo motivo que en el compose oficial: que ninguna ruta del anfitrión se cuele desde el .env. La segunda parte es el servicio del modelo:
services:
  llama:
    image: ghcr.io/ggml-org/llama.cpp:server
    environment:
      LLAMA_API_KEY: ${LLAMA_SERVER_API_KEY:?}
    command: >-
      --model /models/Qwen3.5-4B-Q4_K_M.gguf --alias qwen3.5-4b
      --host 0.0.0.0 --port 8080 --ctx-size 65536 --jinja
    volumes:
      - ./models:/models:ro
    restart: unless-stopped
Como no tiene ports, solo lo alcanzan los contenedores del proyecto por el nombre llama. LLAMA_API_KEY activa la autenticación. Sin ella, llama-server (compilación b10969) avisa al arrancar de que CORS acepta cualquier origen sin clave y de que "this can be a security risk (cross-origin attacks)". Con la clave puesta, /v1/models devolvió 401 sin cabecera y 200 con ella.
La tercera parte son el gateway y el cliente de línea de comandos:
  openclaw-gateway:
    image: ghcr.io/openclaw/openclaw:2026.9.4
    environment: *oc-env
    volumes: *oc-vols
    command: node dist/index.js gateway --bind lan --port 18789
    ports:
      - "127.0.0.1:${OPENCLAW_PORT:-18789}:18789"
    cap_drop: [NET_RAW, NET_ADMIN]
    security_opt: ["no-new-privileges:true"]
    init: true
    restart: unless-stopped
    depends_on: [llama]

  openclaw-cli:
    image: ghcr.io/openclaw/openclaw:2026.9.4
    network_mode: "service:openclaw-gateway"
    environment: *oc-env
    volumes: *oc-vols
    cap_drop: [NET_RAW, NET_ADMIN]
    security_opt: ["no-new-privileges:true"]
    entrypoint: ["node", "dist/index.js"]
    profiles: [cli]
El gateway arranca con --bind lan porque dentro del contenedor tiene que aceptar la conexión que entra por el puerto publicado; con loopback no la vería. La protección está en el anfitrión, en el 127.0.0.1: delante del puerto. openclaw-cli usa network_mode: service:openclaw-gateway, así que alcanza el gateway en su propio 127.0.0.1, y el perfil cli evita que docker compose up lo arranque.
Configurar el modelo local con el onboarding
El onboarding interactivo pregunta proveedor, token y canales, pero en Docker es más limpio pasarlo todo por parámetros con --non-interactive. Estos comandos se ejecutan en un contenedor efímero del gateway antes de arrancarlo:
docker compose up -d llama
OC="docker compose run -T --rm --no-deps --entrypoint node openclaw-gateway"
$OC dist/index.js plugins install @openclaw/llama-cpp-provider@2026.9.4
$OC dist/index.js onboard --non-interactive --accept-risk --skip-health \
  --mode local --auth-choice llama-cpp-existing-server \
  --custom-base-url http://llama:8080/v1 --custom-model-id qwen3.5-4b \
  --secret-input-mode ref --gateway-auth token \
  --gateway-token-ref-env OPENCLAW_GATEWAY_TOKEN \
  --skip-channels --no-install-daemon
El proveedor de llama.cpp no viene en la imagen y se instala desde npm, a diferencia del de Ollama, que figura entre los 14 plugins que carga el gateway al arrancar. Fija la versión del paquete, porque sin ella la auditoría avisa con plugins.installs_unpinned_npm_specs. El onboarding respondió Default llama.cpp model: qwen3.5-4b, registró el modelo con 65.536 tokens de contexto y guardó el token como referencia a la variable de entorno, no en claro dentro de openclaw.json.
Quedan cinco ajustes antes de arrancar. Los dos primeros son los que aplica el script oficial setup.sh en Docker, y los tres últimos salen de lo que falló en mi primera prueba, que cuento en la sección siguiente:
$OC dist/index.js config set --batch-json '[
 {"path":"gateway.bind","value":"lan"},
 {"path":"gateway.controlUi.allowedOrigins",
  "value":["http://127.0.0.1:18789","http://localhost:18789"]},
 {"path":"models.providers.llama-cpp.timeoutSeconds","value":1800},
 {"path":"agents.defaults.timeoutSeconds","value":1800},
 {"path":"tools.toolSearch","value":{"mode":"tools"}}
]'
docker compose up -d openclaw-gateway
curl -s http://127.0.0.1:18789/healthz
docker compose port openclaw-gateway 18789
En la máquina de pruebas publiqué en el 19489 con OPENCLAW_PORT=19489 en el .env, para no chocar con otros servicios, y la salida fue esta:
{"ok":true,"status":"live"}
127.0.0.1:19489
Primera conversación y una llamada a herramienta
Mi primer turno de agente, en el que pedí crear un fichero con la configuración del onboarding, no llegó a responder. OpenClaw envió a llama-server 35.649 caracteres de instrucciones y 35.341 de esquemas de 36 herramientas: unos 24.000 tokens, según el progreso que registró el servidor. En una CPU compartida con otros procesos, el modelo no emitió ni un token antes de que el gateway cortara la petición a los 300 s. Reintentó una vez, volvió a cortar y devolvió este error:
The model did not produce a response before the model idle timeout.
Please try again, or increase `models.providers.<id>.timeoutSeconds`
for slow local or self-hosted providers.
El arreglo son dos ajustes. El primero, timeoutSeconds en el proveedor, da margen a un modelo lento. El segundo, tools.toolSearch en modo tools, sustituye los esquemas completos por tres herramientas de búsqueda (tool_search, tool_describe y tool_call) y deja visibles las básicas de código.
La documentación dice que Ollama, LM Studio y los servidores gestionados por OpenClaw activan Tool Search por su cuenta. Un llama-server externo no está en esa lista, y en mi prueba no lo activó.
Con los dos cambios, el turno pasó a 11 herramientas y 5.719 caracteres de esquemas, y el prompt bajó a 11.899 tokens. Este es el comando, con el mismo mensaje:
docker compose run -T --rm openclaw-cli agent --agent main \
  --timeout 1800 --message "Crea en tu workspace un fichero llamado \
hola.txt con el texto 'hola desde OpenClaw' y dime cuantos bytes ocupa."
Esta vez terminó con He creado el archivo hola.txt con el texto "hola desde OpenClaw". El archivo ocupa 19 bytes. El registro del turno muestra successfulToolNames: ["write"], y workspace/hola.txt existe con 19 bytes. Un detalle que conviene saber: el modelo no midió el tamaño con otra herramienta, contó los caracteres. Acertó, pero no lo comprobó.
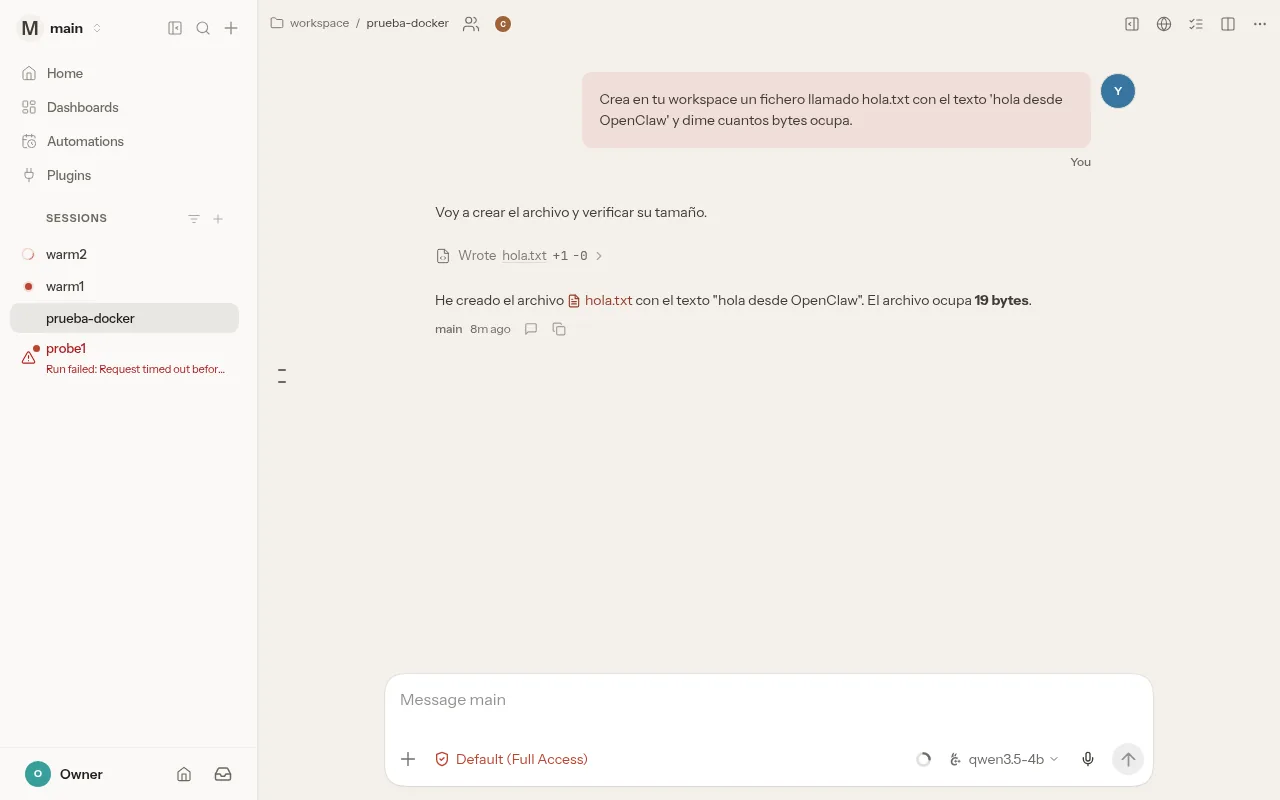
Con la caché de prompt de llama-server ya caliente, pedí tres veces que ejecutara uname -m con la herramienta exec. Las tres respuestas fueron aarch64. Los turnos duraron 61,6 s, 70,8 s y 70,8 s, con una carga media de 26 a 27 en los 18 núcleos por otros trabajos de la máquina. Una CPU libre irá mejor; una con menos núcleos, peor.
| Medida en linux/arm64 sin GPU | Valor |
|---|---|
Imagen openclaw:2026.9.4 |
1,12 GB comprimida, 4,43 GB en disco |
Imagen llama.cpp:server, compilación b10969 |
0,30 GB |
| Gateway en reposo | 465 MiB |
| llama-server con Qwen3.5 4B y 65.536 de contexto | Entre 5,1 y 6,1 GiB |
| Prompt de un turno con 36 herramientas | Unos 24.000 tokens |
| Prompt de un turno con Tool Search | 11.899 tokens |
Turno con exec y caché caliente |
70,8 s de mediana en 3 intentos, carga de 26 a 27 |
Conectar Ollama en lugar de llama-server
Ollama también sirve, con dos detalles: uno está en la documentación y el otro no. El primero es la URL. OpenClaw usa la API nativa de Ollama, la misma del function calling con Ollama, y la documentación advierte que la ruta /v1 "breaks tool calling", así que la dirección es http://ollama:11434, sin sufijo.
El segundo lo encontré al probarlo con Ollama 0.34.0 en otro contenedor del mismo proyecto. El onboarding terminó bien, pero cada petición fallaba con No API key found for provider "ollama" hasta que añadí OLLAMA_API_KEY=ollama-local al entorno del gateway. La documentación dice que los nombres de host sin dominio no necesitan clave; en la 2026.9.4 la necesitaron.
Estos son los cambios sobre el compose anterior, con el mismo GGUF importado en Ollama:
  ollama:
    image: ollama/ollama:0.34.0
    volumes:
      - ./models:/models:ro
      - ollama-data:/root/.ollama
    restart: unless-stopped

volumes:
  ollama-data:
Añade también OLLAMA_API_KEY: ollama-local al ancla x-oc-env, que es donde lo lee el gateway.
Después se importa el modelo y se repite el onboarding con --auth-choice ollama:
docker compose up -d ollama
docker compose exec ollama sh -c \
  'echo "FROM /models/Qwen3.5-4B-Q4_K_M.gguf" > /tmp/Modelfile'
docker compose exec ollama ollama create qwen3.5-4b-gguf -f /tmp/Modelfile
$OC dist/index.js onboard --non-interactive --accept-risk --skip-health \
  --mode local --auth-choice ollama \
  --custom-base-url http://ollama:11434 --custom-model-id qwen3.5-4b-gguf \
  --skip-channels --no-install-daemon
Con eso, openclaw infer model run --gateway --model ollama/qwen3.5-4b-gguf:latest respondió pong. Si ya tienes Ollama instalado en el anfitrión con la guía de instalación de Ollama, la documentación usa http://host.docker.internal:11434 y pide lanzar Ollama con OLLAMA_HOST=0.0.0.0. Eso lo deja escuchando en todas las interfaces del anfitrión, así que el cortafuegos pasa a ser cosa tuya.
Abrir el Control UI con el token
Abre http://127.0.0.1:18789/ en el navegador del mismo equipo. Sin token, el gateway rechaza la conexión y el Control UI muestra esta pantalla:
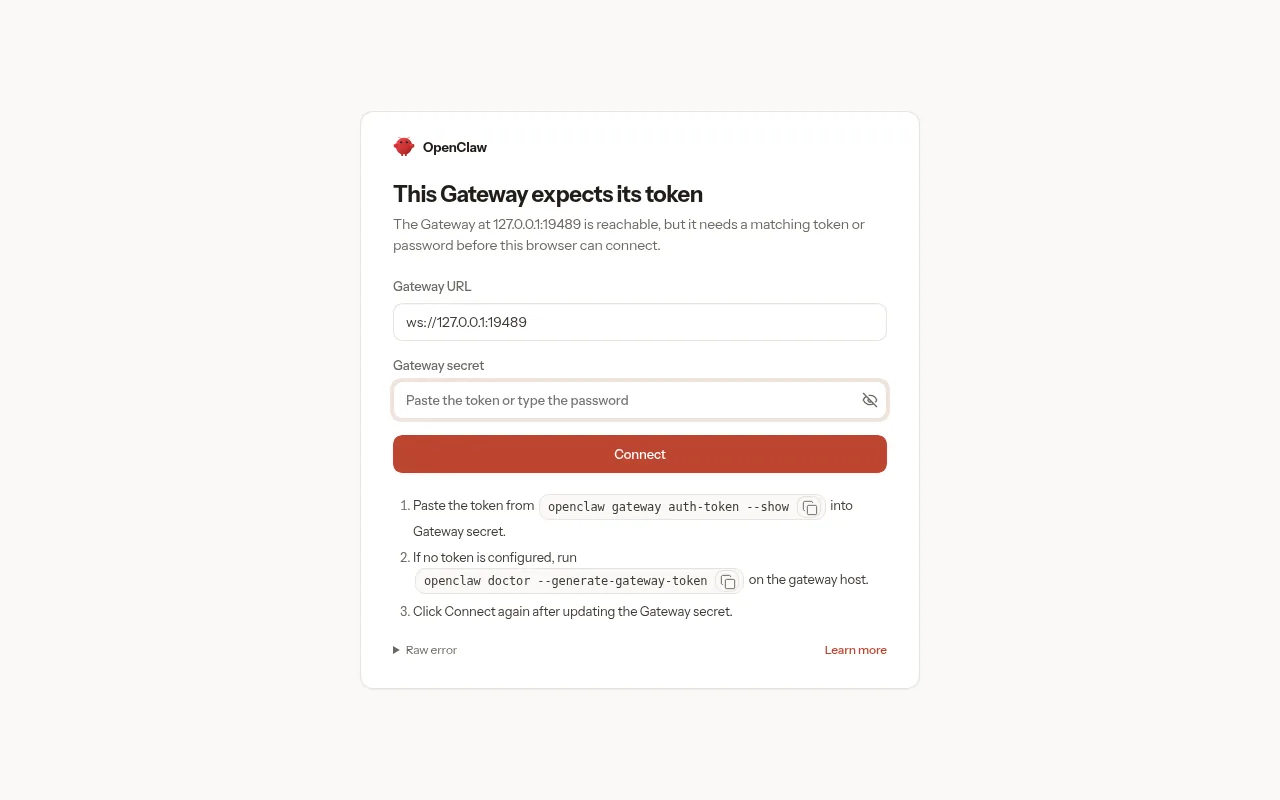
El token es el valor de OPENCLAW_GATEWAY_TOKEN en tu .env: pégalo en Gateway secret y pulsa Connect. En mi prueba no hizo falta aprobar el dispositivo. El registro anotó device pairing auto-approved, y openclaw devices list mostró el navegador, llegado desde 172.24.0.1 (la pasarela del puente de Docker), con los alcances operator.admin, operator.read, operator.write, operator.approvals, operator.questions y operator.pairing. Quien tenga el token tiene el gateway entero.
La sesión se abre además en modo Default (Full Access), y el agente ejecuta comandos sin pedir aprobación. Es lo previsto para un único operador de confianza según el modelo de seguridad del proyecto, y conviene tenerlo presente antes de conectar un canal de mensajería.
Bastionar OpenClaw en Docker
La imagen viene razonablemente cerrada por dentro, con usuario sin privilegios, no-new-privileges y sin NET_RAW; el riesgo está en cómo se publica y en qué dejas hacer al agente. Peter Steinberger, que empezó el proyecto en su Mac, lo resumió así en abril de 2026: "Nothing that can run tools, hold credentials and install plugins is safe by default."
No publiques el puerto 18789 en todas las interfaces
El compose del repositorio en la etiqueta v2026.9.4 declara "${OPENCLAW_GATEWAY_PORT:-18789}:18789" sin dirección delante, junto a los puertos 18790 y 3978. Renderizado con docker compose config, ninguno lleva host_ip, así que Docker los abre en todas las interfaces del anfitrión. La documentación de seguridad lo admite: las imágenes de contenedor "default to an exposed bind".
UFW no te cubre, y la documentación de Docker explica por qué: "Packets are routed before the firewall rules can be applied, effectively ignoring your firewall configuration." La solución es no exponerlo. Pon 127.0.0.1: delante del puerto, como en el compose de esta guía, y compruébalo con ss -ltn, que en mi prueba solo mostró 127.0.0.1:19489.
Si de verdad necesitas abrirlo a una red, OpenClaw documenta reglas en la cadena DOCKER-USER, que se evalúa antes que las reglas de aceptación de Docker. Esta es su receta para /etc/ufw/after.rules, tal cual la publica; no la probé porque la máquina de pruebas no usa UFW:
*filter
:DOCKER-USER - [0:0]
-A DOCKER-USER -m conntrack --ctstate ESTABLISHED,RELATED -j RETURN
-A DOCKER-USER -s 127.0.0.0/8 -j RETURN
-A DOCKER-USER -s 10.0.0.0/8 -j RETURN
-A DOCKER-USER -s 172.16.0.0/12 -j RETURN
-A DOCKER-USER -s 192.168.0.0/16 -j RETURN
-A DOCKER-USER -s 100.64.0.0/10 -j RETURN
-A DOCKER-USER -p tcp --dport 80 -j RETURN
-A DOCKER-USER -p tcp --dport 443 -j RETURN
-A DOCKER-USER -m conntrack --ctstate NEW -j DROP
-A DOCKER-USER -j RETURN
COMMIT
La receta deja pasar el tráfico que sale de redes privadas, incluidas las de los propios contenedores, y desde fuera solo admite conexiones nuevas a los puertos 80 y 443. Si Docker usa IPv6, la documentación pide la misma política en /etc/ufw/after6.rules.
Para usarlo desde fuera no hace falta abrir nada. Un túnel con ssh -L 18789:127.0.0.1:18789 tu_usuario@tu_servidor o una VPN con Headscale llevan el puerto a tu portátil, y la documentación prefiere Tailscale Serve a publicar en la red local.
Trata el token como la contraseña de root
El token de 64 caracteres hexadecimales que genera openssl rand -hex 32 queda lejos del mínimo de 24 que vigila la auditoría. El gateway, además, rechaza al arrancar un token vacío o copiado de un ejemplo. Añade un límite de intentos con gateway.auth.rateLimit: con --bind lan y sin él, la auditoría avisa de que los ataques de fuerza bruta contra la autenticación no tienen freno.
Mantén la imagen al día aunque el gateway solo escuche en loopback. El aviso GHSA-g8p2-7wf7-98mq (CVE-2026-25253, CVSS 8,8) describió un Control UI que aceptaba gatewayUrl desde la dirección de la página y enviaba el token al servidor que indicara ese parámetro. Según el aviso, era explotable "even on instances configured to listen on loopback only", porque el navegador de la víctima hace de puente, y quedó corregido en la v2026.1.29.
El ritmo de avisos es alto. La página de seguridad del proyecto, revisada el 9 de septiembre de 2026, contaba 1.799 informes recibidos desde enero, 722 correcciones publicadas, 39 con CVE y 14 críticas confirmadas. Fija la versión, pero no la dejes fija seis meses.
Revisa cada skill y cada plugin antes de instalarlo
Una skill de ClawHub es código que se ejecuta con tus herramientas y tus datos. Unit 42, el equipo de investigación de Palo Alto Networks, recoge que Koi Security documentó 341 skills maliciosas en la campaña ClawHavoc. Trend Micro confirmó otras que distribuían AMOS, un ladrón de credenciales para macOS. Después de que ClawHub integrara el análisis de VirusTotal, Unit 42 todavía encontró cinco skills maliciosas sin bloquear entre febrero y mayo de 2026, y OpenClaw las borró tras el aviso.
El propio proyecto no promete más: la documentación dice que OpenClaw "does not run built-in local dangerous-code blocking during plugin/skill install or update". Fija versiones exactas, lee el SKILL.md y los scripts antes de activar nada y, si administras más de una máquina, define security.installPolicy para que un comando tuyo permita, avise o bloquee cada instalación. La defensa frente a prompt injection aplica igual, porque una skill también puede traer instrucciones.
Deja al agente las herramientas justas
La auditoría de la instalación recién hecha, ya con el plugin fijado, dio un crítico y un aviso:
Summary: 1 critical · 1 warn · 1 info
CRITICAL
models.small_params Small models require sandboxing and web tools disabled
- llama-cpp/qwen3.5-4b (4B) @ agents.defaults.model.primary
  (unsafe; sandbox=off; web=[web_fetch])
WARN
gateway.auth_no_rate_limit No auth rate limiting configured
El crítico tiene sentido. La documentación advierte que los modelos pequeños son más vulnerables al secuestro de instrucciones, y un 4B que lee páginas con web_fetch y tiene exec es justo la combinación que busca un atacante. Con estos cinco ajustes la auditoría quedó en 0 critical · 0 warn · 2 info, y el agente siguió ejecutando exec en un turno de prueba:
docker compose run -T --rm openclaw-cli config set --batch-json '[
 {"path":"gateway.auth.rateLimit",
  "value":{"maxAttempts":10,"windowMs":60000,"lockoutMs":300000}},
 {"path":"tools.byProvider",
  "value":{"llama-cpp/qwen3.5-4b":{"deny":["group:web","browser"]}}},
 {"path":"tools.deny",
  "value":["gateway","cron","sessions_spawn","sessions_send"]},
 {"path":"tools.elevated.enabled","value":false},
 {"path":"browser.enabled","value":false}
]'
docker compose restart openclaw-gateway
docker compose run -T --rm openclaw-cli security audit
No activé el sandbox de herramientas. Con el backend de Docker, el sandbox exige montar el socket de Docker en el gateway, y quien accede a ese socket controla el daemon del anfitrión. Ese intercambio lo decides tú. Para un agente que solo conversa, la documentación ofrece una base más estricta con tools.profile: "messaging" y exec denegado.
Conectar Telegram, WhatsApp o Discord
Esta parte no la probé, porque requiere tokens de bot que no tenía. La guía de Docker de OpenClaw lo reduce a un comando por canal:
docker compose run --rm openclaw-cli channels login
docker compose run --rm openclaw-cli channels add --channel telegram \
  --token "tu_token_de_bot"
El primero empareja WhatsApp con un código QR y el segundo registra un bot de Telegram. Por defecto, un desconocido que escribe al bot recibe un código de emparejamiento y su mensaje no llega al modelo; lo apruebas con openclaw pairing approve. Mantén esa política, porque con dmPolicy: "open" y la lista de permitidos en "*", cualquiera que encuentre el bot usa tus herramientas.
Actualizar sin perder el estado
Cambia la etiqueta en compose.yaml y ejecuta docker compose pull seguido de docker compose up -d openclaw-gateway. Al arrancar con el estado montado, el gateway aplica sus migraciones antes de declararse listo. Si no puede, sale y Docker lo reinicia en bucle; en ese caso ejecuta una vez openclaw doctor --fix con los mismos volúmenes.
Haz copia de config antes de actualizar y guárdala como una credencial: la documentación advierte que los tokens OAuth quedan en texto plano dentro de SQLite en ese directorio. Y recuerda que docker compose restart no aplica cambios del .env, para eso hace falta up -d.
Preguntas frecuentes
¿Puedo usar OpenClaw sin pagar una API?
Sí. Con llama-server u Ollama en el mismo compose, ninguna petición del agente sale a un proveedor externo. El precio es la velocidad y la seguridad. Un 4B en CPU tardó 70,8 s de mediana en un turno con una herramienta, y la auditoría lo marca como crítico con herramientas web y sin sandbox.
¿Funciona la imagen de OpenClaw en arm64?
Sí. La 2026.9.4 publica variantes linux/amd64 y linux/arm64 en el mismo manifiesto, y toda esta guía se ejecutó en arm64. No la probé en una Raspberry Pi: el gateway y el modelo de 4B suman unos 6,5 GiB en mis medidas, así que una placa de 8 GiB va justa.
¿Es seguro exponer OpenClaw a internet?
No de forma directa. Publica el gateway en 127.0.0.1, entra por túnel SSH o VPN, mantén la autenticación por token y pasa openclaw security audit después de cada cambio. El modelo de confianza del proyecto asume un solo operador por gateway, y para personas que no se fían entre sí pide gateways separados.
Conclusión
Instalar OpenClaw con Docker son tres servicios y un puñado de comandos, y funciona con un modelo local sin ninguna clave de API externa. Lo que el compose oficial no te da hecho es el perímetro. Publica en 127.0.0.1, pon clave al servidor del modelo, sube los límites de tiempo si usas CPU y recorta herramientas hasta que la auditoría salga limpia. Si vas a llevarlo más allá de tu máquina, lee antes cómo desplegar un agente de IA en producción.
La versión en inglés de esta guía está en How to install OpenClaw with Docker.
Fuentes
- OpenClaw, repositorio en GitHub
- OpenClaw, versión 2026.9.4 en GitHub
- OpenClaw, notas de la v2026.8.1 (OpenClaw 2.0)
- OpenClaw, artículo OpenClaw 2.0, Accidentally
- OpenClaw, instalación con Docker
- OpenClaw, operaciones de Compose y mantenimiento de imágenes
- OpenClaw, docker-compose.yml en la etiqueta v2026.9.4
- OpenClaw, onboarding desde la línea de comandos
- OpenClaw, proveedor llama.cpp
- OpenClaw, modelos locales
- OpenClaw, proveedor Ollama
- OpenClaw, red y proveedores en Docker
- OpenClaw, seguridad
- OpenClaw, exposición de red
- OpenClaw, modelo de confianza
- OpenClaw, preguntas sobre seguridad y control de acceso
- OpenClaw, aviso GHSA-g8p2-7wf7-98mq
- OpenClaw, página de estado de seguridad
- OpenClaw, artículo How OpenClaw Got Safer in Public
- Unit 42, OpenClaw’s Skill Marketplace and the Emerging AI Supply Chain Threat
- Docker, filtrado de paquetes y cortafuegos
Código fuente
Accede a todo el código fuente de este artículo en GitHub.
Ver en GitHub