Cómo instalar Open WebUI con Docker y Ollama, imagen slim incluida
Índice de contenidos
- Puntos clave
- Qué es Open WebUI y qué trae la versión 0.11
- Qué necesitas antes de empezar
- Imagen slim o completa: cuánto ocupa cada una
- El docker-compose.yml con Ollama y Open WebUI
- Cómo arrancar el stack y descargar un modelo
- Cómo crear la cuenta de administrador
- Por qué gemma3:1b responde que no admite herramientas
- El segundo fallo: 12 minutos para 57 tokens
- Cómo activar la aprobación de herramientas
- Por qué el modelo no veía la herramienta
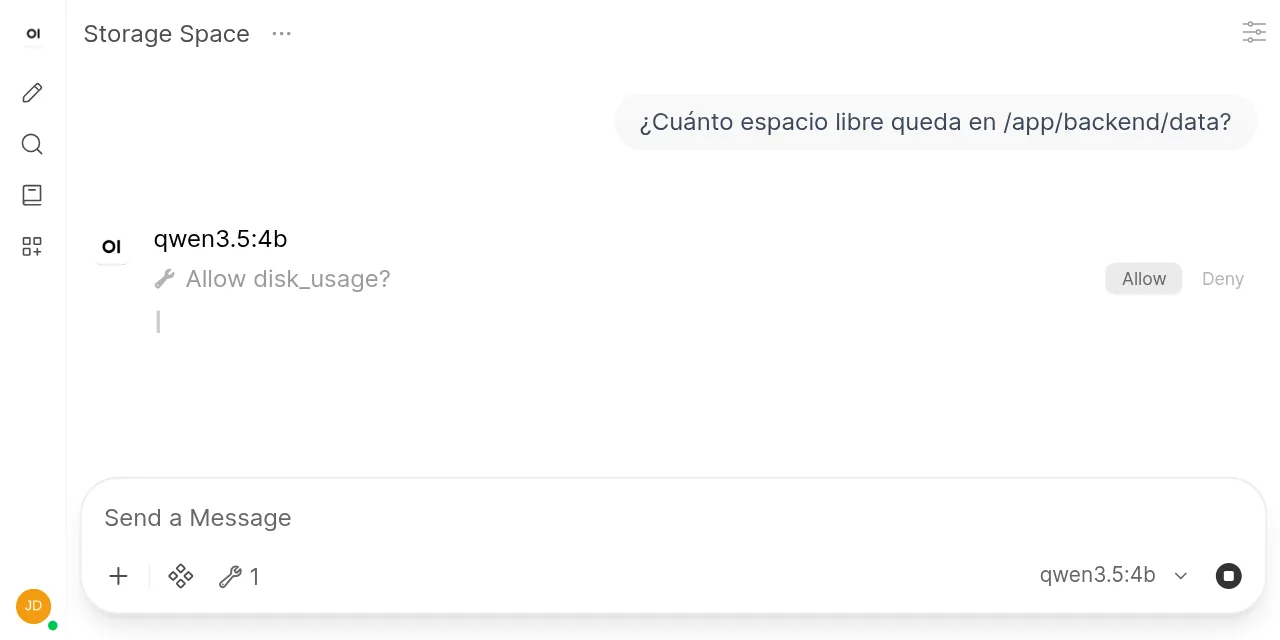
- Qué pasa al pulsar Allow o Deny
- Cómo actualizar desde una versión anterior a la 0.11.1
- Qué no hace la imagen slim
- Preguntas frecuentes
- ¿Qué imagen de Open WebUI elijo para usarla con Ollama?
- ¿Por qué Open WebUI dice que mi modelo no admite herramientas?
- ¿La aprobación de herramientas funciona en todos los chats?
- Conclusión
- Fuentes
Open WebUI 0.11.4 se instala con un docker-compose.yml de dos servicios, Ollama y la imagen slim, y en arm64 esa imagen descarga 176 MB frente a los 1,49 GB de la completa. Lo monté el 27 de septiembre de 2026 en una máquina arm64 de 18 núcleos sin GPU. Creé la cuenta de administrador, hablé con dos modelos locales y probé la aprobación de herramientas que llegó en la 0.11.1. Por el camino aparecieron dos fallos que la guía de instalación oficial no menciona, y aquí van con su arreglo. Tienes también la versión en inglés de esta guía.
Puntos clave
- La etiqueta
0.11.4-slimocupó 829 MB en disco y la completa 5,82 GB. Para chatear con modelos de Ollama, la slim hace lo mismo. - Con la configuración por defecto, gemma3:1b responde con el error "does not support tools". Se arregla desmarcando Builtin Tools en ese modelo.
- Las herramientas integradas ocupan 6 274 tokens, y Ollama recortó el prompt a 2 050 con su contexto de 4 096. Sube
num_ctxo tu herramienta desaparece sin aviso. - La aprobación de herramientas está desactivada por defecto y es experimental. Se activa en Admin > Interface > Tool Permissions y cada usuario elige Ask for approval en su chat.
- La 0.11.1 corrigió 12 CVE publicados el 9 de septiembre de 2026, con una puntuación CVSS de hasta 8,7. Actualiza con una etiqueta fija y copia antes el volumen.
Qué es Open WebUI y qué trae la versión 0.11
Open WebUI es una interfaz web autoalojada para conversar con modelos de lenguaje: gestiona usuarios, guarda los chats y habla con Ollama o con cualquier API compatible con OpenAI. No ejecuta modelos por sí misma en la imagen slim, así que necesita un motor como Ollama al lado. Si todavía no lo conoces, la guía para instalar Ollama en tu ordenador explica ese motor por separado.
La serie 0.11 salió el 27 de julio de 2026 y su último parche, la 0.11.4, el 21 de septiembre. Según las notas de la versión 0.11.4[1], la imagen slim pasa a pesar "around 175 MB, near enough 89% smaller than the last release". La versión 0.11.1[2], del 25 de agosto, añadió la aprobación humana de herramientas y un aviso de seguridad que recomienda actualizar cuanto antes.
Qué necesitas antes de empezar
La instalación pide Docker con el plugin Compose v2 y unos 5 GB libres para las imágenes y un modelo pequeño. Esto es lo que usé:
- Docker 29.5.2 con Docker Compose v2.40.3. Si partes de cero, sigue la guía para instalar Docker en Debian 13
- Una máquina Linux arm64 (una VM de OrbStack sobre Apple silicon) con 18 núcleos, 47 GiB de RAM y sin GPU
- Ollama 0.34.4, la versión marcada como la última en GitHub a 27 de septiembre de 2026. La 0.40.0 ya aparece en el repositorio, pero sus notas hablan de preversión y Docker Hub solo tiene
0.40.0-rc0 opensslpara generar la clave de sesión
La imagen de Open WebUI es multiarquitectura: el registro publica variantes linux/amd64 y linux/arm64 para las dos etiquetas que uso aquí.
Imagen slim o completa: cuánto ocupa cada una
La imagen slim es la completa sin la pila local de aprendizaje automático: sin torch, sin Whisper, sin modelos de embeddings y sin navegador headless. Descargué las dos etiquetas fijadas y esto es lo que midió docker image ls --tree en arm64:
| Etiqueta | Descarga (arm64) | En disco (arm64) | Cuándo usarla |
|---|---|---|---|
0.11.4-slim |
176 MB | 829 MB | Ollama u otra API ejecutan los modelos |
0.11.4 |
1,49 GB | 5,82 GB | RAG con embeddings locales, PDF, voz local |
0.11.3-slim |
1,38 GB | sin medir | Referencia: la slim anterior |
En arm64 la reducción de la slim entre la 0.11.3 y la 0.11.4 es del 87 %, cerca del 89 % que anuncian las notas. La documentación de las variantes de imagen[3] lo resume así: "Nothing extra is required to run it", y el chat funciona igual que en :main.
Fija siempre una versión. :main y :latest se reconstruyen con cada cambio en la rama principal, y :latest no apunta a la última versión estable.
El docker-compose.yml con Ollama y Open WebUI
Crea una carpeta para el proyecto y, dentro, un fichero .env con la clave que firma las sesiones. Sin una clave fija, cada vez que recreas el contenedor se cierran las sesiones de todos:
mkdir open-webui && cd open-webui
echo "WEBUI_SECRET_KEY=$(openssl rand -hex 32)" > .env
El docker-compose.yml levanta dos servicios en la misma red. Open WebUI encuentra a Ollama por su nombre de servicio y solo publica su puerto en 127.0.0.1:
services:
  ollama:
    image: ollama/ollama:0.34.4
    volumes:
      - ollama:/root/.ollama
    restart: unless-stopped

  open-webui:
    image: ghcr.io/open-webui/open-webui:0.11.4-slim
    depends_on:
      - ollama
    ports:
      - "127.0.0.1:3000:8080"
    volumes:
      - open-webui:/app/backend/data
    environment:
      - OLLAMA_BASE_URL=http://ollama:11434
      - WEBUI_SECRET_KEY=${WEBUI_SECRET_KEY}
    restart: unless-stopped

volumes:
  ollama:
  open-webui:
El volumen open-webui guarda la base de datos SQLite con usuarios, chats y ajustes, y el volumen ollama guarda los modelos. Ollama no publica el puerto 11434 en el host, así que solo Open WebUI habla con él. En mi prueba cambié el puerto por el 22300 y monté una caché de modelos compartida en lugar del volumen ollama; el resto del fichero es idéntico. Si quieres más detalle sobre el fichero .env, lo cuento en variables de entorno y secretos en Docker Compose.
Cómo arrancar el stack y descargar un modelo
Levanta los dos contenedores y descarga los modelos dentro del de Ollama:
docker compose up -d
docker compose exec ollama ollama pull qwen3.5:4b
docker compose exec ollama ollama pull gemma3:1b
curl -s http://127.0.0.1:3000/api/version
La última orden devolvió {"version":"0.11.4","deployment_id":""} en cuanto el contenedor pasó su comprobación de salud. En el log, Open WebUI aplica sus migraciones de base de datos y avisa de que CORS_ALLOW_ORIGIN vale *, algo que conviene fijar a tu dominio antes de exponerlo. qwen3.5:4b pesa 3,4 GB y admite herramientas; gemma3:1b pesa 815 MB y no las admite, y esa diferencia importa dos secciones más abajo.
En reposo, con una carga media por debajo de 1,3, el contenedor de Open WebUI usó 293 MiB de RAM (mediana de tres muestras). Ollama, con los dos modelos cargados y qwen3.5:4b con 8 192 tokens de contexto, usó 5,7 GiB.
Cómo crear la cuenta de administrador
La primera cuenta que se registra es la de administrador. Abre http://127.0.0.1:3000, pulsa Get started y rellena nombre, correo y contraseña en el formulario Create Admin Account. Guarda esa contraseña: sin ella pierdes el acceso a los ajustes de la instancia.
Según la guía de inicio de Open WebUI[3], el registro se cierra solo en cuanto existe el administrador. Si quieres invitar a más gente, activa New Sign Ups en Admin > Authentication; las cuentas nuevas quedan como Pending hasta que las apruebas. Tras crear la cuenta, el selector de modelos ya mostraba qwen3.5:4b y gemma3:1b, sin configurar ninguna conexión, gracias a OLLAMA_BASE_URL.
Por qué gemma3:1b responde que no admite herramientas
Mi primer mensaje a gemma3:1b no obtuvo respuesta, sino este error: registry.ollama.ai/library/gemma3:1b does not support tools. La causa es que desde la versión 0.10.0 todos los modelos usan el modo nativo de llamada a funciones. Ese modo añade a cada petición las herramientas integradas de Open WebUI (memoria, notas, calendario, automatizaciones…), y Ollama rechaza la petición si el modelo no declara soporte de herramientas.
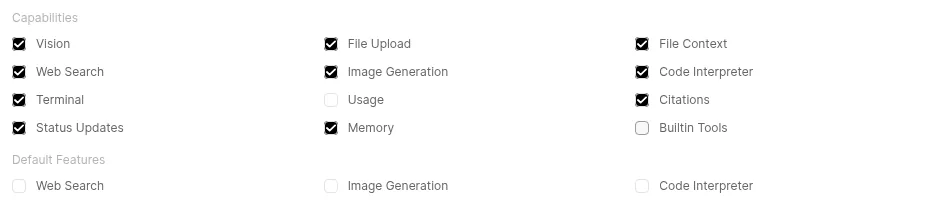
El arreglo está en Admin > Models. Edita gemma3:1b, desmarca Builtin Tools en Capabilities y pulsa Save & Update. La documentación de herramientas[4] lo recomienda justo para modelos pequeños que no manejan el parámetro tools. Con la casilla desmarcada, la misma pregunta obtuvo dos frases correctas en español.
El segundo fallo: 12 minutos para 57 tokens
Esa primera respuesta de gemma3:1b tardó 12 min 57 s en generar 57 tokens, con la máquina compartida con otras cargas (carga media de 52). Repetí la medida con la máquina en reposo llamando a la API de Ollama. Cada fila es la mediana de tres ejecuciones, todas empezadas con una carga media por debajo de 3:
| Modelo | Hilos | Tokens/s generando |
|---|---|---|
| gemma3:1b | 18 (por defecto) | 0,44 |
| gemma3:1b | 17 | 120,3 |
| gemma3:1b | 16 | 123,7 |
| gemma3:1b | 8 | 125,2 |
| gemma3:1b | 4 | 106,2 |
| qwen3.5:4b | 18 (por defecto) | 0,25 |
| qwen3.5:4b | 8 | 56,6 |
La lentitud no venía de la carga ajena: se repite en reposo. Ollama arranca por defecto un hilo por núcleo, 18 en esta VM, y con los 18 ocupados la generación se hunde; con 17 ya va a 120 tokens/s. Mi hipótesis es que, sin un núcleo libre, cualquier otro proceso del sistema frena a todos los hilos, pero no lo he comprobado. Con 8 hilos el mismo modelo fue 284 veces más rápido que con 18.
No lo generalizo a otro hardware, pero si tu CPU va tan lenta, prueba el parámetro num_thread (Ollama) en Advanced Params del modelo con un valor por debajo del número de núcleos. Yo lo fijé en 8 para los dos modelos.
Cómo activar la aprobación de herramientas
La aprobación de herramientas detiene al modelo antes de cada llamada y te pregunta si la permites. Viene desactivada y marcada como experimental, y tiene dos interruptores: uno del administrador y otro de cada usuario. La referencia de variables de entorno[5] documenta el primero como ENABLE_TOOL_PERMISSIONS; yo usé el interruptor de la interfaz, que guarda el mismo ajuste.
Estos son los pasos que seguí:
- En Admin > Interface, activa Tool Permissions y guarda
- En Workspace > Tools, crea una herramienta nueva con el código de abajo y confirma el aviso de código arbitrario
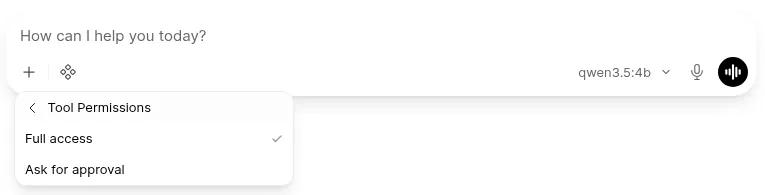
- En un chat nuevo con qwen3.5:4b, abre el menú +, entra en Tool Permissions y elige Ask for approval
- En el menú de integraciones, activa la herramienta Disk Usage
La herramienta de prueba informa del espacio libre en un directorio del servidor. Es inofensiva, pero se ejecuta dentro del contenedor, que es justo lo que la aprobación debe vigilar:
"""
title: Disk usage
description: Reports disk space for a directory on the Open WebUI server
version: 0.1.0
"""
import shutil

class Tools:
    def __init__(self):
        pass

    async def disk_usage(self, path: str = "/app/backend/data") -> str:
        """
        Report total, used and free disk space for a directory on the server.
        :param path: Directory to inspect
        """
        total, used, free = shutil.disk_usage(path)
        gib = 1024**3
        return (
            f"{path}: {total / gib:.1f} GiB total, "
            f"{used / gib:.1f} GiB used, {free / gib:.1f} GiB free"
        )
Open WebUI rellena el nombre, el identificador y la descripción a partir del bloque inicial. El docstring de cada método es lo que lee el modelo para decidir si la llama. Como advierte la guía de desarrollo de herramientas[6]: "Granting a user the ability to create or import Tools is equivalent to giving them shell access to the server."
Por qué el modelo no veía la herramienta
Con todo activado, qwen3.5:4b contestó dos veces que no tenía ninguna herramienta llamada disk_usage. La petición sí la incluía, pero el log de Ollama lo explicó: truncating input prompt limit=2050 prompt=6274. Las herramientas integradas más la mía sumaban 6 274 tokens. Con el contexto por defecto de 4 096, Ollama recortó el prompt y con él la definición de la herramienta.
Tienes dos salidas. Sube num_ctx (Ollama) en Advanced Params del modelo, que es lo que hice (8 192), o desmarca Builtin Tools si no usas memoria, notas ni calendario.
Con 8 192 tokens de contexto y Ollama recién reiniciado, la aprobación apareció a los 52 s (mediana de tres ejecuciones). Ese tiempo se va en cargar el modelo y procesar esos 6 268 tokens en CPU. En las conversaciones siguientes, con el prompt ya en caché, tardó 1,3 s (también mediana de tres).
Qué pasa al pulsar Allow o Deny
Cuando el modelo pide la herramienta, la respuesta se detiene en "Allow disk_usage?" con dos botones. Al pulsar Allow, la herramienta se ejecutó y el modelo respondió "Hay 2155.1 GiB de espacio libre disponible en /app/backend/data", que coincide con los 2,2 TB libres que da df -h en el contenedor. Al pulsar Deny, Open WebUI devuelve al modelo el texto Error: tool call rejected by user. y marca la llamada como denegada.
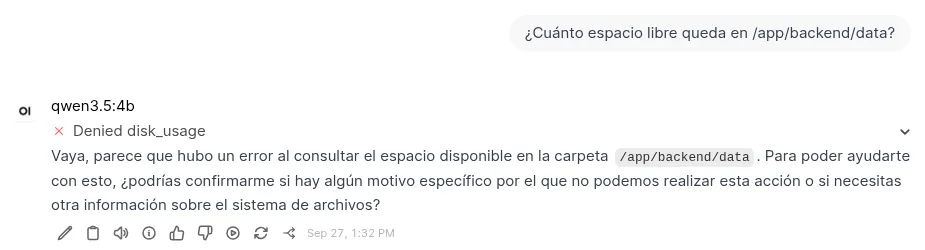
La llamada pendiente se guarda en el propio mensaje, así que sobrevive a recargar la página. Por la misma razón no funciona en los chats temporales, y las automatizaciones y las respuestas en canales siempre se ejecutan con acceso completo. Este patrón de parar al agente antes de actuar lo explico en human-in-the-loop en agentes de IA. La mecánica de fondo está en llamadas a funciones con Ollama en tu propio equipo.
Cómo actualizar desde una versión anterior a la 0.11.1
Si tienes una instalación anterior a la 0.11.1, actualiza. La base de datos de vulnerabilidades del NIST publicó el 9 de septiembre de 2026 doce CVE que afectan a versiones "until 0.11.1". El más grave, CVE-2026-87995[7], tiene una puntuación CVSS 3.1 de 8,7.
Probé la actualización de 0.11.0-slim a 0.11.4-slim con un chat guardado. Primero para el contenedor y copia el volumen con un contenedor desechable (en mi prueba el volumen se llamaba b5p3-upg_open-webui):
docker compose stop open-webui
docker run --rm -v open-webui_open-webui:/data:ro -v "$PWD":/backup \
  alpine:3.22 tar czf /backup/open-webui-backup.tgz -C /data .
Después cambia la etiqueta en el docker-compose.yml y ejecuta docker compose up -d. Open WebUI aplicó tres migraciones al arrancar y el chat seguía allí. Revisa el tamaño de la copia: la 0.11.0-slim había descargado 889 MB de modelos de embeddings en cache/embedding dentro del volumen. La 0.11.4-slim ya no los carga, pero no los borra.
El nombre del volumen lleva delante el del proyecto de Compose, que por defecto es el de la carpeta. Compruébalo con docker volume ls antes de copiarlo. Desde la 0.11.3, una migración fallida detiene el arranque en vez de dejarlo a medias. Ese era el fallo de "chat.timer_at" al actualizar desde la 0.11.0, 0.11.1 o 0.11.2.
Qué no hace la imagen slim
La imagen slim arranca y chatea igual que la completa, pero cada función que dependía de un modelo local necesita ahora un servicio externo. Según las notas de la 0.11.4 y la documentación, estas son las diferencias que más pesan:
- Base de datos: solo SQLite o PostgreSQL. Con MySQL o MariaDB se niega a arrancar
- Almacenamiento de ficheros: solo local. Con S3, Azure o Google Cloud se niega a arrancar
- Documentos y RAG: necesita embeddings de Ollama, OpenAI o Azure y PostgreSQL con pgvector. Un PDF o un Word falla sin un extractor externo
- Voz: sin Whisper ni voces locales; necesita un motor externo de voz a texto y de texto a voz
- Búsqueda web: sin DDGS, así que necesitas un proveedor con clave
- Intérprete de código: el navegador descarga numpy o pandas de cdn.jsdelivr.net
Si usas Open WebUI solo como interfaz de chat para Ollama, nada de esto te afecta. Si necesitas RAG local con PDF, usa la imagen completa o monta los servicios aparte. Para exponer la instancia fuera de tu red con TLS, la guía de Llama 3.3 y Mistral con Ollama y Open WebUI en Ubuntu 24.04 cubre la parte de Traefik.
Preguntas frecuentes
¿Qué imagen de Open WebUI elijo para usarla con Ollama?
La 0.11.4-slim. Descarga 176 MB en arm64 frente a 1,49 GB de la completa, y el chat con modelos de Ollama funciona igual. Elige la completa solo si necesitas embeddings locales, lectura de PDF sin servicios externos o voz local.
¿Por qué Open WebUI dice que mi modelo no admite herramientas?
Porque desde la versión 0.10.0 el modo nativo añade las herramientas integradas a cada petición, y Ollama la rechaza si el modelo no las admite. Desmarca Builtin Tools en las capacidades de ese modelo o usa un modelo con soporte de herramientas, como qwen3.5:4b.
¿La aprobación de herramientas funciona en todos los chats?
No. Solo en chats guardados cuyo usuario eligió Ask for approval, y solo si el administrador activó Tool Permissions. Los chats temporales, las automatizaciones y las respuestas en canales se ejecutan siempre con acceso completo.
Conclusión
Con Ollama 0.34.4 y la imagen 0.11.4-slim, Open WebUI se queda en 829 MB de disco y menos de 300 MiB de RAM en reposo. Es la opción que recomiendo para un servidor doméstico o una VM pequeña. Los dos tropiezos que encontré vienen del modo nativo de herramientas: desmarca Builtin Tools en los modelos que no las admiten y sube num_ctx en los que sí.
La aprobación de herramientas cumple lo que promete: el modelo se para, tú decides y una denegación le llega como error. Sigue siendo experimental, así que no la trates como una barrera de seguridad. Crear herramientas equivale a dar una terminal en el servidor, y ese permiso conviene reservarlo al administrador. Si prefieres comparar con otro motor, la guía para instalar llama.cpp sirve de alternativa a Ollama.
Fuentes
Código fuente
Accede a todo el código fuente de este artículo en GitHub.
Ver en GitHub