RabbitMQ 4.3: streams o colas quorum, con medidas
Índice de contenidos
- Puntos clave
- Qué diferencia hay entre un stream y una cola quorum
- Qué cambió en RabbitMQ 4.3 para colas quorum y streams
- Cómo hice la prueba
- Cuántos mensajes por segundo mueve cada una
- Qué latencia añade cada una a 10 000 mensajes por segundo
- Cuánto disco y memoria ocupa un millón de mensajes
- Un mensaje sin confirmar ya no retiene el disco
- Releer mensajes: lo que una cola quorum no puede hacer
- Qué ofrece cada tipo de cola en RabbitMQ 4.3
- Cuándo elegir un stream y cuándo una cola quorum
- Preguntas frecuentes
- ¿Puedo convertir una cola quorum en un stream con una política?
- ¿Necesito el plugin de streams para usar un stream?
- ¿Un stream de RabbitMQ sustituye a Kafka?
- Conclusión
- Fuentes
En RabbitMQ 4.3.6, un stream leído con su propio protocolo movió 281 330 mensajes por segundo en mi prueba, 6,2 veces más que una cola quorum, que se quedó en 45 156. Las dos son colas replicadas del mismo broker, pero con contratos distintos: la cola quorum borra cada mensaje cuando el consumidor lo confirma y hace fsync antes de confirmar al publicador, y el stream guarda todo para que cualquiera lo relea. Medí ambas el 16 de septiembre de 2026 con PerfTest y Stream PerfTest, las herramientas oficiales, en un nodo de 4 núcleos con mensajes de 1 KB. Tienes también la versión en inglés de esta comparación.
Puntos clave
- Con un productor, un consumidor y mensajes de 1 KB, la cola quorum sostuvo 45 156 msg/s y el stream, por el protocolo de streams, 281 330 msg/s (medianas de tres ejecuciones).
- Un stream leído por AMQP 0-9-1 aceptó 120 860 msg/s, pero el consumidor solo sacó 62 360 msg/s y la latencia de extremo a extremo llegó a 9,1 s.
- A un ritmo fijo de 10 000 msg/s, la cola quorum tuvo una latencia mediana de 2,73 ms y un p99 de 33,6 ms; el stream por AMQP, 0,80 ms y 5,39 ms.
- Un millón de mensajes ocupó 1,24 GB de disco en la cola quorum y 1,11 GB en el stream, pero el proceso de la cola quorum usó 20,5 MB de memoria y el del stream, 9 KB.
- Con un mensaje sin confirmar, RabbitMQ 4.2.9 retuvo 1,02 GB de segmentos de la cola quorum y la 4.3.6 dejó menos de 9 MB.
- El stream no hace fsync antes de confirmar y no tiene dead lettering, TTL ni prioridades; la cola quorum sí, y la 4.3 le añadió reintentos con espera y timeout de consumidor.
Qué diferencia hay entre un stream y una cola quorum
Una cola quorum es una cola FIFO replicada con el algoritmo de consenso Raft: entrega cada mensaje a un consumidor y lo borra cuando este lo confirma. Un stream es un registro en el que solo se añade al final (append-only): leer no borra nada, y cada consumidor elige desde qué posición (offset) empieza. La guía de streams de RabbitMQ[1] lo resume así: "streams were not introduced to replace queues but to complement them".
Los dos tipos se declaran con el argumento x-queue-type (quorum o stream), y ese tipo no se puede cambiar después con una política. La diferencia que más pesa en producción está en la durabilidad. Según la misma guía, los streams no fuerzan el volcado a disco (fsync) y dejan esa decisión al sistema operativo. Una cola quorum, en cambio, no confirma un mensaje hasta que más de la mitad de sus réplicas lo ha escrito y volcado.
La documentación de colas quorum[2] las presenta como la opción por defecto para una cola replicada y de alta disponibilidad. También dice cuándo no usarlas: colas temporales, latencia mínima, backlogs de más de 5 millones de mensajes y fan-outs grandes. Para esos dos últimos casos recomienda un stream.
Qué cambió en RabbitMQ 4.3 para colas quorum y streams
La serie 4.3 se publicó el 23 de abril de 2026, y su parche 4.3.6, el que probé, el 14 de septiembre. La página de versiones de RabbitMQ[3] fija el fin del soporte comunitario de la serie el 30 de noviembre de 2026. Según las notas de RabbitMQ 4.3.0[4], estos son los cambios que afectan a esta comparación:
- Metadatos: Khepri pasa a ser el único almacén, así que el clúster necesita tener en línea a más de la mitad de sus nodos para estar disponible.
- Colas quorum: nueva versión de su máquina de estados con prioridades estrictas de 32 niveles, reintento con espera (
x-delayed-retry-type) y timeout de consumidor. - Disco de las colas quorum: la compactación del registro libera espacio aunque queden mensajes sin confirmar o confirmados fuera de orden.
- Streams: dejan de evaluar el timeout de consumidor, y el ajuste
stream.read_aheadfija cuántos datos se leen del disco por adelantado. - Colas clásicas: las transitorias no exclusivas quedan denegadas por defecto.
Los parches posteriores tocan los streams dos veces. La versión 4.3.2 corrigió una regresión de rendimiento al ensamblar tramas del protocolo de streams. La versión 4.3.5 rechaza de entrada más de 256 publicadores o 256 suscripciones por conexión, un límite del propio formato del protocolo. Las notas de la 4.3.6[5] arreglan otro detalle de los streams: x-max-age se compara ya como duración, así que redeclarar un stream con 1D cuando se creó con 24h deja de fallar.
Comprobé las colas clásicas en 4.3.6. Declarar una cola transitoria no exclusiva por la API HTTP devolvió un 400 con el mensaje Feature transient_nonexcl_queues is deprecated. En cambio, una cola con x-queue-mode=lazy se creó sin error por AMQP y por HTTP, aunque las notas de 4.3.0 dicen que ese argumento hace fallar la declaración.
Cómo hice la prueba
La prueba corrió en un único nodo RabbitMQ 4.3.6 con Erlang 27.3.4.17, dentro de Docker y limitado a 4 CPU y 4 GiB de memoria. La máquina es una VM Linux arm64 de 18 núcleos y 121 GB de RAM (OrbStack sobre Apple silicon), compartida con otros trabajos. El volumen de Docker está en btrfs sobre un disco virtio. Este es el compose.yaml, con los nombres acortados:
services:
  rabbit:
    image: rabbitmq:4.3.6-management
    hostname: bench-rabbit
    cpus: 4
    mem_limit: 4g
    ports:
      - "127.0.0.1:15672:15672"
    volumes:
      - ./enabled_plugins:/etc/rabbitmq/enabled_plugins:ro
      - ./20-bench.conf:/etc/rabbitmq/conf.d/20-bench.conf:ro
      - rabbit-data:/var/lib/rabbitmq
    networks: [bench-net]
volumes:
  rabbit-data:
networks:
  bench-net:
El fichero enabled_plugins activa la interfaz de gestión, Prometheus y los dos plugins de streams, que abren el puerto 5552. El fichero 20-bench.conf fija el umbral de memoria en un valor absoluto:
# enabled_plugins
[rabbitmq_management,rabbitmq_prometheus,rabbitmq_stream,rabbitmq_stream_management].

# 20-bench.conf
vm_memory_high_watermark.absolute = 2400MiB
Ese segundo fichero no es opcional. Sin él, RabbitMQ calculó su umbral en 78,4 GB, el 60 % de la RAM del anfitrión, aunque el contenedor tenía un límite de 4 GiB. La guía de memoria de RabbitMQ[6] recomienda un umbral absoluto en contenedores porque el nodo no siempre detecta el límite de cgroups.
Cada escenario usa un productor, un consumidor, mensajes de 1000 bytes y confirmaciones de publicación, y cada herramienta corre en su propio contenedor con 4 CPU. Para la cola quorum y para el stream por AMQP 0-9-1 usé PerfTest[7] 2.25.0, del 30 de junio de 2026:
docker run --rm --network bench-net --cpus 4 \
  pivotalrabbitmq/perf-test:2.25.0 \
  --uri amqp://guest:guest@bench-rabbit \
  -x 1 -y 1 -s 1000 -c 1000 -q 1000 \
  --quorum-queue --queue qq-1 -z 30
Para el stream por AMQP cambié --quorum-queue por --stream-queue. Para el protocolo de streams usé Stream PerfTest[8] 1.8.0, del 9 de julio de 2026, con sus valores por defecto (lotes de 100 mensajes y hasta 10 000 confirmaciones pendientes):
docker run --rm --network bench-net --cpus 4 \
  pivotalrabbitmq/stream-perf-test:1.8.0 \
  --uris rabbitmq-stream://guest:guest@bench-rabbit:5552 \
  -x 1 -y 1 -s 1000 -z 30 --streams sp-1 -cl -ds
Las pruebas de latencia añaden --rate 10000 a las mismas órdenes. Cada ejecución dura 30 s, y doy la mediana de tres ejecuciones válidas por escenario.
Antes de cada una esperé a que la carga media de un minuto bajase de 6 en los 18 núcleos. Descarté 2 de las 20 ejecuciones porque coincidieron con la carga de otro contenedor. En las 18 válidas, la carga estuvo entre 1,94 al empezar y 5,80 como máximo durante la ejecución.
Cuántos mensajes por segundo mueve cada una
Sin límite de ritmo, el protocolo de streams movió 6,2 veces más mensajes que la cola quorum, y el stream leído por AMQP 0-9-1 quedó en medio con un problema propio:
| Escenario | Publicados/s | Consumidos/s | Latencia mediana | Latencia p99 |
|---|---|---|---|---|
| Cola quorum, AMQP 0-9-1 | 45 164 | 45 156 | 10,8 ms | 35,0 ms |
| Stream, AMQP 0-9-1 | 120 860 | 62 360 | 9,1 s | 15,1 s |
| Stream, protocolo de streams | 281 781 | 281 330 | 24 ms | 40 ms |
La latencia es la de extremo a extremo, desde que el productor publica hasta que el consumidor recibe. En el stream por AMQP, el consumidor sacó la mitad de lo que entraba, así que el retraso creció durante toda la ejecución hasta los 9,1 s de mediana. El publicador sí fue 2,7 veces más deprisa que en la cola quorum. Su confirmación, que no espera a un fsync, tardó 5,9 ms de mediana frente a 10,2 ms.
La presentación de los streams en el blog de RabbitMQ[9], de 2021, decía: "streams are super fast compared to traditional queues, several orders of magnitude faster". En este nodo, con mensajes de 1 KB, la diferencia fue de 6,2 veces, por debajo incluso de un factor 10. La tabla comparativa del protocolo de streams[10] habla de "Hundreds of thousands per second" por AMQP y de "Millions messages per second" con el plugin; aquí el plugin se quedó en 281 330.
El techo del protocolo de streams lo puso el límite de memoria del contenedor. En tres de las cuatro ejecuciones hubo tramos de unos 5 s a entre 500 000 y 600 000 msg/s. Entre ellos, el publicador se detuvo de 3 a 4 s.
Unos 12 s después de empezar a publicar, el contenedor tocó sus 4 GiB, y 3,8 GB eran caché de páginas del núcleo. Los streams escriben a través de esa caché, que en un contenedor cuenta como memoria usada. Lo que no era caché sumaba menos de 470 MB.
Para comprobarlo repetí solo ese escenario con el contenedor limitado a 16 GiB. Las tres ejecuciones, con una carga de 1,82 a 4,30, dieron una mediana de 517 474 msg/s publicados y 517 072 consumidos. No hubo pausas: ningún segundo bajó de 376 000 msg/s, y la caché llegó a 16 GB. Si tu broker va a mover streams a ese ritmo, dimensiona la memoria del contenedor contando con la caché, no solo con el umbral de RabbitMQ.
Qué latencia añade cada una a 10 000 mensajes por segundo
Las tres configuraciones sostienen un ritmo fijo de 10 000 msg/s. A ese ritmo, la cola quorum añadió 3,4 veces más latencia mediana que el stream por AMQP, y 6,2 veces más en el p99:
| Escenario | Extremo a extremo, mediana | Extremo a extremo, p99 | Confirmación, mediana | Confirmación, p99 |
|---|---|---|---|---|
| Cola quorum, AMQP 0-9-1 | 2,73 ms | 33,6 ms | 2,58 ms | 33,2 ms |
| Stream, AMQP 0-9-1 | 0,80 ms | 5,39 ms | 0,44 ms | 1,57 ms |
| Stream, protocolo de streams | 1 ms | 2 ms | menos de 1 ms | 2 ms |
En la cola quorum, la latencia de confirmación y la de extremo a extremo casi coinciden: el mensaje llega al consumidor en cuanto la escritura se completa, y la escritura incluye el fsync. Los picos del p99, entre 22,8 y 54,2 ms según la ejecución, encajan con el coste de ese volcado en un disco virtual, aunque no lo aislé. Stream PerfTest redondea la latencia a milisegundos enteros, así que su fila solo dice que el protocolo de streams se mantuvo en 1 o 2 ms con lotes de 100 mensajes.
Cuánto disco y memoria ocupa un millón de mensajes
Un millón de mensajes de 1000 bytes ocupó un tamaño parecido en disco en los dos tipos, pero la memoria fue otra historia. Publiqué el millón sin consumidores con PerfTest y medí el directorio de datos con du, la memoria de cada cola con rabbitmqctl list_queues y el reparto del nodo con rabbitmq-diagnostics memory_breakdown:
| Con 1 000 000 mensajes de 1000 bytes | Cola quorum | Stream |
|---|---|---|
| Disco tras publicar | 1,24 GB | 1,11 GB |
| Memoria del proceso de la cola | 20,5 MB | 9 KB |
Tablas del registro en memoria (quorum_ets) |
130 MB | No aplica |
| Disco tras consumirlo todo | 272 MB, solo el WAL | 1,11 GB, intacto |
| Mensajes para un segundo consumidor | 0 | 1 000 000 |
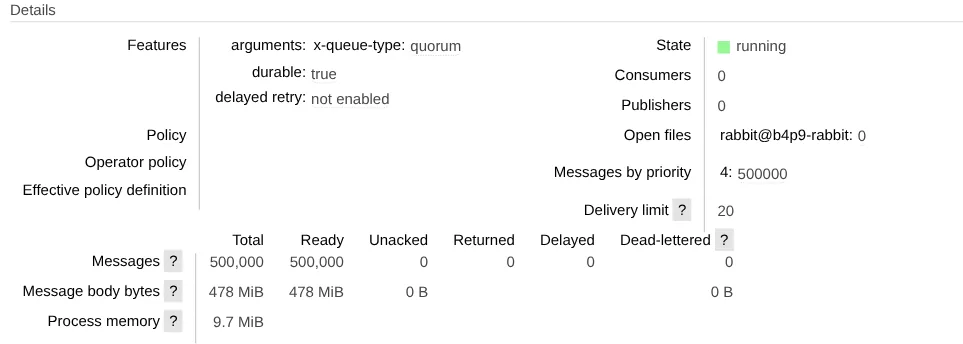
La documentación de colas quorum calcula al menos 32 bytes de metadatos en memoria por mensaje, lo que daría 32 MB o más para un millón. Medí 20,5 MB, unos 20,5 bytes por mensaje, en línea con las referencias compactas que las notas de 4.3.0 describen como "halving per-message memory overhead in many scenarios". La interfaz de gestión da la misma proporción con medio millón de mensajes: 9,7 MiB de memoria de proceso. La misma página muestra la prioridad 4 que la cola asigna por defecto y el límite de 20 entregas.
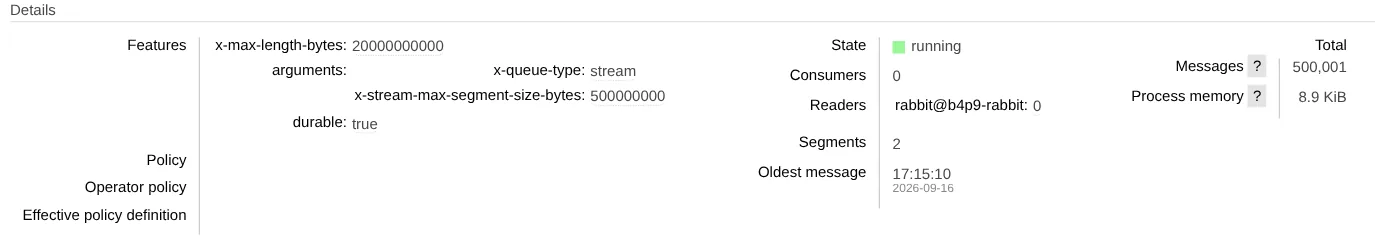
El stream, con 500 001 mensajes, se queda en 8,9 KiB de memoria de proceso. Según su guía, guarda todo en disco y solo retiene en memoria lo que aún no ha escrito. La página muestra también el número de segmentos y la fecha del mensaje más antiguo, un dato que la interfaz añadió en la 4.3.2:
Un mensaje sin confirmar ya no retiene el disco
La compactación nueva de la 4.3 se nota cuando un consumidor se queda un mensaje sin confirmar. Lo probé en dos nodos limpios, uno con 4.3.6 y otro con 4.2.9. Un consumidor de PerfTest con prefetch 1 y 900 s de latencia simulada (-q 1 -L 900000000) retiene el primer mensaje. Otro consumidor vacía los 999 999 restantes, y mido el directorio de la cola durante los 4 minutos siguientes:
| Con un mensaje sin confirmar | RabbitMQ 4.2.9 | RabbitMQ 4.3.6 |
|---|---|---|
| Segmentos tras vaciar la cola | 194 ficheros, 1,02 GB | 8,9 MB fuera del WAL |
| Directorio completo, WAL incluido | 1,35 GB | 398 MB |
| Cambio a los 4 minutos | Ninguno | Ninguno |
En la 4.2.9, los 194 segmentos siguieron en disco incluso después de desconectar al consumidor retenedor. El mensaje volvió a la cola, y esa versión no trunca el registro por detrás del mensaje vivo más antiguo. En la 4.3.6, la primera medida tras vaciar la cola ya daba 8,9 MB fuera del WAL. El WAL, compartido por todas las colas quorum del nodo, no se libera así: se recicla al llegar a su tamaño máximo, 512 MiB por defecto.
Releer mensajes: lo que una cola quorum no puede hacer
Un stream conserva los mensajes después de leerlos, y el millón de la prueba siguió disponible durante nueve lecturas completas. Un consumidor nuevo empieza por el principio con el argumento x-stream-offset en first, que PerfTest expone así:
docker run --rm --network bench-net pivotalrabbitmq/perf-test:2.25.0 \
  --uri amqp://guest:guest@bench-rabbit -x 0 -y 1 \
  --stream-queue --queue eventos -sco first -D 1000000
En tres lecturas por AMQP 0-9-1, la mediana fue de 69 773 msg/s, unos 15 s por lectura contando el arranque del contenedor. Con Stream PerfTest y --offset first, la mediana de otras tres fue de 464 683 msg/s, 3,3 s por lectura con la JVM incluida. La carga estuvo entre 0,98 y 2,93. Cada lectura terminó al recibir el millón, y tras las tres primeras el directorio del stream seguía en 1,11 GB.
En la cola quorum, en cambio, un segundo consumidor conectado 10 s después de vaciarla no recibió ningún mensaje. En el stream, rabbitmqctl contó 1 000 002 mensajes para 1 000 000 publicados; la guía de streams avisa de que ese contador puede superar un poco al real.
Qué ofrece cada tipo de cola en RabbitMQ 4.3
Las funciones de cada tipo, según la documentación de la versión 4.3, separan los casos de uso con más claridad que los números:
| Característica | Cola quorum | Stream |
|---|---|---|
| Lectura | Destructiva: la confirmación borra | No destructiva, por offset |
| Releer mensajes | No | Desde el inicio, un offset o una fecha |
| fsync antes de confirmar | Sí | No, lo decide el sistema operativo |
| Dead lettering | Sí, también at-least-once | No |
| TTL y límite de longitud | Sí | No, retención por tamaño o edad |
| Prioridades | Estrictas, 32 niveles | No |
| Reintento con espera y timeout | Sí, desde 4.3 | No |
| Límite de entregas (mensajes venenosos) | Sí | No |
| Deduplicación al publicar | No | Sí, con el protocolo de streams |
| Cambios de réplicas | Semiautomáticos | Manuales, con rabbitmq-streams |
La retención de un stream se evalúa por segmentos, de 500 MB por defecto, y siempre queda al menos uno con mensajes. Un stream sin x-max-length-bytes ni x-max-age no borra nada y crece hasta llenar el disco, así que fija la retención al declararlo.
Cuándo elegir un stream y cuándo una cola quorum
Elige la cola quorum para trabajo que se reparte y se confirma una vez, y el stream cuando dos o más lectores necesitan los mismos mensajes o cuando vas a releerlos. En la práctica:
- Cola quorum: pedidos, pagos y tareas con reintentos, donde un mensaje que falla debe volver a la cola o acabar en una cola de mensajes muertos.
- Stream: auditoría, reproceso de eventos, fan-outs grandes y backlogs de millones de mensajes.
- Stream leído por AMQP 0-9-1: sirve para lectores lentos o para empezar sin cambiar de biblioteca, pero en esta prueba el consumidor no pasó de 62 360 msg/s; para ritmos mayores, usa un cliente del protocolo de streams.
- Kafka o Redpanda: cuando necesitas particiones gestionadas, conectores y un ecosistema de streaming; lo cuentan Kafka sin ZooKeeper en producción y la comparativa de Redpanda con Kafka.
Si todavía estás decidiendo si RabbitMQ es el broker adecuado, empieza por cuándo RabbitMQ sigue siendo la opción para colas de mensajes, y para el diseño general, por la arquitectura orientada a eventos.
Preguntas frecuentes
¿Puedo convertir una cola quorum en un stream con una política?
No. El tipo se fija con x-queue-type al declarar la cola y ninguna política lo cambia. Para pasar de una a otro hay que crear el stream, mover los productores y vaciar la cola antigua.
¿Necesito el plugin de streams para usar un stream?
No. Cualquier cliente AMQP 0-9-1 que permita argumentos de cola y de consumidor puede declarar y leer un stream, con un prefetch definido. El plugin añade el puerto 5552, la deduplicación, los super streams, el consumidor activo único y el seguimiento de offsets en el servidor.
¿Un stream de RabbitMQ sustituye a Kafka?
Para un fan-out o un registro de eventos dentro del broker que ya operas, puede bastar. Kafka sigue teniendo más herramientas alrededor del registro, como conectores y procesamiento de flujos, y RabbitMQ recomienda los super streams solo cuando un stream individual se queda corto.
Conclusión
En RabbitMQ 4.3.6, la cola quorum y el stream resuelven trabajos distintos. La cola quorum movió 45 156 msg/s con fsync en cada confirmación, prioridades, reintentos y dead lettering, y la 4.3 por fin libera su disco aunque quede un mensaje colgado. El stream movió 281 330 msg/s por su protocolo con 4 GiB de memoria y 517 072 con 16 GiB. Además guardó un millón de mensajes releíbles con 9 KB de memoria de proceso.
Antes de decidir, repite estas pruebas con tu tamaño de mensaje y en tu disco. Aquí el techo del stream lo puso el límite de memoria del contenedor, sobre un disco virtual. Un clúster de tres nodos añade además el coste de replicar, que no medí. Para vigilar después la profundidad de las colas y la memoria del nodo, el plugin rabbitmq_prometheus de este montaje se integra con Prometheus en Docker.
Fuentes
- guía de streams de RabbitMQ
- documentación de colas quorum
- página de versiones de RabbitMQ
- notas de RabbitMQ 4.3.0
- notas de la 4.3.6
- guía de memoria de RabbitMQ
- PerfTest
- Stream PerfTest
- presentación de los streams en el blog de RabbitMQ
- tabla comparativa del protocolo de streams
- Versión 2.25.0 de PerfTest
- Versión 1.8.0 de Stream PerfTest
Código fuente
Accede a todo el código fuente de este artículo en GitHub.
Ver en GitHub