pgvector: búsqueda semántica sin salir de Postgres
Índice de contenidos
- Puntos clave
- Por qué la búsqueda semántica necesita un tipo de índice distinto
- Cuándo pgvector es la decisión correcta
- Del CREATE EXTENSION a un índice que rinde
- Tres detalles operativos que marcan la diferencia
- Señales de que has superado pgvector
- Conclusión
- Preguntas frecuentes
- ¿Qué valores de lists y probes uso en un índice IVFFlat de pgvector?
- ¿Puedo combinar un filtro WHERE con el ranking por similitud en pgvector?
- ¿Cuándo compensa pasar de pgvector a Qdrant o Pinecone?
- ¿Uso HNSW o IVFFlat en pgvector?
- Fuentes
Probado con PostgreSQL 18.6 · pgvector 0.8.6 · Docker · verificado
Actualizado: 2026-09-16
La búsqueda semántica (recuperar documentos por significado y no por coincidencia de palabras) se ha convertido en el cimiento silencioso de buena parte del boom de aplicaciones LLM. Detrás de cada sistema RAG, de cada asistente que consulta documentación interna, de cada buscador "inteligente", hay la misma mecánica. Un modelo convierte texto en un vector de cientos o miles de dimensiones, y la aplicación busca vectores cercanos a la consulta.
Lo interesante es que para montar esa mecánica no hace falta introducir una base de datos nueva en el stack si ya tienes PostgreSQL. pgvector[1] convierte un PostgreSQL ya existente en una base vectorial perfectamente competente. Este texto está revisado el 16 de septiembre de 2026 para pgvector 0.8.6 y PostgreSQL 18.6, con cifras medidas sobre 99.000 embeddings reales. Para instalarlo, sigue la guía paso a paso de PostgreSQL con pgvector.
Puntos clave
-
pgvector extiende PostgreSQL con el tipo
vector(y, desde la 0.7.0, conhalfvec,sparsevecy el indexado debit) y con operadores de distancia coseno, euclídea, producto interior y L1. -
Tiene dos índices aproximados (ANN): HNSW, un grafo por capas con mejor relación entre recall y latencia, e IVFFlat, que agrupa los vectores con k-means y tarda menos en construirse.
-
Con 99.000 embeddings de 1536 dimensiones, HNSW con sus valores por defecto dio un recall@10 del 95,1 % con 1,15 ms de mediana; la búsqueda exacta tardó 158,9 ms.
-
Con un índice aproximado, el
WHEREse aplica después de recorrer el índice: una condición selectiva devuelve menos filas de las pedidas si no activas los recorridos iterativos de la 0.8.0. -
El índice HNSW de esa prueba ocupa 773 MB, unos 7,6 GB por millón de vectores. Cuando deja de caber en RAM, prueba
halfveco la cuantización binaria antes de cambiar de base de datos.
Por qué la búsqueda semántica necesita un tipo de índice distinto
Un embedding moderno (pensemos en los 1536 valores que produce por defecto text-embedding-3-small de OpenAI) vive en un espacio de alta dimensionalidad. Encontrar el vector más parecido a otro es, matemáticamente, calcular una distancia (coseno, euclídea o producto interior) contra cada vector almacenado. En la prueba de este artículo, esa búsqueda exacta sobre 99.000 documentos tardó 158,9 ms de mediana. Con diez millones, la cuenta lineal ronda los 16 s, y el usuario ya se ha marchado.
Los índices B-tree clásicos de Postgres, pensados para ordenar escalares, no sirven para vectores. Un B-tree necesita un orden total; en un espacio de 1536 dimensiones ese orden simplemente no existe. La solución práctica de la industria ha sido renunciar a la exactitud y aceptar búsqueda aproximada, ANN (approximate nearest neighbor). En la misma prueba, HNSW respondió en 1,15 ms de mediana, unas 138 veces menos que la búsqueda exacta, a cambio de perder 4,9 puntos de recall@10.
pgvector implementa esta idea con dos tipos de índice. HNSW construye un grafo jerárquico por capas y, según la documentación del proyecto, ofrece mejor relación entre velocidad y recall que IVFFlat, a cambio de construirse más despacio y ocupar más memoria. IVFFlat particiona la tabla en listas con k-means al crear el índice, y cada búsqueda compara la consulta solo con los vectores de las listas más cercanas. Los parámetros hnsw.ef_search (40 por defecto) e ivfflat.probes (1 por defecto) se ajustan por consulta: subirlos mejora el recall y aumenta la latencia.
Cuándo pgvector es la decisión correcta
La pregunta honesta no es "¿es pgvector lo mejor?" sino "¿qué gana mi proyecto usando Qdrant, Pinecone o Milvus en lugar de extender el Postgres que ya tiene?". La respuesta suele ser: menos de lo que parece.
Ya tienes backups, monitorización, replicación y una política de acceso funcionando sobre Postgres. Añadir un servicio vectorial separado duplica esa superficie: otro proceso que parchear, otro backup que probar, otra ventana de mantenimiento que coordinar.
Hay además una ventaja arquitectónica que se infravalora sistemáticamente. En una base vectorial dedicada, los metadatos (autor, categoría, fecha, permisos) viven en otra parte del sistema. Cualquier filtro complejo requiere coordinar dos stores.
Con pgvector, WHERE category = 'tech' AND user_id = 42 y el ranking vectorial viven en la misma query y el planificador de Postgres decide cómo ejecutarlos juntos. Ese único hecho elimina una capa entera de código pegamento.
Aun así, pgvector no es la respuesta universal. El tipo vector guarda hasta 16.000 dimensiones, pero sus índices solo llegan a 2.000. Como text-embedding-3-large devuelve 3072 por defecto, tendrías que indexarlo como halfvec (hasta 4.000), con cuantización binaria o pidiendo menos dimensiones al modelo.
El otro límite es la memoria, porque un índice que no cabe en RAM obliga a leer de disco en cada consulta. Para chatbots internos, asistentes de documentación y buscadores de soporte, con decenas o cientos de miles de fragmentos, esos límites quedan lejos.
Del CREATE EXTENSION a un índice que rinde
Empezar pide tres sentencias, y el índice conviene crearlo después de la carga inicial:
CREATE EXTENSION IF NOT EXISTS vector;

CREATE TABLE documents (
    id        bigserial PRIMARY KEY,
    content   text,
    category  text,
    embedding vector(1536)  -- text-embedding-3-small
);

-- Después de la carga inicial
CREATE INDEX CONCURRENTLY documents_embedding_idx
    ON documents USING hnsw (embedding vector_cosine_ops);

-- Alternativa IVFFlat para un millón de filas: lists = filas / 1000
-- CREATE INDEX CONCURRENTLY documents_embedding_ivf
--     ON documents USING ivfflat (embedding vector_cosine_ops)
--     WITH (lists = 1000);
HNSW puede crearse con la tabla vacía porque no tiene fase de entrenamiento, pero la documentación de pgvector recomienda crear cualquier índice después de cargar los datos, porque tarda menos. IVFFlat sí necesita datos: calcula sus listas con los vectores que encuentra al construirse. CONCURRENTLY evita bloquear las escrituras mientras tanto.
La consulta combina el filtro relacional con el orden por distancia. $1 es el embedding de la pregunta, que tu aplicación pasa como parámetro:
SET hnsw.ef_search = 100;
SET hnsw.iterative_scan = strict_order;

SELECT id, content, 1 - (embedding <=> $1::vector) AS score
FROM documents
WHERE category = 'tech'
ORDER BY embedding <=> $1::vector
LIMIT 5;
La ejecuté tal cual, con PREPARE, sobre 20.000 filas reales repartidas en cinco categorías, y devolvió las 5 filas pedidas. Con el índice forzado, los recorridos iterativos desactivados y hnsw.ef_search = 10, la misma consulta devolvió solo 2. La sección siguiente explica por qué.
Los operadores de distancia de pgvector 0.8.6 son estos:
-
<=>: distancia coseno, la habitual en búsqueda semántica -
<->: distancia euclídea (L2) -
<#>: producto interior con el signo cambiado -
<+>: distancia L1, desde la 0.7.0 -
<~>y<%>: distancias Hamming y Jaccard para vectores binarios (bit)
La similitud coseno se obtiene como 1 - (a <=> b): vale 1 cuando los vectores apuntan en la misma dirección y 0 cuando son ortogonales. OpenAI normaliza sus embeddings a longitud 1, así que coseno, producto interior y distancia euclídea los ordenan igual. Por eso la documentación de pgvector recomienda <#> para la búsqueda exacta, que ahorra cálculo. Si usas índice, créalo con la clase de operadores de la distancia que consultes (vector_ip_ops para <#>).
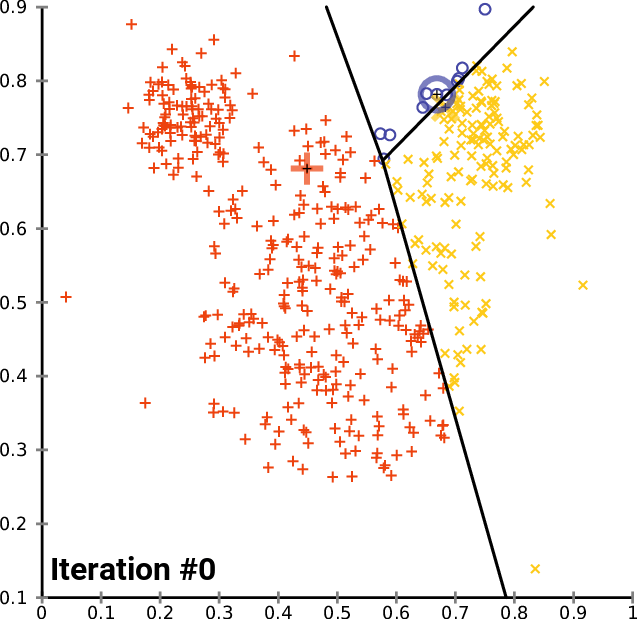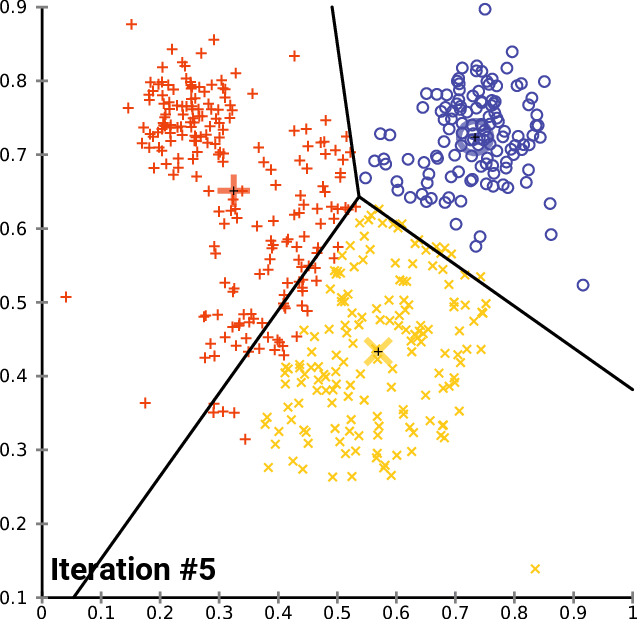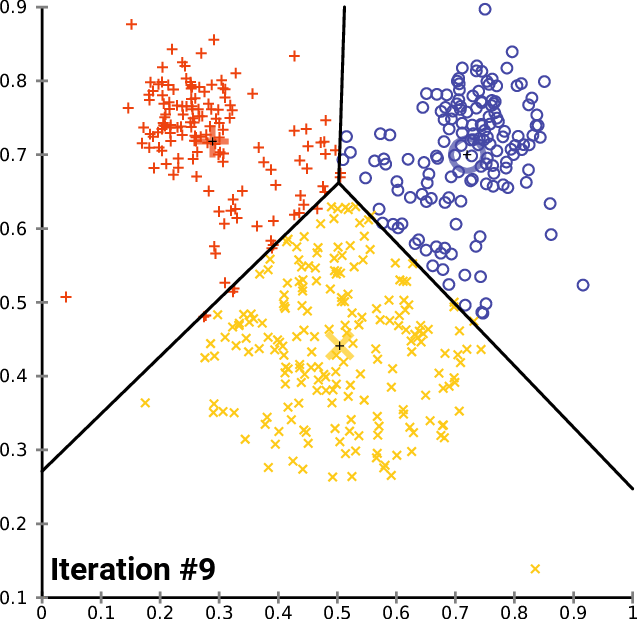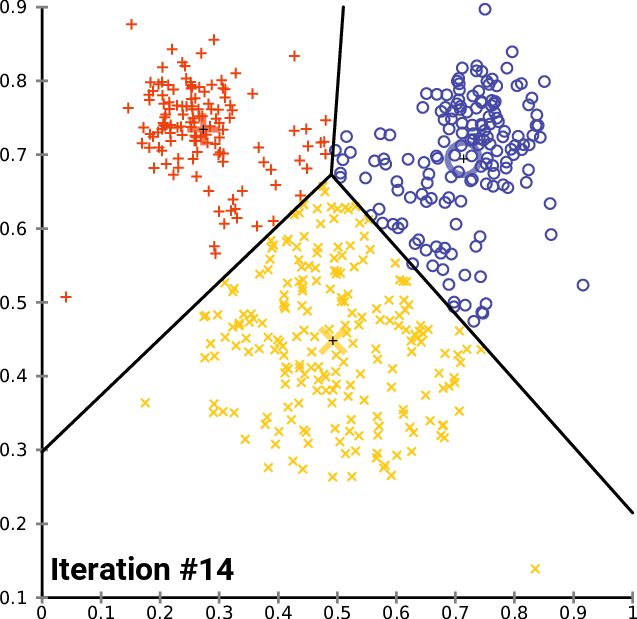 Animación de convergencia de k-means, el algoritmo que IVFFlat usa para particionar los vectores en listas durante la construcción del índice (Imagen: Chire, CC BY-SA 4.0, vía Wikimedia Commons)
Tres detalles operativos que marcan la diferencia
-
Construir el índice con
CREATE INDEX CONCURRENTLYpara no bloquear las escrituras durante la operación, como recomienda la documentación de pgvector para producción. Si PostgreSQL corre en Docker y la construcción es paralela, da al contenedor un--shm-sizeal menos igual amaintenance_work_mem. Con los 64 MB por defecto, mi construcción HNSW paralela falló conNo space left on device. -
Medir el recall en lugar de reindexar por calendario: IVFFlat fija sus listas al construirse, y si los vectores nuevos se alejan de la distribución original, el recall cae. Compara de vez en cuando los resultados del índice con los de la búsqueda exacta (
SET LOCAL enable_indexscan = offdentro de una transacción) y reconstruye conREINDEX INDEX CONCURRENTLYcuando baje. Con HNSW, usa al menos la 0.8.4: la 0.8.3 y la 0.8.4 corrigieron una posible corrupción del índice y el error «hnsw graph not repaired» durante elVACUUM. -
Tratar los filtros como lo que son: con un índice aproximado, PostgreSQL recorre el índice y filtra después. En una prueba con 20.000 filas, un filtro que dejaba pasar el 10 % de las filas y
hnsw.ef_search = 40devolvió 4 filas de las 10 pedidas; conhnsw.iterative_scan = relaxed_orderdevolvió las 10. Sin forzar el índice, el planificador de la 0.8.6 prefirió allí un recorrido secuencial exacto, y la 0.8.0 ya había mejorado esa estimación de costes. Si el filtro deja pocas filas, añade un índice B-tree sobre la columna para que la búsqueda exacta del subconjunto no recorra la tabla entera.
Para IVFFlat, la documentación de pgvector propone lists = filas / 1000 hasta un millón de filas, sqrt(filas) por encima, y empezar con probes = sqrt(lists). Lo medí con 99.000 embeddings de text-embedding-3-small del conjunto DBpedia que Qdrant publica en Hugging Face[2], 1.000 consultas reservadas del mismo conjunto y el top-10 exacto como referencia:
| Índice y ajuste | Recall@10 | Latencia p50 | Latencia p95 |
|---|---|---|---|
| IVFFlat, lists = 100, probes = 1 | 62,1 % | 1,05 ms | 1,64 ms |
| IVFFlat, lists = 100, probes = 3 | 80,9 % | 2,48 ms | 3,53 ms |
| IVFFlat, lists = 100, probes = 10 | 92,8 % | 8,70 ms | 12,47 ms |
| IVFFlat, lists = 100, probes = 20 | 96,8 % | 14,89 ms | 20,36 ms |
| HNSW por defecto, ef_search = 40 | 95,1 % | 1,15 ms | 1,58 ms |
| HNSW, ef_search = 100 | 98,3 % | 2,20 ms | 2,92 ms |
| HNSW, ef_search = 200 | 99,2 % | 3,74 ms | 5,13 ms |
| Búsqueda exacta (50 consultas) | 100 % | 158,85 ms | 180,63 ms |
Las cifras salen de PostgreSQL 18.6 con pgvector 0.8.6 en la imagen pgvector/pgvector:0.8.6-pg18-trixie. La máquina, arm64 y de 18 núcleos, estaba compartida con otros procesos, con una carga media de entre 3,5 y 6,6 durante la medición. Para aislar cada índice forcé su uso con enable_seqscan = off, porque con ef_search = 100 el planificador eligió la búsqueda exacta para la consulta de muestra. Construir el índice HNSW tardó 23,0 s con cuatro procesos paralelos, y el IVFFlat, 4,3 s; los dos ocupan unos 773 MB.
La conclusión práctica es que HNSW con sus valores por defecto ya supera a IVFFlat con 10 sondas en recall y en latencia. IVFFlat compensa cuando manda el tiempo de construcción, y aun así probes = sqrt(lists) (10 sondas para 100 listas) se quedó en el 92,8 %.
Señales de que has superado pgvector
Hay síntomas claros de que el proyecto ha crecido más allá de lo que la extensión cubre cómodamente:
-
Latencia p95 sostenida por encima de 100 ms con los parámetros bien ajustados.
-
Índices que ya no caben en RAM y obligan a leer de disco en cada consulta.
-
Ya usas
halfveco cuantización binaria con re-ranking (las dos existen desde la 0.7.0) y el índice sigue sin caber en memoria.
Antes de migrar, la documentación de pgvector propone escalar en vertical, añadir réplicas de lectura o repartir los datos con Citus. Si nada de eso alcanza, migrar a Qdrant suele ser la opción pragmática: mantiene la propiedad de poder autoalojarlo y escala mucho mejor. Pero llegar hasta ahí es una señal de éxito, no un fracaso arquitectónico: significa que el proyecto funciona lo bastante bien como para tensar la infraestructura.
Si usas LangChain o Chroma para el pipeline RAG, la migración de retriever desde pgvector a Qdrant es un cambio de pocas líneas, siempre que hayas respetado la abstracción del retriever desde el principio.
Conclusión
pgvector no es el eslabón más rápido del mercado ni pretende serlo. Es la pieza que permite añadir búsqueda semántica a un producto existente sin multiplicar la superficie operativa, reutilizando el Postgres que tu equipo ya sabe operar, backupear y auditar. Con RAG convertido en patrón por defecto, esa combinación de pragmatismo e ingeniería conservadora es lo que separa los prototipos que llegan a producción de los que se quedan en demo.
Preguntas frecuentes
¿Qué valores de lists y probes uso en un índice IVFFlat de pgvector?
Empieza por lo que propone la documentación de pgvector: lists igual a filas / 1000 hasta un millón de filas y a la raíz cuadrada de las filas por encima. Para ivfflat.probes, parte de la raíz cuadrada de lists. Con 99.000 embeddings de 1536 dimensiones y 100 listas, 10 sondas dieron un recall@10 del 92,8 % y 20 sondas, del 96,8 %, con 8,7 y 14,9 ms de mediana. Crea el índice después de cargar datos representativos, porque las listas se calculan en ese momento, y usa CREATE INDEX CONCURRENTLY si la tabla recibe escrituras.
¿Puedo combinar un filtro WHERE con el ranking por similitud en pgvector?
Sí, en la misma consulta SQL, con un matiz: con un índice aproximado, PostgreSQL filtra después de recorrer el índice. Con un filtro que dejaba pasar el 10 % de las filas y hnsw.ef_search = 40, la consulta devolvió 4 filas de las 10 pedidas. Desde la 0.8.0, hnsw.iterative_scan (strict_order o relaxed_order) e ivfflat.iterative_scan = relaxed_order siguen explorando hasta reunir las filas, y con relaxed_order devolvió las 10. Para filtros que dejan pocas filas, un índice B-tree en la columna permite una búsqueda exacta sobre ese subconjunto.
¿Cuándo compensa pasar de pgvector a Qdrant o Pinecone?
Cuando lo dicen señales medibles: latencia p95 por encima de 100 ms con los parámetros ajustados, índices que no caben en RAM o memoria que no alcanza ni con halfvec y cuantización binaria. Como referencia, el índice HNSW de 99.000 vectores de 1536 dimensiones ocupó 773 MB, unos 7,6 GB por millón. Antes de migrar, prueba a escalar en vertical, añadir réplicas o repartir con Citus. Si no alcanza, Qdrant suele ser el paso pragmático, y con LangChain el cambio de retriever ocupa pocas líneas.
¿Uso HNSW o IVFFlat en pgvector?
Empieza con HNSW y sus valores por defecto (m = 16, ef_construction = 64). En la prueba de este artículo dio un 95,1 % de recall@10 con 1,15 ms de mediana. IVFFlat, con 100 listas y 10 sondas, se quedó en el 92,8 % y 8,7 ms. IVFFlat tarda menos en construirse (4,3 s frente a 23,0 s con cuatro procesos paralelos) y necesita datos para crearse, así que tiene sentido cuando la ventana de mantenimiento es corta.