Aplicar el libro de SRE de Google sin ser Google

Índice de contenidos
- Puntos clave
- Los principios que sí se trasladan
- Dónde hay que adaptar
- Error budget policy estricta
- Roles dedicados
- Escala de herramientas
- Capacity planning formal
- Un roadmap realista para empezar
- Fase 1 (1–2 meses): SLOs básicos + postmortem
- Fase 2 (3–6 meses): Toil reduction + on-call structure
- Fase 3 (6–12 meses): Alerting maduro + cultura
- El papel del libro en formación del equipo
- Conclusión
- Preguntas frecuentes
- ¿Cómo aplico el error budget en un equipo pequeño sin parar todos los despliegues?
- ¿Necesito un equipo SRE separado del de desarrollo para aplicar el libro?
- ¿Qué capítulos del libro de SRE merecen leerse fuera de Google?
- Fuentes
El libro de SRE de Google[1], publicado en 2016, se ha convertido en la referencia de facto para ingeniería de fiabilidad. Pero está escrito para Google: miles de ingenieros, datacenters propios, herramientas internas. Aplicarlo en un equipo de 10 personas con todo en AWS produce fricción, a veces frustración. La buena noticia es que el 80 % del valor viene de principios portables, no de infraestructura específica.
Puntos clave
-
Cinco principios del libro se trasladan a casi cualquier contexto: SLO, error budget, postmortem sin culpa, toil management y on-call humano.
-
Las áreas que no escalan: error budget policy binaria, roles dedicados, herramientas internas y capacity planning formal.
-
Un roadmap práctico en tres fases cubre el 80 % del valor en 6–12 meses.
-
Los capítulos más relevantes fuera de Google son 3, 4, 5, 11, 13, 15, 16 y 17.
-
El SRE Workbook complementa el libro con ejercicios más accesibles para equipos pequeños.
Los principios que sí se trasladan
Cinco ideas del libro que funcionan en casi cualquier contexto:
-
SLO como contrato con el usuario. Define objetivos de nivel de servicio medibles (99,9 % de peticiones exitosas, latencia p95 < 500 ms). Es la diferencia entre "el sistema va bien" y "el sistema cumple la promesa hecha al cliente".
-
Error budget como permiso a correr riesgos. Si tu SLO es 99,9 % y llevas el mes al 99,95 %, tienes budget para probar cambios. Si estás rozando 99,9 %, para de desplegar y estabiliza. Es un mecanismo de diálogo entre producto y operaciones.
-
Postmortem sin culpa. Tras un incidente, analiza qué falló en procesos y sistemas, no en personas. Esta cultura se construye con prácticas explícitas (plantilla compartida, reunión sin juicio), rara vez con buenas intenciones sueltas. Detallamos el proceso completo en nuestra guía de postmortems sin culpa.
-
Toil management. Toil = trabajo manual repetitivo, automatizable, sin valor duradero. El libro propone un límite: < 50 % del tiempo del equipo. Medirlo y atacarlo sistemáticamente es quizás el cambio cultural más valioso.
-
On-call humano. Rotaciones razonables (no más de 1 semana cada 6), compensación explícita, post-incidente calm-down. Es un derecho laboral, no un ritual de paso.
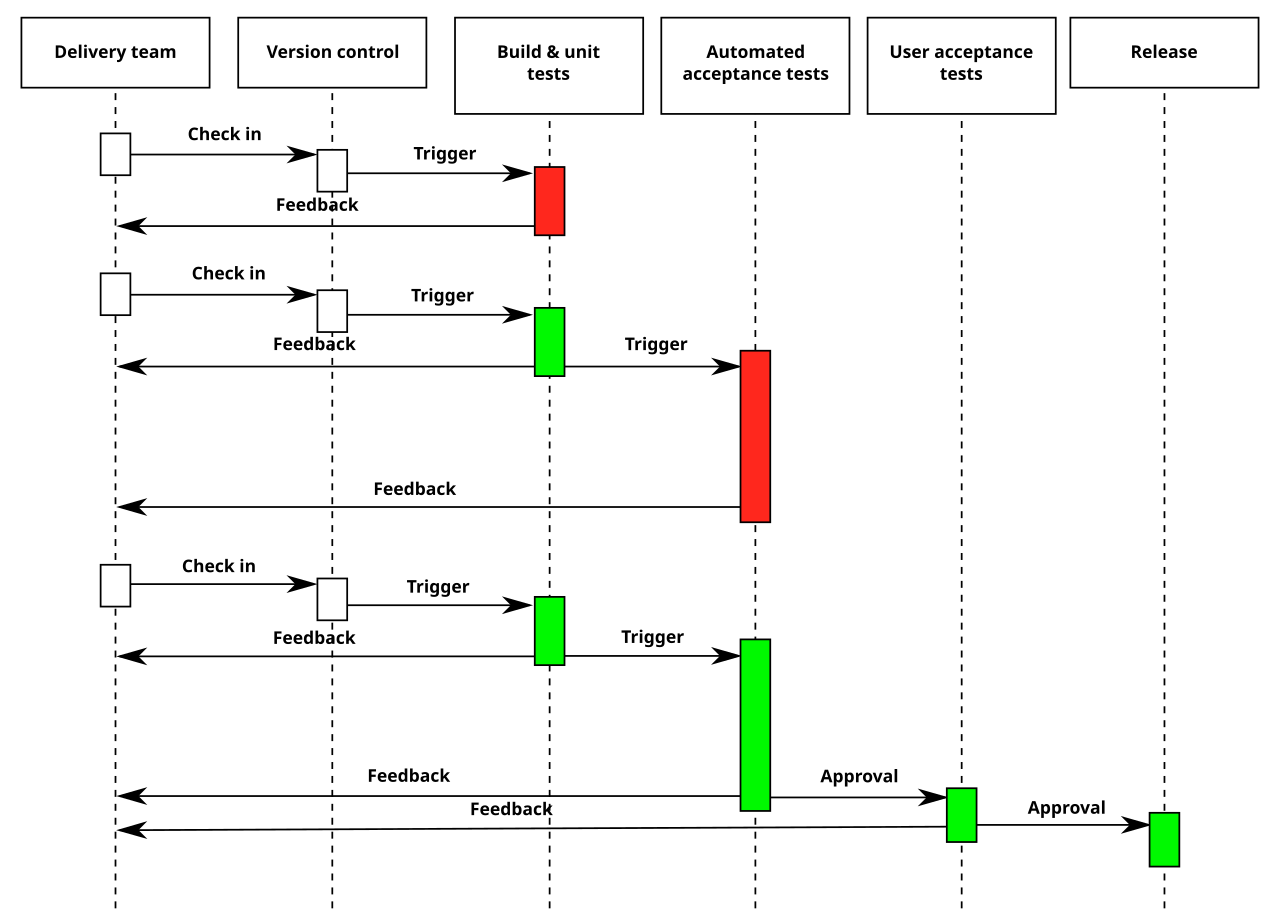 Diagrama de entrega continua, proceso core en equipos SRE que practican despliegue frecuente y error budgets (Imagen: Grégoire Détrez, original by Jez Humble, CC BY-SA 4.0, vía Wikimedia Commons)
Dónde hay que adaptar
Las áreas donde la literalidad del libro choca con equipos pequeños:
Error budget policy estricta
En Google, si agotas el budget, se para todo despliegue de features y solo hay releases de fiabilidad hasta recuperar. En un equipo de 10 personas esto puede ser demasiado binario. Una política más práctica:
-
A 50 % de budget gastado: aumenta el rigor de revisión.
-
A 80 %: bloqueo de features grandes.
-
A 100 %: solo bugfixes críticos.
Roles dedicados
Google tiene equipos dedicados a SRE separados de los equipos de desarrollo. En equipos pequeños, ambos son la misma gente. Los principios funcionan igualmente bien con un equipo mixto que tenga roles explícitos y rotaciones, sin necesidad de separar grupos humanos.
Escala de herramientas
Borgmon, Monarch y Dapper, las herramientas internas de Google, tienen equivalentes open-source decentes (Prometheus[2], OpenTelemetry[3], Grafana[4]), pero la madurez y la ergonomía no son equivalentes. Adaptar ideas sin intentar clonar herramientas ahorra frustración.
Capacity planning formal
El libro dedica capítulos a capacity planning proactivo en decenas de centros de datos. En AWS con autoscaling y serverless, la mayor parte del problema lo resuelve el proveedor. Leer esos capítulos ayuda a entender el fenómeno; no es necesario aplicarlos tal cual.
Un roadmap realista para empezar
Tres fases que funcionan en equipos de 5–30 personas:
Fase 1 (1–2 meses): SLOs básicos + postmortem
Elige 2–3 servicios críticos. Define un SLO simple por servicio (disponibilidad + latencia). Dashboards en Grafana que muestren el burn rate del error budget.
Introduce plantilla de postmortem blameless. Tras el primer incidente con ese proceso, revisa cómo fue.
Fase 2 (3–6 meses): Toil reduction + on-call structure
Mide el toil (preguntas en Slack, manuales de despliegue, copiar-pegar entre paneles). Ataca los tres más grandes con automatización, no todos, solo los que doblen el retorno. Formaliza rotación de on-call con compensación y reglas.
Fase 3 (6–12 meses): Alerting maduro + cultura
Revisa todas las alertas aplicando los principios de alerta orientada al síntoma; nuestra guía de routing de Alertmanager detalla cómo evitar el ruido de las 3 de la madrugada. Integra postmortems como documentos vivos, no PDFs enterrados. Usa las retros del on-call para mejorar documentación y runbooks. El cumplimiento de NIS2 descrito en la directiva NIS2 exige exactamente este nivel de documentación de incidentes: el proceso SRE lo cubre de forma natural.
El papel del libro en formación del equipo
Una práctica común: lectura compartida del libro en book clubs de 1–2 capítulos por semana. Los capítulos que más valor dan fuera de Google:
-
Capítulos 3 (Embracing Risk), 4 (Service Level Objectives), 5 (Eliminating Toil).
-
Capítulo 11 (Being On-Call), 13 (Emergency Response), 15 (Postmortem Culture).
-
Capítulos 16 (Tracking Outages), 17 (Testing for Reliability).
Los capítulos 18–20 (Cluster Management, Storage, Network) son interesantes académicamente pero poco aplicables sin ejército de infraestructura propio.
Complementario al libro: el Workbook de SRE[5] tiene ejercicios prácticos, más accesibles para equipos pequeños. Para el diseño de SLOs y error budgets en concreto, revisa nuestra guía de observabilidad y SLOs que se cumplen de verdad.
Conclusión
SRE como disciplina aporta principios sólidos: mide, define contratos con el usuario, analiza fallos sin culpar, automatiza lo repetitivo, trata al on-call con respeto. Esos principios funcionan en cualquier equipo. Lo que no se traslada es la infraestructura de Google, y eso está bien, porque no hace falta. Adapta ideas, no implementaciones.
Este artículo también está disponible en inglés: Applying Google’s SRE Book Without Being Google.
Preguntas frecuentes
¿Cómo aplico el error budget en un equipo pequeño sin parar todos los despliegues?
Sustituye la política binaria de Google por una gradual: al 50 % del budget gastado aumenta el rigor de revisión, al 80 % bloquea las features grandes y al 100 % permite solo bugfixes críticos. En Google agotar el budget detiene todo despliegue de features hasta recuperar, pero en un equipo de 10 personas eso resulta demasiado binario. El error budget sigue siendo un mecanismo de diálogo entre producto y operaciones.
¿Necesito un equipo SRE separado del de desarrollo para aplicar el libro?
No. Google tiene equipos SRE dedicados separados de desarrollo, pero en equipos pequeños son la misma gente y los principios funcionan igual con un equipo mixto que tenga roles explícitos y rotaciones. El on-call debe ser humano: rotaciones de no más de una semana cada seis, compensación explícita y calm-down tras el incidente. El toil debería quedar por debajo del 50 % del tiempo del equipo.
¿Qué capítulos del libro de SRE merecen leerse fuera de Google?
Los capítulos 3 (Embracing Risk), 4 (Service Level Objectives), 5 (Eliminating Toil), 11 (Being On-Call), 13 (Emergency Response), 15 (Postmortem Culture), 16 (Tracking Outages) y 17 (Testing for Reliability). Los capítulos 18 a 20 sobre cluster management, storage y network son interesantes académicamente pero poco aplicables sin infraestructura propia. Un book club de 1–2 capítulos por semana funciona bien, y el SRE Workbook añade ejercicios más accesibles para equipos pequeños.