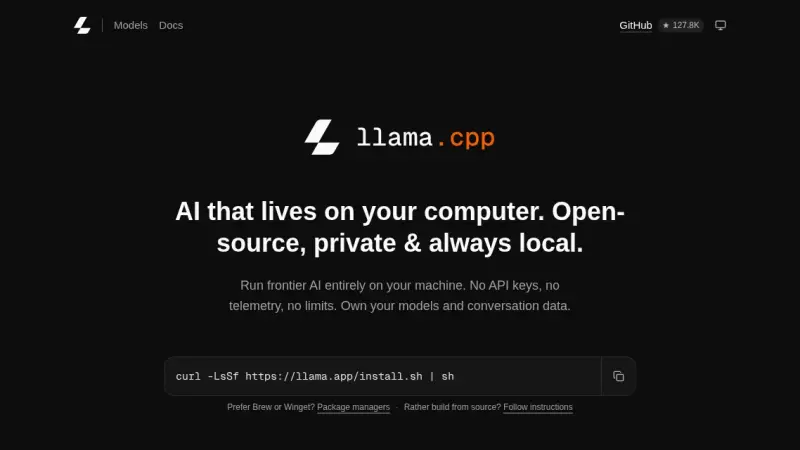
Para instalar llama.cpp tienes cuatro vías: el script de llama.app, que deja un binario llama de 15 MB en ~/.local/bin; Homebrew; la imagen Docker server-v0.4.1; o CMake. Las probé el 14 de septiembre de 2026 en Linux arm64 con Gemma 4 E2B, en la terminal con llama cli y como API compatible con OpenAI.
NVIDIA sigue dominando el entrenamiento de modelos de frontera en 2026, pero en inferencia el panorama es distinto. AMD MI300X/MI325X con ROCm maduro, Intel Gaudi 3, TPU v6 de Google y AWS Trainium/Inferentia ofrecen entre un 20 y un 50% de ahorro por token sin sacrificar calidad. Repasamos cuándo elegir cada opción.
Las NPU dejaron de ser un accesorio para convertirse en el componente que define rendimiento real en portátiles, teléfonos y servidores pequeños. Repaso práctico del hardware que domina 2026, qué cargas compensan y dónde sigue ganando la GPU tradicional.
Un enrutador de inferencia decide qué modelo atiende cada petición en función de coste, latencia y complejidad. Bien diseñados reducen la factura de tokens sin que el usuario perciba degradación; mal diseñados introducen fallos sutiles difíciles de depurar.
TypeScript 5.5 llegó con inferencia de predicados, tipos de expresiones regulares estrictos y mejoras de declaraciones aisladas. Un año de uso real para separar lo que cambia el código diario de lo que es novedad cosmética, y cuándo conviene actualizar.
vLLM sigue siendo el motor de referencia para servir LLM en GPU en 2025: el prefix caching automático recorta drásticamente la latencia con prompts repetidos, el speculative decoding acelera los modelos grandes y el soporte multi-LoRA abarata el SaaS multi-tenant, aunque el multi-GPU y el hardware no NVIDIA siguen siendo puntos débiles.
TensorRT-LLM es el motor de inferencia de NVIDIA que compila cada modelo en un binario optimizado para la GPU exacta y el tamaño de lote donde se va a servir. Usa kernels CUDA hechos a mano y cuantización FP8 nativa en H100. Frente a vLLM puede rendir entre 2 y 3 veces más en el mejor caso, a cambio de un build de 30 a 90 minutos.
vLLM sirve modelos de lenguaje con PagedAttention, batching continuo y una API compatible con OpenAI. En octubre de 2026 va por la 0.32.0, el motor V1 es el único desde la 0.11 y la caché de prefijos viene activada por defecto. Esta guía cubre el arranque con vllm serve, la cuantización por hardware, las métricas y cuándo elegir otra cosa.
Un modelo entrenado en PyTorch o TensorFlow, ejecutado igual en servidor, móvil, navegador o un gateway ARM en planta: eso es lo que resuelve ONNX Runtime. Convierte el formato ONNX en un artefacto portable de verdad, exportado una vez, a costa de ceder algo de rendimiento máximo frente a un runtime nativo específico de cada plataforma.
Text Generation Inference (TGI) es la pila de inferencia de Hugging Face para servir LLM abiertos en producción: continuous batching, cuantización de 4 y 8 bits, streaming y una API compatible con OpenAI. Tras un episodio de licencia restrictiva en 2023, volvió a Apache 2.0 en la versión 2.0.
7 min3674,4
Usamos cookies propias y de terceros para analizar el tráfico del sitio. Puedes aceptarlas, rechazarlas o configurar tu elección.
Más información sobre las cookies
Preferencias de cookies
NecesariasImprescindibles para el funcionamiento del sitio. Siempre activas.
AnalíticasNos ayudan a entender cómo se usa el sitio (Google Analytics).