
Descenso de gradiente por lotes, estocástico y mini-batch
Sobre este vídeo
Batch, estocástico y mini-batch: tres formas de recorrer los datos.
El descenso de gradiente por lotes usa todos los datos en cada paso, el estocástico usa una sola muestra y el mini-batch escoge un grupo intermedio, casi siempre de 32 a 256 ejemplos. Esta guía compara las tres variantes, su coste, su ruido y por qué el mini-batch se ha convertido en el estándar del entrenamiento.
Transcripción del vídeo
- 0:01 El descenso por lotes usa todos los datos en cada paso:
- 0:05 un camino suave, pero cada paso es caro.
- 0:09 SGD usa una sola muestra y avanza con mucho ruido.
- 0:12 Mini-batch queda en medio.
Más vídeos
Explicación
Firecrawl: datos web para agentes
Si escribes tu propio crawler: robots.txt, una cola por host y 304 Not Modified hacen que la opción cortés sea también la barata.
Explicación
El bucle agéntico y el patrón ReAct
El bucle agéntico (razonar, actuar, observar) en movimiento.
Explicación
Cómo instalar SearXNG con Docker
Un uso de la instancia propia: un agente de IA que encuentra sus propias fuentes consultando SearXNG, sin pagar por búsqueda.
Explicación
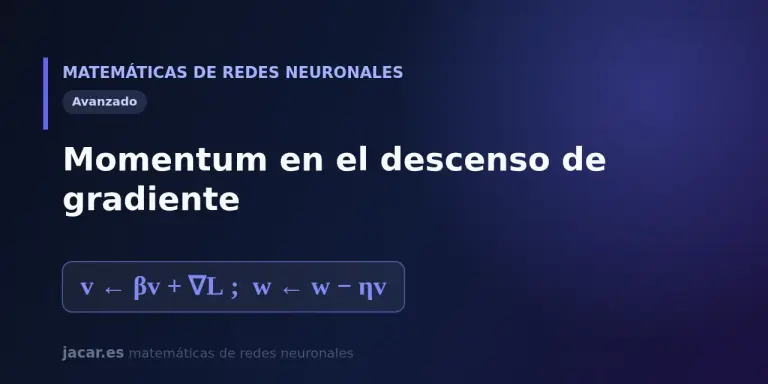
El momentum en el descenso de gradiente
Cómo el momentum acumula velocidad y suaviza el descenso de gradiente.
Explicación
El grafo computacional y la diferenciación automática
El grafo computacional y la diferenciación automática, en acción.
Explicación
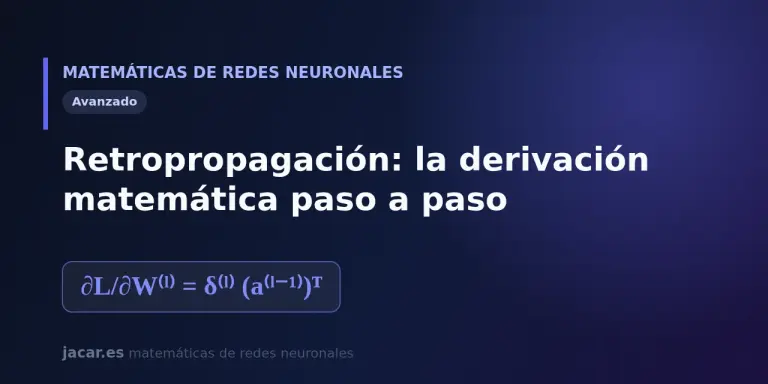
Retropropagación, la derivación matemática paso a paso
La derivación de la retropropagación, factor a factor con la regla de la cadena.