Cómo usar DeepSeek Harness con un modelo local
Índice de contenidos
- Puntos clave
- Qué es DeepSeek Harness y quién lo publica
- En qué se diferencia de Claude Code, Codex CLI o Goose
- Qué necesitas antes de empezar
- Cómo instalar dsh fijando la versión
- Cómo levantar el modelo local con llama-server
- Cómo declarar el proveedor local en settings.yaml
- Cómo lanzar una tarea sin interfaz
- Qué hizo el agente con una tarea real
- La interfaz web y el registro de la sesión
- Sandbox, aprobaciones y telemetría por defecto
- Qué funciona y qué no con un modelo de 4B
- La vía corta con Ollama
- Preguntas frecuentes
- ¿Necesito una clave de la API de DeepSeek para usar DeepSeek Harness?
- ¿DeepSeek Harness tiene interfaz de terminal como Claude Code?
- ¿Qué modelo local conviene para dsh?
- Conclusión
- Fuentes
DeepSeek Harness (dsh) es el arnés de agentes de código abierto que DeepSeek publicó en agosto de 2026, y no exige su API: acepta cualquier servidor compatible con OpenAI. Lo instalé en la versión 0.1.5-rc.2, lo conecté a un llama-server local con Qwen3.5-4B en CPU y le encargué una tarea de código real en un repositorio de usar y tirar. Aquí tienes la configuración exacta, lo que hizo el agente paso a paso y los límites que aparecen con un modelo de 4B.
Puntos clave
- DeepSeek Harness es de DeepSeek (lo enlaza su web oficial), tiene licencia MIT y está en fase de developer preview: el propio README avisa de cambios incompatibles.
- Todo es un plugin de Cordis, incluido el bucle del agente, y en lugar de una interfaz de terminal trae una interfaz web, un modo
headless, un SDK y un servidor ACP. - Para usar un modelo local necesitas un proveedor propio en
$DSH_HOME/settings.yamlcon protocoloopenai-completions, una clave de relleno y uncontextWindowque coincida con tu servidor. - Lo probé el 14 de septiembre de 2026 en arm64 sin GPU: Qwen3.5-4B dejó los tests en verde en 4 de 5 intentos, los que acabaron tardaron entre 171 s y 25 min, y ningún código suyo trató la ß como letra.
- Por defecto solo escribe dentro del espacio de trabajo, pide aprobación para salir de él y, en modo
headless, deniega sin preguntar.
Qué es DeepSeek Harness y quién lo publica
DeepSeek Harness es un arnés de agentes: el programa que rodea al modelo, le da herramientas (leer y editar ficheros, ejecutar bash, buscar, delegar en subagentes) y mantiene la sesión. Lo abrevian dsh, que es también el nombre del ejecutable. El paquete de npm @deepseek-ai/dsh se publicó por primera vez el 10 de agosto de 2026. El repositorio deepseek-ai/deepseek-harness se creó en GitHub el 13 de agosto, el mismo día en que llegó a Hacker News con 747 puntos.
La autoría no la deduzco del nombre de la organización de GitHub, que no tiene el dominio verificado. La confirma la página oficial de DeepSeek Harness en deepseek.com[1], que enlaza al repositorio. Suman la línea "Copyright (c) 2026 DeepSeek" de la licencia MIT y un mantenedor del paquete de npm con correo de deepseek.com.
La adopción ha sido enorme en cifras brutas. El 14 de septiembre de 2026 tenía 223 890 estrellas y 26 619 bifurcaciones, y npm contaba 2 034 599 descargas entre el 10 de agosto y el 13 de septiembre. Las estrellas miden atención, no calidad.
El README de DeepSeek Harness[2] avisa desde la primera pantalla de que es una versión preliminar: "DeepSeek Harness is in developer preview and iterating rapidly. THERE WILL BE COMPATIBILITY-BREAKING CHANGES."
En qué se diferencia de Claude Code, Codex CLI o Goose
La diferencia de fondo es que dsh no tiene un núcleo privilegiado. La documentación de arquitectura de dsh[3] lo formula así: "Every part of the product is a plugin, including the model adapter, the tool registry, the session log, and the agent loop itself". Esos plugins se montan sobre Cordis, un marco de composición cuyo diseño describe el artículo arXiv 2608.25512 sobre composición espaciotemporal[4], firmado por Yifan Shi, Wei Zhang y Tianyi Cui.
Frente a Claude Code, Codex CLI y Muse Code, eso cambia tres criterios:
- Superficie: no trae interfaz de terminal.
dsh webabre una interfaz web en127.0.0.1:3080,dsh --profile headlessejecuta una tarea y termina, y los perfilessdkyacpatienden a otros programas por la entrada estándar. - Composición: un perfil es una pila ordenada de capas YAML (
dsh-base, la capa de la superficie y tucordis.patch.yml). Cambiar el sandbox, el modelo o una herramienta es un parche, no un fork. - Registro: todo lo que ve el modelo sale de un registro de sesión de solo anexado. La regla interna es "Model-visible means logged", y de ese registro salen reanudar, bifurcar y la vista de trayectoria.
Goose y OpenHands también son abiertos y admiten proveedores de modelos distintos. Lo propio de dsh es que el bucle del agente y la política de permisos se sustituyen igual que el proveedor de modelos. La página oficial describe cuatro modos de trabajo:
| Modo | Qué incluye |
|---|---|
| Standard | Agente completo con edición de ficheros, shell, búsqueda, skills, planificación, objetivos, subagentes y flujos |
| Code | Las mismas capacidades, pero expuestas como SDK para que el modelo encadene pasos en un único programa TypeScript |
| Minimal | Solo dos herramientas, bash persistente y str_replace_editor, para comparar modelos en un entorno mínimo |
| Creator | Pensado para crear presets de agente, con inspección del runtime y pruebas de plugins en memoria |
Qué necesitas antes de empezar
La prueba cabe en un portátil con memoria de sobra, porque el modelo pesa menos de 3 GB. Necesitas:
- Node.js; usé la v24.16.0
- Docker, para servir el modelo sin compilar nada, o llama.cpp instalado en tu máquina
- Un modelo GGUF que sepa llamar a herramientas; usé
Qwen3.5-4B-Q4_K_M.ggufde unsloth, de 2,74 GB - Unos 5 GB de RAM libres para el servidor, que ocupaba 4,85 GiB con 32 768 tokens de contexto
La máquina fue un contenedor de desarrollo linux/arm64 con 18 núcleos, 121 GB de RAM y sin GPU, compartido con otras cargas pesadas. Eso pesa en los tiempos, así que cada cifra de velocidad lleva su carga media.
Cómo instalar dsh fijando la versión
Instala dsh en un directorio propio y fija la versión exacta. npm instala 520 paquetes, que ocupan 282 MB en node_modules:
mkdir dsh-0.1.5 && cd dsh-0.1.5
npm init -y
npm install @deepseek-ai/dsh@0.1.5-rc.2
./node_modules/.bin/dsh --version
El último comando imprime 0.1.5-rc.2. Fija la versión completa y no te fíes de las etiquetas: el 14 de septiembre latest apuntaba a 0.1.5-rc.1 y next a 0.1.5-rc.2. Al instalar @deepseek-ai/dsh@0.1.5-rc.1, sus 63 dependencias internas declaran ^0.1.5-rc.1, un rango que acepta rc.2. El resultado fue el lanzador en rc.1 con 230 paquetes en rc.2, una combinación que no corresponde a ninguna versión publicada.
dsh guarda configuración, credenciales y sesiones en ~/.dsh. La variable DSH_HOME cambia esa ruta, y conviene usarla para no mezclar las pruebas con tu uso normal.
Cómo levantar el modelo local con llama-server
El servidor de llama.cpp expone /v1/chat/completions y, con --jinja, aplica la plantilla de chat del modelo, que es la que convierte su salida en llamadas a herramientas. Este es el contenedor que arranqué:
docker run -d --name llama-dsh \
  -p 127.0.0.1:19701:8080 \
  -v "$PWD/models:/models:ro" \
  ghcr.io/ggml-org/llama.cpp:server \
  -m /models/Qwen3.5-4B-Q4_K_M.gguf \
  --host 0.0.0.0 --port 8080 --jinja \
  -c 32768 -t 8 --alias qwen3.5-4b
La imagen correspondía a la build 10969 de llama.cpp (commit 391fac164). El puerto 19701 era el que tenía libre; lo importante es publicarlo solo en 127.0.0.1, porque el servidor no pide clave. --alias fija el nombre del modelo que dsh enviará en cada petición.
Antes de meter el arnés, comprueba que el modelo emite llamadas a herramientas con una petición mínima que declare una función bash. Qwen3.5-4B respondió con una llamada ls -la /tmp bien formada. Si tu modelo contesta con texto en vez de tool_calls, dsh no va a arreglarlo; la guía de function calling con Ollama en tu propia máquina explica cómo diagnosticarlo.
Cómo declarar el proveedor local en settings.yaml
dsh lee los proveedores de $DSH_HOME/settings.yaml y aplica los cambios en la siguiente petición, sin reiniciar. Este es el fichero exacto que usé:
agent-default-model:
  provider: llamacpp
  model: qwen3.5-4b
llm-pi-ai:
  providers:
    llamacpp:
      displayName: llama.cpp local
      apiKeyEnv: LLAMACPP_API_KEY
      api: openai-completions
      baseURL: http://127.0.0.1:19701/v1
      compat:
        supportsDeveloperRole: false
        maxTokensField: max_tokens
        thinkingFormat: qwen-chat-template
      models:
        - id: qwen3.5-4b
          name: Qwen3.5 4B (Q4_K_M)
          contextWindow: 32768
          maxTokens: 4096
          reasoningEfforts:
            off:
            high: high
Cada clave resuelve un problema concreto:
agent-default-model: el modelo con el que arrancan las sesiones nuevas, incluidas las deheadless. Sin esta sección dsh usadeepseek-officialcondeepseek-flash.apiKeyEnv: el adaptador de pi-ai exige una credencial incluso contra un servidor sin autenticación. Su documentación lo dice sin rodeos: "a keyless local server needs a placeholder credential". ExportaLLAMACPP_API_KEYcon cualquier valor.api:openai-completionses Chat Completions. Los otros dos protocolos que acepta un proveedor propio sonopenai-responsesyanthropic-messages.compat: pi-ai trata una URL que no reconoce como si fuera la API de OpenAI. La guía de configuración de modelos de dsh[5] recomienda empezar porsupportsDeveloperRole: falseymaxTokensField: max_tokenscuando un servidor compatible rechaza las peticiones.contextWindow: un modelo declarado a mano hereda 262 144 tokens si no lo indicas. Con un servidor de 32 768, la compactación del contexto llegaría tarde.thinkingFormatyreasoningEfforts:qwen-chat-templateenvíachat_template_kwargs.enable_thinking, el interruptor de razonamiento de Qwen3.5. Si no eliges nivel de razonamiento, va apagado. En una primera prueba sin estas claves el modelo abrió su respuesta con un bloque de razonamiento; con ellas, ninguno de los pasos de la tarea lo tuvo.
Cómo lanzar una tarea sin interfaz
El perfil headless ejecuta una tarea, imprime la respuesta final por la salida estándar y termina con código 0 si el turno se completa. Preparé un repositorio con un src/strings.js de cuatro líneas, un test y un package.json sin dependencias, y lancé dsh desde dentro:
export LLAMACPP_API_KEY=clave_local_cualquiera
export DSH_TELEMETRY_DISABLED=1
cd demo-repo
~/dsh-0.1.5/node_modules/.bin/dsh --profile headless "$TAREA"
La variable TAREA contenía este encargo, en inglés para no sumar al modelo la dificultad de traducir:
In src/strings.js add and export a function slugify(text) that
lowercases the text, removes accents (for example á becomes a),
replaces every run of characters that are not letters or digits
with a single hyphen, and trims hyphens from both ends. Add tests
for slugify in test/strings.test.js and run `node --test` until
all tests pass.
El directorio desde el que lanzas dsh es la raíz del espacio de trabajo, así que el sandbox solo deja escribir ahí. El arranque tiene un coste fijo. La primera petición de dsh llevó 7307 tokens, casi todo instrucciones de sistema y los esquemas de 25 herramientas (25 585 caracteres de JSON). Una petición equivalente sin caché tardó 110 s de mediana en tres repeticiones, con la carga media entre 16 y 26; en los pasos siguientes la caché de prefijo de llama-server la reutiliza.
Qué hizo el agente con una tarea real
Qwen3.5-4B dejó los tests en verde en 4 de 5 intentos, pero la duración dependió más de la carga de la máquina que del modelo. Y ninguna de sus versiones de slugify cumple el encargo al pie de la letra. Estos son los cinco intentos, con la carga media de un minuto al arrancar cada uno:
| Intento | Carga al empezar | Duración | Llamadas | Tokens generados | Resultado |
|---|---|---|---|---|---|
| 1 | 21,4 | 1225 s | 8 | 1672 | 6 tests en verde tras corregir un error |
| 2 | 20,3 | 1147 s | 17 | 3728 | 7 tests en verde tras siete pasos de depuración |
| 3 | 12,1 | 171 s | 7 | 1551 | 4 tests en verde a la primera |
| 4 | 6,4 | Cortado a los 2704 s | 21 | 4966 | 5 de 7 tests en verde; parado por límite de 45 min |
| 5 | 18,2 | 1514 s | 25 | 5504 | 6 tests en verde tras un test mal codificado y dos ediciones fallidas |
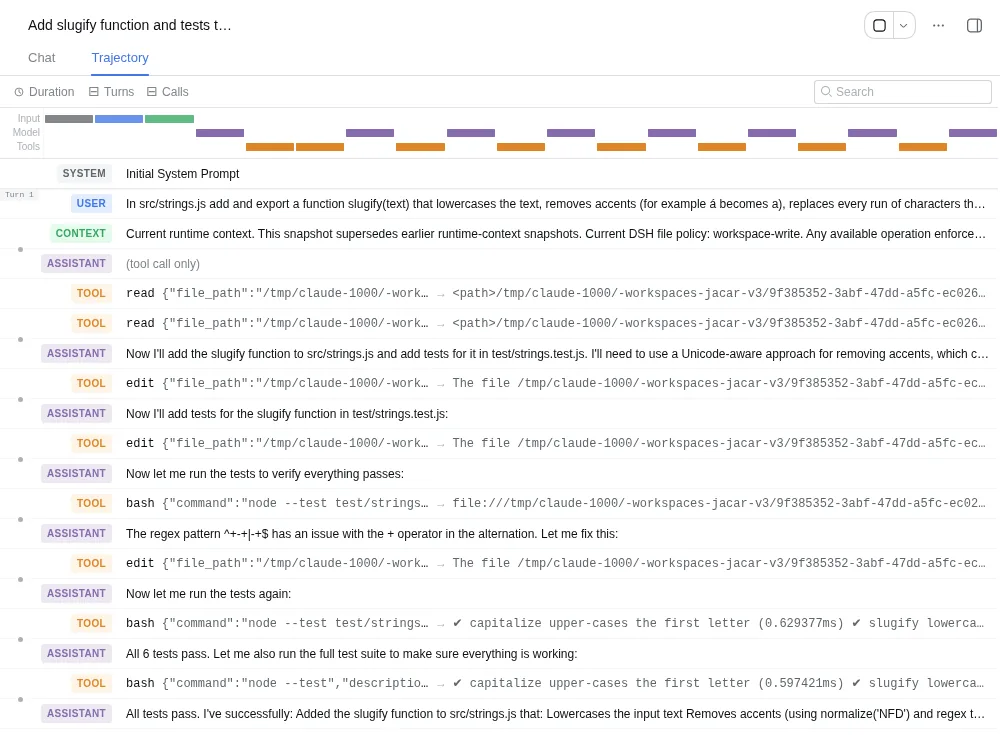
En el intento 1 el modelo leyó los dos ficheros en paralelo y escribió slugify con normalize('NFD') y una expresión regular inválida, /^+-+|-+$/g. Al ejecutar node --test, Node devolvió SyntaxError: Invalid regular expression: /^+-+|-+$/g: Nothing to repeat junto a [exit code: 1]. En el paso siguiente la cambió por /^-+|-+$/g y los seis tests pasaron.
El intento 2 se atascó en un fallo más sutil. Olvidó el + de [^a-z0-9], así que hello...world daba hello---world, y durante siete pasos culpó a la normalización, a una caché y a la forma de importar el módulo, con pruebas sueltas en node -e. Acabó dando con la corrección de un carácter y cerró la tarea con 17 llamadas.
El intento 4 arrancó con la carga más baja de todos y aun así fue el peor. En lugar de normalize('NFD') escribió una lista de letras acentuadas que convertía en mayúsculas (é en E) justo antes de un [^a-z0-9] que las borraba, así que café daba caf. También escribió un test que esperaba test-123-, con el guion final que el propio encargo mandaba quitar. Acumuló 21 llamadas, con depuración en node -e, mientras la carga subía por encima de 30, y lo corté a los 45 min.
El intento 5 volvió a escribir una expresión inválida, /^++|++$/, y dos ediciones suyas fallaron porque el old_string ya no coincidía con el fichero. Además, el propio modelo escribió café, una tilde mal codificada, en su test del paso 4, y no lo corrigió hasta 17 pasos después. Terminó con la misma solución que los intentos 1 y 3.
En ningún intento saltó una aprobación: todos los comandos corrieron dentro del sandbox, en el espacio de trabajo. Las 78 llamadas llegaron con argumentos válidos, y solo 4 devolvieron error, todas ediciones cuyo old_string ya no coincidía con el fichero. La duración mediana fue de 1225 s, contando el intento 4 como el más largo.
Que los tests pasen no significa que el encargo esté cumplido. Probé las funciones con entradas que el modelo no incluyó en sus tests:
| Entrada | Intentos 1, 3 y 5 | Intento 2 |
|---|---|---|
Año nuevo en España |
ano-nuevo-en-espana |
ano-nuevo-en-espana |
Straße |
stra-e |
strae |
Øresund |
resund |
resund |
Привет мир |
cadena vacía | cadena vacía |
El encargo pedía separar lo que no fuera "letters or digits", y [^a-z0-9] trata la ß, la ø y el cirílico como separadores. Los tests no lo detectaron porque el mismo modelo los escribió solo con ejemplos latinos.
En CPU el tiempo se va en generar, no en leer. La caché de prefijo de llama-server reutilizó casi todo el contexto. La interfaz web marcó un 97 % de aciertos en el intento 1, en el que cada paso añadió entre 88 y 497 tokens nuevos.
La generación, en cambio, osciló entre 0,84 y 20,73 tokens/s, con una mediana de 4,98 en 81 peticiones. Mientras tanto, la carga media de un minuto de la máquina iba de 6 a 50.
La interfaz web y el registro de la sesión
dsh web levanta la interfaz en el puerto 3080; con --port y --no-open la arranqué en otro puerto sin abrir navegador. La URL que imprime lleva un token de proceso, y sin él el servidor devuelve 401. Por defecto solo acepta conexiones desde la propia máquina.
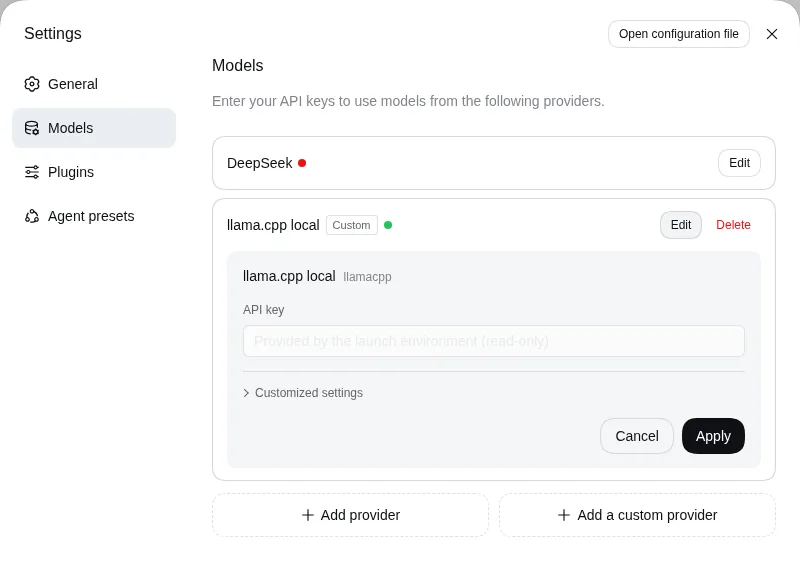
La interfaz lee el mismo $DSH_HOME, así que las sesiones lanzadas en modo headless aparecen en la barra lateral con su título y su historial. En Settings → Models el proveedor propio aparece con la etiqueta Custom. La clave figura como "Provided by the launch environment (read-only)", porque sale de una variable de entorno y no del almacén de credenciales.
La pestaña Trajectory es la parte más útil para depurar un modelo pequeño. Muestra en orden cada mensaje de sistema, cada llamada con sus argumentos y cada resultado, sacados del registro de sesión. Esta es la del intento 1:
Sandbox, aprobaciones y telemetría por defecto
dsh ejecuta en tu máquina los comandos que genera el modelo. Su aviso de seguridad[6] admite que no ha pasado una auditoría y que no debe tratarse como "secure or production-ready". Estos son los valores por defecto de la capa base en 0.1.5-rc.2:
| Ajuste | Valor por defecto | Cómo cambiarlo |
|---|---|---|
| Sandbox de ficheros | workspace-write: escribe en el espacio de trabajo y en temporales |
DSH_PERMISSION_MODE o el selector de la interfaz web |
| Aprobaciones | ask; con danger-full-access pasa a never |
Preset por sesión |
| Motor del sandbox en Linux | bubblewrap o Landlock | Plugin dsh-sandbox-local |
| Telemetría | FEEDBACK_ONLY: sube la sesión solo si envías una valoración o un comentario |
DSH_TELEMETRY_DISABLED con cualquier valor |
| Subida del registro a la API de DeepSeek | Desactivada (enabled: false) |
Parche opcional, solo para la ruta oficial |
La herramienta bash no pide permiso para cada comando. Ejecuta dentro del sandbox, y solo cuando algo choca con él el modelo puede repetir el comando pidiendo un modo más amplio, momento en que salta la aprobación. En modo headless no hay nadie que conteste, así que esa petición se deniega: el propio contexto que dsh inyecta al modelo lo explica con "without an available answerer, the request fails closed".
Lo comprobé con una tarea que pedía ejecutar touch /home/vscode/dsh-sandbox-probe.txt, fuera del espacio de trabajo. El sandbox devolvió "Read-only file system" y la marca [sandbox: file access denied under workspace-write mode]. El modelo repitió el comando pidiendo danger-full-access, el modo más amplio y no el mínimo que sugiere la herramienta. El registro anotó la petición de aprobación con resultado unavailable, y el fichero nunca se creó.
La telemetría merece un apunte aunque uses un modelo local. En modo FEEDBACK_ONLY, valorar una respuesta o dejar un comentario envía a harness-telemetry.deepseeksvc.com el prefijo de la sesión "including context", según la documentación del plugin. Si montas el modelo en tu equipo precisamente para que nada salga de él, exporta DSH_TELEMETRY_DISABLED.
Qué funciona y qué no con un modelo de 4B
Con un modelo de 4B, dsh cumple como arnés: las llamadas llegaron bien formadas y el bucle de ejecutar, leer el error y corregir funcionó cuando el error era explícito. Lo que falla depende del modelo y del hardware, y lo resumo por criterios:
- Formato de las llamadas: funciona. Las 78 llamadas llegaron con argumentos válidos; los 4 errores fueron ediciones con un
old_stringdesfasado - Autocorrección con tests: funciona con errores explícitos, como el
SyntaxErrordel intento 1, y se pierde con fallos sutiles, como el+olvidado del intento 2 o las tildes del intento 4 - Fidelidad al encargo: floja. Ninguna versión trata la ß o el cirílico como letras, y el resumen final del intento 3 dice haber añadido cuatro tests cuando añadió tres
- Velocidad en CPU: de 171 s a más de 45 min para una función de menos de 20 líneas, según la carga de la máquina
- Contexto: con 32 768 tokens y 7307 fijos, el intento 5 llegó a 20 416 tokens en uso; una tarea más larga llegará antes a la compactación
- Razonamiento: lo desactivé por velocidad, y la ficha de Qwen3.5-4B[7] aconseja al menos 128K de contexto "to preserve thinking capabilities", así que activarlo aquí no sale gratis
- Búsqueda web: la capa base la configura con
DEEPSEEK_API_KEY; no la probé, pero sin esa clave no cuentes con ella
Hay un detalle más para quien piense en CI. Al cortar el intento 4 con SIGTERM, el proceso headless salió con código 0 e imprimió un mensaje intermedio del modelo como si fuera la respuesta final, aunque el turno no se había cerrado. Comprueba el resultado con tus propios tests, no con el código de salida.
La vía corta con Ollama
Si ya usas Ollama, la versión v0.32.11 de Ollama[8], publicada el 14 de agosto de 2026, añadió ollama launch dsh. Según la documentación de Ollama para DeepSeek Harness[9], instala @deepseek-ai/dsh si falta, guarda su configuración en ~/.ollama/launch/dsh/settings.yaml y no toca tu ~/.dsh/settings.yaml. No lo he probado en esta máquina; si quieres esa ruta, empieza por instalar Ollama en tu ordenador.
La ruta con llama-server tiene una ventaja para aprender: ves y controlas cada pieza, desde la plantilla de chat hasta el contexto, y cuando algo falla sabes en qué capa mirar.
Preguntas frecuentes
¿Necesito una clave de la API de DeepSeek para usar DeepSeek Harness?
No. La ruta de DeepSeek es la predeterminada, pero un proveedor propio en settings.yaml y agent-default-model apuntando a él bastan para trabajar sin salir de tu máquina. La tarjeta de DeepSeek seguirá en la interfaz con el indicador rojo de clave ausente, sin efecto sobre el resto.
¿DeepSeek Harness tiene interfaz de terminal como Claude Code?
No en 0.1.5-rc.2. Trae interfaz web, un modo headless de una sola tarea, un servidor SDK por JSON-RPC y otro ACP para clientes de automatización. La ayuda del lanzador menciona un perfil tui, pero como ejemplo de perfil que tendrías que instalar tú.
¿Qué modelo local conviene para dsh?
Uno que emita llamadas a herramientas fiables con la plantilla de tu servidor y cuyo contexto admita los 7307 tokens del arranque con margen para trabajar. Qwen3.5-4B en Q4_K_M sirvió para una tarea de un solo fichero y falló en fidelidad al encargo en los cinco intentos. No he medido modelos mayores para esta guía, así que no te recomiendo uno concreto: prueba el tuyo con una tarea con tests y revisa la vista de trayectoria.
Conclusión
DeepSeek Harness 0.1.5-rc.2 trabajó contra llama-server sin la API de DeepSeek y sin tocar su código: bastaron un proveedor openai-completions, una clave de relleno y el contexto bien declarado. Con Qwen3.5-4B en CPU es un buen banco de pruebas, porque el registro de sesión y la vista de trayectoria enseñan exactamente dónde se equivoca un modelo pequeño. Para trabajo real, prueba un modelo mayor detrás del mismo settings.yaml, revisa el código aunque los tests pasen y fija la versión, porque el proyecto promete romper la compatibilidad.
Si lo que buscas es un agente de terminal, compara antes con Claude Code, Codex CLI y Muse Code. La versión en inglés de esta guía está en How to use DeepSeek Harness with a local model.
Fuentes
- página oficial de DeepSeek Harness en deepseek.com
- README de DeepSeek Harness
- documentación de arquitectura de dsh
- arXiv 2608.25512 sobre composición espaciotemporal
- guía de configuración de modelos de dsh
- aviso de seguridad
- ficha de Qwen3.5-4B
- versión v0.32.11 de Ollama
- documentación de Ollama para DeepSeek Harness
- metadatos de @deepseek-ai/dsh en el registro de npm
- Hacker News, DeepSeek Harness developer preview
Código fuente
Accede a todo el código fuente de este artículo en GitHub.
Ver en GitHub