Cómo crear un agente con Dify Agent y un modelo local
Índice de contenidos
- Puntos clave
- Qué es Dify Agent y en qué se diferencia del agente clásico
- Qué necesitas antes de empezar
- Cómo levantar Dify 1.17.1 sin ocupar los puertos 80 y 443
- Cómo añadir Ollama al mismo Compose
- Cómo conectar Ollama a Dify con el plugin oficial
- Por qué Dify marca tu modelo local como incompatible
- Cómo configurar y publicar el agente en Community Edition
- Qué consigue el agente publicado con Qwen3.5-4B en CPU
- Qué hace el modo Build con un modelo de 4B
- Qué puede alcanzar el sandbox en la red
- Preguntas frecuentes
- ¿Funciona Dify Agent con un modelo local sin GPU?
- ¿Por qué Dify dice que mi modelo es incompatible?
- ¿Puede el sandbox de Dify Agent acceder a mi red local?
- Conclusión
- Fuentes
Dify Agent es el agente con sandbox Linux que Dify estrenó en beta con la versión 1.16.0 y que viene activado en su Docker Compose. Esta guía lo levanta con Dify 1.17.1, le conecta un modelo local servido por Ollama y cuenta qué pasó al ponerlo a trabajar con Qwen3.5-4B en un procesador sin tarjeta gráfica: dónde cumplió, dónde inventó datos y qué alcanza su sandbox en la red.
Puntos clave
- Dify 1.17.1 levanta 16 servicios con
docker compose up -dy publica los puertos 80, 443 y 5003. Las variablesEXPOSE_*del.envlos mueven a otro puerto y a127.0.0.1. - El modelo local entra por el plugin oficial
langgenius/ollama1.0.2 con las llamadas a herramientas activadas. Ollama necesita más contexto que los 4.096 tokens que asigna sin GPU: la primera petición del agente publicado ya ocupó 2.703. - El selector del agente marca como «Incompatible» cualquier modelo cuyo nombre empiece por
qwen3.5,qwen2ogpt-4, entre otros. Es una lista de expresiones regulares en el frontend, no una prueba del modelo. - Con un prompt escrito a mano, el agente publicado descargó el CSV, instaló pandas y dio las cifras correctas en tres de tres ejecuciones, con una mediana de 182 s. En dos de ellas añadió comentarios con datos falsos.
- En el modo Build, ninguna de tres sesiones de 21 a 27 minutos terminó con una respuesta: una se inventó los datos, otra contó 149 filas de 150 y la tercera cayó por el límite de lectura de 300 s del plugin de Ollama.
- El sandbox sale a internet por un Squid que bloquea las redes privadas, pero llega directo al
agent_backend. Dify avisa de que no es una frontera de seguridad endurecida.
Qué es Dify Agent y en qué se diferencia del agente clásico
Dify Agent trabaja dentro de un sandbox Linux propio: ejecuta órdenes, instala programas y lee y escribe ficheros. El agente clásico, que la documentación llama ahora Legacy Agent, solo llama a las herramientas que le configuras. El nuevo apareció en beta con Dify 1.16.0[1], publicada el 17 de julio de 2026, y su nota de versión pide ofrecerlo "only to trusted, non-malicious users".
La configuración se divide en dos partes. La capacidad (prompt, modelo, skills, ficheros y herramientas) se define una vez. La tarea es el mensaje de cada ejecución.
La versión 1.17.0[2], del 25 de agosto, añadió el backend de sandbox de E2B y un gestor de skills por espacio de trabajo. También guarda una instantánea del directorio personal al publicar y compacta el historial. La versión actual es la 1.17.1[3], del 10 de septiembre.
La guía de Dify como plataforma LLMOps autoalojada explica el resto de la plataforma con la versión 1.15.0. Aquí solo trato el agente nuevo. La licencia no cambia: es una Apache 2.0 modificada que no permite operar un servicio multiinquilino sin autorización ni quitar el logotipo de la consola.
Qué necesitas antes de empezar
La documentación pide al menos 2 núcleos, 4 GiB de RAM y Docker Compose 2.24.0 o posterior, sin contar el modelo. Lo probé el 16 de septiembre de 2026 con esta máquina y estas versiones:
| Pieza | Versión o dato |
|---|---|
| Máquina | Linux arm64, 18 núcleos, 121 GB de RAM, sin GPU, compartida con otras cargas |
| Docker | Engine 29.5.2 y Compose 2.40.3 |
| Dify | 1.17.1 (dify-api, dify-agent-backend, dify-agent-local-sandbox) |
| Plugin daemon | langgenius/dify-plugin-daemon:0.6.10-local |
| Plugin de Ollama | langgenius/ollama 1.0.2 |
| Ollama | 0.34.1 |
| Modelo | qwen3.5:4b: 4,7 B de parámetros en Q4_K_M, 3,4 GB, licencia Apache 2.0 |
La máquina estaba compartida y la carga media de un minuto osciló entre 6 y 73 durante las pruebas. Cada tiempo que doy lleva su carga al lado. Las llamadas y los tokens salen del registro de Ollama y de un pequeño proxy de registro en Python que puse entre Dify y Ollama a partir de la segunda prueba.
Cómo levantar Dify 1.17.1 sin ocupar los puertos 80 y 443
Clona la etiqueta de la versión y crea el .env a partir del ejemplo:
git clone --depth 1 --branch 1.17.1 https://github.com/langgenius/dify.git
cd dify/docker
cp .env.example .env
El Compose publica nginx en los puertos 80 y 443 de todas las interfaces, y plugin_daemon en el 5003. Como las líneas de puertos son del tipo ${EXPOSE_NGINX_PORT:-80}, la dirección de escucha cabe dentro de la variable. Cambia estas líneas del .env:
EXPOSE_NGINX_PORT=127.0.0.1:21580
EXPOSE_NGINX_SSL_PORT=127.0.0.1:21543
EXPOSE_PLUGIN_DEBUGGING_PORT=127.0.0.1:21503
TRIGGER_URL=http://localhost:21580
ENDPOINT_URL_TEMPLATE=http://localhost:21580/e/{hook_id}
NEXT_PUBLIC_SOCKET_URL=ws://localhost:21580
SERVICE_API_URL=http://localhost:21580
APP_WEB_URL=http://localhost:21580
Comprueba con docker compose config que las tres publicaciones quedan en 127.0.0.1. Las variables TRIGGER_URL, ENDPOINT_URL_TEMPLATE y NEXT_PUBLIC_SOCKET_URL vienen con localhost y el puerto 80 implícito, así que las alineé con el puerto nuevo. SERVICE_API_URL y APP_WEB_URL vienen vacías, y así la pestaña Punto de acceso mostraba http://localhost/v1, sin el puerto. Con el valor puesto, las direcciones salieron completas tras recrear los contenedores. Si actualizas desde una versión anterior con el Weaviate incluido, la nota de la 1.17.1 exige antes una actualización escalonada de Weaviate 1.27.0 a 1.39.2.
Arranca la pila con docker compose up -d. La documentación de despliegue con Compose[4] enumera 16 servicios:
- siete de núcleo:
api,api_websocket,worker,worker_beat,web,plugin_daemonyagent_backend - ocho dependencias:
weaviate,db_postgres,redis,nginx,ssrf_proxy,agent_ssrf_proxy,sandboxylocal_sandbox - la tarea
init_permissions, que ajusta permisos y termina
Con las imágenes ya descargadas, up -d tardó 20 s. En marcha, los 15 contenedores sumaban unos 2,2 GB de RAM según docker stats. Crea la cuenta de administrador en http://localhost:21580/install.
Cómo añadir Ollama al mismo Compose
Ollama va en un fichero aparte, docker-compose.ollama.yaml, para no tocar el docker-compose.yaml que genera Dify. Así comparte la red default con plugin_daemon, que es el contenedor que llama al modelo:
services:
  ollama:
    image: ollama/ollama:0.34.1
    environment:
      OLLAMA_CONTEXT_LENGTH: "32768"
      OLLAMA_KEEP_ALIVE: "60m"
    volumes:
      - ./volumes/ollama:/root/.ollama
    ports:
      - "127.0.0.1:21534:11434"
OLLAMA_CONTEXT_LENGTH es la línea que más importa. Según la documentación de Ollama[5], con menos de 24 GiB de VRAM el contexto por defecto es de 4k, y para agentes recomienda al menos 64.000 tokens. La primera petición del agente publicado ya ocupó 2.703 tokens, y las sesiones en modo Build llegaron a 25.753.
Con 32.768 tokens me bastó; si te sobra RAM, sube a 64.000. Con este contexto y el modelo cargado, el contenedor de Ollama ocupaba 5,5 GB.
Exporta COMPOSE_FILE para no repetir los dos ficheros en cada orden, arranca Ollama y descarga el modelo:
export COMPOSE_FILE=docker-compose.yaml:docker-compose.ollama.yaml
docker compose up -d ollama
docker compose exec ollama ollama pull qwen3.5:4b
La descarga de 3,4 GB tardó 67 s.
En una máquina cargada conviene fijar además los hilos. Con los que elige Ollama, mi primera petición de prueba de 200 tokens pasó más de cinco minutos sin terminar, con la carga media por encima de 22. Con num_thread 6, la misma petición terminó en 37 s y en 11 s en dos intentos seguidos, con cargas de 33,6 y 22,8. Fíjate también en el nombre del modelo, que importa en la siguiente sección:
docker compose exec ollama sh -c \
  'printf "FROM qwen3.5:4b\nPARAMETER num_thread 6\n" > /root/Modelfile \
  && ollama create lab/qwen35-cpu:4b -f /root/Modelfile'
Cómo conectar Ollama a Dify con el plugin oficial
Dify habla con Ollama a través del plugin langgenius/ollama, que se instala desde Marketplace. Una vez instalado, añade el modelo en la configuración del proveedor con estos campos:
- Model Name:
lab/qwen35-cpu:4b, el nombre exacto que usa Ollama - Base URL:
http://ollama:11434, sin/api, porque el plugin añade/api/chat - Model context size:
32768, el mismo valor queOLLAMA_CONTEXT_LENGTH - Function call support: Sí. Viene en No, y el agente trabaja llamando a herramientas
- Vision support: Sí, porque
qwen3.5:4bacepta imágenes
Dify valida la credencial con una petición de 5 tokens antes de guardarla. Las peticiones al modelo salen de plugin_daemon, que está en la red default y no usa el proxy SSRF, así que el nombre ollama se resuelve directamente. Si Ollama vive en otra máquina, esa dirección tiene que ser alcanzable desde ese contenedor.
Para elegir otro modelo, la comparativa de modelos abiertos con tool calling y la guía de function calling con Ollama en tu propia máquina explican qué familias responden bien a las herramientas.
Por qué Dify marca tu modelo local como incompatible
Con el primer nombre que le di, qwen3.5-cpu:4b, el campo de modelo del agente mostró la etiqueta Incompatible, y el selector lo escondía tras Mostrar modelos incompatibles. La causa está en el fichero model-compatibility.ts[6] de la 1.17.1. Contiene una lista de expresiones regulares que el frontend compara con el nombre visible del modelo, entre ellas ^qwen3\.5, ^qwen3-, ^qwen2, ^gpt-4, ^deepseek-v3 y ^glm-4. Otra lista marca como sugeridos a GPT-5.5, Claude Opus 4.8 y 4.7, Sonnet 4.6, DeepSeek V4 Pro y Flash, Qwen3.7 Max y GLM 5.1, entre otros.
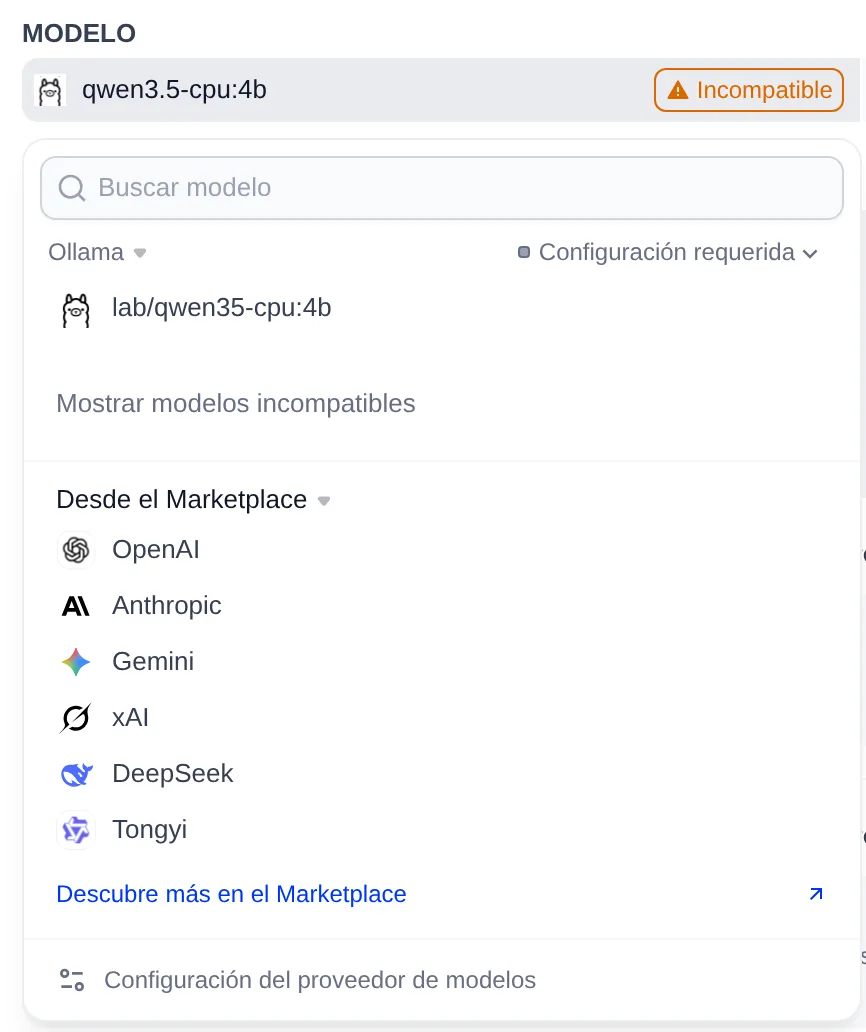
La comprobación no mira el proveedor ni prueba el modelo: solo lee el nombre. Con la etiqueta puesta, el agente ejecutó igualmente las tres sesiones en modo Build que cuento más abajo, pero el botón de parámetros del modelo quedó desactivado. Con el alias lab/qwen35-cpu:4b registrado en Dify, la etiqueta desapareció y el botón se activó.
Renombrar quita el aviso, no el motivo. La guía para construir un agente[7] lo resume así: "Agent performance rises and falls with the model, so pick a recent one". La lista de incompatibles recoge los modelos que Dify considera insuficientes para el sandbox. Qwen3.5 está en esa lista por su nombre, y las pruebas de las secciones siguientes le dan la razón a Dify en parte.
Cómo configurar y publicar el agente en Community Edition
Desde Agents, pulsa Crear y Crear desde cero, dale nombre y rol, y elige el modelo. Dos detalles de la edición comunitaria cambian el flujo que describe la documentación:
- La pestaña Vista previa está desactivada, con el aviso «Preview solo está disponible en Dify Cloud y Enterprise». Para probar lo publicado te quedan la aplicación web y la API de servicio.
- En mi primera prueba, el prompt que escribí aún no se había guardado cuando pulsé publicar, y la versión publicada salió vacía. Antes de publicar, recarga la página y comprueba que el prompt sigue ahí.
Para este agente escribí el prompt a mano, con cinco pasos y la prohibición explícita de inventar datos:
Eres un analista de datos que trabaja en un sandbox Linux.
Cuando el usuario te dé la URL de un CSV:
1. Descárgalo con curl -fsSL a datos.csv. Si la descarga falla,
   detente y explica el error. No inventes datos ni uses un
   conjunto de ejemplo.
2. Si falta pandas, instálalo con python3 -m pip install --user pandas.
3. Con Python calcula el número de filas y columnas, y la media y
   el máximo de cada columna numérica.
4. Guarda el resultado en informe.md como una tabla Markdown.
5. Responde con el contenido de informe.md.
Dify coloca ese texto delante de su propio prompt de sistema. La primera petición a Ollama llevó 8.294 caracteres de sistema, de los que 522 eran míos, y cuatro herramientas: shell_run, shell_wait, shell_input y shell_interrupt. El resto describe el sandbox, la herramienta de línea de órdenes dify-agent y un script de ejemplo que empieza por #!/usr/bin/env -S uv run --quiet --script.
Publica con Publicar actualización, crea una clave en Punto de acceso y llama a la API de servicio. La API del agente[8] solo admite respuestas en streaming:
URL=https://raw.githubusercontent.com/mwaskom/seaborn-data/master/iris.csv
jq -n --arg q "Analiza este CSV: $URL" \
  '{inputs: {}, query: $q, response_mode: "streaming", user: "prueba"}' |
curl -sN http://localhost:21580/v1/chat-messages \
  -H "Authorization: Bearer tu_clave_de_api" \
  -H "Content-Type: application/json" -d @-
La respuesta llega como eventos agent_thought, con cada llamada a herramienta y su salida, y agent_message con el texto. El evento message_end cierra el turno con el recuento de tokens.
Qué consigue el agente publicado con Qwen3.5-4B en CPU
Con el prompt escrito a mano, el agente resolvió la tarea en las tres ejecuciones que lancé contra el CSV de iris de seaborn-data. Las tres tablas coincidieron con mi cálculo independiente: 150 filas, 5 columnas y medias de 5,84, 3,06, 3,76 y 1,20. El texto libre que añadió alrededor fue otra historia:
| Ejecución | Tiempo total | Herramientas | Llamadas al modelo | Carga media al empezar | Texto libre |
|---|---|---|---|---|---|
| 1 | 181,9 s | 5 | 6 + 1 de título | 73,1 | dice 49 flores por especie; son 50 |
| 2 | 107,8 s | 6 | 7 + 1 de título | 19,8 | atribuye a setosa la media global de pétalo |
| 3 | 197,5 s | 13 | 14 + 1 de título | 18,2 | sin errores |
La mediana fue de 182 s. La generación se movió entre 23,8 y 35 tokens por segundo en 26 de las 27 llamadas del agente, con una mediana de 29,4. La llamada restante, la primera de la ejecución 1, bajó a 6 con la carga en 73. La llamada de título la lanza Dify en paralelo al primer paso, con num_predict 500, y en las tres ejecuciones agotó esos 500 tokens.
Tres detalles más salieron de los registros:
- pandas 3.0.5 se descargó de nuevo en cada ejecución. Lo que el agente instala en una ejecución publicada es temporal; si quieres conservarlo, instálalo en modo Build y aplica el borrador.
- En la ejecución 3, el modelo intentó escribir en
/tmp, que el prompt de sistema prohíbe y Landlock bloqueó, y llamó apython3con rutas inventadas antes de acertar. - Las cifras salen del Python que ejecuta el agente; las frases que las rodean salen del modelo. Si vas a reutilizar el informe, pide solo la tabla.
Qué hace el modo Build con un modelo de 4B
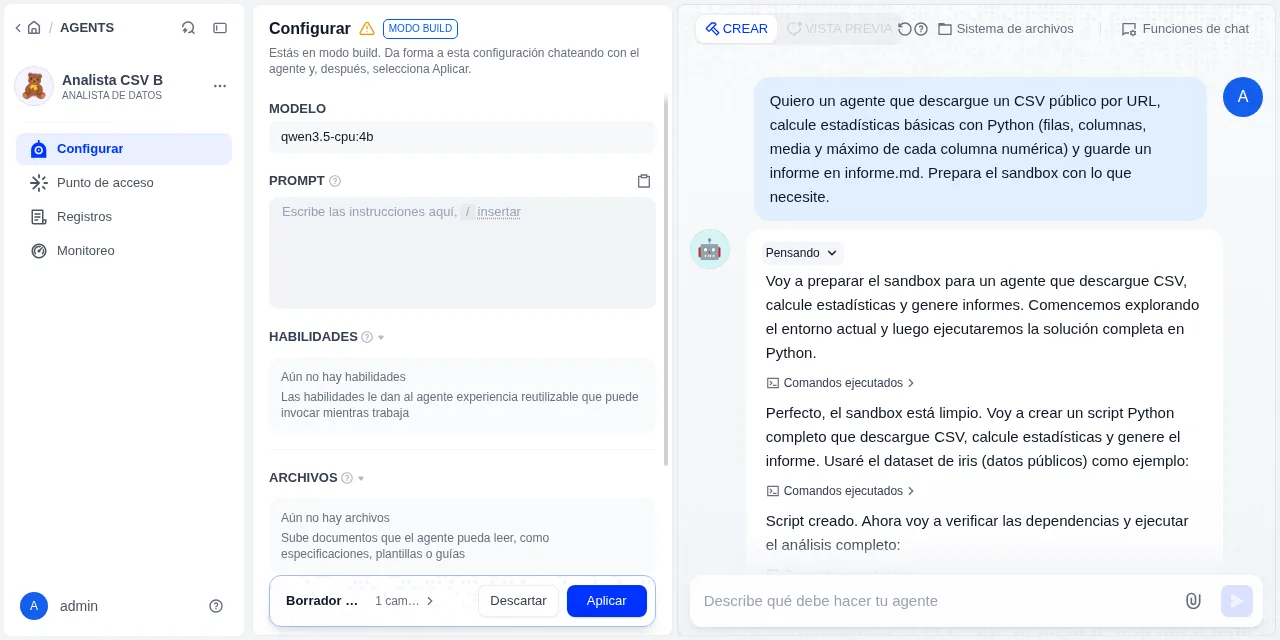
Build es el modo en el que el propio agente prepara el sandbox, las skills, los ficheros y una nota que leerá en cada conversación. Con el modelo local fue la parte que peor salió: ninguna de tres sesiones terminó con una respuesta.
Lancé la misma petición, sin URL, en tres agentes nuevos. Decía así:
Quiero un agente que descargue un CSV público por URL, calcule estadísticas básicas con Python (filas, columnas, media y máximo de cada columna numérica) y guarde un informe en informe.md. Prepara el sandbox con lo que necesite.
| Sesión | Duración | Llamadas al modelo | Tokens de entrada y salida | Carga media | Resultado |
|---|---|---|---|---|---|
| A | 1.435,7 s | 32 | 409.504 y 13.008 | de 13 a 38 | se inventó los datos |
| B | 1.642,8 s | 46 | 685.345 y 17.812 | de 6 a 15 | informe con 149 filas de 150 |
| C | 1.264,5 s | 24 | 316.730 y 19.664 | de 6 a 10 | cortada por un error 503 |
La sesión A fue la más preocupante, porque el resultado parecía correcto:
- Tardó cuatro intentos en instalar pandas. Copió el script de ejemplo sin el
-Sdeenv(salida 127), probóuv sync --add, que no existe, yuv pip installsin entorno virtual, antes de acertar conpip install. - Probó nueve URL de conjuntos de datos que no existen. Las comprobé después desde fuera del sandbox: ocho devuelven 404 y una, 403.
- Se inventó tres conjuntos de datos distintos, de 8×4, 6×3 y 5×5 filas por columnas, y en su código llamó "dataset real" a los inventados. Rehízo el informe dos veces, cada una sobre un fichero diferente.
- Subió el último
data.csva los ficheros del agente y escribió en su nota que usaría un "dataset de ejemplo" si la descarga fallaba.
La sesión B eligió una URL real, el iris.data del repositorio de UCI. Como ese fichero no tiene fila de cabecera, pandas tomó la primera flor como nombres de columna. Por eso el informe cuenta 149 filas y titula las columnas 5.1, 3.5, 1.4 y 0.2.
Antes de eso, nueve órdenes de la sesión B chocaron con «Permission denied». Intentaba escribir en /tmp, en /workspace y en un directorio personal ajeno, y Landlock solo le deja escribir en su carpeta de trabajo y en su $HOME.
La sesión C probó siete URL; seis fallaron (cinco con 404 y una con 403) y la séptima, un CSV real de UCI, no llegó a procesarse. El script uv run --script que sugiere el prompt de sistema falló con Invalid cross-device link (os error 18) al descomprimir una dependencia.
Después, la sesión C murió con un 503. La caché de Qwen3.5, un modelo híbrido, solo recuperó un punto de control de 2.059 tokens, así que Ollama tardó 326 s en reprocesar otros 21.490. El plugin de Ollama deja de esperar a los 300 s, como indica el propio error (read timeout=300).
En A y B, el último paso del modelo fue un razonamiento que anunciaba un resumen final que nunca escribió. B y C no guardaron nada en la configuración.
No apliqué ninguno de los tres borradores. Con el de A, el agente publicado habría leído en cada conversación la instrucción de usar datos de ejemplo cuando la descarga falla. Con un modelo pequeño, escribe tú el prompt y las skills, y usa Build solo con órdenes concretas, como instalar una dependencia que quieres conservar.
Qué puede alcanzar el sandbox en la red
El contenedor local_sandbox solo está en dos redes internas: una compartida con agent_backend y otra con agent_ssrf_proxy, un Squid 6.13. Sus variables HTTP_PROXY y HTTPS_PROXY apuntan a ese proxy, y la plantilla squid-agent.conf[9] permite /agent-stub/ en agent_backend y /files/ en la API, bloquea las redes privadas y deja pasar el resto de internet. Lo comprobé desde dentro del contenedor con curl y con Python:
| Destino | Resultado |
|---|---|
https://pypi.org, https://example.com, http://neverssl.com |
200 a través del proxy |
http://ollama:11434, http://redis:6379, http://api:5001/console/api/setup |
403 de Squid |
http://169.254.169.254 y host.docker.internal |
403 de Squid |
http://api:5001/files/… |
llega a la API, que responde 404 para un fichero inexistente |
http://agent_backend:5050 sin proxy |
llega directo; el backend responde 404 |
| Internet sin proxy | falla, porque la red es interna y no resuelve nombres |
El comentario del Compose sobre local_sandbox dice que el proxy "only allows agent_backend /agent-stub/ and the Dify API /files/*", pero esa frase describe las excepciones dentro de la red privada. Internet queda abierto, y el agente descargó pandas y el CSV sin que yo configurara nada. Otro matiz: curl ignora HTTP_PROXY en mayúsculas para las URL http://, así que sin -x intenta la conexión directa y falla al resolver el nombre. El urllib de Python sí usa el proxy y recibe el 403.
Para que el agente alcance un servicio interno, añade su rango a SSRF_PROXY_ALLOW_PRIVATE_IPS. Desde la 1.17.1 esa variable también se aplica al proxy del agente, que antes la ignoraba. Para cortar la salida a internet no encontré ninguna variable en la 1.17.1: la plantilla de Squid termina en http_access allow all.
La interfaz de la edición comunitaria describe el aislamiento con claridad. El sandbox corre como usuario sin privilegios y con las capacidades por defecto de Docker. Landlock solo protege los ficheros del agente y de la sesión, y todos los procesos comparten el espacio de PID.
La documentación del agente[10] lo resume así: "the Agent runtime is not intended to provide a hardened security boundary between mutually untrusted users or workloads". Si vas a abrirlo a usuarios que no controlas, un sandbox de código como E2B, que Dify ya admite como backend, o una máquina aparte son mejores puntos de partida.
Preguntas frecuentes
¿Funciona Dify Agent con un modelo local sin GPU?
Funciona con límites. Con Qwen3.5-4B en 18 núcleos, las tres ejecuciones publicadas dieron cifras correctas con una mediana de 182 s. En cambio, ninguna de las tres sesiones en modo Build terminó con una respuesta, y una se inventó los datos. Para tareas abiertas, la lista de sugeridos de Dify apunta a modelos como GPT-5.5 o DeepSeek V4.
¿Por qué Dify dice que mi modelo es incompatible?
Porque su nombre coincide con una lista de expresiones regulares del frontend, que incluye qwen3.5, qwen2, gpt-4 y glm-4. La etiqueta no impidió ejecutar el agente, pero desactiva el panel de parámetros del modelo.
¿Puede el sandbox de Dify Agent acceder a mi red local?
Por defecto, no. Su proxy Squid devuelve 403 para las direcciones privadas, salvo las rutas /files/ de la API y /agent-stub/ del backend, y el backend además es accesible sin proxy. Para abrir un servicio interno, añade su rango a SSRF_PROXY_ALLOW_PRIVATE_IPS.
Conclusión
Dify Agent se autoaloja con el Compose de siempre y acepta un modelo local de Ollama con cinco campos bien puestos. Con un 4B en CPU sirve para tareas cortas y bien descritas, siempre que escribas tú el prompt y te fíes solo de las cifras que salen del código. Para que el agente construya su propia configuración, necesitas un modelo de la lista de sugeridos.
El siguiente paso es darle una skill escrita por ti: el patrón está en skills y subagentes. La versión en inglés está en Dify Agent with a local model.
Fuentes
Código fuente
Accede a todo el código fuente de este artículo en GitHub.
Ver en GitHub