Cómo migrar Langfuse autoalojado de v3 a v4
Índice de contenidos
- Puntos clave
- Qué cambia en Langfuse v4 y a quién afecta
- Por qué no debes actualizar con docker compose up --pull always
- Cómo he probado la migración
- Paso 0: llega a la última v3 y revisa las migraciones
- Paso 1: sube ClickHouse a 26.4 sin tocar Langfuse
- La trampa de la versión fijada en el compose de v4
- Paso 2: haz copia de PostgreSQL y ClickHouse
- Paso 3: arranca la v4 en modo de doble escritura
- Paso 4: comprueba la doble escritura con cada SDK
- Paso 5: rellena el histórico
- Paso 6: pasa a events_only
- Cómo volver a v3 si algo falla
- Cuánto disco recuperas al terminar
- Preguntas frecuentes
- ¿Puedo quedarme en Langfuse v3?
- ¿Puedo actualizar los SDK antes que el servidor?
- ¿Cuánto disco necesita el relleno del histórico?
- Conclusión
- Fuentes
Langfuse v4 cambia la tabla de la que lee las trazas, y pasar de v3 a v4 no se resuelve cambiando la etiqueta de la imagen. Esta guía explica la migración completa de una instalación con Docker Compose: primero ClickHouse, después el servidor en modo de doble escritura, el relleno del histórico y el corte final. La ejecuté entera el 16 de septiembre de 2026, de Langfuse v3.225.8 a v4.37.0, con datos de tres versiones del SDK de Python. Aquí están los tiempos, los errores y los detalles que la guía oficial no cuenta. Si todavía no conoces la herramienta, empieza por qué es Langfuse y cómo se despliega.
Puntos clave
- La v4 lee de una tabla nueva de ClickHouse,
events_full. Tras el corte al modo por defecto (events_only), el SDK de Python v2 recibe errores 400, y la guía lista 22 endpoints de la API pública que pasan a devolver 404. - La etiqueta
latesty eldocker-compose.ymldel repositorio ya apuntan a la v4, así quedocker compose up --pull alwayste sube de versión sin modo de transición. Fija las etiquetas antes de empezar. - El compose de v3 usaba ClickHouse sin etiqueta (hoy, la 26.8) y el de v4 fija la 25.12. Con datos que ya había abierto la 26.8, la 25.12 no arranca.
- Si tienes productores con el SDK de Python v3, activa
LANGFUSE_MIGRATION_V4_NATIVE_OTEL_BEHAVIOUR=dual_writedesde el primer arranque de v4. Sin esa variable, sus observaciones hijas quedan sin usuario ni sesión, y el relleno del histórico no lo corrige. - Con 45 931 trazas, el relleno tardó 3 min 5 s, y durante el proceso las tablas de trazas ocuparon 3,55 veces su tamaño inicial. Volver a v3 sin restaurar la copia funciona (
migrate goto 37tardó 2,4 s), pero lo escrito después del corte se pierde.
Qué cambia en Langfuse v4 y a quién afecta
Langfuse v4 guarda cada llamada al modelo, cada herramienta y cada paso del agente como una fila de events_full, una tabla ancha y casi inmutable. Cada fila lleva copiados los atributos de la traza: usuario, sesión y etiquetas. Una segunda tabla, events_core, es una proyección recortada que sirve las tablas y los gráficos, y cada traza pasa a ser la observación raíz de su árbol.
Según el artículo técnico de Langfuse[1], así se evitan las uniones y la deduplicación en cada lectura, y los paneles de proyectos grandes cargan "at least 10x" más rápido. Es una cifra del fabricante que no he medido.
Las fechas que importan son tres:
- 29 de julio de 2026: se publica Langfuse v4.0.0[2]
- 16 de noviembre de 2026: Langfuse Cloud pasa a ser solo v4, según el anuncio de la versión 4[3]
- Enero de 2027: último mes de parches de seguridad para la v3 autoalojada
La guía oficial de migración[4] lo dice así: "Langfuse v3 will receive security patches until end of January 2027". Si alojas Langfuse tú mismo, no hay fecha de corte obligatoria, pero la v3 ya solo recibe parches: la v3.225.8, del 16 de septiembre, trae tres correcciones portadas desde la v4.
Lo que se rompe depende de tus clientes. Esta es la matriz de compatibilidad[5] resumida para un servidor v4:
| Cliente | En un servidor v4 | Qué hacer |
|---|---|---|
| SDK de Python 4.7.0 o superior, JS/TS 5.4.0 o superior | Soporte completo, escritura directa | Nada |
| SDK de Python 4.0 a 4.6, JS/TS 5.0 a 5.3 | Funciona, con retraso durante la doble escritura | Subir al mínimo |
| SDK de Python v3, JS/TS v4 | Obsoleto | Migrar a Python v4 o JS/TS v5 |
| SDK de Python v2, JS/TS v3 | Sin soporte tras el corte | Migrar antes del corte |
| OpenTelemetry directo | Soporte completo | Enviar la cabecera x-langfuse-ingestion-version: 4 |
Tras el corte también dejan de funcionar los evaluadores con juez LLM asociados a la traza y la exportación "Traces and observations (legacy)" hacia almacenamiento, PostHog o Mixpanel. Si tus agentes ya usan OpenTelemetry con las convenciones GenAI, llevas la mitad del trabajo hecho.
Por qué no debes actualizar con docker compose up –pull always
La guía de despliegue con Docker Compose[6] resume la actualización en parar los contenedores y ejecutar docker compose up --pull always. Hoy esa orden te lleva a la v4 sin modo de transición, por tres cambios en el repositorio:
- Etiqueta
latest: desde el PR #15607[7], del 23 de julio, apunta a la línea v4. El 16 de septiembre,langfuse/langfuse:latesttenía el mismo resumen que4.37.0(sha256:06c0eaae…) - Etiqueta del compose: el
docker-compose.ymlde la rama principal usa:4, y el de la etiqueta v3.225.8[8] usa:3 - Registro: desde el PR #16265[9], del 12 de agosto, las imágenes se descargan de
docker.langfuse.comen vez dedocker.io
Si haces git pull en tu copia del repositorio y arrancas, entras directamente en events_only: el SDK v2 queda rechazado y el relleno del histórico empieza solo, sin que hayas comprobado la doble escritura.
El registro nuevo me dio otro problema: en esta máquina, docker.langfuse.com no resolvía, porque el DNS de la red devolvía ::.
Con un resolvedor público, el nombre es un alias de langfuse.docker.reo.dev, y la portada de Reo.Dev[10] cita a un cliente que valora que su producto "shows which developers are pulling Docker images". Un filtro DNS que bloquee ese dominio rompe la descarga. El proxy autentica contra Docker Hub y sirve el mismo resumen, así que puedes cambiar el registro por docker.io y la imagen es idéntica.
Cómo he probado la migración
Monté el stack con los docker-compose.yml oficiales de las etiquetas v3.225.8 y v4.37.0, más un fichero de sobrescritura con versiones fijas y puertos propios. Todo corrió en un contenedor de desarrollo linux/arm64 con 18 núcleos y 121 GB de RAM. La máquina estaba compartida con otras cargas, y la carga media osciló entre 2 y 73 durante la prueba, así que los tiempos son orientativos.
Estas son las versiones:
- Langfuse: v3.225.8, después v4.37.0 (web y worker)
- ClickHouse: 25.8.33.6, después 26.4.5.143
- Resto del stack: PostgreSQL 17, Redis 7 y la imagen de MinIO de Chainguard que trae el compose
- Herramientas: Docker 29.5.2 y Docker Compose v2.40.3
Con el servidor en v3 generé 45 931 trazas y 137 762 observaciones. De ellas, 40 000 trazas salieron del SDK de Python 2.60.10, 3598 del 3.15.0 y 2318 del 4.15.3. Con los dos SDK basados en OpenTelemetry lancé 10 000 trazas cada uno, pero mi bucle no vaciaba la cola y el SDK descartó el resto sin avisar.
En ClickHouse, esos datos ocupaban 81,2 MiB en la base default. El volumen entero ocupaba 1,7 GB, porque los registros del sistema pesan más que los datos. Es un conjunto pequeño, así que los tiempos del relleno no representan una instalación con millones de trazas.
Paso 0: llega a la última v3 y revisa las migraciones
La v4 borra tablas que la v3 dejó de usar, y la guía exige que todas las migraciones en segundo plano de v3 hayan terminado antes. Si alguna quedó a medias, los datos que no llegó a copiar se pierden. Actualiza primero a la última v3 (la v3.225.8 cuando escribo esto) y fija la etiqueta completa en vez de :3.
La guía propone una consulta que "must return zero rows". En una v3.225.8 sana, con el worker informando de que no quedaban migraciones, me devolvió estas cinco:
20260701_v4_step_1_create_root_spans_from_traces
20260701_v4_step_2_rewrite_observations_to_pid_tid_sorting
20260701_v4_step_3_backfill_events_full_from_observations
20260701_v4_step_4_backfill_events_full_from_dataset_run_items
20260701_v4_step_5_drop_pid_tid_sorting_tables
Son los pasos del relleno de v4, que la v3 ya registra y deja dormidos. No bloquean nada, y la consulta que te sirve los excluye:
docker compose exec -T postgres psql -U postgres -c "
  SELECT name, failed_at, failed_reason
  FROM background_migrations
  WHERE finished_at IS NULL
    AND name NOT LIKE '20260701_v4_%';"
Tiene que devolver cero filas. En la instalación nueva de mi prueba devolvió diez, porque el worker arrancó antes de que la web creara las tablas y su tanda de migraciones falló con The table public.background_migrations does not exist. El worker solo lo intenta al arrancar: un docker compose restart langfuse-worker las completó en menos de un segundo.
Paso 1: sube ClickHouse a 26.4 sin tocar Langfuse
La v4 exige ClickHouse 25.12 como mínimo y recomienda la 26.4, además de PostgreSQL 15 y Redis 7.0 o superiores. La v3 funciona con ClickHouse 24.3 o posterior, según la página de ClickHouse de Langfuse[11], así que puedes subir ClickHouse con la v3 en marcha y quedarte así el tiempo que quieras. Fija la versión en un fichero de sobrescritura, junto al compose:
services:
  clickhouse:
    image: docker.io/clickhouse/clickhouse-server:26.4
Después recrea solo ese servicio con docker compose up -d clickhouse; Compose lee docker-compose.override.yml sin que se lo indiques. En mi prueba, ClickHouse pasó de 25.8.33.6 a 26.4.5.143 y volvió a estar sano en 7,4 s. La v3 siguió recibiendo datos: 20 trazas nuevas del SDK v2 aparecieron en la API, y el listado de trazas respondió en 0,18 s.
La guía añade una lista de permisos para el usuario de ClickHouse. Con el compose oficial no hace falta, porque el usuario que crea la imagen ya tenía ALTER, CREATE, DROP y SYSTEM sobre todas las bases, según SHOW GRANTS. Si usas un ClickHouse externo con un usuario restringido, concede esos permisos antes del paso 3.
Reserva también disco para el paso 5. La guía pide margen para "roughly 3x" el volumen actual de ClickHouse, y en mi prueba las tablas de trazas llegaron a 3,55 veces su tamaño antes de limpiar.
La trampa de la versión fijada en el compose de v4
No dejes que el compose nuevo baje la versión de ClickHouse. El de v3 usaba la imagen sin etiqueta, que el 16 de septiembre era la 26.8.5, y el de v4 fija la 25.12. Probé tres combinaciones sobre una copia de mis datos:
| Datos abiertos antes por | Arranque con | Resultado |
|---|---|---|
| 26.4 | 25.12 | Arranca y lee las 45 931 trazas |
| 26.8 | 26.4 | Arranca |
| 26.8 | 25.12 | Se detiene con el código 210 |
El error aparece en las tablas de registro del sistema que la 26.8 había creado, no en las de Langfuse:
Code: 115. DB::Exception: Unknown setting 'table_readonly':
for storage MergeTree: Cannot attach table `system`.`text_log_1`
La documentación de ClickHouse sobre actualizaciones[12] avisa de que solo puedes volver a una versión anterior "if you have not started to use any of the new features". Si ya ejecutas la 26.8, fija la 26.8 en tu sobrescritura en vez de heredar la 25.12 del compose.
Paso 2: haz copia de PostgreSQL y ClickHouse
No hay vuelta automática a v3 una vez aplicadas las migraciones de v4, así que la copia va justo antes del cambio de servidor. Para PostgreSQL, un volcado es suficiente; en mi instalación ocupó 312 KB, porque ahí solo viven la configuración, los usuarios y los prompts:
docker compose exec -T postgres \
  pg_dump -U postgres -Fc postgres > langfuse-pg.dump
ClickHouse guarda las trazas. En una sola máquina, la forma más directa es parar la web, el worker y ClickHouse y empaquetar el volumen:
docker compose stop langfuse-web langfuse-worker clickhouse
docker run --rm -v langfuse_langfuse_clickhouse_data:/src:ro \
  -v "$PWD":/dst alpine \
  tar czf /dst/clickhouse-data.tgz -C /src .
docker compose start clickhouse
El nombre del volumen empieza por el nombre de tu proyecto de Compose; compruébalo con docker volume ls. Parar y empaquetar los 1,7 GB del volumen tardó 70,5 s y dejó un fichero de 934 MB. Guarda los dos ficheros fuera de la máquina, por ejemplo con restic y un repositorio cifrado.
Paso 3: arranca la v4 en modo de doble escritura
El modo dual escribe cada evento en las tablas viejas y en las nuevas, así que todo lo de v3 sigue funcionando mientras migras los clientes. Las variables de la migración no aparecen en el docker-compose.yml oficial, y Compose solo pasa al contenedor las variables que el fichero declara: si las pones en .env, no llegan. Añádelas a los dos servicios en la sobrescritura:
x-migracion-v4: &migracion-v4
  LANGFUSE_MIGRATION_V4_WRITE_MODE: dual
  LANGFUSE_MIGRATION_V4_NATIVE_OTEL_BEHAVIOUR: dual_write
  LANGFUSE_MIGRATION_V4_ALLOW_PREVIEW_OPT_IN: "false"
  LANGFUSE_BACKGROUND_MIGRATION_V4_ENABLE_HISTORIC_BACKFILL: "false"

services:
  langfuse-worker:
    image: docker.io/langfuse/langfuse-worker:4.37.0
    environment: *migracion-v4
  langfuse-web:
    image: docker.io/langfuse/langfuse:4.37.0
    environment: *migracion-v4
  clickhouse:
    image: docker.io/clickhouse/clickhouse-server:26.4
Cada variable controla una parte de la transición:
LANGFUSE_MIGRATION_V4_WRITE_MODE:dualescribe en las dos familias de tablas;legacyconserva el comportamiento completo de v3LANGFUSE_MIGRATION_V4_NATIVE_OTEL_BEHAVIOUR:dual_writehace pasar las trazas de OpenTelemetry sin la cabecera de v4 por la tubería que copia los atributos de la trazaLANGFUSE_MIGRATION_V4_ALLOW_PREVIEW_OPT_IN: confalse, todos siguen viendo la interfaz de v3 y la API v2 no respondeLANGFUSE_BACKGROUND_MIGRATION_V4_ENABLE_HISTORIC_BACKFILL: confalse, el relleno espera a que tú lo actives
La última es la que más importa. El relleno se ejecuta una sola vez, y lo que entre entre su final y el inicio de la doble escritura no llega nunca a las tablas nuevas.
Con el compose nuevo y la sobrescritura, arranca con docker compose up -d. La web respondió {"status":"OK","version":"4.37.0"} a los 10,7 s. En ese tiempo aplicó 14 migraciones de PostgreSQL, entre ellas drop_legacy_tracing_tables, y 12 de ClickHouse, de la versión 38 a la 49.
Las 12 de ClickHouse crean events_full, events_core y la tabla de preparación observations_batch_staging, y borran event_log, project_environments y dataset_run_items. Con la vista previa desactivada, los endpoints de v3 seguían respondiendo 200, y GET /api/public/v2/observations devolvía 404 con el aviso "The observations v2 API is only available in a Langfuse v4 write mode".
Paso 4: comprueba la doble escritura con cada SDK
Cada generación del SDK llega a events_full por un camino distinto, y conviene verlo con tus datos antes de seguir. Envié 50 trazas con cada SDK y anoté cuándo aparecían en la tabla nueva y si las observaciones hijas llevaban usuario y sesión:
| SDK de Python | Tablas de v3 | events_full |
Usuario en las hijas |
|---|---|---|---|
| 2.60.10 | Al instante | A los 11 min | Sí |
3.15.0 sin dual_write |
Al instante | Al instante | No |
3.15.0 con dual_write |
Al instante | A los 8,5 min | Sí |
| 4.15.3 | Al instante | Al instante | Sí |
La segunda fila es la trampa. Sin LANGFUSE_MIGRATION_V4_NATIVE_OTEL_BEHAVIOUR, el valor por defecto es direct, y los spans del SDK v3 se escriben tal cual en events_full. Ese SDK solo pone usuario, sesión y etiquetas en el span raíz, así que las 100 observaciones hijas quedaron sin ellos, y un filtro por usuario en la vista nueva no las encuentra.
El relleno del paso 5 tampoco las corrigió. Con dual_write, las trazas del mismo SDK pasaron por la tabla de preparación y salieron completas, con una fila raíz virtual encima de cada una.
El retraso tiene una causa concreta. El trabajo de propagación se ejecuta cada minuto y solo procesa particiones con más de 10 minutos de antigüedad, según el valor por defecto de LANGFUSE_EXPERIMENT_EVENT_PROPAGATION_PARTITION_DELAY_MINUTES en el código de la v4.37.0. La guía habla de unos 15 minutos.
Para vigilar la propagación, el worker responde en su puerto 3030 a GET /api/health?failIfEventPropagationStuck=true, que devuelve 503 si el trabajo lleva demasiado tiempo sin ejecutarse. La guía dice que el umbral por defecto son 15 minutos, pero la v4.37.0 respondía "thresholdSeconds":2100 (35 minutos), y ese es el valor fijado en su código. Un comentario en ese código pide que la sonda espere al menos 60 s antes de la primera comprobación.
Paso 5: rellena el histórico
El relleno copia a events_full todo lo que entró antes de la doble escritura, y solo debes activarlo cuando el paso 4 esté verificado. Cambia LANGFUSE_BACKGROUND_MIGRATION_V4_ENABLE_HISTORIC_BACKFILL a "true" y vuelve a ejecutar docker compose up -d. El worker encadena cuatro migraciones en segundo plano:
- Crea una observación raíz virtual por cada traza, con el identificador
t-seguido del de la traza - Reescribe las observaciones en una tabla intermedia,
observations_pid_tid_sorting, ordenada para la unión siguiente - Une esa tabla con las trazas y escribe las observaciones hijas en
events_full - Añade los metadatos de experimentos a los spans que los necesitan
Con mis 45 931 trazas, la cadena tardó 3 min 5 s, de las 16:11:57 a las 16:15:02 UTC. Cada paso terminó casi al minuto exacto del anterior, así que ese tiempo mide la cadencia del worker. La copia en sí fue más breve: los datos del paso 1 ya estaban en disco a los 7 s.
Al final, events_full tenía 185 623 filas, 46 201 de ellas raíces virtuales. Las 120 000 observaciones del SDK v2 recibieron usuario y sesión, pero los metadatos de la traza se quedaron solo en la raíz virtual, como la guía advierte.
El disco es lo que tienes que vigilar:
| Momento | Tamaño en ClickHouse |
|---|---|
Tablas traces y observations antes del relleno |
49,9 MiB |
Tablas nuevas events_full y events_core |
93,8 MiB |
Tabla intermedia observations_pid_tid_sorting |
33,1 MiB |
Base default antes y en el pico |
82,3 MiB y 208,6 MiB |
Sumando tablas viejas, nuevas e intermedia, las trazas pasaron de ocupar 49,9 MiB a 176,8 MiB, 3,55 veces su tamaño inicial, algo por encima del "roughly 3x" de la guía. Los datos sintéticos se comprimen distinto que los reales, así que toma la proporción como propia de estos datos y deja más margen del que pide la guía.
Paso 6: pasa a events_only
El corte es el punto sin retorno: a partir de aquí, los datos nuevos solo se escriben en las tablas de v4. Antes, migra todo lo que envía datos a Langfuse o los lee:
- Productores: el SDK de Python a la 4.7.0 o superior, donde
update_current_trace()pasa a serpropagate_attributes()según la guía de migración del SDK[13] - Lectores de la API: a Observations API v2, Metrics API v2 y Scores API v3
- Evaluadores: de la traza a la observación
- Exportaciones: a la fuente "Enriched observations"
Después, quita las variables LANGFUSE_MIGRATION_V4_* de la sobrescritura y vuelve a ejecutar docker compose up -d. La web y el worker estuvieron de vuelta en 17,9 s.
Esto es lo que vi justo después del corte, con 20 trazas por SDK:
- SDK de Python 2.60.10: imprimió 140 veces "Bad request. Please check your request for any missing or incorrect parameters", una por evento, y terminó con código 0. No se guardó nada
- SDK de Python 3.15.0: se guardó, pero las observaciones hijas volvieron a quedar sin las etiquetas de la traza
- SDK de Python 4.15.3: se guardó completo
GET /api/public/traces,observations,sessionsymetrics/daily: 404, con el mensaje "This endpoint is not available on deployments running in Langfuse v4 events_only mode"POST /api/public/ingestion: 207, con 201 para elscore-createy 400 para eltrace-createGET /api/public/v2/observations?traceId=…: 200 en 16 ms, con las cuatro filas de una traza antigua del SDK v2 (la raíz virtual y sus tres hijas)
La respuesta 400 del servidor explica el problema y hasta propone volver a dual como puente, pero el SDK v2 no muestra ese texto. Si una aplicación antigua se te escapa, lo único que verás son esas líneas genéricas en su registro, sin fallo del proceso. Revisa los registros de cada productor tras el corte.
La combinación de variables también se valida, aunque en mi prueba solo lo hizo el worker. Con events_only y LANGFUSE_MIGRATION_V4_ALLOW_PREVIEW_OPT_IN=false, el worker salió con código 1 y el mensaje Invalid V4 config: LANGFUSE_MIGRATION_V4_WRITE_MODE=events_only requires LANGFUSE_MIGRATION_V4_ALLOW_PREVIEW_OPT_IN=true, mientras la web arrancaba sin quejarse.
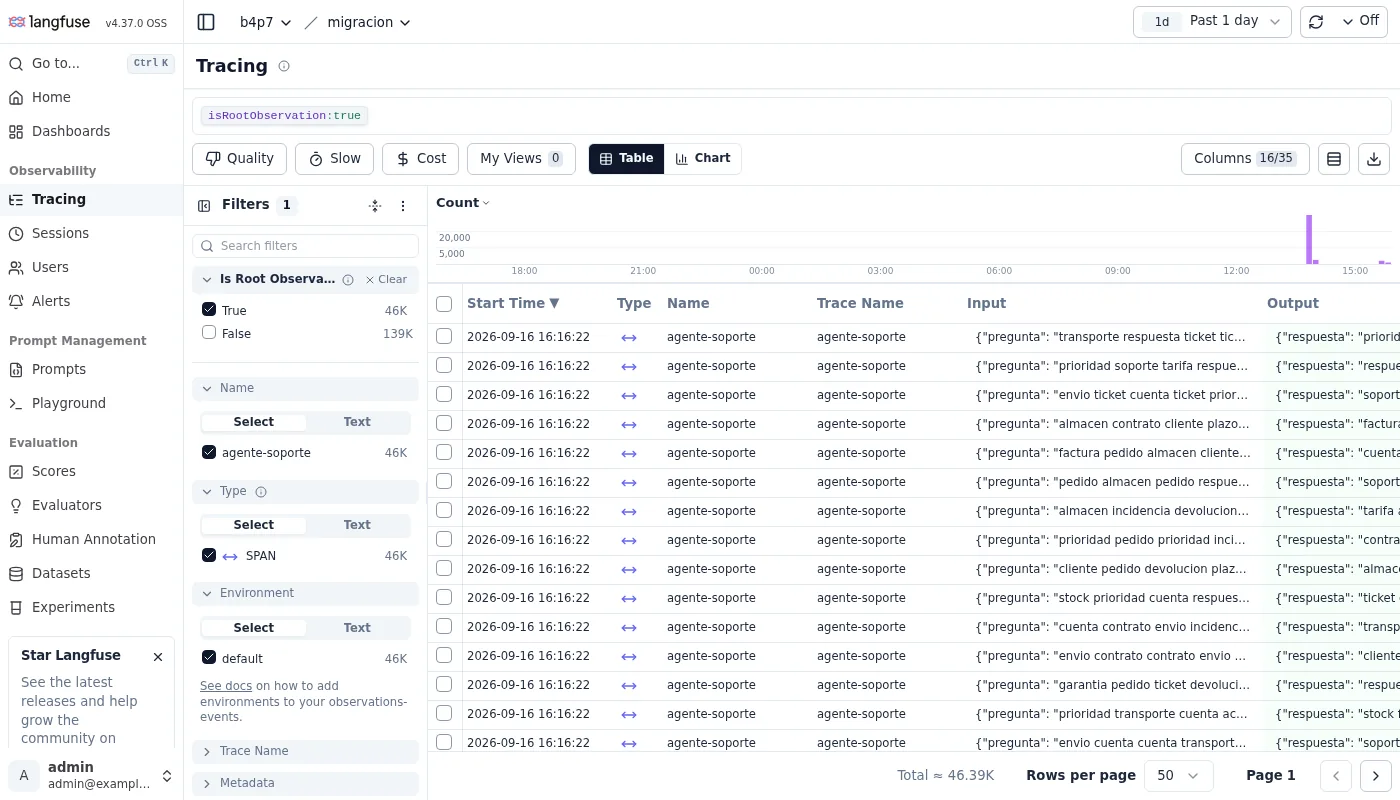
Tras el corte, la vista de trazas abre filtrada por isRootObservation:true, que en mi instalación mostraba 46 000 raíces frente a 139 000 observaciones hijas.
Cómo volver a v3 si algo falla
Mientras sigas en dual o legacy, puedes volver a v3 sin restaurar la copia, aunque no basta con cambiar la etiqueta de la imagen. Lo probé con la v4 en dual: la web de v3.225.8 entró en bucle de reinicios con error: no migration found for version 49. La guía cita la versión 46; el número es el de la última migración de ClickHouse que aplicó tu v4, así que variará.
El arreglo es rebobinar el esquema de ClickHouse con el binario migrate que trae la imagen web de v4, desde un contenedor de la misma versión que tienes desplegada:
docker compose exec langfuse-web sh -c '
cd /app/packages/shared && migrate \
  -source file://clickhouse/migrations/unclustered \
  -database "${CLICKHOUSE_MIGRATION_URL}?username=${CLICKHOUSE_USER}\
&password=${CLICKHOUSE_PASSWORD}&database=default\
&x-multi-statement=true&x-migrations-table-engine=MergeTree" \
  goto 37'
La orden deshizo las 12 migraciones en 2,4 s: borró las tablas de v4 y recreó event_log, project_environments y dataset_run_items. Con las imágenes de v3.225.8, la web arrancó en 16,7 s sobre el esquema de PostgreSQL de v4, mostró las 46 201 trazas y volvió a aceptar el SDK v2.
Lo hice después del corte, a propósito, para ver qué se pierde. Las trazas enviadas en modo dual estaban todas; las 20 enviadas con el SDK v4 después del corte no aparecían, porque solo existían en events_full. Por eso el corte es el punto de compromiso, y a partir de ahí la única vuelta atrás es la copia del paso 2.
Cuánto disco recuperas al terminar
La limpieza tiene dos partes, y las dos son opcionales. La primera es la tabla intermedia: con LANGFUSE_BACKGROUND_MIGRATION_V4_DROP_PID_TID_SORTING_TABLES a "true", el worker la borró al arrancar, y la base bajó de 208,6 a 175,7 MiB.
La segunda son las tablas traces y observations, que tras el corte ya no reciben escrituras ni lecturas. La guía pide vaciarlas con TRUNCATE TABLE en vez de borrarlas, porque Langfuse espera que existan. En mi caso liberaría otros 49,9 MiB, pero también eliminaría la única fuente para repetir el relleno y la vuelta a v3 del apartado anterior. Déjalas unas semanas y vacíalas cuando hayas comprobado el histórico en la vista nueva.
Preguntas frecuentes
¿Puedo quedarme en Langfuse v3?
Hasta final de enero de 2027, con parches de seguridad y sin funciones nuevas. Si además usas Langfuse Cloud, esa parte pasa a ser solo v4 el 16 de noviembre de 2026, así que tus SDK tendrán que estar actualizados antes de esa fecha de todas formas.
¿Puedo actualizar los SDK antes que el servidor?
Sí. El SDK de Python 4.15.3 envió trazas a mi servidor v3.225.8 sin errores, y la guía confirma que Python v4 y JS/TS v5 funcionan con servidores v3. La excepción son langfuse.api.observations y langfuse.api.metrics, que en el SDK v4 apuntan a las API v2; contra un servidor v3 usa langfuse.api.legacy.observations_v1.
¿Cuánto disco necesita el relleno del histórico?
En mi prueba, las tablas de trazas llegaron a 3,55 veces su tamaño inicial antes de borrar la tabla intermedia, y a 2,88 veces después. Calcula el margen sobre el tamaño de traces y observations en system.parts, no sobre el volumen entero de ClickHouse, que incluye los registros del sistema.
Conclusión
Migrar Langfuse de v3 a v4 lleva seis pasos, y ninguno exige parar el servicio más de un minuto, salvo la copia del volumen. Los riesgos están en lo que la documentación no dice. El compose y la etiqueta latest ya apuntan a v4, y el compose nuevo puede bajarte ClickHouse de versión. Además, las trazas del SDK v3 pierden sus atributos si no activas dual_write desde el principio.
Mi recomendación es fijar versiones, pasar un par de días en dual revisando qué productores siguen con SDK antiguos y cortar solo cuando los registros de todos estén limpios. Con la v4 funcionando, repasa qué instrumentar primero en tus agentes para sacar partido a las observaciones por fila.
La versión en inglés de esta guía está en How to migrate self-hosted Langfuse from v3 to v4.
Fuentes
- artículo técnico de Langfuse
- Langfuse v4.0.0
- anuncio de la versión 4
- guía oficial de migración
- matriz de compatibilidad
- guía de despliegue con Docker Compose
- PR #15607
- etiqueta v3.225.8
- PR #16265
- Reo.Dev
- página de ClickHouse de Langfuse
- documentación de ClickHouse sobre actualizaciones
- guía de migración del SDK
Código fuente
Accede a todo el código fuente de este artículo en GitHub.
Ver en GitHub