
Firecrawl: datos web para agentes
Sobre este vídeo
Si escribes tu propio crawler: robots.txt, una cola por host y 304 Not Modified hacen que la opción cortés sea también la barata.
Firecrawl es una API de código abierto que convierte cualquier página web en Markdown limpio y listo para un modelo de lenguaje. Con endpoints de scrape y crawl y extracción estructurada a JSON, da a tu agente de IA datos web fiables. Esta guía cubre sus formatos, cómo alojarlo con Docker y cuándo compensa frente a un scraper propio.
Transcripción del vídeo
- 0:02 Primero pedimos robots.txt y lo respetamos:
- 0:06 las rutas prohibidas ni se piden.
- 0:09 Una cola por host, a dos peticiones por segundo, con un User-Agent honesto.
- 0:15 La primera descarga baja 142 KB y guarda los validadores junto al documento.
- 0:21 Al volver, la petición lleva el validador guardado y pregunta si algo ha cambiado.
- 0:27 Si no ha cambiado, el servidor responde 304 Not Modified:
- 0:32 cero KB, nada que volver a procesar.
- 0:36 Las revisitas desperdiciadas bajan de 375 a 59.
- 0:42 La opción cortés y la barata son la misma.
Más vídeos
Explicación
El bucle agéntico y el patrón ReAct
El bucle agéntico (razonar, actuar, observar) en movimiento.
Explicación
Cómo instalar SearXNG con Docker
Un uso de la instancia propia: un agente de IA que encuentra sus propias fuentes consultando SearXNG, sin pagar por búsqueda.
Explicación
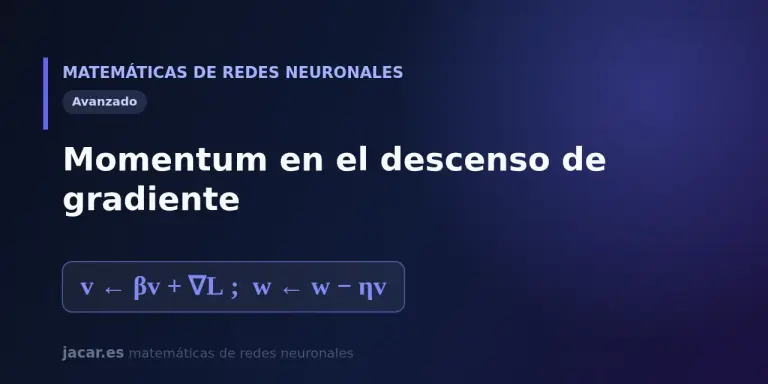
El momentum en el descenso de gradiente
Cómo el momentum acumula velocidad y suaviza el descenso de gradiente.
Explicación
El grafo computacional y la diferenciación automática
El grafo computacional y la diferenciación automática, en acción.
Explicación
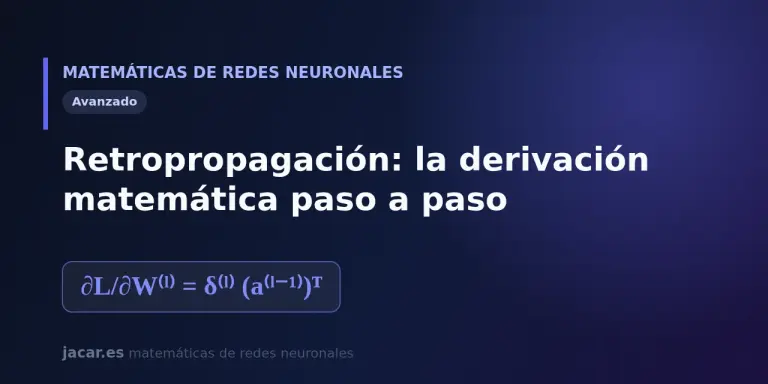
Retropropagación, la derivación matemática paso a paso
La derivación de la retropropagación, factor a factor con la regla de la cadena.
Explicación
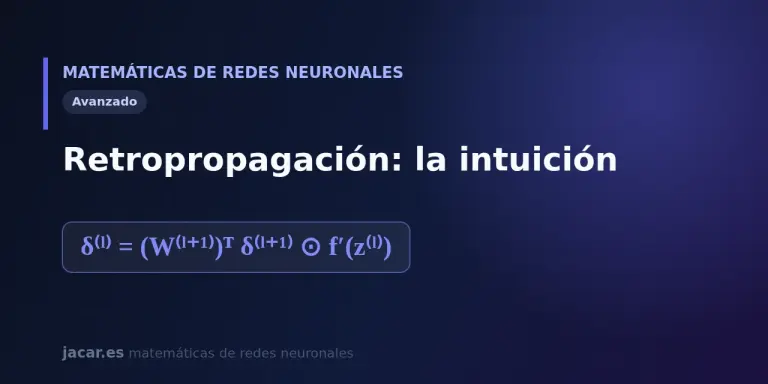
Retropropagación, la intuición detrás del aprendizaje
La intuición de la retropropagación: el error fluye hacia atrás por la red.