Clef en Ollama: clasifica tickets con probabilidades en lugar de texto
Índice de contenidos
- Puntos clave
- Qué es un modelo de decisión y en qué se diferencia de un LLM
- Cómo ejecutar Clef-flash en Ollama con Docker
- Cómo clasificar un ticket con una pregunta choice
- Cuánto acierta Clef-flash con 24 tickets reales
- Cómo puntuar con score y preguntar sobre imágenes
- Cuándo usar un modelo de decisión en lugar de un LLM
- Preguntas frecuentes
- ¿Puedo usar Clef con la API de chat de Ollama?
- ¿Clef o Clef-flash?
- ¿Funciona en un Mac con Apple Silicon?
- Conclusión
- Fuentes
Clef y Clef-flash son modelos de decisión: reciben un texto y unas preguntas con respuestas cerradas, y devuelven la respuesta elegida con la probabilidad de cada opción, sin generar texto. Cloudflare los publicó el 1 de octubre de 2026 con licencia Apache 2.0, y Ollama 0.35.1 los sirve en tu propia máquina a través de /v1/systemone. Los he probado en Docker sobre una máquina arm64 sin GPU clasificando 24 tickets de soporte, puntuando el enfado de un cliente y preguntando por dos imágenes. Esto es lo que salió. También tienes la versión en inglés.
Puntos clave
- Un modelo de decisión, en palabras de Cloudflare, "makes classifications to help agents decide how to act, based on certain probabilities". No escribe una respuesta: puntúa las opciones que le das.
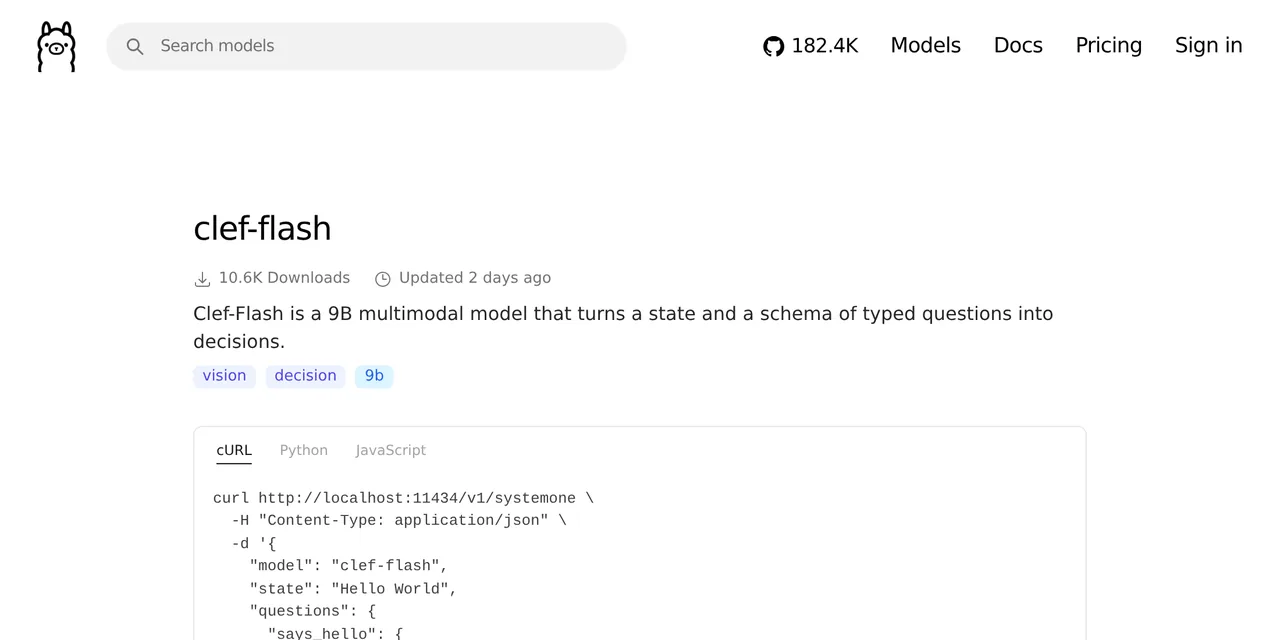
- Clef tiene 27 000 millones de parámetros y Clef-flash 9100 millones; los dos parten de Qwen y aceptan imágenes. En Ollama,
clef-flashpesa 10 GB en Q8_0 y ocupó 14 GB al cargarse con 16k de contexto. - La API admite tres tipos de pregunta:
choice(elegir una opción),noul(probabilidad de que algo sea cierto) yscore(una puntuación sobre una escala ordenada). - Clef-flash acertó 23 de 24 tickets en español e inglés, con las mismas respuestas en dos ejecuciones. El fallo tuvo una confianza de 0,37; el resto estuvo por encima de 0,57.
- Con imágenes, respondió 0,93 a "¿muestra la configuración de un servidor MCP?" para una captura que sí lo hacía y 0,02 para un gráfico de barras.
Qué es un modelo de decisión y en qué se diferencia de un LLM
Un modelo de decisión resuelve el mismo problema que pides a un LLM cuando le dices "responde solo con una de estas etiquetas", pero sin generar texto. Lee el estado y las preguntas de una pasada y asigna una probabilidad a cada respuesta permitida.
La diferencia práctica está en lo que recibes. Con un LLM obtienes una etiqueta en texto que tienes que validar, y a veces otra cosa. Con Clef obtienes un JSON con la etiqueta, la probabilidad de cada alternativa y una confianza, así que puedes fijar un umbral y mandar a una persona los casos dudosos. En mi prueba, el campo output_tokens de la respuesta fue 0 o 1 en todas las llamadas.
Según el anuncio de Cloudflare[1], firmado por Michelle Chen, Clef usa una red troncal de Qwen de 27B y Clef-flash una de 9B, con 64k de contexto. Cloudflare publica una mediana de 38,8 ms por decisión para Clef-flash en su infraestructura; en una CPU, como verás, la cuenta es otra.
Cómo ejecutar Clef-flash en Ollama con Docker
Necesitas Ollama 0.35.1 o posterior: la 0.35.0 añadió /v1/systemone y la 0.35.1, los modelos Clef. Si es la primera vez que usas Ollama, empieza por instalar Ollama. Con Docker, levanta el contenedor y descarga el modelo:
docker run -d --name ollama -p 11434:11434 \
  -v ollama:/root/.ollama ollama/ollama:0.35.1
docker exec ollama ollama pull clef-flash
docker exec ollama ollama show clef-flash
La descarga tardó 1 minuto y 53 segundos para 10 GB. ollama show confirma que es un modelo qwen35 de 9,1B en Q8_0 con un proyector de visión, y que su única capacidad es decision, así que Ollama no lo ofrece para chat.
Cómo clasificar un ticket con una pregunta choice
Una petición tiene un state (el texto que se evalúa) y un mapa de questions. Esta clasifica un ticket en cuatro etiquetas y, en la misma llamada, pregunta si el cliente está bloqueado:
curl -s http://localhost:11434/v1/systemone -d '{
  "model": "clef-flash",
  "state": "Al pulsar Exportar a PDF la aplicación se cierra",
  "questions": {
    "label": {
      "type": "choice",
      "instructions": "¿Qué etiqueta corresponde al ticket?",
      "criteria": {
        "facturacion": "Cobros, facturas y reembolsos",
        "cuenta": "Acceso, contraseñas y usuarios",
        "error": "Fallos del software",
        "peticion": "Ideas y funciones nuevas"
      }
    },
    "urgent": {
      "type": "noul",
      "instructions": "¿El cliente no puede trabajar?"
    }
  }
}'
La respuesta trae, para label, la opción elegida (error), la probabilidad de cada etiqueta (0,981 para error) y una confidence de 0,918. Para urgent devuelve un único número, la probabilidad de que la condición se cumpla: 0,401 en este caso. Las descripciones de cada etiqueta en criteria importan, porque el modelo puntúa el texto contra ellas.
Cuánto acierta Clef-flash con 24 tickets reales
Preparé 24 tickets cortos, 18 en español y 6 en inglés, seis por cada etiqueta, con la respuesta correcta anotada a mano. Los pasé dos veces por Clef-flash con la petición anterior:
| Resultado | Valor |
|---|---|
| Aciertos | 23 de 24 (95,8 %) |
| Respuestas iguales entre las dos ejecuciones | 24 de 24 |
| Confianza del único fallo | 0,37 |
| Confianza más baja entre los aciertos | 0,579 |
| Tokens de entrada por ticket | 308 a 322 |
El fallo fue "My card was declined but the money left my bank", que esperaba en facturacion y el modelo puso en error con una probabilidad de 0,611. Es el caso ambiguo del lote: habla de un cobro, pero describe un fallo. Con un umbral de confianza de 0,5, ese ticket habría ido a revisión humana y los otros 23 se habrían etiquetado solos, todos bien.
La pregunta noul de urgencia dio valores razonables sin ajustar nada. Puntuó 0,793 "no puedo entrar" y "la app se cierra al arrancar en iOS", y 0,004 la petición de modo oscuro.
No doy tiempos por petición. La máquina, una arm64 de 18 núcleos sin GPU, ejecutaba otros trabajos a la vez, y cualquier latencia estaría contaminada. Como orden de lo que esperar, en CPU se mide en segundos por ticket, no en los 38,8 ms que Cloudflare publica para su infraestructura.
Cómo puntuar con score y preguntar sobre imágenes
Las preguntas score reciben los criterios como una lista ordenada, no como un mapa. Si pasas un objeto, Ollama responde score criteria must be an array. Para medir el enfado de un cliente usé cinco niveles:
"tono": {
  "type": "score",
  "instructions": "¿Cuál es el grado de enfado del cliente?",
  "criteria": ["Tranquilo", "Algo molesto", "Molesto",
               "Muy molesto", "Furioso"]
}
Para "Llevo tres días sin poder facturar y nadie contesta. Es inaceptable.", la respuesta fue una puntuación de 3,45 sobre una escala de 0 a 4, con un 60,4 % de probabilidad para "Furioso" y un 30,1 % para el nivel anterior.
Las imágenes van en base64 en el campo images, junto al state. Probé dos: una captura de la tarjeta MCP de Home Assistant y un gráfico de barras. A "¿la imagen muestra la configuración de un servidor Model Context Protocol?" respondió 0,928 y 0,017; a "¿la imagen es un gráfico de barras?", 0,005 y 0,936. Cada imagen subió la entrada de unos 310 a 956 tokens.
Cuándo usar un modelo de decisión en lugar de un LLM
Un modelo de decisión encaja cuando la salida es una de N opciones conocidas y te importa saber cuánto se fía el modelo:
- Triaje: tickets, correos, alertas o incidencias que van a una cola concreta
- Enrutado de agentes: decidir qué herramienta o qué modelo atiende una petición
- Moderación y filtros: probabilidades sí o no con un umbral que tú controlas
Si necesitas que el modelo redacte, extraiga campos libres o encadene llamadas a herramientas, sigue necesitando un LLM con llamadas a funciones en Ollama. Los dos se combinan bien: el modelo de decisión clasifica y solo los casos que lo necesitan pasan al LLM.
Preguntas frecuentes
¿Puedo usar Clef con la API de chat de Ollama?
No. ollama show lista decision como su única capacidad, y Ollama no lo ofrece para chat, herramientas ni razonamiento. Se usa solo con /v1/systemone.
¿Clef o Clef-flash?
Clef-flash (9B) cabe en 14 GB de memoria con 16k de contexto y es el que he probado. Clef (27B) promete más precisión en las pruebas de Cloudflare, pero necesita unas tres veces más memoria.
¿Funciona en un Mac con Apple Silicon?
Ollama 0.40, publicado el 25 de septiembre de 2026, incluye clef y clef-flash entre los modelos que ejecuta con MLX en Apple Silicon. En esta prueba usé Linux y CPU.
Conclusión
Clef-flash hace una cosa y la hace con números: elige entre las opciones que le das y te dice cuánto se fía. En mi lote acertó 23 de 24 tickets y repitió las mismas respuestas en dos pasadas. Además, señaló su único error con la confianza más baja, que es lo que necesitas para automatizar con un umbral.
El siguiente paso es tomar 50 tickets reales de tu cola, anotarlos a mano y ajustar el umbral de confianza antes de dejarlo clasificar solo.
Fuentes: [1] Introducing Clef, blog de Cloudflare[1], [2] Ollama v0.35.0, modelos de decisión[2], [3] Ollama v0.35.1, modelos Clef[3], [4] cloudflare/clef-flash en Hugging Face[4], [5] clef-flash en la biblioteca de Ollama[5], [6] Ollama v0.40.0[6].