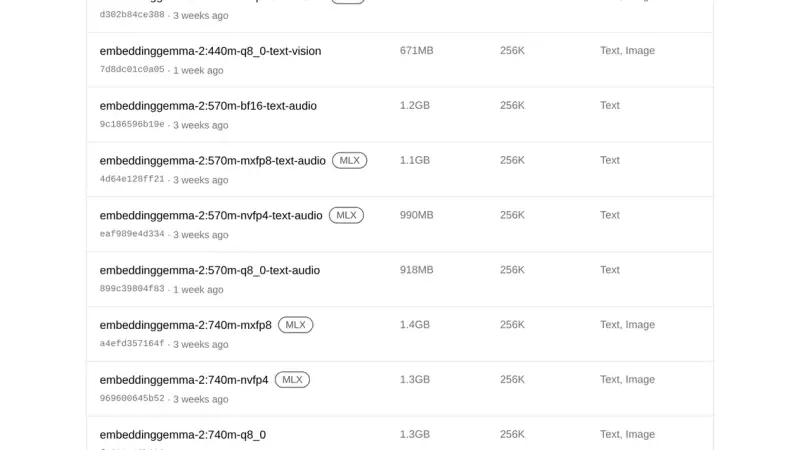
Ollama muestra this model requires MLX support, but the MLX runtime is not available cuando descargas una etiqueta que solo existe en safetensors para MLX, como embeddinggemma-2:740m-bf16 o phonon, en un equipo sin MLX: Linux arm64, Linux sin GPU de NVIDIA o Windows. Descarga la variante GGUF (q8_0) con Ollama 0.40.4 o posterior.
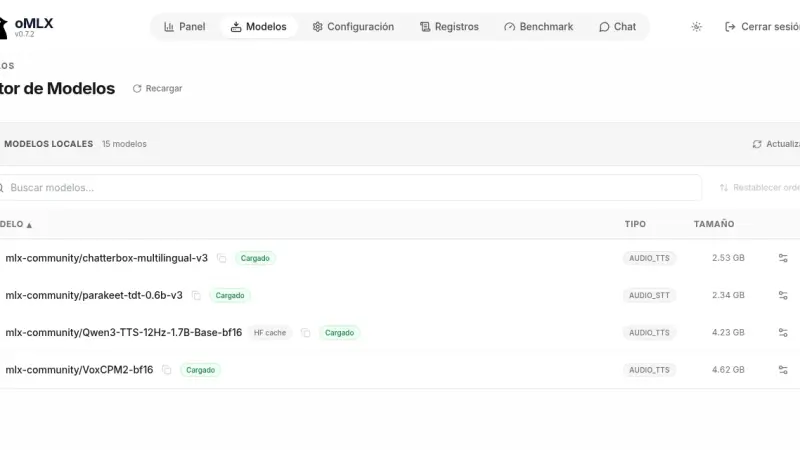
oMLX sirve modelos de texto a voz (TTS) en un Mac con Apple Silicon con la misma API que OpenAI. Con POST /v1/audio/speech pides audio con una voz predefinida, una voz descrita en lenguaje natural o una voz clonada desde unos segundos de referencia. En un M5 Max, Qwen3-TTS 1.7B genera cada segundo de audio en 0,33 s.
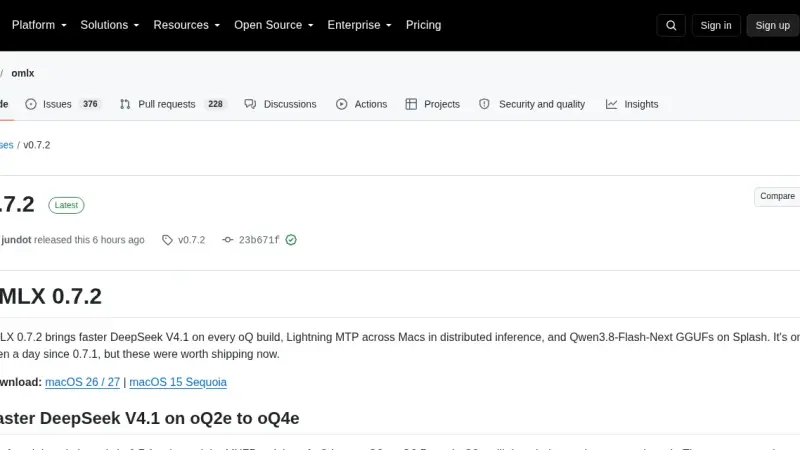
oMLX 0.7.2, publicado el 21 de octubre de 2026, un día después de la 0.7.1, acelera DeepSeek V4.1 en los cuantizados oQ2e a oQ4e, activa Lightning MTP en clústeres de dos o más Mac, ejecuta en Splash los GGUF de Qwen3.8-Flash-Next y deja de repetir el prefill entero en cada turno de Claude Code. Se actualiza desde la app, Homebrew o el código fuente.
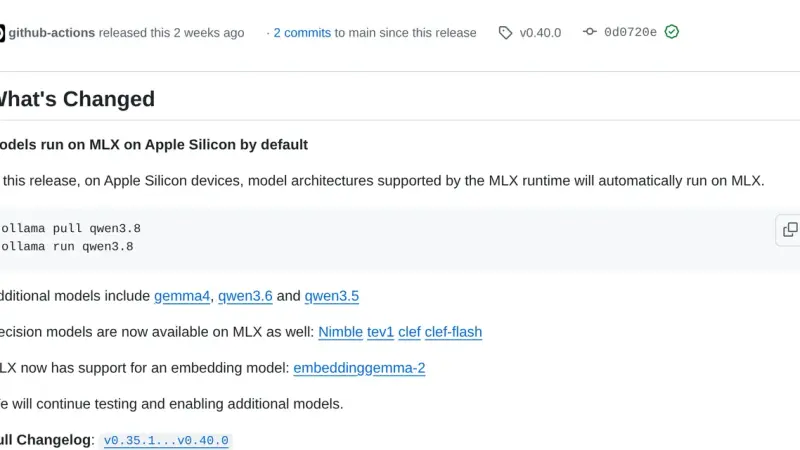
Desde Ollama 0.40, publicado el 25 de septiembre de 2026, los modelos con arquitectura compatible se ejecutan con MLX en los Mac con Apple Silicon en lugar de con llama.cpp. Ollama elige la variante del modelo al descargarlo y el comando ollama ps muestra en la columna RUNNER qué motor la sirve. En Linux y Windows sigue mandando llama.cpp.
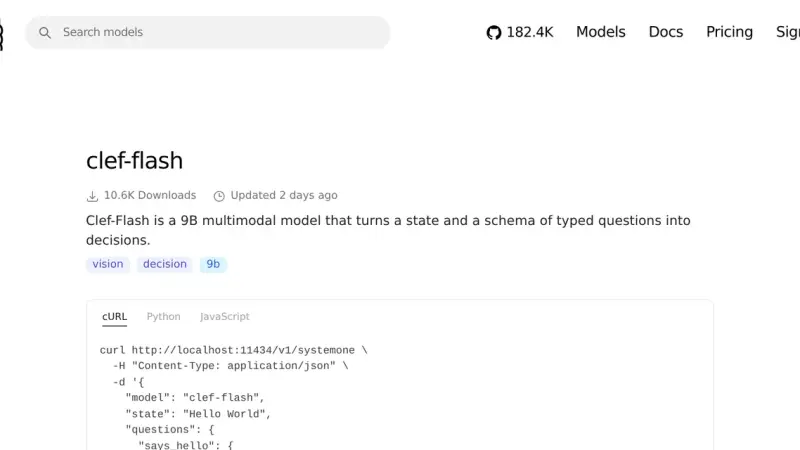
Clef y Clef-flash son los modelos de decisión abiertos que Cloudflare publicó el 1 de octubre de 2026: en lugar de texto devuelven una elección con su probabilidad. En Ollama 0.35.1 se usan con /v1/systemone. Clef-flash clasificó bien 23 de 24 tickets de soporte en mi prueba, y el único fallo fue el de menor confianza.
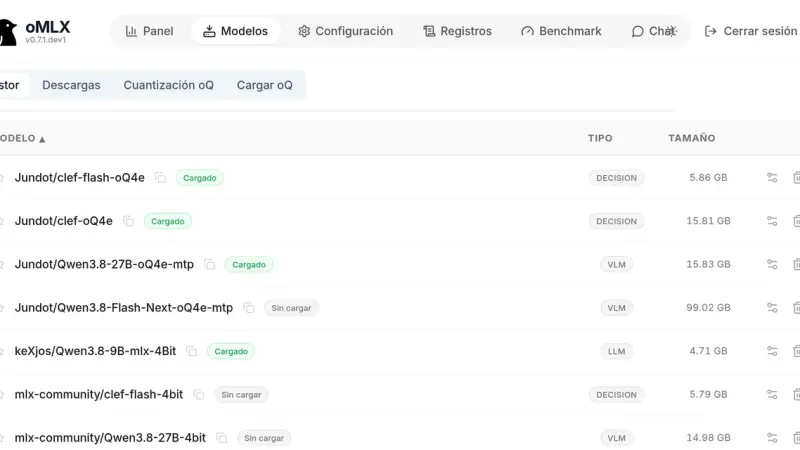
Desde oMLX 0.7.1.dev1, un mismo servidor en el Mac sirve Qwen por /v1/chat/completions y los modelos de decisión Clef por /v1/systemone. En un M5 Max, Clef-flash decidió cada ticket en 111 ms y, con Qwen escribiendo la respuesta, el triaje acertó 39 de 40 etiquetas frente a 34 con Qwen solo.
Para instalar gsd-pi, el agente de terminal de Open GSD, ejecuta npx @opengsd/gsd-pi@latest con Node.js 22.18 o superior. Funciona sin clave de API: con un models.json que apunte a llama.cpp y 64k de contexto, un Qwen3.5 de 4B completó una tarea con 12 tests y un commit. gsd-core, en cambio, se instala dentro de Claude Code u OpenCode.
OpenCode usa un modelo local si declaras en opencode.json un proveedor @ai-sdk/openai-compatible con la URL de llama-server u Ollama y el límite de contexto del modelo. La versión 1.18.31 envía 7.516 tokens en su primer turno, así que los 4k que Ollama asigna por defecto sin GPU grande no bastan: reserva 32k.
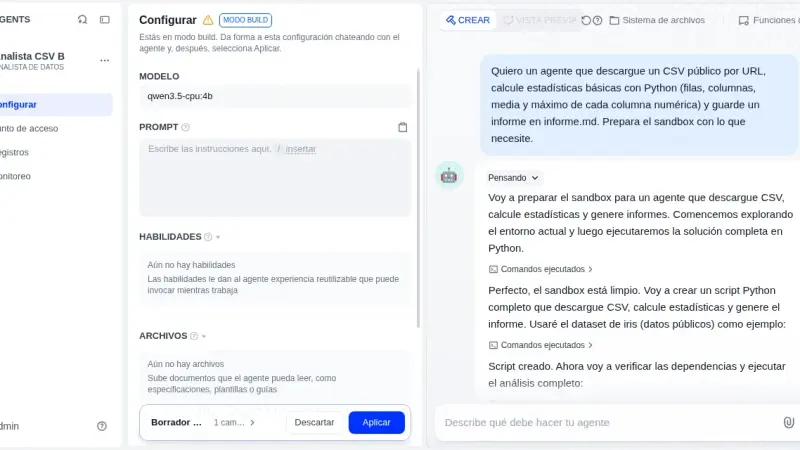
Dify Agent, el agente con sandbox Linux de Dify 1.16, funciona con un modelo local si instalas el plugin de Ollama y activas las llamadas a herramientas. Con Dify 1.17.1 y Qwen3.5-4B en CPU, el agente publicado dio cifras correctas en tres de tres pruebas; el modo Build no terminó ninguna de sus tres sesiones.
Qwen3-VL 8B en Q4_K_M son 4,68 GiB de pesos más 1,08 GiB de torre de visión, y su cache KV cuesta 144 KiB por token. Con 8.192 tokens de contexto la suma ronda los 7 GiB y cabe de sobra en 16 GB; con los 256K nativos pediría 36 GiB solo de cache y no cabe en ninguna tarjeta de consumo.
16 min19
Usamos cookies propias y de terceros para analizar el tráfico del sitio. Puedes aceptarlas, rechazarlas o configurar tu elección.
Más información sobre las cookies
Preferencias de cookies
NecesariasImprescindibles para el funcionamiento del sitio. Siempre activas.
AnalíticasNos ayudan a entender cómo se usa el sitio (Google Analytics).