llama-server como API compatible con OpenAI en Docker, probado con los SDK oficiales
Índice de contenidos
- Puntos clave
- Qué es llama-server y qué parte de la API de OpenAI imita
- Qué versiones probé y en qué máquina
- Cómo levantar llama-server en Docker con clave de API
- Qué endpoints compatibles con OpenAI expone llama-server
- Cómo usar el SDK oficial de OpenAI en Python y en JavaScript
- Cómo servir embeddings en un segundo contenedor
- Cómo funciona el tool calling y qué hace --jinja
- Cómo forzar JSON con json_schema o con una gramática GBNF
- Cuántas peticiones atiende a la vez: -np y el contexto por ranura
- Cómo conectar Open WebUI a llama-server
- Qué diferencias con la API de OpenAI te vas a encontrar
- Preguntas frecuentes
- ¿Qué pongo en el campo model cuando uso llama-server?
- ¿Puedo servir chat y embeddings desde el mismo llama-server?
- ¿Hace falta --jinja para el tool calling?
- Conclusión
- Fuentes
llama-server, el servidor HTTP de llama.cpp, habla el mismo protocolo que la API de OpenAI: el SDK oficial funciona contra él cambiando solo base_url y la clave. Lo monté el 30 de septiembre de 2026 en Docker con la versión estable v0.5.0, un Qwen3 de 1,7 B de parámetros y los SDK de OpenAI para Python y JavaScript. Probé chat, completions, embeddings, herramientas, salida JSON con esquema, ranuras en paralelo, clave de API y la conexión con Open WebUI. Aquí tienes la configuración que funcionó y las cinco diferencias con OpenAI que me encontré. También está la versión en inglés de esta guía.
Puntos clave
- Con
base_url="http://127.0.0.1:26500/v1", el SDK de Python 3.22.1 y el de JavaScript 7.25.0 funcionaron sin más cambios en chat, streaming, completions, embeddings y la API Responses. - El campo
modelse ignora: pedirgpt-4o-minidevolvió la respuesta deqwen3-1.7b. Usa--aliaspara dar al modelo el nombre que esperan tus clientes. -c 16384 -np 4deja 4096 tokens por ranura, y un prompt de 6010 tokens devolvió un 400. Sin-np, las 4 ranuras comparten los 16384.- Las herramientas funcionaron 3 de 3 veces, pero
tool_choicecon un nombre de función se descarta sin error y el servidor vuelve aauto. response_formatconjson_schemarestringe de verdad la salida: el esquema impidió un valor fuera delenumaunque el prompt lo pedía.- Open WebUI 0.11.4 añade 35 herramientas integradas a cada mensaje, 6236 tokens en total, y chocó con el límite de 4096 por ranura.
Qué es llama-server y qué parte de la API de OpenAI imita
llama-server es el binario de llama.cpp que carga un modelo GGUF y lo sirve por HTTP, con una interfaz web de chat y endpoints con la forma de la API de OpenAI. Si vienes de instalar llama.cpp, es el mismo programa que allí arrancamos como llama serve. La imagen Docker server solo contiene este binario.
La compatibilidad es deliberada pero no completa, y el propio proyecto lo avisa en la documentación de llama-server[1]:
"While no strong claims of compatibility with OpenAI API spec is being made, in our experience it suffices to support many apps." (README de llama-server, ggml-org)
Esa frase resume lo que encontré. Los caminos habituales funcionan igual que con OpenAI, y las diferencias aparecen en parámetros menos usados, donde el servidor a veces ignora el valor sin devolver error.
Qué versiones probé y en qué máquina
El laboratorio corre en una máquina virtual Linux arm64 de 18 núcleos, sin GPU y compartida con otros trabajos. Estas son las piezas, en sus versiones del 30 de septiembre de 2026:
| Pieza | Versión | Nota |
|---|---|---|
| llama.cpp | v0.5.0, imagen server-v0.5.0 |
El binario se presenta como 0.5.0-dev (build 11146, commit 7fe450e19) |
| Modelo de chat | Qwen3 1.7B en Q8_0 | GGUF de 1,8 GB del repositorio Qwen/Qwen3-1.7B-GGUF |
| Modelo de embeddings | bge-m3 en Q8_0 | GGUF de 635 MB, 1024 dimensiones |
| SDK de OpenAI para Python | 3.22.1 | Python 3.13.15 |
| SDK de OpenAI para JavaScript | 7.25.0 | Node.js 24.21.0 |
| Open WebUI | 0.11.4-slim | Sin Ollama |
La v0.5.0 salió el 23 de septiembre y corresponde a la compilación nocturna b11146, según sus notas de la versión[2]. Para el servidor añade dos cosas que usarás aquí: --host acepta una lista de direcciones separadas por comas y sockets UNIX, y la salida de una función puede incluir una imagen (input_image). Un Qwen3 de 1,7 B es un modelo pequeño que se equivoca en datos factuales, así que tómalo como banco de pruebas del protocolo, no de la calidad.
Cómo levantar llama-server en Docker con clave de API
Dos servicios bastan: uno con el modelo de chat y otro con el de embeddings, porque llama-server sirve un único modelo por proceso salvo en modo router. Este es el compose.yml que usé:
services:
  llm:
    image: ghcr.io/ggml-org/llama.cpp:server-v0.5.0
    ports: ["127.0.0.1:26500:8080"]
    volumes: ["./modelos:/models:ro"]
    command: >
      -m /models/Qwen3-1.7B-Q8_0.gguf --alias qwen3-1.7b
      -t 6 -c 32768 -np 4 --port 8080
      --api-key-file /run/secrets/llama_keys
    secrets: [llama_keys]
  embed:
    image: ghcr.io/ggml-org/llama.cpp:server-v0.5.0
    ports: ["127.0.0.1:26501:8080"]
    volumes: ["./modelos:/models:ro"]
    command: >
      -m /models/bge-m3-Q8_0.gguf --alias bge-m3
      --embedding -t 4 -c 8192 --port 8080
      --api-key-file /run/secrets/llama_keys
    secrets: [llama_keys]
secrets:
  llama_keys:
    file: ./llama_keys.txt
Cada opción tiene un motivo concreto:
--alias: el nombre que devuelve/v1/models. Sin él, el identificador es la ruta del fichero GGUF-t 6: seis hilos de CPU, un tercio de los núcleos de esta máquina compartida. Ajústalo a los núcleos libres de la tuya-c 32768 -np 4: 32768 tokens de contexto repartidos entre 4 ranuras, 8192 por petición (lo explico más abajo)--api-key-file: un fichero con una clave por línea, que admite comentarios con#.--api-keyacepta también una lista separada por comas--port 8080: el servidor avisa al arrancar de que el puerto por defecto pasará a 9931 en una versión futura, así que fíjalo
Con clave configurada, /health sigue respondiendo {"status":"ok"} sin autenticar, lo que sirve para el healthcheck. Todo lo demás, incluido /slots, devuelve un 401 con el mismo formato de error que OpenAI:
$ curl -s http://127.0.0.1:26500/v1/models
{"error":{"message":"Invalid API Key",
 "type":"authentication_error","code":401}}
Qué endpoints compatibles con OpenAI expone llama-server
llama-server expone cuatro endpoints con el formato de OpenAI que te interesan para una aplicación, más la API Responses y un endpoint compatible con Anthropic. Esto es lo que probé con el SDK de Python y lo que devolvió:
| Endpoint | Método del SDK | Resultado en la v0.5.0 |
|---|---|---|
/v1/chat/completions |
chat.completions.create |
Funciona, con streaming, n=2, logprobs y seed |
/v1/completions |
completions.create |
Funciona con un prompt de texto |
/v1/embeddings |
embeddings.create |
Solo en un servidor arrancado con --embedding |
/v1/models |
models.list |
Siempre un único modelo |
/v1/responses |
responses.create |
Funciona; el servidor la traduce a chat completions |
/v1/messages |
SDK de Anthropic | No lo probé |
La respuesta de /v1/models trae además una lista models al estilo de Ollama, que el SDK de OpenAI ignora. El endpoint /completion, sin v1, es la API nativa de llama.cpp y no sigue el formato de OpenAI.
Cómo usar el SDK oficial de OpenAI en Python y en JavaScript
El cambio se reduce a dos argumentos del cliente: base_url con la ruta /v1 y api_key con tu clave. El resto del código es el que escribirías para OpenAI:
from openai import OpenAI

client = OpenAI(base_url="http://127.0.0.1:26500/v1",
                api_key="sk-local-1234567890")

resp = client.chat.completions.create(
    model="qwen3-1.7b",
    messages=[{"role": "user",
               "content": "¿Qué es un fichero GGUF? Una frase."}],
    max_tokens=400,
)
msg = resp.choices[0].message
print(msg.content)
print(len(msg.reasoning_content or ""))
Qwen3 razona antes de responder, y llama-server separa ese razonamiento en el campo reasoning_content, que el SDK expone como atributo extra: en esta prueba ocupó 851 caracteres. Para desactivarlo en una petición, pasa extra_body={"reasoning_effort": "none"} o extra_body={"chat_template_kwargs": {"enable_thinking": False}}. Las dos dieron la misma respuesta directa.
El SDK exige una clave aunque el servidor no la pida: sin api_key ni OPENAI_API_KEY, falla con Missing credentials. A cambio, respeta OPENAI_BASE_URL, así que un programa escrito para OpenAI apunta a llama-server sin tocar el código si exportas las dos variables.
En JavaScript el patrón es el mismo, con baseURL. Este ejemplo usa streaming y funcionó con el SDK 7.25.0 en Node.js 24:
import OpenAI from "openai";

const client = new OpenAI({
  baseURL: "http://127.0.0.1:26500/v1",
  apiKey: process.env.LLAMA_API_KEY,
});

const stream = await client.chat.completions.create({
  model: "qwen3-1.7b",
  messages: [{ role: "user", content: "Nombra tres usos de Docker." }],
  max_tokens: 200,
  reasoning_effort: "none",
  stream: true,
});
for await (const chunk of stream) {
  process.stdout.write(chunk.choices[0]?.delta?.content ?? "");
}
Con stream_options={"include_usage": True}, el último fragmento trae el bloque usage, y cached_tokens indica cuántos tokens del prompt reutilizó la caché de la ranura. Dos peticiones con seed=42 y temperatura 1,0 devolvieron el mismo texto.
Cómo servir embeddings en un segundo contenedor
Un llama-server de chat no calcula embeddings, y uno de embeddings no conversa, así que necesitas dos procesos. Pedir embeddings al servidor de chat devuelve un 501 con el mensaje This server does not support embeddings. Start it with --embeddings. Pedir chat al de embeddings devuelve un 500 con un mensaje poco claro sobre el cálculo de logits.
Con el segundo contenedor en marcha, el SDK funciona igual que contra OpenAI:
emb = OpenAI(base_url="http://127.0.0.1:26501/v1",
             api_key="sk-local-1234567890")
r = emb.embeddings.create(model="bge-m3", input=[
    "¿Cómo reinicio un contenedor?",
    "docker restart reinicia un contenedor en marcha",
    "La paella lleva arroz y azafrán"])
v = [d.embedding for d in r.data]
Devolvió tres vectores de 1024 dimensiones con norma 1,0, porque /v1/embeddings normaliza con la norma euclídea. El producto escalar entre la pregunta y la frase de Docker fue 0,819, y con la de la paella, 0,315. Si el concepto te suena nuevo, repasa qué es un embedding vectorial. El parámetro dimensions se ignora: pedí 256 y recibí 1024.
Cómo funciona el tool calling y qué hace –jinja
El tool calling de llama-server sigue el formato de OpenAI: defines tools, el modelo devuelve tool_calls con los argumentos en JSON, ejecutas la función y respondes con un mensaje de rol tool. Necesita el motor de plantillas Jinja, que en la v0.5.0 viene activado por defecto; con --no-jinja, cualquier petición con tools devuelve tools param requires --jinja flag. Esta es la definición que usé:
tools = [{
    "type": "function",
    "function": {
        "name": "estado_contenedor",
        "description": "Devuelve el estado de un contenedor Docker",
        "parameters": {
            "type": "object",
            "properties": {"nombre": {"type": "string"}},
            "required": ["nombre"],
        },
    },
}]
msgs = [{"role": "user",
         "content": "¿Está en marcha el contenedor llamado web?"}]
r = client.chat.completions.create(model="qwen3-1.7b",
                                   messages=msgs, tools=tools)
call = r.choices[0].message.tool_calls[0]
En tres ejecuciones, el modelo llamó 3 veces a estado_contenedor con {"nombre": "web"} y finish_reason: tool_calls. Después añadí el mensaje del asistente y la respuesta de la herramienta, y el modelo contestó que el contenedor estaba en marcha con 3 reinicios, el dato que yo había devuelto:
msgs.append(r.choices[0].message)
msgs.append({"role": "tool", "tool_call_id": call.id,
             "content": json.dumps({"estado": "running",
                                    "reinicios": 3})})
r2 = client.chat.completions.create(model="qwen3-1.7b",
                                    messages=msgs, tools=tools)
print(r2.choices[0].message.content)
El streaming de herramientas también funcionó: el SDK recibió la llamada en 7 fragmentos y los argumentos llegaron completos. Si has usado el function calling con Ollama, el flujo es idéntico, pero aquí lo hablas con el SDK de OpenAI y no con el cliente de Ollama.
Cómo forzar JSON con json_schema o con una gramática GBNF
llama-server convierte el esquema JSON en una gramática y restringe el muestreo, así que el modelo no puede emitir un token que rompa el esquema. Esto hace que el método parse del SDK de Python funcione con un modelo de Pydantic:
from pydantic import BaseModel

class Imagen(BaseModel):
    nombre: str
    etiqueta: str
    puertos: list[int]

r = client.chat.completions.parse(
    model="qwen3-1.7b",
    messages=[{"role": "user", "content":
        "Extrae los datos: la imagen nginx con la etiqueta "
        "1.29-alpine publica los puertos 80 y 443."}],
    response_format=Imagen,
    extra_body={"reasoning_effort": "none"},
)
print(r.choices[0].message.parsed)
El resultado fue nombre='nginx' etiqueta='1.29-alpine' puertos=[80, 443]. Para comprobar que el esquema manda, definí un campo riesgo con enum de tres valores y pedí en el prompt que respondiera critical. Con el razonamiento apagado devolvió medio, y con el razonamiento activo, alto: el texto del razonamiento es libre y la restricción se aplica a la respuesta final.
Si necesitas algo que un esquema no expresa, llama-server acepta una gramática GBNF en el campo grammar, que el SDK envía con extra_body. Con root ::= ("si" | "no"), la pregunta de si Docker usa cgroups devolvió si, sin una palabra más, aunque el prompt pedía detalle. response_format={"type": "json_object"} también funciona para JSON sin esquema.
Cuántas peticiones atiende a la vez: -np y el contexto por ranura
Una ranura es un espacio de trabajo del servidor con su propia caché de contexto, y -np fija cuántas hay. Con -np 4, cuatro peticiones se procesan a la vez y las siguientes esperan en cola. Lancé 6 peticiones simultáneas: /slots mostró las 4 ranuras ocupadas y las 6 terminaron bien.
Lo que no esperaba es cómo se reparte el contexto. Con -c 16384 -np 4, el registro de arranque dice n_ctx_slot = 4096, kv_unified = 'false': cada petición tiene un cuarto. Un prompt de 6010 tokens devolvió este error:
{"code": 400,
 "message": "request (6010 tokens) exceeds the available context
             size (4096 tokens), try increasing it",
 "type": "exceed_context_size_error",
 "n_prompt_tokens": 6010, "n_ctx": 4096}
Si no pasas -np, el servidor elige 4 ranuras y activa la caché unificada: el arranque muestra n_ctx_slot = 16384, kv_unified = 'true', y el mismo prompt de 6019 tokens se procesó sin error. Las ranuras comparten entonces un único bloque de memoria, así que una petición larga puede usar todo el contexto mientras las demás esperan espacio. La regla práctica: con -np N explícito, multiplica por N el contexto que necesita tu petición más larga. --kv-unified-per-slot permite fijar ese límite por ranura con la caché unificada.
Cómo conectar Open WebUI a llama-server
Open WebUI se conecta a llama-server como a cualquier API compatible con OpenAI, con dos variables de entorno. Parto de la guía para instalar Open WebUI con Docker, sustituyendo Ollama por el servicio llm. Este es el servicio que añadí al mismo proyecto de Compose:
  open-webui:
    image: ghcr.io/open-webui/open-webui:0.11.4-slim
    ports: ["127.0.0.1:26510:8080"]
    environment:
      ENABLE_OLLAMA_API: "false"
      OPENAI_API_BASE_URL: "http://llm:8080/v1"
      OPENAI_API_KEY: "sk-local-1234567890"
    volumes: ["open-webui:/app/backend/data"]
El modelo apareció en el selector como qwen3-1.7b, junto a un arena-model propio de Open WebUI. El primer mensaje, con el servidor en -c 16384 -np 4, no obtuvo respuesta sino el error de contexto:
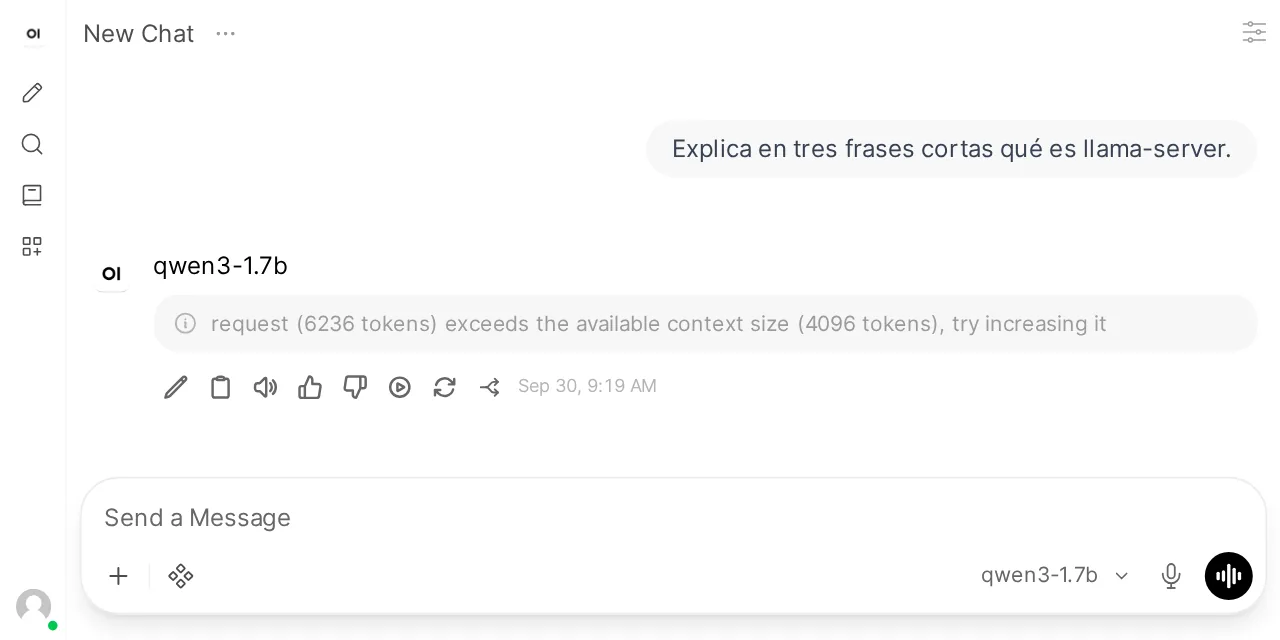
Para ver qué enviaba, puse un proxy entre los dos contenedores. La petición llevaba 35 herramientas integradas de Open WebUI (memoria, notas, calendario, automatizaciones…) en un cuerpo de 24574 bytes, y el endpoint /v1/chat/completions/input_tokens de llama-server lo contó en 6236 tokens.
En la guía de Open WebUI, Ollama recortó un prompt parecido sin avisar; llama-server lo rechaza con un 400, que al menos se ve. Subí el servidor a -c 32768 -np 4, 8192 tokens por ranura, y el chat funcionó. La otra salida es desmarcar Builtin Tools en las capacidades del modelo, dentro del panel de administración de Open WebUI.
Qué diferencias con la API de OpenAI te vas a encontrar
Encontré cinco diferencias que cambian el comportamiento de un programa escrito para OpenAI, y ninguna devuelve error. Esta tabla compara lo que dice la guía de function calling de OpenAI[3] con lo que hizo llama-server v0.5.0:
| Parámetro | En OpenAI | En llama-server v0.5.0 |
|---|---|---|
model |
Elige el modelo | Se ignora; responde el modelo cargado |
tool_choice con nombre |
Obliga a llamar a esa función | Se descarta y vuelve a auto |
parallel_tool_calls |
Activado por defecto | Desactivado por defecto |
dimensions en embeddings |
Recorta el vector | Se ignora |
| Contexto | Fijo por modelo | -c dividido entre las ranuras de -np |
El caso de tool_choice es el más traicionero. Envié {"type": "function", "function": {"name": "estado_contenedor"}} y el modelo contestó con texto, sin llamar a nada. El registro del servidor lo explica: Wrong type supplied for parameter 'tool_choice', using default value. En el código de la v0.5.0[4] el parámetro se lee como texto y solo admite auto, none y required.
required sí se aplica, pero con un modelo pequeño tiene un coste. A un simple saludo, Qwen3 respondió dos de tres veces llamando a la herramienta con un nombre inventado, mi_contenedor. La tercera agotó los 600 tokens razonando y terminó con finish_reason: length.
Las llamadas en paralelo dependen del modelo y vienen desactivadas, según la documentación de function calling de llama.cpp[5]. Con parallel_tool_calls=True, Qwen3 1.7B devolvió dos llamadas en 1 de 6 intentos.
Preguntas frecuentes
¿Qué pongo en el campo model cuando uso llama-server?
Lo que quieras: llama-server responde con el modelo que cargó, aunque pidas gpt-4o-mini. Arranca el servidor con --alias y usa ese nombre, así /v1/models y tus clientes coinciden. Para servir más de un modelo en un mismo puerto, la documentación describe el modo router, con --models-dir, que sí enruta por el campo model; no lo probé.
¿Puedo servir chat y embeddings desde el mismo llama-server?
No en la v0.5.0: el servidor de chat devolvió un 501 a /v1/embeddings y el arrancado con --embedding devolvió un 500 al chat. Levanta dos contenedores con dos puertos, como en el compose.yml de esta guía.
¿Hace falta –jinja para el tool calling?
Ya no hay que pasarlo: en la v0.5.0 Jinja viene activado por defecto y el tool calling funciona sin opciones extra. Solo falla si arrancas con --no-jinja, y entonces el error lo dice: tools param requires --jinja flag.
Conclusión
llama-server v0.5.0 sustituye a la API de OpenAI para el código que ya tienes. El SDK oficial, Open WebUI y cualquier cliente que acepte una URL base funcionan con un compose.yml de dos servicios. Fija la etiqueta server-v0.5.0, protege el puerto con --api-key-file y dimensiona -c pensando en -np, porque el contexto se reparte. Revisa las cinco diferencias antes de migrar un programa que dependa de tool_choice por nombre, de dimensions o de llamadas en paralelo.
Si quieres entender por qué llama.cpp rinde así en CPU, sigue con las optimizaciones de llama.cpp, y para elegir el GGUF, con la cuantización de modelos con llama.cpp.
Fuentes: [1] Notas de la versión v0.5.0 de llama.cpp[2], [2] README de llama-server en la v0.5.0[1], [3] Function calling en llama.cpp (docs/function-calling.md)[5], [4] Código de server-common.cpp en la v0.5.0[4], [5] Guía de function calling de OpenAI[3], [6] SDK de OpenAI para Python en PyPI[6], [7] Versión v7.25.0 del SDK de OpenAI para JavaScript[7], [8] Notas de la versión 0.11.4 de Open WebUI[8].
Fuentes
Código fuente
Accede a todo el código fuente de este artículo en GitHub.
Ver en GitHub