Novedades de PostgreSQL 19 probadas en Docker, con REPACK y pg_upgrade desde la 18
Índice de contenidos
- Puntos clave
- Qué trae PostgreSQL 19 y en qué estado está
- Cómo arrancar PostgreSQL 19 en Docker
- Qué hace REPACK y en qué se diferencia de VACUUM FULL
- Qué pasa con las escrituras durante REPACK CONCURRENTLY
- Dónde no funciona REPACK CONCURRENTLY
- Por qué REPACK CONCURRENTLY no es seguro para MVCC
- Cómo esperar en una réplica con WAIT FOR LSN
- Replicación lógica de secuencias sin reiniciar el primario
- Otros cambios de SQL que probé
- Qué valores por defecto cambian respecto a la 18
- Cómo actualizar de PostgreSQL 18 a 19 con pg_upgrade en Docker
- Qué incompatibilidades encontré al actualizar
- ¿Conviene actualizar ya o esperar a la 19.1?
- Preguntas frecuentes
- ¿REPACK sustituye a la extensión pg_repack?
- ¿Puedo cambiar la etiqueta de la imagen de postgres:18 a postgres:19 y ya está?
- ¿Cuándo sale la versión final de PostgreSQL 19?
- Conclusión
- Fuentes
PostgreSQL 19, cuya versión final está prevista para octubre de 2026, añade REPACK: un comando que compacta tablas y, con la opción CONCURRENTLY, lo hace sin bloquear lecturas ni escrituras. Probé la Beta 4, la compilación más reciente el 28 de septiembre, en Docker sobre arm64. Una tabla de 1895 MB con tres cuartas partes de filas borradas bajó a 474 MB, y a unos 490 MB cuando la compacté mientras ocho clientes seguían actualizándola. También repasé WAIT FOR, la replicación lógica de secuencias, los valores por defecto que cambian y una actualización real desde la 18 con pg_upgrade --link. Tienes la versión en inglés de esta guía.
Puntos clave
- REPACK sustituye a VACUUM FULL y CLUSTER, que siguen funcionando, y REPACK (CONCURRENTLY) solo toma el bloqueo exclusivo para intercambiar los ficheros al final
- Con ocho clientes de pgbench actualizando filas, REPACK (CONCURRENTLY) no perdió ni una actualización en tres ejecuciones y el peor segundo mantuvo 3526 transacciones por segundo; con VACUUM FULL los ocho clientes esperaron 1,6 s y el peor segundo bajó a 16
- REPACK (CONCURRENTLY) no es seguro para MVCC: una transacción REPEATABLE READ abierta antes vio vacía una tabla de 2 millones de filas
- WAIT FOR LSN deja que una réplica espere a haber aplicado una escritura concreta, y la replicación lógica copia secuencias al suscribir y con
REFRESH SEQUENCES, pero no de forma continua - JIT pasa a estar desactivado,
max_locks_per_transactionsube de 64 a 128 ystandard_conforming_stringsya no se puede desactivar pg_upgradedesde la 18.6 rechazó un índice GiST de btree_gist sobreinet, y el clúster nuevo arrancó sin la regla depg_hba.confque añade la imagen de Docker
Qué trae PostgreSQL 19 y en qué estado está
PostgreSQL 19 estaba en Beta 4 el 28 de septiembre de 2026, con una versión final prevista para octubre. La hoja de ruta de PostgreSQL[1] fija la 19 para ese mes. El anuncio de la Beta 4[2], del 24 de septiembre, esperaba una release candidate a principios de octubre y añadía que la versión final "may also occur in October".
La Beta 4 retiró cuatro funciones que se habían anunciado: las consultas de grafos SQL/PGQ, la activación de checksums en caliente, las actualizaciones temporales con FOR PORTION OF y MERGE/SPLIT PARTITIONS. El anuncio lo justifica así: "The PostgreSQL community strongly believes that, first and foremost, PostgreSQL must be reliable." Una lista de novedades escrita antes de la Beta 4 puede incluir alguna de esas cuatro.
Las notas de la versión 19[3], con fecha de corte del 14 de septiembre, destacan estas novedades, y la última columna dice qué probé:
| Novedad | Qué hace | Probado aquí |
|---|---|---|
| REPACK y REPACK (CONCURRENTLY) | Compacta y reordena tablas; en modo concurrente sin bloquear escrituras | Sí |
| WAIT FOR LSN | Una réplica espera a haber aplicado un punto concreto del WAL | Sí |
| Secuencias en replicación lógica | CREATE PUBLICATION ... ALL SEQUENCES y REFRESH SEQUENCES |
Sí |
Replicación lógica con wal_level=replica |
Se activa sola cuando hace falta, sin reiniciar | Sí |
| Autovacuum con trabajadores paralelos y puntuación | Vacía índices en paralelo y prioriza tablas | Solo la vista |
pg_plan_advice y pg_stash_advice |
Fija o corrige decisiones del planificador | Sí, pg_plan_advice |
Cómo arrancar PostgreSQL 19 en Docker
La imagen oficial postgres:19beta4 guarda el clúster en /var/lib/postgresql/19/docker, así que el volumen se monta en /var/lib/postgresql, igual que en la 18. La documentación de la imagen oficial[4] lo explica: desde la 18, PGDATA incluye la versión mayor y el VOLUME declarado es /var/lib/postgresql. Si vienes de la 17 o de una guía antigua que monta /var/lib/postgresql/data, la guía para instalar PostgreSQL con Docker cubre ese cambio paso a paso.
Este es el arranque que usé para las pruebas, con el puerto publicado solo en la interfaz local:
docker run -d --name b6p10-pg19 \
  -e POSTGRES_PASSWORD=labpass \
  -p 127.0.0.1:25000:5432 \
  -v b6p10-pg19data:/var/lib/postgresql \
  postgres:19beta4
docker exec b6p10-pg19 env | grep -E 'PG_VERSION|PGDATA'
La segunda orden confirma la ruta y el paquete: PG_VERSION=19~beta4-1.pgdg13+1 y PGDATA=/var/lib/postgresql/19/docker. La imagen para arm64 pesa 162 MB comprimida según la API de Docker Hub y ocupa 674 MB una vez descargada. La descargué de Docker Hub.
Qué hace REPACK y en qué se diferencia de VACUUM FULL
REPACK reescribe la tabla en un fichero nuevo sin las filas muertas y devuelve el espacio sobrante al sistema operativo, igual que VACUUM FULL; con USING INDEX además la reordena, como CLUSTER. Las notas explican que los dos comandos antiguos hacían cosas parecidas con nombres confusos y que se mantienen por compatibilidad. En la Beta 4, VACUUM FULL y CLUSTER pedidos USING pedidos_pkey siguieron funcionando sin avisos.
La diferencia está en CONCURRENTLY. Según la documentación de REPACK[5], el modo concurrente copia la tabla, captura con decodificación lógica los cambios que llegan mientras tanto y solo pide el bloqueo ACCESS EXCLUSIVE para intercambiar los ficheros. Hasta ahora eso pedía una extensión externa, pg_repack[6], que según su README trabaja "without holding an exclusive lock on the processed tables during processing".
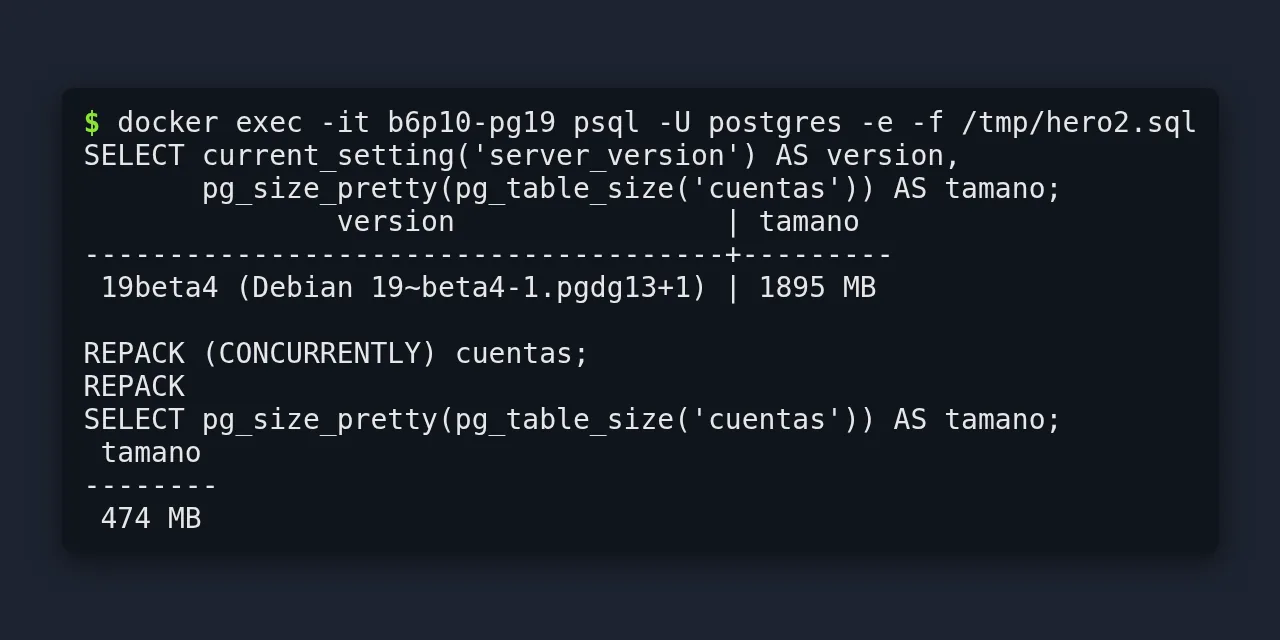
Para probarlo creé una tabla de 8 millones de filas con clave primaria y borré tres de cada cuatro. Después pasé un VACUUM normal, que marca el hueco como reutilizable pero no lo devuelve al disco:
CREATE TABLE cuentas (
  id      bigint PRIMARY KEY,
  saldo   bigint NOT NULL DEFAULT 0,
  relleno text NOT NULL
);
INSERT INTO cuentas (id, relleno)
SELECT g, repeat(md5(g::text), 6) FROM generate_series(1, 8000000) g;
DELETE FROM cuentas WHERE id % 4 <> 0;
VACUUM cuentas;
SELECT pg_size_pretty(pg_table_size('cuentas'));  -- 1895 MB
REPACK (CONCURRENTLY) cuentas;
SELECT pg_size_pretty(pg_table_size('cuentas'));  -- 474 MB
La tabla pasó de 1895 MB a 474 MB con los mismos 2 millones de filas vivas.
Sin más carga, REPACK (CONCURRENTLY) tardó 1,42 s de mediana en tres ejecuciones. VACUUM FULL tardó 1,09 s y REPACK sin CONCURRENTLY, 1,03 s: el modo concurrente cuesta algo más porque además decodifica y aplica los cambios. Con la opción VERBOSE, REPACK informa de cada tabla. En una más pequeña escribió repacking "public.pedidos" in physical order y dejó 347 MB de tabla y 56 MB de índices en 87 MB y 14 MB.
Qué pasa con las escrituras durante REPACK CONCURRENTLY
Las escrituras siguieron entrando durante todo el REPACK (CONCURRENTLY) y ninguna se perdió. Lancé pgbench con ocho clientes durante 40 s, cada uno sumando 1 al saldo de una cuenta al azar, y a los 10 s ejecuté el comando de mantenimiento.
Repetí cada modo tres veces y rehice la tabla de 1895 MB antes de cada ejecución. La carga media de un minuto estaba por debajo de 3 al empezar (entre 1,25 y 2,97). Este es el script de pgbench:
\set k random(1, 2000000)
UPDATE cuentas SET saldo = saldo + 1 WHERE id = :k * 4;
Si alguna actualización se perdiera al intercambiar los ficheros, la suma de saldos quedaría por debajo del número de transacciones. No pasó:
| Mediana de tres ejecuciones | REPACK (CONCURRENTLY) | VACUUM FULL |
|---|---|---|
| Duración del comando | 2,50 s (1,52–2,89) | 1,70 s (1,69–1,96) |
| Peor segundo, transacciones por segundo | 3526 (695–4118) | 16 (0–19) |
| Tiempo con clientes esperando un bloqueo | 0 s (0–0,9) | 1,6 s (1,6–1,9), los 8 clientes |
| Transacciones fallidas | 0 en las tres | 0 en las tres |
sum(saldo) igual a las transacciones |
Sí, en las tres | Sí, en las tres |
| Tamaño final de la tabla | 488–491 MB | 488–492 MB |
Antes del mantenimiento, pgbench iba a unas 8000 transacciones por segundo, y muestreé pg_locks cada 0,2 s buscando peticiones no concedidas sobre la tabla. Con REPACK (CONCURRENTLY), dos ejecuciones no registraron ninguna espera y en la tercera un solo cliente esperó unos 0,9 s, lo que encaja con el bloqueo breve del intercambio final. Con carga, la tabla quedó en unos 490 MB con los dos comandos, algo más que los 474 MB sin carga, porque las filas actualizadas ocupan sitio nuevo. Con VACUUM FULL, los ocho clientes aparecieron en cola y el registro del servidor recogió ocho líneas como esta, porque log_lock_waits viene activado por defecto en la 19:
LOG:  process 1288 still waiting for RowExclusiveLock on relation 16469
      of database 5 after 1000.811 ms at character 8
Ese milisegundo de más sobre 1000 es el umbral de deadlock_timeout, que vale 1 s. Mientras REPACK (CONCURRENTLY) trabajaba, pg_replication_slots mostró un slot lógico temporal llamado pg_repack_2679 con el plugin pgrepack, y pg_stat_progress_repack pasó por las fases seq scanning heap y rebuilding index. El slot desapareció al terminar. VACUUM FULL terminó antes, pero a cambio paró a todos los clientes; REPACK (CONCURRENTLY) tardó más y la escritura siguió, a menos de la mitad de ritmo en el peor segundo.
Dónde no funciona REPACK CONCURRENTLY
El modo concurrente necesita una clave primaria o un índice de identidad de réplica, porque aplica los cambios capturados por esa clave. Estos son los errores que devolvió la Beta 4 en cada caso prohibido:
| Caso | Mensaje de la Beta 4 |
|---|---|
| Tabla sin clave primaria | Relation "sin_pk" has no identity index. |
Tabla UNLOGGED |
This operation is only supported for permanent relations. |
| Vista materializada | This operation is not supported for materialized views. |
Dentro de BEGIN |
REPACK (CONCURRENTLY) cannot run inside a transaction block |
| Sin nombre de tabla | REPACK (CONCURRENTLY) requires an explicit table name |
La documentación añade las tablas particionadas, los catálogos y las tablas TOAST, y el límite de max_repack_replication_slots, que vale 5 por defecto. También exige espacio libre para una copia de la tabla y de sus índices, y un poco más para los cambios que llegan durante la copia.
Por qué REPACK CONCURRENTLY no es seguro para MVCC
REPACK (CONCURRENTLY) comparte con TRUNCATE una advertencia de la sección de salvedades de MVCC[7]: tras la reescritura, la tabla aparece vacía a las transacciones cuyo snapshot es anterior. Lo reproduje con una transacción REPEATABLE READ que primero lee otra tabla y espera 15 s:
BEGIN ISOLATION LEVEL REPEATABLE READ;
SELECT count(*) FROM notas;       -- toma el snapshot
SELECT pg_sleep(15);              -- aquí corre REPACK (CONCURRENTLY)
SELECT count(*) FROM cuentas;     -- 0
COMMIT;
SELECT count(*) FROM cuentas;     -- 2000000
La transacción contó 0 filas en una tabla con 2 millones. Con REPACK cuentas, sin CONCURRENTLY, la misma prueba contó 2 000 000: la documentación solo incluye el modo concurrente entre los comandos que no son seguros para MVCC. Si tienes informes largos en REPEATABLE READ que leen esta tabla junto a otras, lanza el modo concurrente fuera de esa ventana.
Cómo esperar en una réplica con WAIT FOR LSN
WAIT FOR LSN hace que una sesión en una réplica espere hasta haber aplicado un punto concreto del WAL, lo que da consistencia de "leer lo que acabo de escribir" con réplicas asíncronas. La documentación de WAIT[8] define cuatro modos: standby_replay, el de por defecto, standby_write, standby_flush y primary_flush. Monté una réplica en streaming con pg_basebackup -R y pausé su reproducción para forzar la espera:
-- primario
INSERT INTO notas VALUES (1, 'escrita en el primario');
SELECT pg_current_wal_insert_lsn();              -- 4/6B0267A0
-- réplica, con pg_wal_replay_pause() activo
WAIT FOR LSN '4/6B0267A0' WITH (TIMEOUT '2s', NO_THROW);  -- timeout
SELECT pg_wal_replay_resume();
WAIT FOR LSN '4/6B0267A0';                       -- success
SELECT * FROM notas;                             -- ya aparece la fila
Sin NO_THROW, el tiempo agotado es un error: timed out while waiting for target LSN 4/6B0267A0 to be replayed. En el primario, el modo por defecto falla con recovery is not in progress, y WITH (NO_THROW) devuelve not in recovery. La aplicación tiene que guardar el LSN de su última escritura y pasarlo a la réplica.
Replicación lógica de secuencias sin reiniciar el primario
La replicación lógica de la 19 copia los valores de las secuencias, pero solo al crear la suscripción y cuando se lo pides. Lo comprobé con dos contenedores 19beta4 y una base ventas con una tabla de identidad:
-- primario (wal_level = replica, el valor por defecto)
CREATE PUBLICATION pub_ventas FOR ALL TABLES, ALL SEQUENCES;
-- suscriptor
CREATE SUBSCRIPTION sub_ventas
  CONNECTION 'host=primario dbname=ventas user=postgres password=labpass'
  PUBLICATION pub_ventas;
ALTER SUBSCRIPTION sub_ventas REFRESH SEQUENCES;
Tras suscribir, la secuencia del suscriptor tenía last_value 1000, igual que el primario. Añadí 500 filas en el primario: la tabla llegó a 1500 filas en el suscriptor, pero la secuencia se quedó en 1000 hasta ejecutar REFRESH SEQUENCES. En una migración con cambio de primario, ese paso va justo antes del corte, o el primer INSERT en el nodo nuevo chocará con una clave existente.
La otra novedad se ve en effective_wal_level. El primario seguía con wal_level = replica, y effective_wal_level pasó de replica a logical en cuanto la suscripción creó su slot, sin reiniciar. En la 18 había que cambiar wal_level a logical y reiniciar antes; la guía de replicación lógica en PostgreSQL 16 cuenta cómo era el proceso.
Otros cambios de SQL que probé
Cuatro cambios pequeños resuelven cosas que antes pedían un rodeo, y los cuatro funcionaron en la Beta 4 tal como los describen las notas:
IGNORE NULLSenlag(),lead(),first_value(),last_value()ynth_value():lag(valor) IGNORE NULLS OVER (ORDER BY t)devuelve el último valor conocido y salta los huecosON CONFLICT DO SELECT:INSERT ... ON CONFLICT (nombre) DO SELECT RETURNING iddevuelve también la fila que ya existía, sin un segundoSELECTCOPY ... TO STDOUT (FORMAT json): saca una línea JSON por fila, como{"sensor":1,"t":1,"valor":10}json_array()sin filas: devuelve[]en vez deNULL, un cambio que las notas marcan como incompatible
La extensión pg_plan_advice, de Robert Haas, fija decisiones del planificador. Tras LOAD 'pg_plan_advice', EXPLAIN (PLAN_ADVICE) escribió INDEX_SCAN(cuentas public.cuentas_pkey) para una búsqueda por clave. Con SET pg_plan_advice.advice = 'SEQ_SCAN(cuentas)', el plan pasó a un escaneo secuencial paralelo marcado /* matched */. La documentación de pg_plan_advice[9] avisa de que forzar el plan puede salir mal cuando cambian los datos.
Qué valores por defecto cambian respecto a la 18
Comparé SHOW en dos contenedores recién creados, postgres:18.6 y postgres:19beta4, y estos son los valores que cambian:
| Parámetro | 18.6 | 19beta4 |
|---|---|---|
jit |
on |
off |
max_locks_per_transaction |
64 | 128 |
default_toast_compression |
pglz |
lz4 |
log_lock_waits |
off |
on |
| Trabajadores de E/S | io_workers = 3 |
io_min_workers = 2, io_max_workers = 8 |
standard_conforming_strings |
on, desactivable |
on fijo |
El cambio de JIT se nota en los planes. La misma agregación sobre cuentas mostró en la 18 un bloque JIT: Functions: 5 con inlining y optimización, y en la 19 ninguno hasta hacer SET jit = on. Las notas explican que el coste que decidía activarlo "has been determined to be unreliable", así que si ejecutas consultas analíticas grandes, vuelve a activarlo y mide. Sobre los bloqueos, las notas avisan de que el tamaño de cada entrada cambió: si tenías 256, pon 512 para conservar la misma capacidad.
Cómo actualizar de PostgreSQL 18 a 19 con pg_upgrade en Docker
La actualización con pg_upgrade --link funciona dentro de un único volumen, porque la 18 y la 19 viven en /var/lib/postgresql/18/docker y /var/lib/postgresql/19/docker. El problema es que cada imagen oficial trae solo los binarios de su versión, y pg_upgrade necesita los dos. Lo resolví con una imagen propia que copia los de la 18 dentro de la de la 19:
FROM postgres:19beta4
COPY --from=postgres:18.6 /usr/lib/postgresql/18 /usr/lib/postgresql/18
COPY --from=postgres:18.6 /usr/share/postgresql/18 /usr/share/postgresql/18
Las dos imágenes parten de Debian trixie, y ldd no encontró ninguna biblioteca ausente en el postgres de la 18 copiado. El compose.yaml define la base de datos y un servicio upgrade que solo arranca bajo demanda y monta el mismo volumen:
services:
  db:
    image: postgres:${PG_TAG:-18.6}
    environment:
      POSTGRES_PASSWORD: cambia_esta_clave
    ports:
      - "127.0.0.1:25020:5432"
    volumes:
      - pgdata:/var/lib/postgresql
  upgrade:
    build: ./upgrade
    profiles: [upgrade]
    volumes:
      - pgdata:/var/lib/postgresql
      - ./upgrade.sh:/upgrade.sh:ro
    entrypoint: ["/upgrade.sh"]
volumes:
  pgdata:
El script crea el clúster nuevo con la misma codificación y configuración regional que el antiguo y lanza pg_upgrade. Se ejecuta desde /var/lib/postgresql a propósito: pg_upgrade deja en el directorio actual update_extensions.sql y delete_old_cluster.sh, y en /tmp se perderían al borrarse el contenedor. La última línea útil copia pg_hba.conf, por un motivo que explico más abajo:
#!/usr/bin/env bash
# usage: upgrade.sh check|link
set -euo pipefail
OLD=/var/lib/postgresql/18/docker
NEW=/var/lib/postgresql/19/docker
if [ ! -s "$NEW/PG_VERSION" ]; then
  install -d -o postgres -g postgres -m 700 "$NEW"
  gosu postgres initdb -D "$NEW" -U postgres \
    --encoding=UTF8 --locale=en_US.utf8 > /dev/null
fi
cd /var/lib/postgresql
MODE=--check; [ "$1" = link ] && MODE=--link
gosu postgres pg_upgrade -U postgres \
  -b /usr/lib/postgresql/18/bin -B /usr/lib/postgresql/19/bin \
  -d "$OLD" -D "$NEW" $MODE
[ "$1" = link ] && cp "$OLD/pg_hba.conf" "$NEW/pg_hba.conf"
exit 0
Con la 18.6 en marcha cargué una base de prueba de 684 MB: btree_gist, pg_stat_statements, 2 millones de filas en cuentas y una tabla accesos con un índice GiST sobre una columna inet. Después paré la base y lancé la comprobación. Ejecuté cada orden de Compose con -f y -p explícitos; aquí las acorto:
docker compose stop db
docker compose build upgrade
docker compose run --rm upgrade check
La comprobación falló en gist_inet_ops. Las notas de la 19 cambian la clase de operadores por defecto para inet y cidr de btree_gist a la GiST nativa, porque la de btree_gist "can exclude rows that should be returned", y pg_upgrade rechaza los índices antiguos:
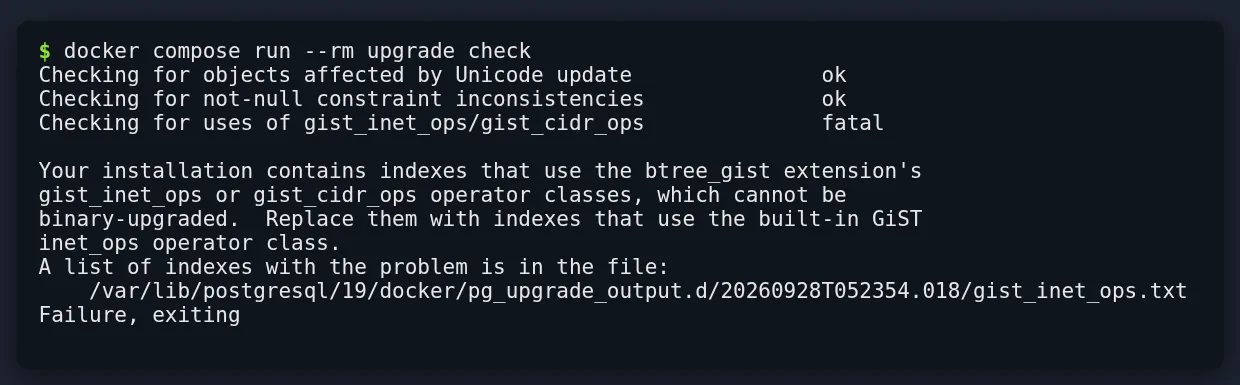
El fichero que indica el mensaje listaba public.accesos_ip_gist. Lo rehíce en la 18 con la clase nativa, volví a comprobar y ya salió *Clusters are compatible*:
docker compose start db
docker compose exec db psql -U postgres \
  -c "CREATE INDEX accesos_ip_inet ON accesos USING gist (ip inet_ops)" \
  -c "DROP INDEX accesos_ip_gist"
docker compose stop db
docker compose run --rm upgrade check
docker compose run --rm upgrade link
PG_TAG=19beta4 docker compose up -d db
pg_upgrade --link terminó con Upgrade Complete y avisó de que el clúster antiguo ya no se puede arrancar con seguridad. Después quedan dos pasos que el propio pg_upgrade sugiere: actualizar las extensiones y generar las estadísticas que no se transfieren.
docker compose exec db psql -U postgres \
  -f /var/lib/postgresql/update_extensions.sql
docker compose exec db vacuumdb -U postgres --all \
  --analyze-in-stages --missing-stats-only
El primer fichero subió btree_gist de 1.8 a 1.9 y pg_stat_statements de 1.12 a 1.13. La base arrancó con data_directory en /var/lib/postgresql/19/docker y con las 2 000 000 filas de cuentas y las 100 000 de accesos.
Repetí el laboratorio con --copy para comparar el disco: el volumen completo ocupó 1765 MB con --link y 2427 MB con --copy, 662 MB más, casi el tamaño de la base. En tiempo, pg_upgrade tardó 1,61 s de mediana con --link y 2,65 s con --copy, en tres ejecuciones de cada modo con carga por debajo de 3 al empezar. Con 684 MB la diferencia es pequeña, pero --copy crece con el tamaño de la base y --link no.
Qué incompatibilidades encontré al actualizar
Seis problemas aparecieron durante las pruebas, y pg_upgrade --check solo avisa del primero:
- Índices GiST de btree_gist sobre
inetocidr:pg_upgradese niega a seguir; recréalos coninet_opsantes de actualizar pg_hba.confsin la regla de Docker: elinitdbdel script no añade la líneahost all all all scram-sha-256que escribe el entrypoint de la imagen, y la primera conexión desde otro contenedor falló conno pg_hba.conf entry for host; por eso el script copia el fichero de la 18io_workersya no existe: uncommand: -c io_workers=3que funcionaba en la 18 hace que la 19 se detenga conFATAL: unrecognized configuration parameter "io_workers"; en su lugar estánio_min_workerseio_max_workers- Volcados de un
pg_dumpantiguo constandard_conforming_strings = off: al restaurar en la 19,SET standard_conforming_strings = offda error y un valor por defecto'C:\\datos'quedó guardado comoC:\\datos, con la barra duplicada y sin avisar; volcando la misma base 18 con elpg_dumpde la 19 se restauró bien - Contraseñas MD5: siguen funcionando, pero la 19 avisa al crearlas (
setting an MD5-encrypted password) y en cada inicio de sesión (authenticated with an MD5-encrypted password); el aviso se apaga conmd5_password_warnings - Cambiar solo la etiqueta de la imagen: arrancar
postgres:19beta4sobre un volumen de la 18 no borra nada, pero el contenedor sale con código 1 y el mensajethere appears to be PostgreSQL data in: /var/lib/postgresql/18/docker
Las notas recogen más cambios que no me afectaron. RADIUS desaparece, se elimina la codificación MULE_INTERNAL y los nombres de base de datos, rol o tablespace ya no admiten saltos de línea; pg_upgrade rechaza los clústeres que los usan. Si tu clúster usa alguno, pg_upgrade --check o una restauración de prueba te lo dirán antes del corte.
¿Conviene actualizar ya o esperar a la 19.1?
Para producción, espera al menos a la primera versión menor de la 19 y usa este tiempo para ensayar. La 18 tiene soporte hasta el 14 de noviembre de 2030 según la política de versiones de PostgreSQL[10], así que no hay prisa. Además, la Beta 4 demostró que las funciones pueden cambiar hasta el final. Lo que sí puedes hacer ya es lanzar pg_upgrade --check contra una copia del volumen con la imagen de arriba, revisar tus parámetros de arranque y rehacer los volcados con el pg_dump nuevo.
REPACK (CONCURRENTLY) es la razón de más peso para dar el salto si hoy dependes de pg_repack o programas ventanas de mantenimiento para VACUUM FULL. Pesa menos si tus tablas tienen poco espacio muerto, porque el autovacuum normal ya reutiliza ese hueco sin reescribir nada. Si vienes de la 17, las optimizaciones de PostgreSQL 17 siguen vigentes y se suman a estas.
Preguntas frecuentes
¿REPACK sustituye a la extensión pg_repack?
Cubre su caso principal, compactar una tabla sin bloquear las escrituras, y viene en el núcleo desde la 19. Tiene las restricciones que describe la documentación de REPACK: exige clave primaria o índice de identidad de réplica, no admite tablas particionadas y no es seguro para MVCC.
¿Puedo cambiar la etiqueta de la imagen de postgres:18 a postgres:19 y ya está?
No. El contenedor de la 19 se detiene al ver datos en /var/lib/postgresql/18/docker y no los toca. Necesitas pg_upgrade, con los binarios de las dos versiones, o volcar con el pg_dump de la 19 y restaurar.
¿Cuándo sale la versión final de PostgreSQL 19?
La hoja de ruta la preveía para octubre de 2026. El 28 de septiembre se había publicado la Beta 4 y la release candidate estaba prevista para principios de octubre; consulta la página de noticias de postgresql.org para la fecha exacta.
Conclusión
PostgreSQL 19 trae la función de mantenimiento que más se echaba en falta en el núcleo. REPACK (CONCURRENTLY) compactó una tabla de 1895 MB a 474 MB con escrituras en marcha y sin perder ninguna. A cambio exige clave primaria, espacio para una copia y cuidado con las transacciones largas en REPEATABLE READ.
WAIT FOR y las secuencias en replicación lógica facilitan las réplicas de lectura y las migraciones con cambio de primario. Antes de actualizar, ensaya pg_upgrade --check con una imagen que lleve las dos versiones y rehaz los volcados con el pg_dump de la 19.
Fuentes: [1] Notas de la versión 19 de PostgreSQL[3], [2] Anuncio de PostgreSQL 19 Beta 4[2], [3] Hoja de ruta de PostgreSQL[1], [4] Documentación de REPACK[5], [5] Salvedades de MVCC[7], [6] Documentación de WAIT[8], [7] Documentación de la imagen oficial de postgres[4], [8] README de pg_repack[6], [9] Política de versiones de PostgreSQL[10], [10] Documentación de pg_plan_advice[9].