Cómo usar OpenCode con modelos locales en llama.cpp y Ollama
Índice de contenidos
- Puntos clave
- Qué es OpenCode y quién lo mantiene
- Qué necesitas antes de empezar
- Cómo instalar OpenCode y fijar la versión
- Cómo arrancar llama-server con un modelo que llame a herramientas
- Cómo configurar opencode.json para un servidor local
- Qué cambia si usas Ollama
- Cuántos tokens envía OpenCode antes de leer tu mensaje
- Qué permisos preguntan y qué dejan pasar
- Una tarea real con Qwen3.5-4B en CPU
- Qué hay de cierto en las críticas a OpenCode
- Qué ajustes cambiar para no depender de servicios remotos
- Preguntas frecuentes
- ¿Qué modelo local funciona con OpenCode?
- ¿Cuánto contexto necesita OpenCode?
- ¿OpenCode envía datos fuera si uso un modelo local?
- Conclusión
- Fuentes
OpenCode habla con cualquier servidor compatible con la API de OpenAI, y eso incluye un llama-server en tu propia máquina. OpenCode[1] es un agente de programación de código abierto que trabaja en la terminal: lee tu proyecto, edita ficheros y ejecuta comandos. He probado la versión 1.18.31 contra Qwen3.5-4B en CPU, he registrado cada petición que envía y he contado sus tokens. Aquí tienes la configuración que funcionó, lo que cuesta cada turno y los ajustes que conviene cambiar antes de fiarte de sus valores por defecto.
Puntos clave
- OpenCode 1.18.31 salió el 14 de septiembre de 2026 con licencia MIT. El repositorio vive ahora en
anomalyco/opencodey la dirección antiguasst/opencoderedirige allí. - Un modelo local se declara como proveedor
@ai-sdk/openai-compatiblecon subaseURLy sulimit.contextenopencode.json. - El primer turno envió 7.516 tokens al servidor (10 herramientas y 9.733 caracteres de prompt de sistema), más una petición aparte de 558 tokens para titular la sesión.
- Denegar cuatro herramientas que no usas (
webfetch,task,todowriteyskill) las quita de la petición y deja el primer turno en 5.335 tokens, un 29 % menos. - Qwen3.5-4B arregló un bug acotado en 3 de 3 intentos, con cuatro llamadas a herramientas y una mediana de 217 s. En una tarea más abierta se saltó el
AGENTS.mde instaló numpy fuera del proyecto. - Los permisos por defecto dejan hacer casi todo sin preguntar, y el filtro de comandos compara texto: trátalo como un freno, no como un aislamiento.
Qué es OpenCode y quién lo mantiene
OpenCode es un agente de programación que funciona en la terminal, como aplicación de escritorio (en beta) o dentro del editor. Lo mantiene Anomaly, la empresa que firma la web opencode.ai[2], y el código se publica con licencia MIT.
El proyecto nació como sst/opencode. Hoy GitHub responde a esa dirección con una redirección permanente a anomalyco/opencode, que el 14 de septiembre de 2026 sumaba 207.375 estrellas. La web afirma que lo usan más de 16 millones de desarrolladores al mes; es una cifra del propio proyecto y no he podido contrastarla.
Publica versiones a un ritmo que obliga a fijar la que pruebas. Entre la 1.18.17 (12 de agosto) y la 1.18.31[3] (14 de septiembre) salieron 15 versiones. GitHub muestra además etiquetas v2.0.0 a v2.0.3 del 11 y 12 de septiembre, pero sin binarios ni paquete en npm, así que la rama estable sigue siendo la 1.18.
Qué necesitas antes de empezar
OpenCode no ejecuta el modelo: se limita a enviar peticiones a un servidor. Para trabajar con un modelo en tu propia máquina necesitas cuatro piezas:
- Un servidor compatible con OpenAI: llama-server, que viene con llama.cpp, u Ollama
- Un modelo entrenado para llamar a herramientas, porque OpenCode edita ficheros y ejecuta comandos a través de ellas
- Contexto suficiente: el primer turno ya pasa de 7.500 tokens y la tarea de prueba llegó a 8.932
- Node.js para instalar con npm, o el script oficial de instalación
Si nunca has visto cómo pide un modelo local que se ejecute una función, la guía de function calling con Ollama lo explica paso a paso.
Mi banco de pruebas fue un contenedor linux/arm64 con 18 núcleos, 121 GB de RAM y sin GPU. Lo compartía con otros procesos que mantuvieron la carga media entre 20 y 40 durante las mediciones. Los tiempos que verás son pesimistas por esa razón; los recuentos de tokens no dependen de la máquina.
Cómo instalar OpenCode y fijar la versión
El paquete de npm se llama opencode-ai y descarga un binario nativo para tu plataforma:
npm install -g opencode-ai@1.18.31
opencode --version
En Linux arm64 instaló dos paquetes y un binario de 176 MiB. El script oficial (curl -fsSL https://opencode.ai/install | bash) y Homebrew (brew install anomalyco/tap/opencode) llegan al mismo resultado.
Desactiva la actualización automática antes del primer arranque. OpenCode descarga versiones nuevas al iniciarse, y con 15 versiones en 33 días tu configuración puede cambiar de comportamiento entre dos sesiones. Añade "autoupdate": false a tu configuración o exporta OPENCODE_DISABLE_AUTOUPDATE=1.
Yo lo ejecuté con HOME y las variables XDG_CONFIG_HOME, XDG_DATA_HOME y XDG_CACHE_HOME apuntando a un directorio desechable. Así la prueba no tocó mi configuración real, y al terminar bastó con borrar ese directorio.
Cómo arrancar llama-server con un modelo que llame a herramientas
Usé la imagen oficial ghcr.io/ggml-org/llama.cpp:server para arm64, versión 0.4.1-dev (build 10969, commit 391fac164), con el GGUF Qwen3.5-4B en Q4_K_M de unsloth[4]. El fichero pesa 2,74 GB y el modelo tiene licencia Apache-2.0:
docker run -d --name llama -p 127.0.0.1:8080:8080 \
  -v "$HOME/models:/models:ro" \
  ghcr.io/ggml-org/llama.cpp:server \
  -m /models/Qwen3.5-4B-Q4_K_M.gguf -a qwen3.5-4b \
  -c 32768 -np 1 -t 4 --reasoning off \
  --host 0.0.0.0 --port 8080
Con el modelo cargado, el contenedor ocupó 3,7 GiB de RAM. Cada opción cumple una función concreta:
-a qwen3.5-4b: el alias con el que el servidor se anuncia en/v1/models. Usa el mismo identificador en OpenCode y no tendrás dudas sobre qué modelo responde.-c 32768: la ventana de contexto en tokens. Tiene que caber el primer turno entero y el historial que se va acumulando.-np 1: una sola ranura (slot), para que los 32.768 tokens sean de una única conversación. El registro lo confirma conn_slots = 1, n_ctx_slot = 32768.-t 4: los hilos de CPU. En una máquina cargada, pedir más hilos que núcleos libres empeora la generación; ajústalo a lo que tengas disponible.--reasoning off: Qwen3.5 razona por defecto según su ficha de modelo[5], y en CPU ese razonamiento multiplica el tiempo de cada respuesta.
Las llamadas a herramientas dependen de las plantillas Jinja, que en esta build ya vienen activadas; la documentación de function calling de llama.cpp[6] explica qué formatos reconoce.
Cómo configurar opencode.json para un servidor local
La configuración global va en ~/.config/opencode/opencode.json. Este fichero reúne lo que probé, con la URL adaptada al puerto del ejemplo anterior:
{
  "$schema": "https://opencode.ai/config.json",
  "model": "llamacpp/qwen3.5-4b",
  "small_model": "llamacpp/qwen3.5-4b",
  "enabled_providers": ["llamacpp"],
  "provider": {
    "llamacpp": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "llama-server (local)",
      "options": { "baseURL": "http://127.0.0.1:8080/v1" },
      "models": {
        "qwen3.5-4b": {
          "name": "Qwen3.5 4B Q4_K_M",
          "tool_call": true,
          "reasoning": false,
          "limit": { "context": 32768, "output": 8192 }
        }
      }
    }
  }
}
Cada clave tiene un efecto que pude comprobar en las peticiones:
provider.llamacpp: un identificador libre. El modelo se referencia después comollamacpp/qwen3.5-4b.npm:@ai-sdk/openai-compatiblehabla con/v1/chat/completions, que es lo que exponen llama-server y Ollama.models.<id>: OpenCode envía ese identificador tal cual en el campomodelde cada petición.limit:outputse convierte enmax_tokens: 8192, ycontextle dice a OpenCode cuánto espacio le queda antes de compactar.small_model: el modelo que genera el título de la sesión. Si no hay uno barato disponible, la documentación de configuración[7] indica que usa el principal.enabled_providers: deja solo tu proveedor local en la lista de modelos.
La documentación de proveedores[8] resume así el papel del límite: "The limit fields allow OpenCode to understand how much context you have left. Standard providers pull these from models.dev automatically." Un modelo local no está en models.dev, así que si omites limit, OpenCode no sabe cuándo se acerca al final de la ventana.
La última clave importa más de lo que parece. En una instalación limpia y sin credenciales, opencode models me listó siete modelos remotos gratuitos del proveedor opencode. Con enabled_providers solo apareció llamacpp/qwen3.5-4b, así que un nombre de modelo mal escrito ya no puede acabar en un proveedor remoto.
Qué cambia si usas Ollama
Con Ollama la configuración es la misma con otra baseURL, http://localhost:11434/v1, y el nombre del modelo tal como aparece en ollama list. La trampa está en el contexto. La documentación de Ollama sobre la longitud de contexto[9] fija el valor por defecto según la VRAM. Son 4k con menos de 24 GiB, 32k entre 24 y 48 GiB y 256k a partir de 48 GiB.
Lo comprobé con Ollama 0.34.0 en el mismo contenedor sin GPU. El registro arrancó con default_num_ctx=4096, y la primera petición de OpenCode (6.378 tokens con ocho herramientas) se recortó sin devolver ningún error. Esta es la línea del registro, partida en tres para que quepa:
level=WARN source=llama_server.go:317
msg="truncating input prompt"
limit=2050 prompt=6378 keep=4 new=2050
La respuesta llegó con código 200, prompt_tokens: 2050 y un texto en lugar de una llamada a herramienta: [use the run tests tool to execute the test suite]. Desde OpenCode eso parece un modelo torpe, no un contexto recortado. Para esa medición reenvié a Ollama la petición que OpenCode había generado, porque qwen3.5:4b razona por defecto y la petición del título seguía sin terminar a los cinco minutos.
La solución es arrancar Ollama con más contexto. La guía de integración de Ollama con OpenCode[10] pide 64k, y también ofrece ollama launch opencode para arrancar OpenCode ya configurado:
OLLAMA_CONTEXT_LENGTH=32768 ollama serve
ollama ps
Con OLLAMA_CONTEXT_LENGTH=32768, la misma petición entró entera: 6.380 tokens en una ranura de 32.768, sin aviso de recorte, y ollama ps mostró CONTEXT 32768.
Cuántos tokens envía OpenCode antes de leer tu mensaje
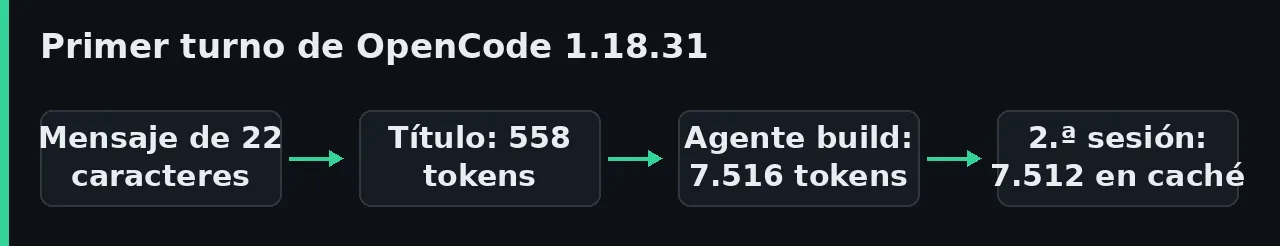
Con un mensaje de 22 caracteres, "Reply with exactly: OK", OpenCode 1.18.31 envió 8.074 tokens repartidos en dos peticiones. Lo medí con un proxy de registro entre OpenCode y llama-server, y tomé los tokens del campo usage.prompt_tokens que devuelve el propio servidor.
| Petición | Herramientas | Tokens de prompt | En caché |
|---|---|---|---|
| Título de la sesión | 0 | 558 | 0 |
| Agente build, configuración por defecto | 10 | 7.516 | 0 |
| Agente build, 2.ª y 3.ª ejecución | 10 | 7.516 | 7.512 |
Agente build sin webfetch, task, todowrite ni skill |
6 | 5.335 | 0 |
El prompt de sistema ocupa 9.733 caracteres, unos 2.200 tokens con el tokenizador de Qwen3.5. El resto son las definiciones de herramientas: 21.144 caracteres de JSON, de los que la definición de bash se lleva 5.310. La cifra encaja con la medición de Systima[11], que llegó a 706 puntos en Hacker News[12]. Systima contó unos 6.900 tokens para OpenCode 1.17.18 y unos 32.800 para Claude Code, ambos con un modelo de Anthropic y otro tokenizador.
La caché es la buena noticia. La segunda y la tercera ejecución enviaron un prefijo idéntico byte a byte, llama-server reutilizó 7.512 de los 7.516 tokens y cada ejecución terminó en unos 3 s. Con la caché vacía, procesar esos 7.516 tokens costó una mediana de 137 s en tres repeticiones, con una carga media de entre 12 y 16 y cuatro hilos. Hay una excepción: el prompt incluye la fecha del día (Today's date: Mon Sep 14 2026), así que la primera petición después de medianoche vuelve a procesar el prefijo entero.
El AGENTS.md del proyecto también entra en el prompt de sistema. En la tarea de prueba, un AGENTS.md de tres líneas y la herramienta question, que aparece al usar opencode serve, subieron la primera petición a 7.706 tokens.
Qué permisos preguntan y qué dejan pasar
Los valores por defecto de OpenCode son permisivos. Según la documentación de permisos[13], casi todas las acciones están en allow; solo external_directory y doom_loop preguntan, y la lectura de ficheros .env está denegada. Para la prueba restringí la edición y los comandos en el opencode.json del proyecto:
{
  "$schema": "https://opencode.ai/config.json",
  "permission": {
    "edit": "ask",
    "webfetch": "deny",
    "bash": {
      "*": "ask",
      "python3 -m unittest*": "allow",
      "git status*": "allow",
      "git diff*": "allow",
      "git commit *": "deny",
      "git push *": "deny"
    }
  }
}
La regla que coincide en último lugar gana, por eso el comodín * va primero. Una herramienta denegada por completo desaparece de la lista que recibe el modelo, lo que además ahorra tokens. Una aprobación con always dura hasta que cierras la sesión.
En la práctica, el filtro compara el texto del comando. En el segundo intento, el modelo ejecutó python3 -m unittest -v 2>&1 | head -100, y como head no estaba en la lista, OpenCode preguntó. Lo revelador fue la sugerencia para always: python3 * y head *. Aceptarla habría autorizado cualquier script de Python durante el resto de la sesión.
Hay un segundo límite en el código. En shell.ts de la versión 1.18.31, la comprobación de rutas fuera del proyecto solo se aplica a una lista fija de órdenes (cd, rm, cp, mv, mkdir, touch, chmod, chown y cat). Un python3 -c que escriba en otro directorio no pasa por esa comprobación. Si el repositorio no es tuyo, ejecuta OpenCode dentro de un contenedor o de una máquina virtual.
Una tarea real con Qwen3.5-4B en CPU
La prueba fue un repositorio desechable con un stats.py cuya función median fallaba con listas de longitud par. Tenía cuatro pruebas, una en rojo, y el prompt pedía arreglar el fallo sin tocar test_stats.py. Lancé la misma tarea tres veces sobre opencode serve, respondiendo "once" a cada petición de permiso.
Las tres ejecuciones siguieron el mismo camino de cuatro herramientas:
bashpara lanzarpython3 -m unittest -vy ver el falloreadsobrestats.pyeditpara añadir el caso de longitud par, que pidió permisobashde nuevo para confirmar que las cuatro pruebas pasaban
El cambio fue el correcto las tres veces, dos líneas que promedian los dos elementos centrales, y test_stats.py quedó intacto. La primera ejecución tardó 335 s con la caché vacía; las otras dos, 123 s y 217 s con el prefijo ya en caché. La mediana de generación fue de 6,3 tokens por segundo con la carga media entre 25 y 38.
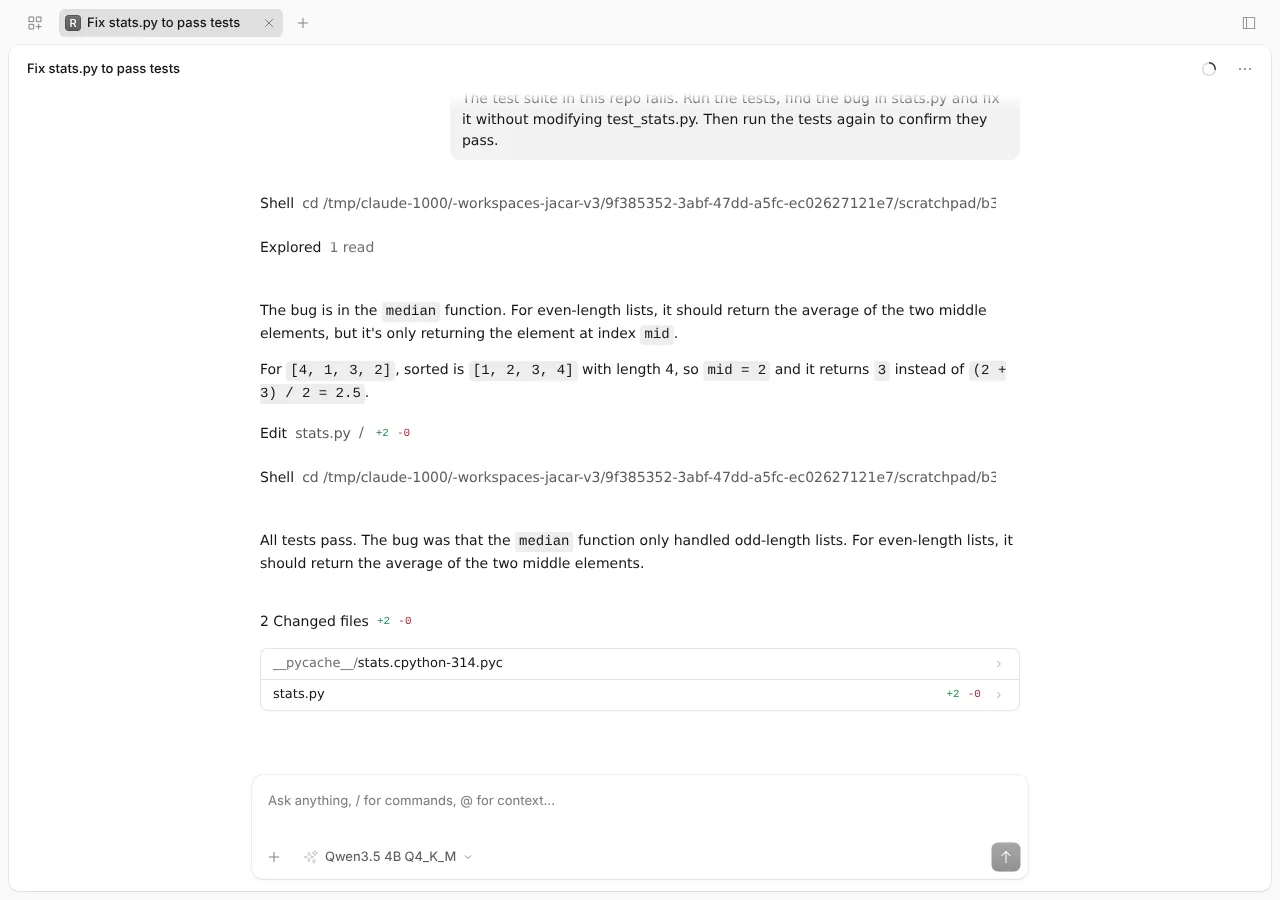
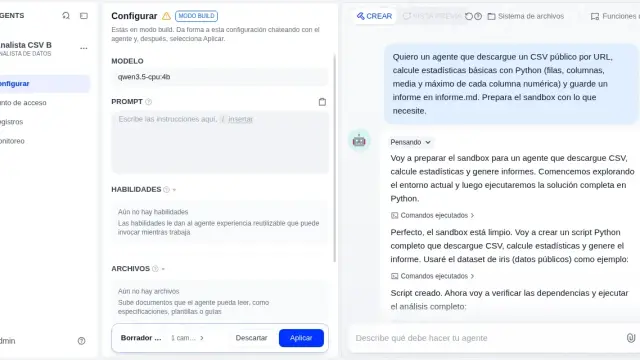
La captura es la segunda ejecución vista en la interfaz web que sirve el propio opencode serve. Esa interfaz cargó sin una sola petición a hosts externos.
La segunda prueba fue más abierta y salió mal, lo que también es información. Pedí una función percentile con interpolación lineal, las pruebas en un fichero nuevo test_percentile.py y la batería completa en verde. El agente principal delegó el trabajo en un subagente con la herramienta task, y ese subagente hizo cuatro cosas que no debía:
- importó numpy en
stats.pyen lugar de escribir la interpolación - añadió las pruebas a
test_stats.py, aunque el prompt pedía un fichero nuevo y elAGENTS.mdprohíbe tocar las pruebas - escribió dos valores esperados erróneos: 1,6 y 4,4 donde numpy devuelve 1,4 y 4,6
- ejecutó
pip install numpy -qcuando la importación falló
Mi script respondía "once" a todas las peticiones de permiso, igual que alguien que aprueba sin leer. Resultado: numpy 2.5.3 acabó instalado en el Python global del contenedor. Paré la sesión a los cinco minutos, con 10 de 12 pruebas en verde, y desinstalé el paquete. Ninguna protección de directorio saltó, porque pip no está en la lista de órdenes cuyas rutas comprueba OpenCode.
Un modelo de 4B basta para un arreglo acotado con pruebas que ya existen. Cuando la tarea obliga a decidir, por ejemplo si añadir una dependencia o dónde van las pruebas, se salta las instrucciones, y los permisos pasan a ser la última barrera. Desde entonces deniego task con modelos pequeños.
Qué hay de cierto en las críticas a OpenCode
La crítica más citada es Stop Using OpenCode[14], que llegó a 420 puntos en Hacker News[12] el 20 de julio de 2026. Su autor la escribió probando OpenCode con un modelo local, y la resume sin rodeos: "Textual command filtering is entirely useless." Contrasté cada punto con la versión 1.18.31:
| Crítica | Estado en 1.18.31 | Cómo lo comprobé |
|---|---|---|
| La poda de resultados de herramientas invalida la caché | Corregido: compaction.prune vale false por defecto |
Código de compaction.ts y documentación |
Las aprobaciones always se guardan entre sesiones |
Corregido: duran hasta cerrar la sesión | Documentación de permisos y código |
| La fecha en el prompt rompe la caché a medianoche | Sigue igual | Prompt capturado con Today's date |
El filtro de bash compara texto |
Sigue igual | Sugerencia python3 * y lista fija en shell.ts |
| Configuración remota por defecto | Sigue igual | Siete modelos remotos y un catálogo de 4,66 MB descargado al arrancar |
El fallo de seguridad más grave ya está cerrado. El aviso CVE-2026-22812[15] describe un servidor HTTP sin autenticación y con CORS abierto que permitía ejecutar comandos desde cualquier web visitada. Tiene una puntuación CVSS de 8,8 y se corrigió en la versión 1.0.216, publicada el 30 de diciembre de 2025. El propio aviso indica que el informe inicial, enviado por correo el 17 de noviembre de 2025, no recibió respuesta.
Mi lectura es mixta. El diseño del prompt le sienta bien a la inferencia local: es corto, estable y cabe en la caché. El modelo de permisos, en cambio, sigue confiando demasiado en que el modelo no haga nada raro.
Qué ajustes cambiar para no depender de servicios remotos
Estos son los valores que cambié, con su valor por defecto al lado:
| Ajuste | Por defecto | Para uso local |
|---|---|---|
autoupdate |
true |
false |
share |
manual |
disabled |
enabled_providers |
todos | ["llamacpp"] |
OPENCODE_DISABLE_MODELS_FETCH |
descarga el catálogo al arrancar y cada 60 minutos | 1 |
permission.edit |
allow |
ask |
permission.webfetch |
allow |
deny |
OPENCODE_DISABLE_CLAUDE_CODE |
lee ~/.claude/CLAUDE.md y .claude/skills |
1 si no quieres mezclar configuraciones |
El catálogo sale de models.opencode.ai (4.660.655 bytes, el mismo tamaño que el api.json de models.dev), y el código de la versión 1.18.31 lo refresca cada 60 minutos. Con OPENCODE_DISABLE_MODELS_FETCH=1 no se descargó en una instalación limpia.
Hay otra descarga que ningún ajuste de esta tabla evita: en el primer arranque, OpenCode crea un package.json en ~/.config/opencode e instala desde npm @opencode-ai/plugin 1.18.31, 62 MB de node_modules. El modo manual no publica nada si no escribes /share. La documentación de share[16] explica que una sesión compartida se sincroniza con los servidores del proyecto; con disabled en el fichero del repositorio, nadie del equipo puede compartir.
Si vienes de otro agente, la comparativa de Claude Code, Codex CLI y Muse Code y la guía de Goose, el agente de Block cubren las alternativas. Para otro arnés que también funciona con un modelo local, mira DeepSeek Harness con un modelo local.
Preguntas frecuentes
¿Qué modelo local funciona con OpenCode?
Cualquiera que el servidor exponga con llamadas a herramientas. Qwen3.5-4B en Q4_K_M resolvió la tarea de prueba en 3 de 3 intentos, y la documentación de OpenCode usa Qwen3-Coder 30B-A3B como ejemplo para llama.cpp. Evita modelos sin plantilla de herramientas: sin ellas, OpenCode no puede leer ni editar ficheros.
¿Cuánto contexto necesita OpenCode?
El primer turno ocupa entre 5.335 y 7.516 tokens según las herramientas activas, y la tarea de prueba acabó en 8.932. La documentación de OpenCode recomienda subir num_ctx en Ollama a entre 16k y 32k si fallan las llamadas a herramientas, y la de Ollama pide 64k para OpenCode. Con 32k no tuve problemas en tareas cortas.
¿OpenCode envía datos fuera si uso un modelo local?
Los prompts van solo a tu servidor, pero el programa sí sale a Internet. Descarga el catálogo de modelos desde models.opencode.ai al arrancar, instala su paquete de plugins desde npm la primera vez y busca actualizaciones si no lo desactivas. Con enabled_providers, autoupdate: false, share: "disabled" y OPENCODE_DISABLE_MODELS_FETCH=1 cierras las vías del catálogo, las actualizaciones y la compartición.
Conclusión
OpenCode con un modelo local funciona hoy con una configuración de 21 líneas, y su prompt corto y estable encaja con la caché de llama-server mejor que el de agentes más pesados. Lo que no conviene es aceptar sus valores por defecto: fija la versión, deja un único proveedor, restringe la edición y los comandos, y ejecútalo en un contenedor si el código no es tuyo. Tienes la versión en inglés de esta guía si quieres compartirla con tu equipo.
Fuentes
- OpenCode
- opencode.ai
- 1.18.31
- Qwen3.5-4B en Q4_K_M de unsloth
- ficha de modelo
- documentación de function calling de llama.cpp
- documentación de configuración
- documentación de proveedores
- documentación de Ollama sobre la longitud de contexto
- guía de integración de Ollama con OpenCode
- medición de Systima
- 706 puntos en Hacker News
- documentación de permisos
- Stop Using OpenCode
- aviso CVE-2026-22812
- documentación de share
Código fuente
Accede a todo el código fuente de este artículo en GitHub.
Ver en GitHub