Espresso es una biblioteca en Swift que compila programas MIL directamente para el Neural Engine de los Mac con Apple Silicon mediante APIs privadas, sin Core ML. En un modelo de 6 capas en un M3 Max genera 519 tokens por segundo frente a 152 de Core ML; con modelos reales como Qwen2.5 la atención sigue en la CPU.
oMLX sirve modelos de texto a voz (TTS) en un Mac con Apple Silicon con la misma API que OpenAI. Con POST /v1/audio/speech pides audio con una voz predefinida, una voz descrita en lenguaje natural o una voz clonada desde unos segundos de referencia. En un M5 Max, Qwen3-TTS 1.7B genera cada segundo de audio en 0,33 s.
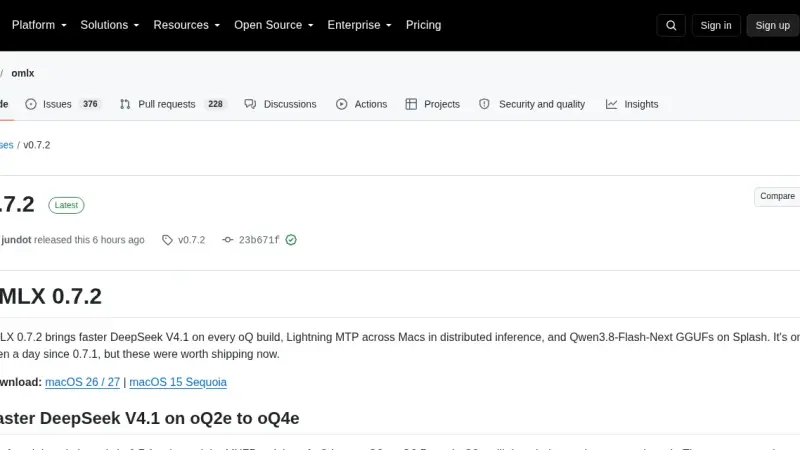
oMLX 0.7.2, publicado el 21 de octubre de 2026, un día después de la 0.7.1, acelera DeepSeek V4.1 en los cuantizados oQ2e a oQ4e, activa Lightning MTP en clústeres de dos o más Mac, ejecuta en Splash los GGUF de Qwen3.8-Flash-Next y deja de repetir el prefill entero en cada turno de Claude Code. Se actualiza desde la app, Homebrew o el código fuente.
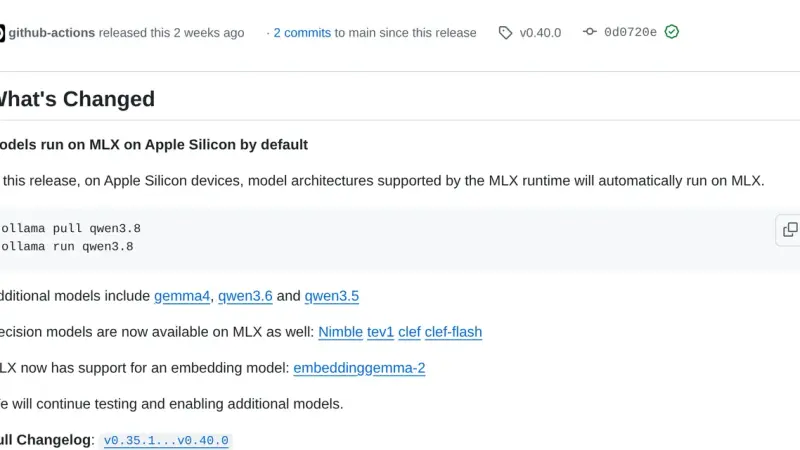
Desde Ollama 0.40, publicado el 25 de septiembre de 2026, los modelos con arquitectura compatible se ejecutan con MLX en los Mac con Apple Silicon en lugar de con llama.cpp. Ollama elige la variante del modelo al descargarlo y el comando ollama ps muestra en la columna RUNNER qué motor la sirve. En Linux y Windows sigue mandando llama.cpp.
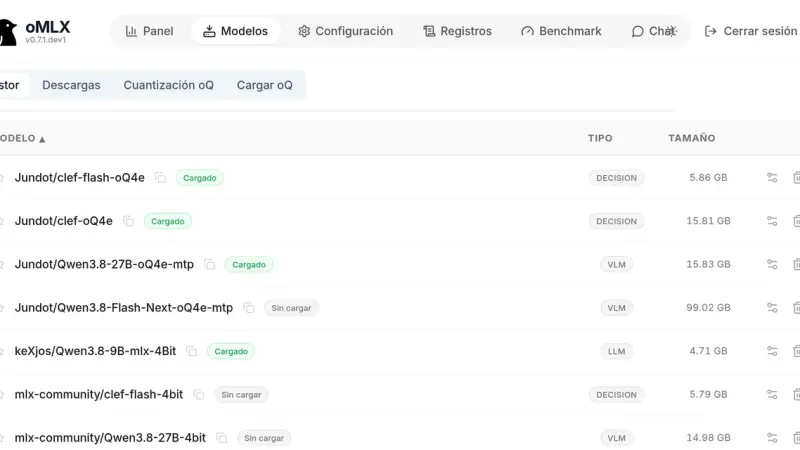
Desde oMLX 0.7.1.dev1, un mismo servidor en el Mac sirve Qwen por /v1/chat/completions y los modelos de decisión Clef por /v1/systemone. En un M5 Max, Clef-flash decidió cada ticket en 111 ms y, con Qwen escribiendo la respuesta, el triaje acertó 39 de 40 etiquetas frente a 34 con Qwen solo.
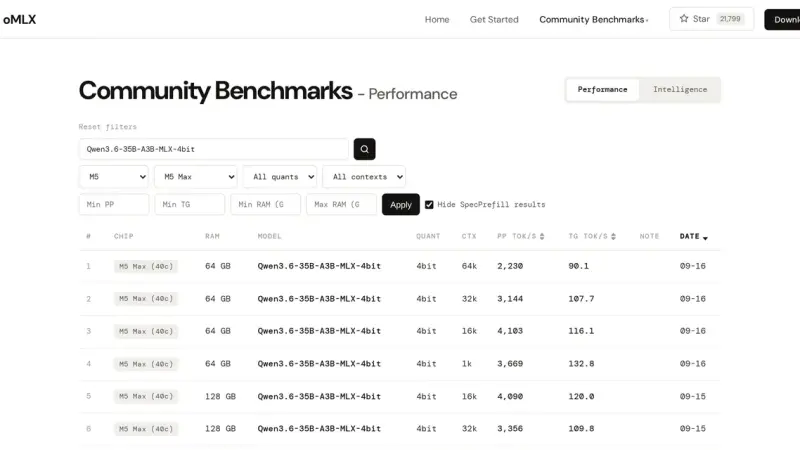
Una cifra de tokens por segundo de oMLX solo sirve si dice la longitud del prompt, la vía de medida, el estado de la caché y el del Mac. En un M5 Max, el primer token de Qwen3.8-27B pasó de 1,12 a 65,5 segundos entre 1k y 32k de prompt. El techo de memoria por defecto deja para macOS el 8 % de la RAM, entre 3 y 8 GB.
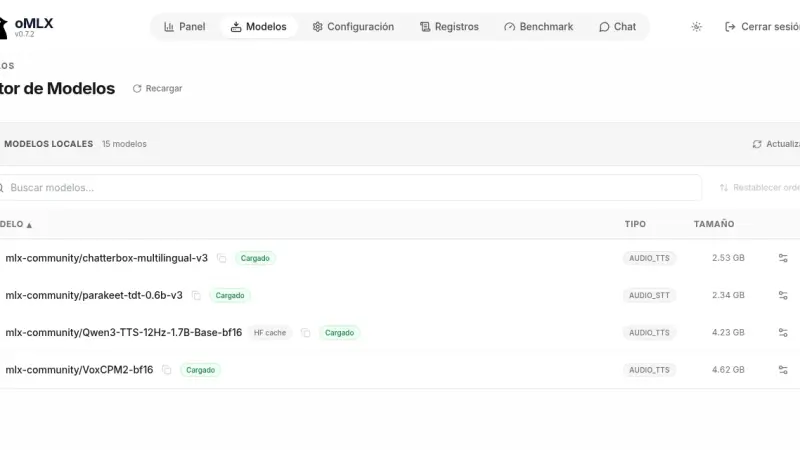
oMLX es un servidor de inferencia local para Mac con Apple Silicon que envuelve el framework MLX de Apple y lo expone con las API de OpenAI y de Anthropic. Desde Ollama 0.40 los tres grandes servidores usan MLX en un Mac, así que lo que distingue a oMLX es la memoria: varios modelos cargados con expulsión y fijado, y una caché KV en el SSD que sobrevive a los reinicios.
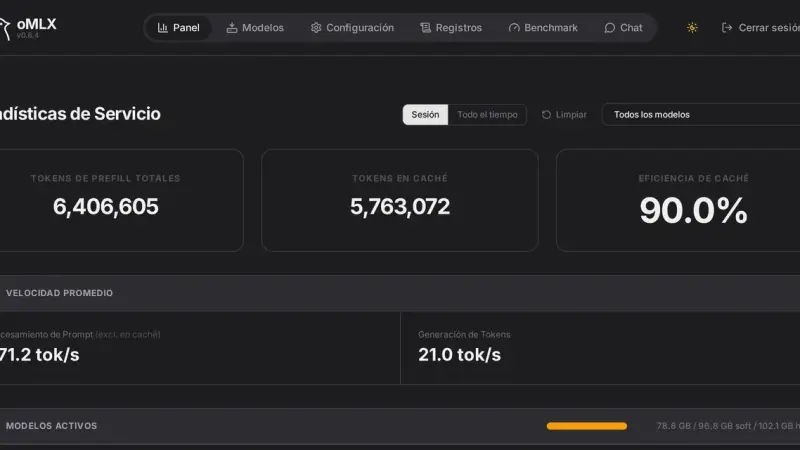
El panel de oMLX vive en localhost:8000/admin y reúne monitorización, carga y descarga de modelos, chat con historial, descargador de Hugging Face, benchmarks y ajustes por modelo. La línea de comandos cubre lo demás con cuatro órdenes: serve, start, stop y launch, esta última para conectar clientes externos.
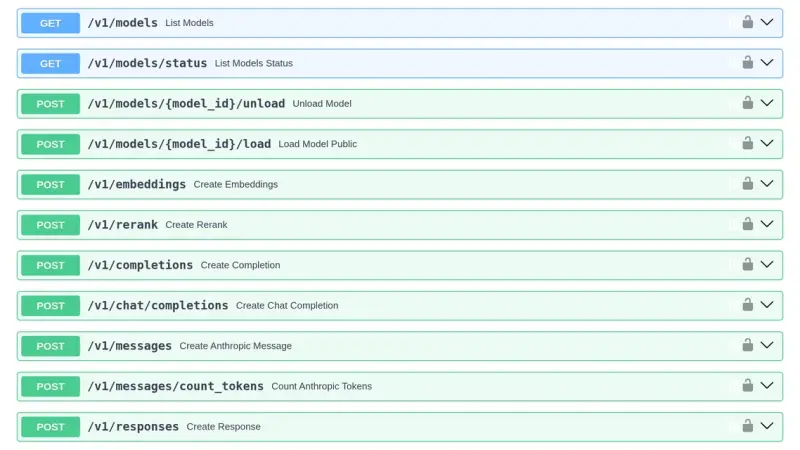
oMLX 0.7.2 escucha en 127.0.0.1:8000 y sirve la API de OpenAI y la Messages API de Anthropic en el mismo puerto. La clave viaja en Authorization: Bearer o en x-api-key y es obligatoria en cuanto el servidor escucha fuera de loopback. Los errores llegan en el formato de OpenAI, y el puerto se cambia con --port, OMLX_PORT o la sección server de settings.json.
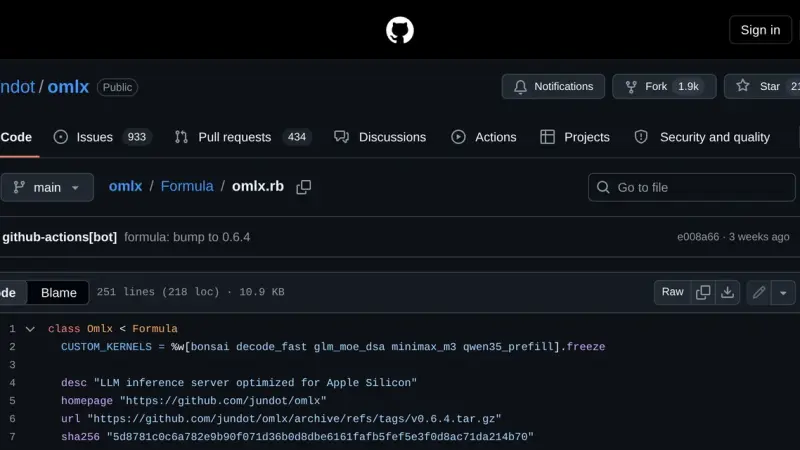
oMLX se instala con Homebrew en dos órdenes: primero el tap del repositorio de jundot y después la fórmula. Queda un servicio de launchd que arranca con omlx start, un registro en la carpeta var de Homebrew y una actualización con brew upgrade. La versión actual es la 0.6.4, del 29 de agosto de 2026.
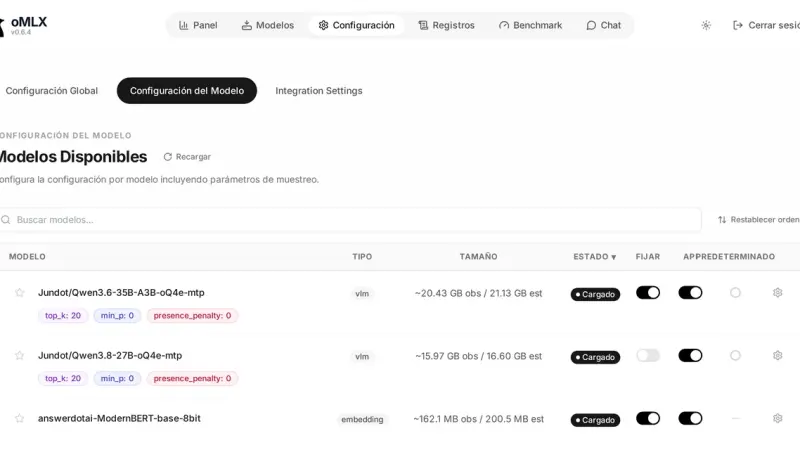
oMLX gestiona el ciclo de vida de cada modelo con cuatro piezas: un descargador que trae pesos desde Hugging Face, alias que renombran el modelo en la API, un TTL que lo descarga tras un tiempo inactivo y una caché KV por niveles que vuelca bloques al SSD cuando la RAM se llena.
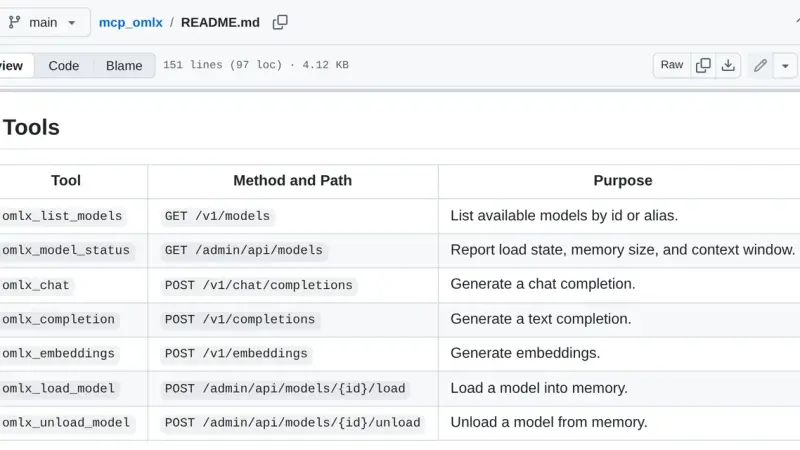
oMLX MCP es un puente que expone tu servidor local de oMLX como herramientas del Model Context Protocol. Con el paquete mcp_omlx conectas Claude Desktop a los modelos que corren en tu Mac y ganas siete herramientas para listar modelos, cargarlos y liberarlos de memoria, y lanzar inferencias sin salir del cliente.
Receta para oMLX 0.6.4 en un Mac M5 Max con 128 GB: instalación, Claude Code y ajustes avanzados con capturas (Lightning MTP, VLM MTP y DFlash). Incluye benchmarks propios de septiembre de 2026, con hasta 1,88x más tokens por segundo.
Guía de 100 aplicaciones imprescindibles para tu Mac M5, organizadas en 20 categorías: navegador, gestor de contraseñas, email, notas, terminal, IDE, contenedores, IA y muchas más. Cada selección incluye propósito, características clave, plugins esenciales, precio en euros y enlace oficial, seleccionadas por consenso comunitario y métricas verificables.
Las NPU dejaron de ser un accesorio para convertirse en el componente que define rendimiento real en portátiles, teléfonos y servidores pequeños. Repaso práctico del hardware que domina 2026, qué cargas compensan y dónde sigue ganando la GPU tradicional.
Las unidades de procesamiento neuronal han dejado de ser una etiqueta de marketing en portátiles Snapdragon, Apple Silicon y AMD Ryzen AI. Repaso qué se puede hacer hoy desde código, qué herramientas están maduras y cuándo compensa mirar a la NPU en lugar de la CPU o la GPU.
Llevo seis meses usando un MacBook Pro con M4 Pro como equipo principal de desarrollo. Cuento qué ha cambiado de verdad respecto al M2 Pro anterior, dónde se nota el salto y dónde la inversión no se justifica si ya tienes un equipo reciente.
M3 y M4 consolidaron la ventaja de Apple Silicon: memoria unificada de hasta 128 GB compartida entre CPU, GPU y Neural Engine, autonomía de 12 a 16 horas en uso real, y un Neural Engine con 38 TOPS que ejecuta modelos de lenguaje grandes en el propio portátil. Para desarrolladores, la diferencia es tangible.
Ollama se consolidó en 2024 como el estándar para ejecutar LLMs en local. Empaqueta llama.cpp en un binario único con interfaz de línea de comandos estilo Docker y API compatible con OpenAI. Phi-3 Mini corre en 4 GB; Llama 3.1 8B Q4 necesita 6 GB. Para tráfico de producción a escala, vLLM sigue siendo la opción correcta.
Qualcomm Snapdragon X Elite es el primer chip ARM que iguala el rendimiento de Apple M3 en portátiles Windows, con más de 22 horas de batería y una NPU de 45 TOPS para IA on-device. Compatible con la mayoría del software vía el emulador Prism, pero aún no apto para gaming con anticheat ni cargas x86 especializadas.
Instalar Ollama en un Mac con Apple Silicon es tan simple como ejecutar un comando de Homebrew. Después, elige el modelo según la RAM disponible (Phi-3 con 8 GB, Llama 3.1 8B con 16 GB) y expón la API HTTP local, compatible con OpenAI, en el puerto 11434 para integrarla en tus propias aplicaciones.
LM Studio es una aplicación de escritorio para Mac, Windows y Linux que descarga y ejecuta modelos de lenguaje grandes en tu propio equipo, con una interfaz de chat pulida y sin necesidad de terminal. Incluye una API compatible con OpenAI y RAG con tus documentos. Para uso individual gana a Ollama en experiencia de usuario; para equipos o producción conviene OpenWebUI, vLLM o TGI.
6 min2934,6
Usamos cookies propias y de terceros para analizar el tráfico del sitio. Puedes aceptarlas, rechazarlas o configurar tu elección.
Más información sobre las cookies
Preferencias de cookies
NecesariasImprescindibles para el funcionamiento del sitio. Siempre activas.
AnalíticasNos ayudan a entender cómo se usa el sitio (Google Analytics).