Sin GPU, en una CPU arm64 de 18 núcleos con llama.cpp v0.4.1, Maple-Preview generó 172,84 tokens/s con 6 hilos: el doble que MiniCPM5-2B y 3,6 veces Spark-X2.5-4B. A cambio ocupa 5,79 GiB de RAM y siempre razona. MiniCPM5 cabe en 3,27 GiB y Spark escribe mejor en español. Los tres inventaron datos.
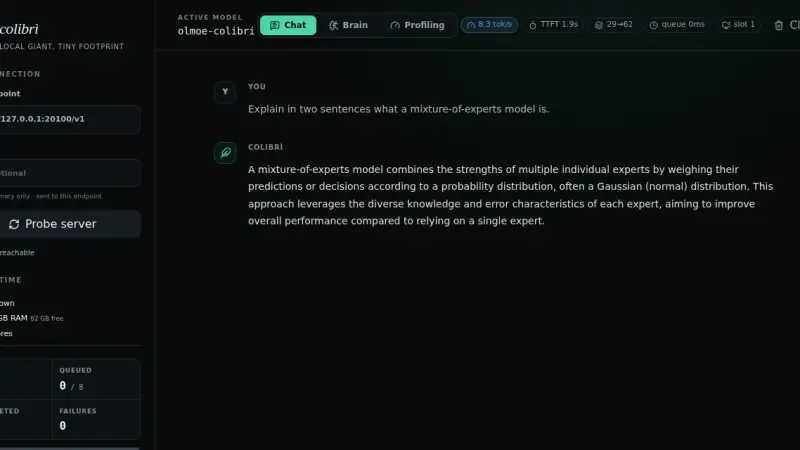
Colibri es un motor de inferencia en C, con licencia Apache 2.0, que ejecuta modelos Mixture-of-Experts de hasta 2,8 billones de parámetros sin cargarlos enteros: deja en RAM la parte densa y lee del SSD solo los expertos que el router elige en cada token. Por eso su velocidad depende del disco, de la caché y de la RAM libre.
FreeToken es un motor de inferencia de código abierto, publicado por investigadores de UC Berkeley y UT Austin en agosto de 2026, que reparte los expertos de un modelo MoE entre GPU, CPU y memoria del sistema según el ancho de banda real de cada máquina. Permite servir modelos de 35B a 753B parámetros en hardware de consumo.
Mixtral 8x22B es el modelo Mixture of Experts de Mistral AI liberado en abril de 2024: 141B parámetros totales pero solo 39B activos por token, licencia Apache 2.0 sin restricciones comerciales y rendimiento multilingüe superior a Llama 3 70B en español, francés, italiano y alemán. Requiere GPU de datacenter para servirlo en producción real.
Gemini 1.5 Pro irrumpió en febrero de 2024 con un contexto de un millón de tokens verificado. Recupera más del 95% de los datos hasta los 530.000 tokens en pruebas de recuperación, lo que transforma el diseño de sistemas RAG, hace viable el análisis de documentos completos y habilita nuevos patrones arquitectónicos con context caching.
8 min2354,3
Usamos cookies propias y de terceros para analizar el tráfico del sitio. Puedes aceptarlas, rechazarlas o configurar tu elección.
Más información sobre las cookies
Preferencias de cookies
NecesariasImprescindibles para el funcionamiento del sitio. Siempre activas.
AnalíticasNos ayudan a entender cómo se usa el sitio (Google Analytics).