Benchmarks de oMLX: método de medida y techo de memoria
Índice de contenidos
- Puntos clave
- Las variables que hay que fijar antes de medir
- Qué mide cada métrica
- Cómo cambia la velocidad con la longitud del prompt
- El benchmark integrado frente a la API
- Caché fría o caliente y peticiones concurrentes
- El estado térmico del Mac
- El techo de memoria, que decide antes que nada
- Los dos errores cuando no cabe
- Preguntas frecuentes
- ¿Por qué el mismo modelo da cifras distintas en el panel y en mi cliente?
- ¿Qué significa "Prefill context too large for available memory" en oMLX?
- ¿Qué significa "does not fit under the memory ceiling"?
- ¿Cuánto contexto cabe en mi Mac?
- ¿Se suben mis benchmarks de oMLX a omlx.ai?
- Conclusión
- Fuentes
Una cifra de tokens por segundo de oMLX no significa nada si no dice con qué longitud de prompt, por qué vía, con la caché fría o caliente y con el Mac frío o caliente. Este artículo es el método que seguimos en jacar.es para medir oMLX, ilustrado con resultados propios de un Apple M5 Max de 128 GB. Cubre también el techo de memoria, que decide antes que nada si una prueba cabe, y los dos errores que aparecen cuando no cabe.
Puntos clave
- Con el prompt de 1.000 a 32.000 tokens, el tiempo hasta el primer token de Qwen3.8-27B pasó de 1,12 a 65,5 segundos y su decode bajó de 30,6 a 23,5 tokens por segundo.
- El benchmark integrado del panel y la API no dan la misma cifra para el mismo modelo: Qwen3.6-35B-A3B oQ4e-mtp generó 49,3 tokens por segundo en uno y 100,2 en la otra.
- La temperatura del Mac pesa: la misma prueba de gpt-oss-20b con 16.000 tokens de prompt procesó 2.942 tokens por segundo con el Mac en parte frío y 1.755 en caliente.
- El benchmark integrado de la 0.7.2 nunca reutiliza la caché de prefijos y sube los resultados a omlx.ai, salvo en tres casos concretos.
- El techo de memoria por defecto deja para macOS el 8 % de la RAM, entre 3 y 8 GB.
Las variables que hay que fijar antes de medir
Cada una de estas variables mueve los números tanto como cambiar de modelo. Una medición comparable las fija todas y las anota junto al resultado:
| Variable | Qué cambia | Cómo la fijamos |
|---|---|---|
| Longitud del prompt | El tiempo hasta el primer token crece con ella; el decode baja | Medimos a 1k, 4k, 16k y 32k tokens, o con el contexto real de la tarea |
| Longitud de la respuesta | Con respuestas cortas pesa más el arranque | 768 tokens por la API y 256 en el benchmark integrado |
| Peticiones concurrentes | El rendimiento total sube y cada petición va más lenta | Una sola petición, salvo que midamos un servidor compartido |
| Caché de prefijos | Una caché caliente evita recalcular el prompt | Un prefijo único en cada petición, para medir siempre en frío |
| Estado térmico del Mac | Un Mac caliente baja la frecuencia | Comparar solo dentro de una sesión y anotar la presión térmica |
| Vía de medida | Motor, muestreo y tokens cambian entre panel y API | Indicar siempre si es el benchmark integrado o la API |
| Versión y aceleración | Una versión nueva o Lightning MTP cambian el resultado | Guardar la versión de oMLX y los ajustes del modelo con cada medición |
Qué mide cada métrica
Una petición tiene dos fases, y cada métrica mira una. El prefill procesa el prompt entero de una vez; el decode genera la respuesta token a token. Las métricas que usamos son estas:
| Métrica | Qué es | Qué la empeora |
|---|---|---|
| TTFT | Tiempo desde el envío hasta el primer token | Un prompt largo, la caché fría, la primera petición tras cargar |
| Prefill | Tokens de prompt procesados por segundo | Modelos densos grandes y prompts largos |
| Decode | Tokens de respuesta generados por segundo | El tamaño de los pesos activos, el contexto acumulado |
| Tiempo total | Del envío al último token | La suma de las dos fases |
| Pico de memoria | Máximo que registra MLX, pesos incluidos | El modelo, el contexto y el lote |
Separar el TTFT del decode es lo que más explica. Un modelo puede tardar un minuto en empezar con un prompt largo y después generar a buen ritmo; si solo miras tokens por segundo, no ves ese minuto.
Cómo cambia la velocidad con la longitud del prompt
La longitud del prompt es la variable que más mueve el tiempo hasta el primer token. Con 32.000 tokens de prompt, Qwen3.8-27B MLX-4bit tardó 65,5 segundos en empezar a responder, 58 veces más que con 1.000:
El decode también baja con el contexto, pero menos y de forma desigual. El modelo de expertos Qwen3.6-35B-A3B perdió un 15 % entre 1k y 32k; gpt-oss-20b, que empezó como el más rápido, perdió un 45 %:
La consecuencia práctica es medir con la longitud que vas a usar. Una cifra obtenida con 1.000 tokens no dice nada de cómo se comporta el modelo con un fichero de código entero en el contexto.
El benchmark integrado frente a la API
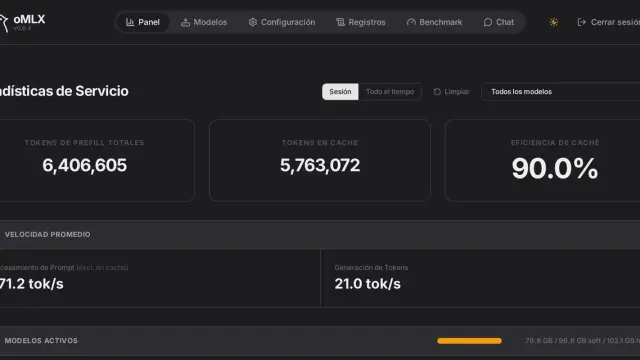
El panel de oMLX trae un banco de pruebas que mide prefill, decode, TTFT y pico de memoria. Admite prompts de 1.024 a 200.000 tokens y lotes de 2, 4 y 8 peticiones. Es la mejor herramienta para ver cómo escala un modelo con el contexto, pero sus cifras no son las que verá tu cliente por la API:
En cuatro modelos el benchmark integrado salió entre un 13 % y un 28 % por encima de la API, porque genera respuestas más cortas y siempre en modo greedy. En Qwen3.6-35B-A3B oQ4e-mtp salió a la mitad. Es un modelo de visión, y el banco de pruebas lo carga con el motor de texto salvo que MTP esté activado; la API usa el motor de visión.
Por eso usamos el benchmark integrado para curvas de contexto dentro de un mismo modelo, y la API para comparar configuraciones o modelos entre sí. En la API medimos peticiones en streaming a /v1/chat/completions desde el cliente, con el razonamiento desactivado y un prefijo único por petición.
Dos detalles del banco de pruebas de la 0.7.2 afectan a cómo lees sus resultados:
- No reutiliza la caché de prefijos. Cada petición empieza con un identificador aleatorio, así que siempre mide el prompt en frío.
- Sube los resultados al ranking de omlx.ai. Solo se quedan en tu Mac las pruebas con el prompt alineado al motor neuronal (
align_prompt_to_ane), las del motor externo Splash y las que miden un endpoint externo.
Caché fría o caliente y peticiones concurrentes
La caché KV por niveles de oMLX cambia el TTFT y deja el decode como está. Si una petición comparte prefijo con otra anterior, los bloques se leen de la RAM o del SSD en lugar de recalcularse, también después de reiniciar el servidor.
El banco de pruebas no mide ese caso, porque cada prueba usa un prefijo nuevo. Para medirlo, manda por la API dos veces la misma petición larga y compara el time_to_first_token que oMLX devuelve en usage. La primera es tu peor caso, la primera petición del día; la segunda, una conversación que continúa. No tenemos aún esa medición publicada para el M5 Max.
Los lotes de 2, 4 y 8 peticiones solo importan si el servidor atiende a más de un cliente a la vez. Para una persona delante de un asistente de programación, el número honesto es el de una sola petición.
El estado térmico del Mac
Un Mac que lleva un rato a plena carga baja la frecuencia, y eso cambia los resultados de una tanda a otra. En la misma sesión del 15 de septiembre, gpt-oss-20b pasó la batería dos veces: una al principio, con el Mac en parte frío, y otra al final, en caliente.
Con prompts cortos las dos tandas coinciden; con 16.000 y 32.000 tokens, la tanda caliente procesó entre un 38 % y un 40 % menos. Por eso solo comparamos configuraciones medidas en la misma sesión, y anotamos la presión térmica cuando la registramos.
Entre sesiones distintas la comparación es aún más frágil. En la página de benchmarks de LLM local en Apple Silicon, Qwen3.8-27B oQ4e-mtp con Lightning MTP pasó de 39,7 a 70,8 tokens por segundo. La primera cifra es del 15 de septiembre y la segunda, del 27 de octubre. Entre una fecha y otra cambiaron la versión de oMLX, las bibliotecas de MLX y el estado térmico, y no hay forma de repartir la mejora entre las tres.
El techo de memoria, que decide antes que nada
En un Mac con memoria unificada no hay memoria de vídeo aparte: cada modelo sale del mismo presupuesto que macOS y el resto de aplicaciones. oMLX impone su propio techo para que el Mac no se quede sin memoria, y lo calcula según un nivel:
safe: deja libre el 20 % de la RAM, entre 6 y 16 GB.balanced: el nivel por defecto. Deja el 8 %, entre 3 y 8 GB, y puede comprimir una cuarta parte de la memoria activa de otras aplicaciones.aggressive: deja el 2 %, entre 1,5 y 4 GB, y puede comprimir la mitad.custom: un techo fijo en GB, con--memory-guard-gbomemory_guard_custom_ceiling_gb.
En un Mac de 128 GB, balanced deja unos 120 GB; en uno de 16 GB, unos 13 GB. El techo además se mueve: oMLX lo recalcula con la memoria libre en cada momento, así que una aplicación pesada abierta lo baja. Desde la línea de comandos el nivel se elige con --memory-guard, que también admite off.
Lo que cuenta contra el techo no es solo el tamaño del fichero del modelo. El pico de memoria crece con el contexto, más en unos modelos que en otros:
Qwen3.8-27B, un modelo denso, sumó 5,8 GiB entre 1k y 32k de prompt; gpt-oss-20b sumó 0,6 GiB. Con lotes de más de una petición, la caché KV crece con cada petición que se suma.
Los dos errores cuando no cabe
Los mensajes que se encuentra la gente son de dos familias y significan cosas distintas. El primero aparece al procesar una petición:
Prefill context too large for available memory (pre-chunk
guard at ... tokens, kv_len=...): predicted peak would exceed
prefill safety cap ...
Viene del vigilante de prefill, que estima el pico antes de procesar cada trozo del prompt. El modelo cabe, pero ese prompt con ese modelo no. Las salidas son acortar el contexto, descargar otro modelo para liberar memoria o subir el nivel del techo.
El segundo aparece al cargar un modelo y llega por la API como un 507:
Model '...' (...) does not fit under the memory ceiling (...).
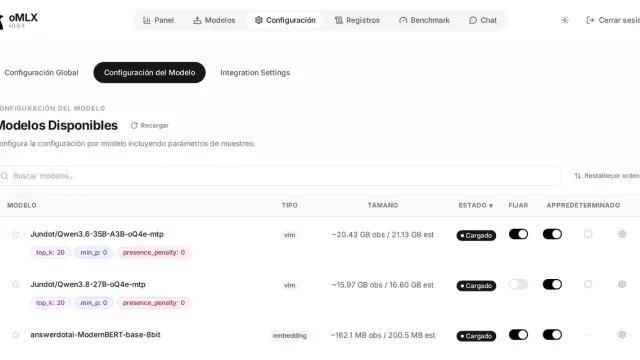
Aquí el problema es el modelo entero, incluso después de expulsar los que no están fijados. Las salidas son una cuantización más agresiva, fijar menos modelos o cambiar de nivel. Antes de tocar el techo, mira qué hay cargado y qué está fijado, como explico en gestión de modelos y memoria en oMLX.
Preguntas frecuentes
¿Por qué el mismo modelo da cifras distintas en el panel y en mi cliente?
Porque el benchmark integrado genera 256 tokens en modo greedy y puede cargar un modelo de visión con el motor de texto. Tu cliente, en cambio, usa la API con su propia temperatura y longitud. En nuestras pruebas la diferencia fue de un 13 % a un 28 % en cuatro modelos y de la mitad en uno. Compara configuraciones siempre por la misma vía.
¿Qué significa "Prefill context too large for available memory" en oMLX?
Que el vigilante de prefill estima que procesar ese prompt superaría el techo de memoria. El modelo está cargado y cabe; lo que no cabe es ese contexto. Acorta el prompt, descarga otro modelo o sube el nivel con --memory-guard.
¿Qué significa "does not fit under the memory ceiling"?
Que el modelo que intentas cargar ocupa más de lo que el techo permite, incluso expulsando los modelos no fijados. Por la API llega como un error 507. Usa una cuantización menor, desfija modelos o cambia de nivel.
¿Cuánto contexto cabe en mi Mac?
Depende del techo, del modelo y de cuántas peticiones atiendes a la vez, así que conviene medirlo. Lanza el benchmark integrado subiendo la longitud del prompt y mira el pico de memoria de cada tamaño; el vigilante de prefill rechazará el primero que no quepa.
¿Se suben mis benchmarks de oMLX a omlx.ai?
Sí, los del benchmark integrado se suben al terminar. Se quedan en tu Mac las pruebas con align_prompt_to_ane activado, las del motor externo Splash y las que miden un endpoint externo.
Conclusión
Medir bien oMLX es sobre todo decidir qué estás midiendo. Fija la longitud del prompt, la vía de medida, el estado de la caché y la sesión, y anótalos junto al resultado; sin eso, las cifras son ruido. Nuestras mediciones en un M5 Max de 128 GB, con el método completo y un CSV descargable, están en los benchmarks de LLM local en Apple Silicon.
El techo de memoria fija el límite superior de todo lo demás. Los endpoints, la clave y los códigos de error están en la referencia de la API de oMLX, y todas las guías, ordenadas, en la página de oMLX. La versión inglesa de este artículo está en oMLX benchmarks and the memory ceiling.
Fuentes: [1] jundot/omlx, código de la etiqueta v0.7.2[1], [2] Notas de la versión 0.7.2 de oMLX[2], [3] Benchmarks de LLM local en Apple Silicon, conjunto de datos de jacar.es, [4] MLX, el framework de Apple sobre el que corre oMLX[3], [5] vLLM y PagedAttention, origen de la caché por bloques[4].
Fuentes
Código fuente
Accede a todo el código fuente de este artículo en GitHub.
Ver en GitHub