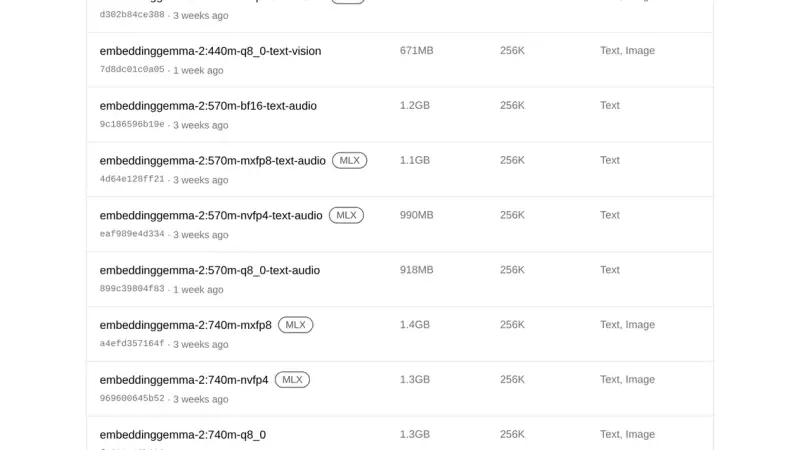
Ollama muestra this model requires MLX support, but the MLX runtime is not available cuando descargas una etiqueta que solo existe en safetensors para MLX, como embeddinggemma-2:740m-bf16 o phonon, en un equipo sin MLX: Linux arm64, Linux sin GPU de NVIDIA o Windows. Descarga la variante GGUF (q8_0) con Ollama 0.40.4 o posterior.
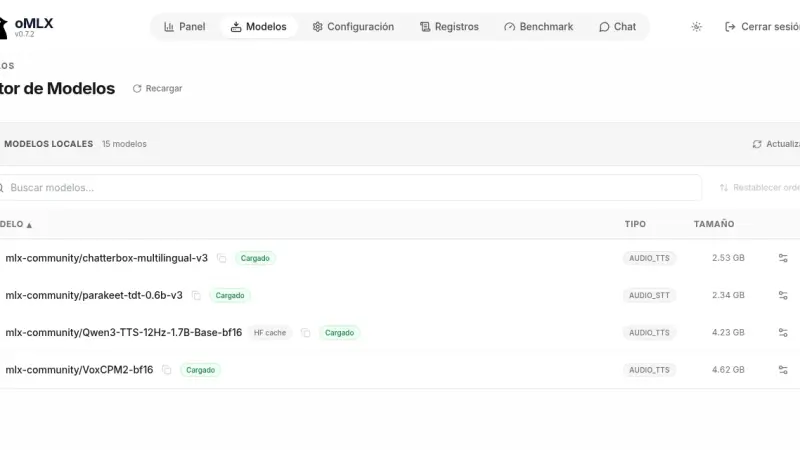
oMLX sirve modelos de texto a voz (TTS) en un Mac con Apple Silicon con la misma API que OpenAI. Con POST /v1/audio/speech pides audio con una voz predefinida, una voz descrita en lenguaje natural o una voz clonada desde unos segundos de referencia. En un M5 Max, Qwen3-TTS 1.7B genera cada segundo de audio en 0,33 s.
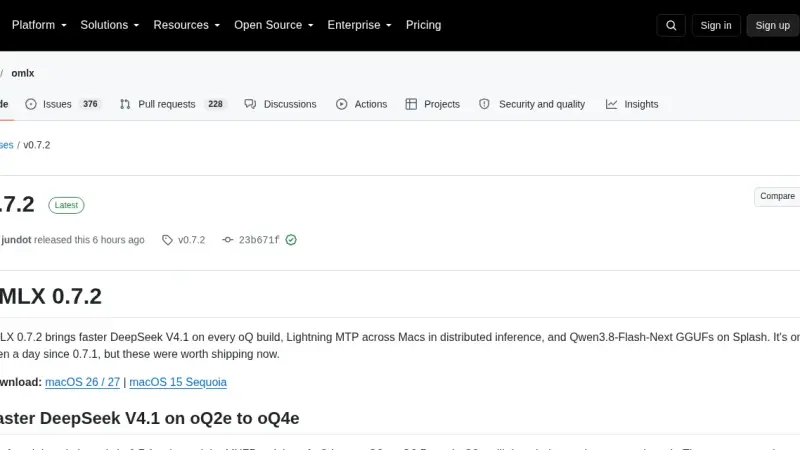
oMLX 0.7.2, publicado el 21 de octubre de 2026, un día después de la 0.7.1, acelera DeepSeek V4.1 en los cuantizados oQ2e a oQ4e, activa Lightning MTP en clústeres de dos o más Mac, ejecuta en Splash los GGUF de Qwen3.8-Flash-Next y deja de repetir el prefill entero en cada turno de Claude Code. Se actualiza desde la app, Homebrew o el código fuente.
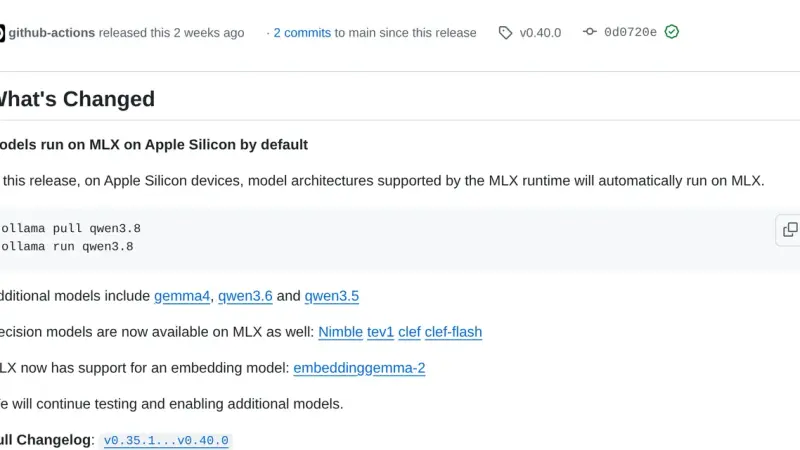
Desde Ollama 0.40, publicado el 25 de septiembre de 2026, los modelos con arquitectura compatible se ejecutan con MLX en los Mac con Apple Silicon en lugar de con llama.cpp. Ollama elige la variante del modelo al descargarlo y el comando ollama ps muestra en la columna RUNNER qué motor la sirve. En Linux y Windows sigue mandando llama.cpp.
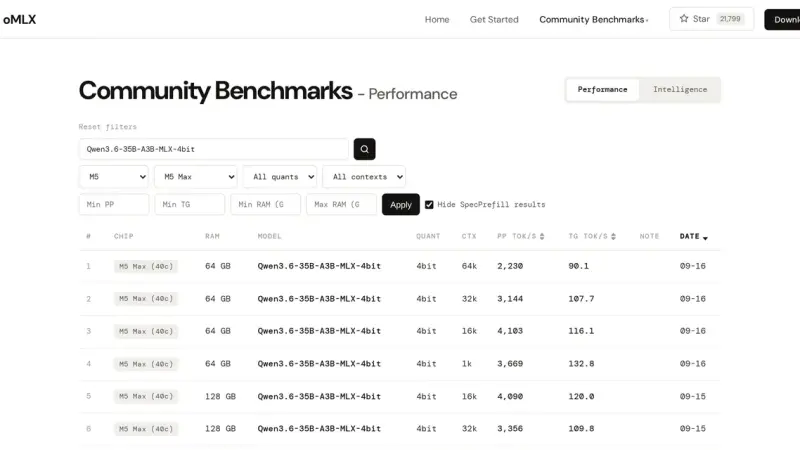
Una cifra de tokens por segundo de oMLX solo sirve si dice la longitud del prompt, la vía de medida, el estado de la caché y el del Mac. En un M5 Max, el primer token de Qwen3.8-27B pasó de 1,12 a 65,5 segundos entre 1k y 32k de prompt. El techo de memoria por defecto deja para macOS el 8 % de la RAM, entre 3 y 8 GB.
oMLX es un servidor de inferencia local para Mac con Apple Silicon que envuelve el framework MLX de Apple y lo expone con las API de OpenAI y de Anthropic. Desde Ollama 0.40 los tres grandes servidores usan MLX en un Mac, así que lo que distingue a oMLX es la memoria: varios modelos cargados con expulsión y fijado, y una caché KV en el SSD que sobrevive a los reinicios.
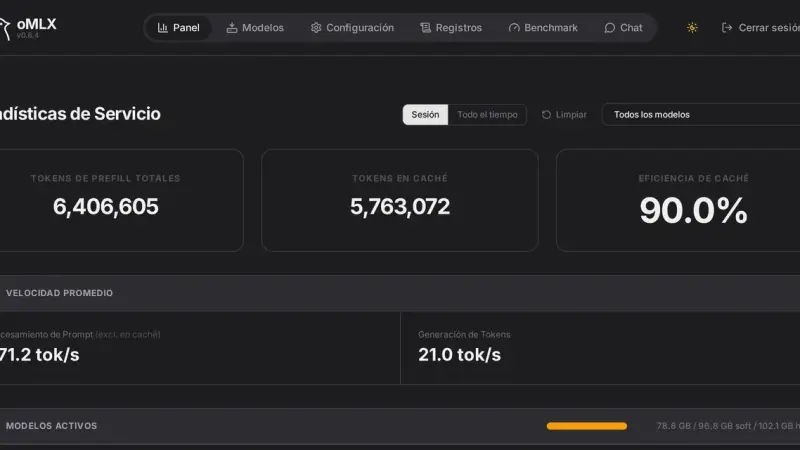
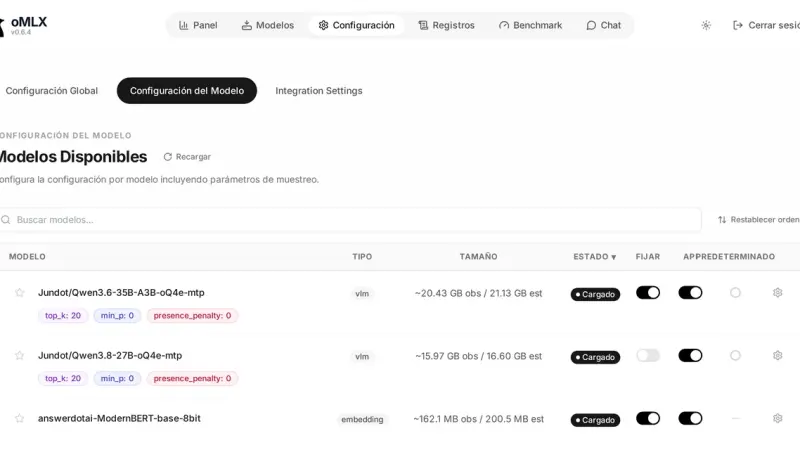
El panel de oMLX vive en localhost:8000/admin y reúne monitorización, carga y descarga de modelos, chat con historial, descargador de Hugging Face, benchmarks y ajustes por modelo. La línea de comandos cubre lo demás con cuatro órdenes: serve, start, stop y launch, esta última para conectar clientes externos.
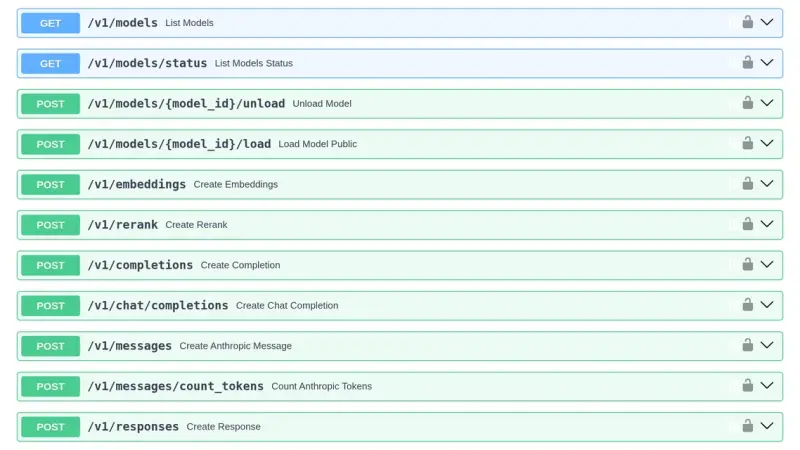
oMLX 0.7.2 escucha en 127.0.0.1:8000 y sirve la API de OpenAI y la Messages API de Anthropic en el mismo puerto. La clave viaja en Authorization: Bearer o en x-api-key y es obligatoria en cuanto el servidor escucha fuera de loopback. Los errores llegan en el formato de OpenAI, y el puerto se cambia con --port, OMLX_PORT o la sección server de settings.json.
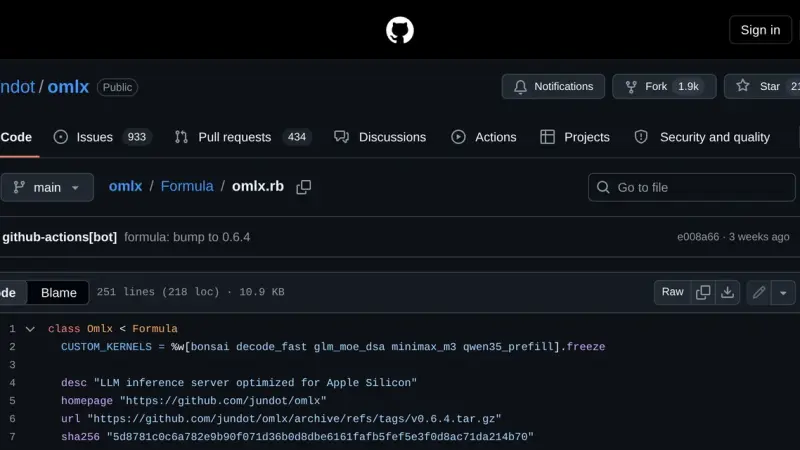
oMLX se instala con Homebrew en dos órdenes: primero el tap del repositorio de jundot y después la fórmula. Queda un servicio de launchd que arranca con omlx start, un registro en la carpeta var de Homebrew y una actualización con brew upgrade. La versión actual es la 0.6.4, del 29 de agosto de 2026.
oMLX gestiona el ciclo de vida de cada modelo con cuatro piezas: un descargador que trae pesos desde Hugging Face, alias que renombran el modelo en la API, un TTL que lo descarga tras un tiempo inactivo y una caché KV por niveles que vuelca bloques al SSD cuando la RAM se llena.
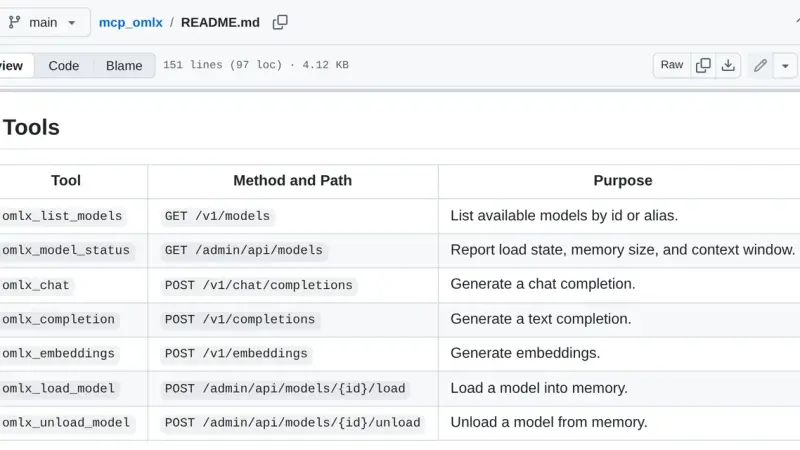
oMLX MCP es un puente que expone tu servidor local de oMLX como herramientas del Model Context Protocol. Con el paquete mcp_omlx conectas Claude Desktop a los modelos que corren en tu Mac y ganas siete herramientas para listar modelos, cargarlos y liberarlos de memoria, y lanzar inferencias sin salir del cliente.
Receta para oMLX 0.6.4 en un Mac M5 Max con 128 GB: instalación, Claude Code y ajustes avanzados con capturas (Lightning MTP, VLM MTP y DFlash). Incluye benchmarks propios de septiembre de 2026, con hasta 1,88x más tokens por segundo.
45 min3,3K5,0
Usamos cookies propias y de terceros para analizar el tráfico del sitio. Puedes aceptarlas, rechazarlas o configurar tu elección.
Más información sobre las cookies
Preferencias de cookies
NecesariasImprescindibles para el funcionamiento del sitio. Siempre activas.
AnalíticasNos ayudan a entender cómo se usa el sitio (Google Analytics).