Cómo activar la IA local de Paperless-ngx 3 con Ollama
Índice de contenidos
- Puntos clave
- Qué cambia en Paperless-ngx 3 si vienes de la 2.20
- Antes de actualizar: la 2.20.15 y una copia completa
- Cómo actualicé de la 2.20.15 a la 3.1.3
- Cómo conectar Paperless-ngx 3 con Ollama
- El fallo de los modelos que razonan
- Cuánto tarda y cuánta RAM ocupa en CPU
- Qué sugiere un modelo pequeño con documentos reales
- Cómo responde el chat con tus documentos
- Límites que conviene conocer
- Preguntas frecuentes
- ¿Necesito GPU para usar la IA de Paperless-ngx 3?
- ¿Qué modelo pongo si no quiero parchear nada?
- ¿Los documentos salen de mi servidor?
- Conclusión
- Fuentes
Paperless-ngx 3 trae IA de serie: sugiere título, etiquetas, corresponsal y fechas, y responde preguntas sobre tus documentos. La he probado entera en mi propia máquina, sin mandar un PDF a ningún servicio externo. Partí de una instalación 2.20.15 como la de la guía para instalar Paperless-ngx con Docker, la actualicé a la 3.1.3 y la conecté a Ollama en una máquina sin GPU. Aquí tienes los comandos, lo que tardó cada paso, cuánta memoria ocupa el modelo y un fallo que duplica el tiempo de cada sugerencia.
Puntos clave
- La 3.0.0 salió el 22 de julio de 2026 y la versión más reciente a 14 de septiembre es la 3.1.3, del 4 de septiembre. Solo se puede actualizar desde la 2.20.15.
- Actualizar fue cambiar la etiqueta de la imagen: 37 migraciones, el índice de búsqueda reconstruido solo y la API respondiendo a los 25,6 s.
- La IA se configura con variables
PAPERLESS_AI_*. La dirección del servidor va enPAPERLESS_AI_LLM_ENDPOINT, no enPAPERLESS_AI_LLM_URLcomo decía la descripción del PR que la introdujo. - En CPU, Gemma 4 E4B tardó una mediana de 25,8 s por sugerencia de un documento nuevo, y su proceso ocupó entre 6,6 y 7,6 GiB de RAM.
- Paperless-ngx 3.1.3 intenta desactivar el razonamiento del modelo, pero la orden se pierde por el camino. Con modelos que razonan, cada sugerencia genera cientos de tokens de más o acaba en un error 400.
Qué cambia en Paperless-ngx 3 si vienes de la 2.20
La 3.0.0 se publicó el 22 de julio de 2026 y le han seguido nueve versiones más hasta la 3.1.3. Estas son las novedades grandes según el registro de la versión 3.0.0[1]:
- Búsqueda con Tantivy en lugar de Whoosh
- Versiones de un mismo documento
- Paquetes de enlaces compartidos
- Un sistema de plugins para leer formatos nuevos
- OCR remoto con Azure
- La IA
La IA llegó con el PR #10319, "Feature: Paperless AI"[2], de shamoon, integrado en la rama dev el 13 de enero de 2026. La 3.1.0 añadió una acción de flujo de trabajo, "Apply AI Suggestions", que aplica las sugerencias sin que pulses nada.
La guía de migración a la v3[3] lista bastantes cambios incompatibles. Estos son los que afectan a quien administra su propia instalación:
| Qué cambia | Qué tienes que hacer |
|---|---|
PAPERLESS_SECRET_KEY pasa a ser obligatoria |
Defínela. Si dependías de la clave por defecto, una nueva invalida las sesiones abiertas |
PAPERLESS_DBENGINE obligatoria con PostgreSQL o MariaDB |
Añade PAPERLESS_DBENGINE: postgresql |
PAPERLESS_CONSUMER_POLLING |
Renómbrala a PAPERLESS_CONSUMER_POLLING_INTERVAL |
PAPERLESS_CONSUMER_IGNORE_PATTERNS |
Ahora son expresiones regulares, no comodines |
| Documentos duplicados | Ya no se rechazan. PAPERLESS_CONSUMER_DELETE_DUPLICATES=true recupera lo anterior |
PAPERLESS_OCR_MODE=skip o skip_noarchive |
Usa auto junto a PAPERLESS_ARCHIVE_FILE_GENERATION |
| Cifrado de documentos | Eliminado. Ejecuta decrypt_documents antes de actualizar |
| Scripts de pre y posconsumo | Ya no reciben $1 a $8. Lee DOCUMENT_ID, DOCUMENT_SOURCE_PATH y el resto de variables |
Búsquedas con note: |
Pasan a notes.note:. Las vistas guardadas se migran solas |
La misma guía trae dos avisos más. La API retira las versiones anteriores a la 9, así que una aplicación móvil o un script antiguo pueden dejar de funcionar. Y en x86 la CPU necesita SSE4.2, porque NumPy 2.4 lo exige para el clasificador clásico, uses la IA o no.
Si seguiste nuestra guía de la 2.20, ya tenías PAPERLESS_SECRET_KEY y PAPERLESS_DBENGINE. Lo único que puedes tener que tocar es PAPERLESS_CONSUMER_POLLING, si la añadiste para una carpeta en NFS.
Antes de actualizar: la 2.20.15 y una copia completa
Paperless-ngx 3 no admite una base de datos anterior a la 2.20.15. La guía de migración lo dice en su primera línea:
Upgrading to Paperless-ngx v3 can only be performed from version 2.20.15. If you are running an older version, please upgrade to v2.20.15 before proceeding with the v3 upgrade.
No es una recomendación. Al arrancar, el código de la 3.1.3 busca la migración 1075_workflowaction_order, la última de la 2.20.15. Si no la encuentra, devuelve el error paperless.E002 y te pide actualizar antes a esa versión.
Yo partí de la 2.20.15, así que no llegué a provocarlo. Si tu etiqueta era :2.20, no te preocupes: hoy apunta a la misma imagen que 2.20.15, lo comprobé comparando los resúmenes de las dos etiquetas.
Haz la copia con el exportador incluido antes de tocar la imagen. Con mis cinco documentos de prueba tardó 2,4 s y ocupó 1,1 MB:
docker compose exec webserver document_exporter ../export
Esa copia es la que restauras con document_importer si algo sale mal, y conviene que acabe fuera del servidor, por ejemplo con restic y copias cifradas.
Revisa también dónde monta tu docker-compose.yml el volumen de PostgreSQL. El compose de ejemplo de la 3.x lo monta en /var/lib/postgresql. Lo comprobé en una instalación nueva: con postgres:18 (18.6) y el volumen en /var/lib/postgresql/data, el contenedor se cierra al arrancar con Error: in 18+, these Docker images are configured to store database data in a format which is compatible with "pg_ctlcluster". Si ya tienes datos de otra versión mayor en la ruta antigua, no cambies la imagen sin pasar antes por pg_upgrade.
Cómo actualicé de la 2.20.15 a la 3.1.3
La actualización consistió en cambiar la etiqueta de la imagen y recrear el contenedor. Todo corrió en un contenedor de desarrollo linux/arm64 con 18 núcleos, 121 GB de RAM y sin GPU, compartido con otras cargas.
Mi banco de pruebas eran cinco PDF inventados en español. Tres tenían texto digital: una factura de la luz, una carta del banco y un aviso de renovación del seguro de hogar. Los otros dos eran escaneos de una factura de taller y de un recibo del IBI.
En el servicio webserver, cambia la línea de la imagen:
  webserver:
    image: ghcr.io/paperless-ngx/paperless-ngx:3.1.3
Después descarga la imagen, recrea el contenedor y sigue el registro:
docker compose pull webserver
docker compose up -d
docker compose logs -f webserver
El arranque aplicó 37 migraciones, entre ellas una que recalcula las sumas SHA-256 de todos los documentos, y terminó con init completed in 13 seconds. La API contestó a los 25,6 s de lanzar up -d, con una carga media de 33 en los 18 núcleos. El índice de Tantivy se reconstruyó solo, y buscar "factura" devolvió las dos facturas. La cabecera X-Api-Version pasó de 9 a 10.
La actualización tiene coste en disco y en memoria. En arm64, la imagen pasó de 1,92 GB a 3,32 GB. La diferencia son PyTorch 2.13.0 para CPU, sentence-transformers y llama-index, que la 2.20.15 no traía. Solo la carpeta de PyTorch ocupa 577 MB.
La memoria también sube: en reposo y con la IA apagada, el contenedor pasó de 582 a 648 MiB de RAM.
Cómo conectar Paperless-ngx 3 con Ollama
La IA necesita dos modelos: uno de lenguaje, que redacta las sugerencias y las respuestas, y uno de embeddings vectoriales, que indexa tus documentos para encontrar los parecidos. Los dos pueden vivir en el mismo Ollama. Si aún no lo conoces, la guía para instalar Ollama explica lo básico.
Añade un docker-compose.override.yml junto a tu compose. Docker Compose lo combina con el principal sin que tengas que pasarlo con -f, y las variables se suman a las que ya tenías:
services:
  ollama:
    image: docker.io/ollama/ollama:0.34.0
    restart: unless-stopped
    volumes:
      - ollama:/root/.ollama
  webserver:
    environment:
      PAPERLESS_AI_ENABLED: "true"
      PAPERLESS_AI_LLM_BACKEND: ollama
      PAPERLESS_AI_LLM_ENDPOINT: http://ollama:11434
      PAPERLESS_AI_LLM_MODEL: gemma4-e4b
      PAPERLESS_AI_LLM_EMBEDDING_BACKEND: ollama
      PAPERLESS_AI_LLM_EMBEDDING_MODEL: embeddinggemma
      PAPERLESS_AI_LLM_REQUEST_TIMEOUT: 600
volumes:
  ollama:
Arranca Ollama y descarga los dos modelos. Yo los bajé como GGUF desde Hugging Face porque, en la red donde probé, el CDN del registro de Ollama devolvía un certificado inválido. Con una conexión normal, la etiqueta del registro oficial es gemma4:e4b, que no llegué a probar:
docker compose up -d ollama
docker compose exec ollama ollama pull \
  hf.co/unsloth/gemma-4-E4B-it-GGUF:Q4_K_M
docker compose exec ollama ollama pull \
  hf.co/unsloth/embeddinggemma-300m-GGUF:Q8_0
Crea ahora los nombres cortos que usa el compose. La línea PARAMETER num_thread limita los hilos de cálculo de cada modelo, y más abajo explico por qué, en una máquina ocupada, es la que más tiempo ahorra:
docker compose exec ollama sh -c 'cat > /tmp/Modelfile <<EOF
FROM hf.co/unsloth/gemma-4-E4B-it-GGUF:Q4_K_M
PARAMETER num_thread 6
EOF
ollama create gemma4-e4b -f /tmp/Modelfile'
docker compose exec ollama sh -c 'cat > /tmp/Modelfile <<EOF
FROM hf.co/unsloth/embeddinggemma-300m-GGUF:Q8_0
PARAMETER num_thread 4
EOF
ollama create embeddinggemma -f /tmp/Modelfile'
Por último, recrea Paperless para que lea las variables y construye el índice de embeddings:
docker compose up -d webserver
docker compose exec webserver document_llmindex rebuild
Con cinco documentos, la reconstrucción tardó unos 6 s y dejó 3,2 MB en data/llm_index, una base sqlite-vec. A partir de ahí, cada documento nuevo o editado se indexa solo, y además una tarea repasa el índice entero cada noche a las 2:10.
Estas son las variables de la 3.1.3 que conviene conocer. Los valores por defecto salen de la documentación de configuración de la 3.1.3[4]:
| Variable | Por defecto | Qué hace |
|---|---|---|
PAPERLESS_AI_ENABLED |
false |
Interruptor general de la IA |
PAPERLESS_AI_LLM_BACKEND |
ninguno | ollama u openai-like |
PAPERLESS_AI_LLM_ENDPOINT |
ninguno | Dirección del servidor, obligatoria con Ollama |
PAPERLESS_AI_LLM_MODEL |
llama3.1 con Ollama |
Modelo que genera sugerencias y respuestas |
PAPERLESS_AI_LLM_EMBEDDING_BACKEND |
ninguno | huggingface, ollama u openai-like. Activa el índice |
PAPERLESS_AI_LLM_EMBEDDING_MODEL |
embeddinggemma con Ollama |
Modelo de embeddings |
PAPERLESS_AI_LLM_CONTEXT_SIZE |
8192 |
Se envía a Ollama como num_ctx |
PAPERLESS_AI_LLM_REQUEST_TIMEOUT |
120 |
Segundos de espera. En CPU, súbelo |
PAPERLESS_AI_LLM_OUTPUT_LANGUAGE |
ninguno | Idioma de las sugerencias |
PAPERLESS_LLM_INDEX_TASK_CRON |
10 2 * * * |
Cuándo se repasa el índice entero |
Un detalle despista: todo esto también se ajusta en Administración > Configuración, y el valor guardado ahí manda sobre la variable de entorno. Si cambias el compose y no ves efecto, revisa esa pantalla.
El fallo de los modelos que razonan
Mi primer modelo fue Qwen3.5 4B, y las dos primeras sugerencias fallaron después de 5 min 52 s y 4 min 53 s. Paperless devolvió un 400 con {"ai":["Invalid AI configuration."]}, y el registro mostraba json.decoder.JSONDecodeError: Expecting value: line 1 column 1 (char 0). La configuración estaba bien. El modelo había generado más de 2.700 tokens y la respuesta llegó vacía.
Seguí la llamada por el código. Paperless pide a Ollama la salida con un esquema JSON y think=False, pero la biblioteca que hace de intermediaria, llama-index-llms-ollama 0.10.1, recoge ese parámetro así:
think = kwargs.pop("think", None) or self.thinking
En Python, False or None vale None. Ollama no recibe ninguna instrucción sobre el razonamiento y el modelo razona, que es lo que hace por defecto.
En la respuesta de Qwen3.5 4B, el bloque de razonamiento empezaba con "Thinking Process: 1. Analyze the Request" y el contenido estaba vacío. La misma línea sigue en la rama principal de llama_index[5] a 14 de septiembre.
Gemma 4 E4B también razona en esa situación, aunque Ollama no le atribuía esa capacidad al GGUF importado. Con él las sugerencias sí llegan, pero cada una genera entre 680 y 1.130 tokens de razonamiento antes de los 100 a 180 tokens del JSON. Llamando a Ollama directamente con think a false, la misma petición generó 163 tokens.
Hay dos salidas. La primera es un modelo que no razone, como Gemma 3 4B, que funciona sin tocar nada pero acierta menos, como verás en la sección de calidad. La segunda es corregir la línea al arrancar el contenedor con el mecanismo oficial de scripts de inicio. Guarda esto en init/10-think.sh:
#!/bin/bash
f=$(python3 -c 'import llama_index.llms.ollama.base as b; print(b.__file__)')
viejo='kwargs.pop("think", None) or self.thinking'
nuevo='kwargs.pop("think", self.thinking)'
sed -i "s/$viejo/$nuevo/" "$f"
Monta la carpeta en el webserver con - ./init:/custom-cont-init.d:ro. Paperless solo ejecuta scripts de una carpeta que pertenezca a root y que nadie más pueda escribir, así que ejecuta sudo chown -R root:root init y sudo chmod 755 init init/10-think.sh. El registro del arranque lo confirma con [custom-init] 10-think.sh: exited 0.
Esto modifica una dependencia dentro del contenedor, así que trátalo como un apaño temporal. Cuando actualices Paperless, comprueba con grep si la línea original sigue ahí antes de dejar el script montado.
Cuánto tarda y cuánta RAM ocupa en CPU
Con el parche, Gemma 4 E4B tardó una mediana de 25,8 s por sugerencia de un documento nuevo. Casi todo ese tiempo se va en leer el prompt, de entre 1.634 y 1.674 tokens, a entre 80 y 88 tokens por segundo. Es tan largo porque Paperless envía el texto del documento, fragmentos de los documentos parecidos y la lista de etiquetas candidatas. Generar el JSON, entre 124 y 150 tokens, llevó entre 3,8 y 5,2 s.
Medí cada configuración con los cinco documentos, pidiendo la sugerencia de cada uno por primera vez. Las dos filas de Gemma 4 E4B se midieron una detrás de otra para compararlas en condiciones parecidas, y la carga media aparece en cada fila porque otros procesos competían por la CPU:
| Configuración | Mediana por documento nuevo | Tokens generados | RAM del proceso del modelo | Carga media |
|---|---|---|---|---|
| Gemma 4 E4B, Paperless sin tocar | 51,2 s | 840 a 1.180 | 6,6 a 7,6 GiB | 7 a 16 |
| Gemma 4 E4B con el parche | 25,8 s | 124 a 150 | 6,6 a 7,6 GiB | 5 a 11 |
| Gemma 3 4B, sin tocar | 17,8 s | 66 a 157 | 4,5 a 5,9 GiB | 12 a 14 |
| Qwen3.5 4B, sin tocar | Error 400 tras 4 min 53 s y 5 min 52 s | Más de 2.700 | 4,0 GB según ollama ps |
21 a 27 |
Con más carga la diferencia crece. En una tanda anterior, con la máquina a una carga de entre 24 y 41, la mediana sin parche fue de 138,2 s. Con el parche y una carga de entre 14 y 20, bajó a 28,7 s. Las 30 sugerencias de esas dos tandas terminaron bien.
La RAM del modelo sube con el uso porque el servidor guarda prompts anteriores en caché. Gracias a esa caché, repetir la sugerencia del mismo documento bajó a entre 4,8 y 6,2 s. Aparte, el modelo de embeddings ocupó entre 795 y 924 MiB, y el contenedor de Paperless se movió entre 745 y 840 MiB con la IA encendida.
El ajuste que más tiempo ahorró no tiene nada que ver con Paperless. Con la máquina a una carga media de entre 13 y 27, alterné tres veces el mismo resumen de 585 tokens con y sin límite de hilos:
| Hilos | Lectura del prompt | Generación | Tiempo total (mediana) |
|---|---|---|---|
| Los que elige Ollama | 26 tokens/s | 0,15 tokens/s | 354,3 s |
num_thread 6 |
80,9 tokens/s | 32,5 tokens/s | 11,9 s |
Sin límite, el proceso llegó a ocupar 13 núcleos a la vez y los hilos se estorbaron entre sí y con el resto de la máquina. En un servidor dedicado y en reposo la diferencia será menor, pero un NAS que hace OCR mientras sugiere se parece más a mi caso que a un banco de pruebas limpio.
Qué sugiere un modelo pequeño con documentos reales
Gemma 4 E4B acertó el corresponsal y las fechas en los cinco documentos, y falló sobre todo en el tipo de documento. Antes de pedir nada asigné a mano corresponsal, tipo y etiquetas a los tres PDF digitales, y dejé sin clasificar los dos escaneados. En la ficha, las sugerencias aparecen bajo cada campo y en el desplegable del botón Suggest:
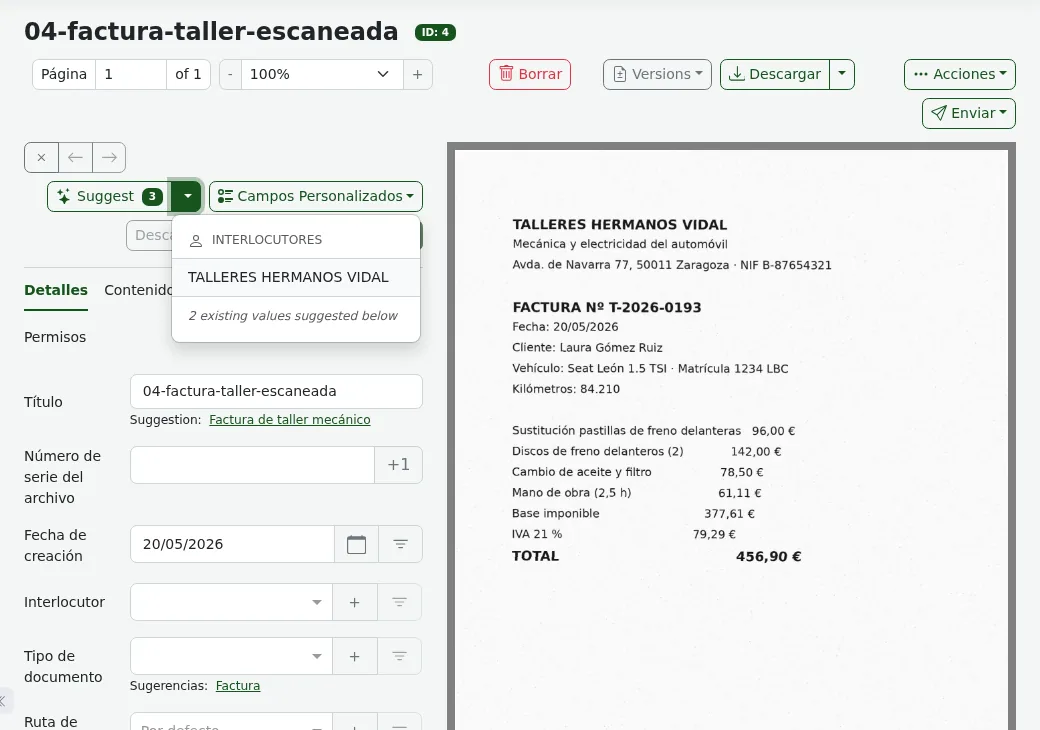
Esta es la primera sugerencia de cada documento en la tanda con el parche:
| Documento | Título sugerido | Corresponsal | Tipo | Veredicto |
|---|---|---|---|---|
| Factura de la luz | FACTURA DE ELECTRICIDAD de LUMINIA ENERGÍA S.L. | Luminia Energía | Nuevo, "FACTURA DE ELECTRICIDAD" | Crea un tipo aunque existe Factura, y propone una etiqueta sin sentido |
| Carta del banco | Comunicación de modificación de condiciones de tarjeta de crédito Meridiano Oro | Banco Meridiano | Ninguno | Falta el tipo Carta y sobra la etiqueta Hogar |
| Renovación del seguro | Aviso de renovación de póliza de Seguro de Hogar | Aseguradora Faro | Carta | Existe Póliza y no la elige |
| Factura de taller, escaneada | Factura Mecánica y Electricidad de Automóvil | Nuevo, TALLERES HERMANOS VIDAL | Factura | Correcta, salvo la etiqueta Hogar |
| Recibo del IBI, escaneado | Recibo IBI 2026 | Nuevo, AYUNTAMIENTO DE VALDECIERZO | Carta | Existe Recibo y no la elige |
Los fallos de tipo tienen explicación en el código. Paperless solo ofrece al modelo etiquetas, tipos y corresponsales que ya llevan los documentos parecidos, con un máximo de 10 etiquetas y 5 de cada tipo. Nadie usaba todavía el tipo Recibo ni la etiqueta Impuestos, así que el modelo nunca los vio. Con un archivo de cientos de documentos bien clasificados, esa lista mejora sola.
Gemma 3 4B tardó menos y se equivocó más. Asignó Aseguradora Faro como corresponsal de la carta del banco y mezcló corresponsales equivocados en la factura de la luz y en el aviso del seguro. En el recibo del IBI, copió trozos de la lista de candidatas dentro de los campos del JSON. Además, las sugerencias varían entre peticiones: Gemma 4 E4B dio tres títulos distintos para la factura del taller en tres intentos.
Cómo responde el chat con tus documentos
El chat acertó las cuentas y los datos que le pregunté, aunque tarda alrededor de un minuto cuando busca en todo el archivo. Se abre desde el icono de la barra superior, y pregunta sobre un solo documento o sobre todos según la pantalla en la que estés. Cada respuesta enlaza los documentos de los que ha sacado la información.
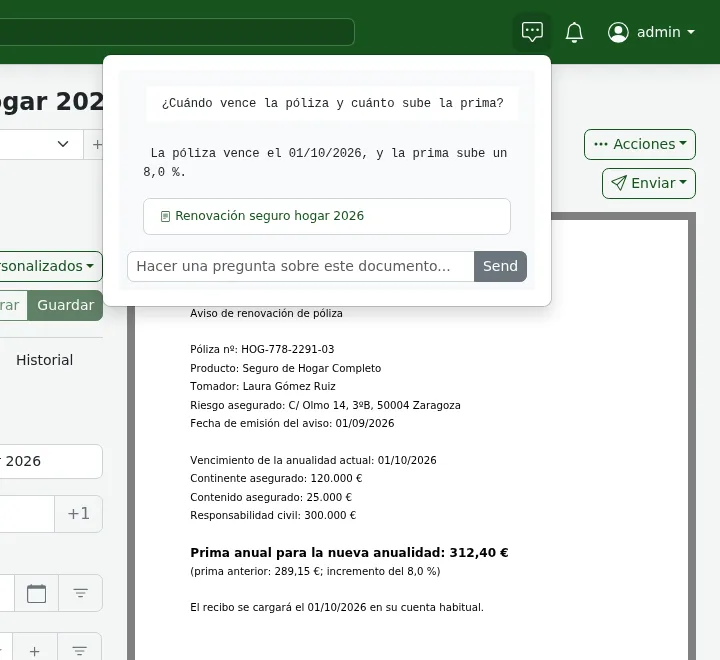
A la pregunta "¿Cuánto pago en total al año entre el seguro de hogar y el IBI?", buscando en todo el archivo, respondió:
El seguro de hogar tiene una prima anual de 312,40 €. La cuota íntegra del IBI es de 355,94 €. El total anual es de 668,34 €.
La suma es correcta y citó el aviso del seguro y el recibo del IBI. Tardó una mediana de 57,5 s en tres intentos. Dentro del aviso del seguro le pregunté "¿Cuándo vence la póliza y cuánto sube la prima?". Respondió "La póliza vence el 01/10/2026 y la prima sube un 8,0%" en una mediana de 13,4 s, con una carga media de entre 12 y 17.
Dos de las seis respuestas sobre todo el archivo arrastraron basura del contexto. Una incluía la línea "TOTAL A PAGAR: 84,37 €" de la factura de la luz, y otra, los metadatos crudos de un documento. La respuesta llega de golpe al final, sin ir apareciendo palabra a palabra. Además, cada llamada del chat generó entre 270 y 780 tokens para respuestas de una a cinco líneas: el chat no pasa think, así que el parche no lo alcanza y el razonamiento sigue encendido.
Límites que conviene conocer
La IA de Paperless-ngx 3 tiene límites que no se ven en la pantalla de configuración:
- Las sugerencias solo leen los primeros 4.000 caracteres de cada documento. En un contrato largo, las cláusulas del final no cuentan para el título ni para las etiquetas
- Si defines un idioma de salida, o tu usuario tiene guardado un idioma de interfaz, cada sugerencia hace una segunda llamada al modelo para traducirla
- La acción "Apply AI Suggestions" encola una llamada por documento. La documentación advierte de que un flujo que coincida con todo tu archivo puede bloquear la cola y retrasar el consumo de documentos nuevos
PAPERLESS_AI_LLM_ALLOW_INTERNAL_ENDPOINTSvaletruepor defecto para que funcione un Ollama local. Si solo usas un proveedor remoto, ponla afalse- Cambiar el modelo de embeddings obliga a reconstruir el índice con
document_llmindex rebuild - El backend
openai-likeusa llamadas a herramientas y no el esquema JSON de Ollama, así que el servidor que pongas detrás tiene que admitirlas. No lo probé
La elección del modelo se nota más que cualquier variable. El análisis de qué variante de Gemma 4 cabe en tu GPU ayuda a elegir tamaño, y la decodificación restringida para salidas estructuradas explica cómo Ollama fuerza el JSON que Paperless espera.
Preguntas frecuentes
¿Necesito GPU para usar la IA de Paperless-ngx 3?
No. Todas las medidas de este artículo son en CPU, con 18 núcleos arm64 y sin GPU. Con Gemma 4 E4B y el parche, una sugerencia tarda entre 26 y 29 s y el modelo ocupa unos 7 GiB de RAM. Para un archivo doméstico que recibe unos pocos documentos al día es asumible, y una GPU recorta sobre todo la lectura del prompt.
¿Qué modelo pongo si no quiero parchear nada?
Uno que no razone, pero comprueba sus aciertos con tus propios documentos. Gemma 3 4B funcionó sin parche y fue el más rápido, con una mediana de 17,8 s, pero se equivocó de corresponsal en tres de cinco documentos. El valor por defecto, llama3.1, tampoco razona, aunque no lo medí.
¿Los documentos salen de mi servidor?
Con PAPERLESS_AI_LLM_BACKEND=ollama y Ollama en la misma red de Docker, no. Paperless envía el texto al contenedor de Ollama y nada más. La documentación avisa de que, si apuntas a un proveedor remoto compatible con OpenAI, el contenido de tus documentos viaja a ese proveedor y puede tener coste.
Conclusión
Paperless-ngx 3 funciona con IA local desde el primer día, y la actualización desde la 2.20.15 fue un cambio de etiqueta que se completó en medio minuto. El trabajo está en el modelo. Uno que razona, sin el parche, duplica el tiempo de cada sugerencia o termina en un error 400. Y en una máquina compartida, limitar los hilos de Ollama marcó la diferencia entre 12 s y casi 6 min.
Mi configuración recomendada hoy es Gemma 4 E4B con num_thread ajustado, el script que corrige think y un tiempo de espera de 600 s. Úsala para proponer, no para archivar sin mirar: el corresponsal y las fechas salieron bien, pero el tipo de documento solo acertó en uno de cinco. La misma prueba está en inglés.
Fuentes
- registro de la versión 3.0.0
- PR #10319, "Feature: Paperless AI"
- guía de migración a la v3
- documentación de configuración de la 3.1.3
- llama_index
- Paperless-ngx v3.1.3, notas de la versión
- Documentación de uso avanzado: funciones de IA
- Wiki de Paperless-ngx, recomendaciones de modelos de IA
- Ollama v0.34.0
- Modelo EmbeddingGemma en la biblioteca de Ollama
Código fuente
Accede a todo el código fuente de este artículo en GitHub.
Ver en GitHub