Maple-Preview, MiniCPM5-2B o Spark-X2.5, qué LLM sin GPU elegir para una CPU arm64
Índice de contenidos
- Puntos clave
- Qué son Maple-Preview, MiniCPM5-2B y Spark-X2.5-4B
- Qué versión de llama.cpp necesita cada modelo
- Cómo medí: máquina, compilación y carga
- Qué velocidad da cada modelo en una CPU sin GPU
- Cuántos hilos usar para generar en una CPU
- Cuánta memoria y disco ocupa cada modelo
- Cómo respondieron a cinco tareas en español
- Cuánto cuesta el modo de razonamiento en una CPU
- Qué modelo usar según la tarea
- Preguntas frecuentes
- ¿Se puede ejecutar un LLM sin GPU a una velocidad útil?
- ¿Hace falta un fork de llama.cpp para Maple-Preview o Spark-X2.5?
- ¿Cuál de los tres responde mejor en español?
- Conclusión
- Fuentes
En una CPU arm64 sin GPU, Maple-Preview genera texto más deprisa que MiniCPM5-2B y que Spark-X2.5-4B aunque pesa 20.214 millones de parámetros, porque cada token solo activa unos 1.000 millones y sus pesos son ternarios. A cambio ocupa 5,49 GiB en disco y ninguno de los tres modelos acertó la pregunta de cultura general que les hice. El 14 y el 15 de septiembre de 2026 los ejecuté con la misma compilación de llama.cpp v0.4.1 en una máquina Linux arm64 de 18 núcleos, con Gemma 4 E2B como referencia conocida, y medí velocidad, memoria y cinco tareas en español.
Esta referencia recoge las cifras, los comandos y las respuestas en bruto resumidas, con la carga de la máquina anotada en cada medida porque la compartía con otros trabajos. Tienes también la versión en inglés de esta comparación.
Puntos clave
- Con 6 hilos, Maple-Preview generó 172,84 tokens/s de mediana, frente a 83,19 de MiniCPM5-2B, 64,53 de Gemma 4 E2B y 47,41 de Spark-X2.5-4B.
- Los tres GGUF oficiales cargan en llama.cpp v0.4.1 sin forks, aunque las fichas GGUF de Maple y Spark sigan remitiendo a versiones propias de llama.cpp.
- Con 16.384 tokens de contexto, la memoria residente máxima fue de 5,79 GiB para Maple, 3,27 GiB para MiniCPM5 y 5,56 GiB para Spark.
- Los cuatro modelos, Gemma incluido, inventaron la fecha y las estaciones de la primera línea del Metro de Madrid.
- En modo razonamiento, Spark agotó el tope de 4.096 tokens en la cuenta de la compra y Gemma en la función de código; Maple no permite desactivar ese modo.
- Más hilos no es mejor: los cuatro generaron más deprisa con 6 y cayeron a entre 5,90 y 7,78 tokens/s con 16.
Qué son Maple-Preview, MiniCPM5-2B y Spark-X2.5-4B
Son tres modelos de pesos abiertos publicados entre agosto y septiembre de 2026 que sus autores presentan para dispositivos sin GPU dedicada, y cada uno llega a esa meta por un camino distinto. Estos son los datos que leí en sus repositorios de Hugging Face y en los metadatos de los ficheros:
| Modelo | Autor | Publicado | Licencia | Parámetros | Arquitectura | GGUF probado | Tamaño |
|---|---|---|---|---|---|---|---|
| Maple-Preview | DeepGrove | 4 de agosto de 2026 | MIT | 20.214.030.336 | MoE ternario, 256 expertos y 8 activos | TQ2_0 con cabeza Q4_K | 5,49 GiB |
| MiniCPM5-2B | OpenBMB | 7 de septiembre de 2026 | Apache 2.0 | 2.516.756.480 | Densa, LlamaForCausalLM |
Q4_K_M | 1,45 GiB |
| Spark-X2.5-4B | XHToken | 24 de agosto de 2026 | Apache 2.0 | 4.112.079.360 | Densa, atención híbrida | Q4_K_M | 2,42 GiB |
| Gemma 4 E2B (referencia) | Google, GGUF de ggml-org | 31 de marzo de 2026 | Apache 2.0 | 4,63 B según llama-bench | Densa | Q4_0 | 2,63 GiB |
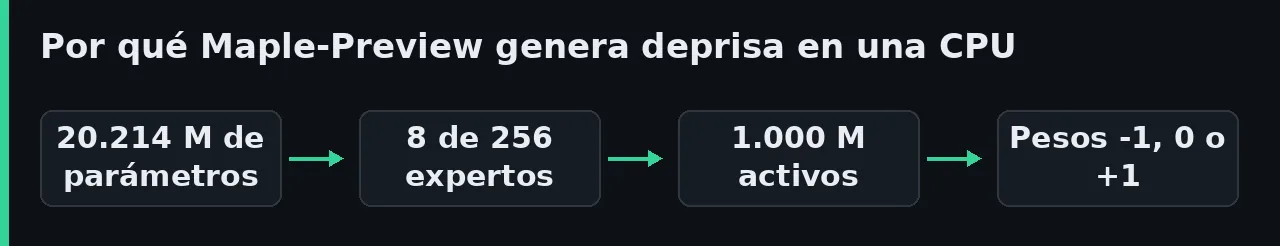
Maple-Preview[1] es un modelo de mezcla de expertos (MoE): 24 capas con 256 expertos, de los que el enrutador elige 8 por token. Sus pesos son ternarios: cada uno vale -1, 0 o +1 multiplicado por un factor de escala por bloque, y el formato TQ2_0 los guarda en 2,06 bits por peso. En CPU, la velocidad de generación depende sobre todo de cuántos bytes de pesos hay que leer de la memoria en cada token. Maple lee unos 1.000 millones de parámetros por token (el "A1B" de su nombre), a poco más de 2 bits cada uno.
La ficha afirma que resuelve problemas "de nivel IMO" y que supera las 200 tokens/s en un Mac mini M4, pero también reconoce su punto débil:
"this preview is focused primarily on raw reasoning and, as such, may underperform on agentic benchmarks." (DeepGrove, ficha de Maple-Preview en Hugging Face)
MiniCPM5-2B[2] usa la arquitectura estándar de Llama, con 42 capas y 2 cabezas de clave y valor, así que no necesita soporte específico en llama.cpp. OpenBMB lo declara en inglés y chino, no en español.
Spark-X2.5-4B[3] alterna tres capas de atención de ventana deslizante (512 tokens) con una de atención completa. Su ficha afirma un contexto nativo de 1.048.576 tokens y más de 200 idiomas. No lo confundas con Muse Spark de Meta, que es otro modelo. Gemma 4 E2B va como referencia porque es un modelo pequeño conocido; sus variantes están en la guía de Gemma 4 con Ollama.
Qué versión de llama.cpp necesita cada modelo
Con la v0.4.1, publicada el 14 de septiembre de 2026, funcionan los tres. Maple entró con el PR 27000[4], fusionado ese mismo día, y su autor lo describe como "CPU-only for now", con Metal y CUDA pendientes. Spark2.5 entró con el PR 27868[5], fusionado el 6 de septiembre, y la primera compilación nocturna que lo incluye es la b10828. MiniCPM5-2B no necesita nada nuevo.
Las fichas van por detrás del código. La del GGUF de Maple[6] remite al fork deepgrove-ai/llama.cpp. La del GGUF de Spark[7] remite al fork XHToken/llama.cpp, también para usarlo con Ollama y LM Studio. Probé los ficheros oficiales, sin reconvertirlos, en la compilación upstream y los tres cargaron y generaron texto.
Si aún no tienes llama.cpp, la guía para instalar llama.cpp en Linux, macOS y Docker cubre los cuatro canales; aquí usé la compilación desde el código de la etiqueta v0.4.1. Descarga los GGUF del repositorio oficial de cada autor y lanza la medida así:
llama-bench -m maple-preview-TQ2_0-head-Q4_K.gguf \
  -p 512 -n 128 -r 3 -t 4,8,16 -o json
-p 512 mide el procesamiento de un prompt de 512 tokens (prefill), -n 128 la generación de 128 tokens, -r 3 repite cada prueba tres veces y -t fija los hilos.
Cómo medí: máquina, compilación y carga
La máquina es una VM Linux arm64 sobre Apple silicon con 18 núcleos, 121 GB de RAM y sin GPU utilizable. Compilé llama.cpp v0.4.1 (commit b29c606) con GCC 13.3 en un contenedor de Ubuntu 24.04. CMake detectó dotprod, i8mm y bf16, y compiló sin SVE ni KleidiAI. Los cuatro GGUF estaban en un tmpfs, es decir, en RAM, así que los tiempos de carga de este artículo no incluyen lectura de disco.
Hice cinco rondas entre las 23:26 del 14 de septiembre y las 00:15 del 15 (UTC). En cada ronda roté el orden de los modelos, para que cualquier interferencia les afectara por igual. Cada ronda lanza llama-bench -p 512 -n 128 -r 3 con 4, 6, 8 y 16 hilos, y las tablas dan la mediana de las cinco rondas con el mínimo y el máximo entre paréntesis.
Empecé cuando la carga media a 1 minuto bajó de 6 (estaba en 5,60), después de 68 minutos esperando a que bajara la carga de los otros trabajos de la máquina. Durante las rondas osciló entre 1,33 y 16,70, y esa cifra incluye los hilos de la propia prueba: una ejecución con 16 hilos suma hasta 16. Las cinco tareas en español las lancé antes, con 2 hilos y una carga de 12 a 37, así que de ellas cuento tokens, no segundos.
Qué velocidad da cada modelo en una CPU sin GPU
Maple-Preview fue el más rápido generando con cualquier número de hilos: 172,84 tokens/s con 6, el doble que MiniCPM5-2B y 3,6 veces Spark-X2.5-4B. Estas son las medianas de generación de 128 tokens, en tokens/s:
| Modelo | 4 hilos | 6 hilos | 8 hilos | 16 hilos |
|---|---|---|---|---|
| Maple-Preview TQ2_0 | 144,43 (101,61–147,33) | 172,84 (161,40–181,16) | 133,65 (115,49–151,65) | 7,78 (6,88–8,06) |
| MiniCPM5-2B Q4_K_M | 72,95 (65,97–74,40) | 83,19 (74,12–84,62) | 68,03 (55,18–79,14) | 6,61 (6,28–6,83) |
| Spark-X2.5-4B Q4_K_M | 40,85 (33,32–41,09) | 47,41 (44,47–48,25) | 46,57 (34,58–49,81) | 6,87 (6,84–7,22) |
| Gemma 4 E2B Q4_0 | 57,14 (48,56–58,43) | 64,53 (63,53–67,34) | 61,29 (30,10–66,33) | 5,90 (5,50–5,94) |
En el procesamiento de un prompt de 512 tokens el orden es el mismo, y ahí sí compensa subir hilos hasta 16:
| Modelo | 4 hilos | 6 hilos | 8 hilos | 16 hilos |
|---|---|---|---|---|
| Maple-Preview TQ2_0 | 253,95 (211,70–257,21) | 337,68 (330,21–343,25) | 425,99 (419,16–429,76) | 584,06 (568,10–633,25) |
| MiniCPM5-2B Q4_K_M | 182,20 (170,44–183,57) | 241,69 (226,29–260,84) | 283,49 (253,61–286,02) | 455,48 (422,29–457,99) |
| Spark-X2.5-4B Q4_K_M | 95,63 (83,25–97,85) | 130,30 (123,15–133,04) | 157,80 (133,60–159,38) | 253,73 (225,45–260,14) |
| Gemma 4 E2B Q4_0 | 154,11 (135,96–157,21) | 212,96 (209,98–216,66) | 266,88 (238,81–268,15) | 413,03 (267,98–427,84) |
La ficha GGUF de Maple publica, para este mismo fichero en la CPU de un M5 Pro con 16 hilos, 610,48 tokens/s de prefill y 252,74 de generación. Mi prefill con 16 hilos quedó un 4 % por debajo, en 584,06, pero la generación con 16 hilos se hundió y mi mejor cifra, con 6, fue un 32 % inferior a la suya. El autor del PR 27000 midió en la CPU de un M4 unos 216 tokens/s de prefill y 88 de generación, sin indicar hilos ni longitud del prompt.
Los 218 tokens/s en un Mac mini M4 de la ficha principal no salen de llama.cpp: la propia ficha aclara que ese resultado usa "a separate on-device runtime". El Show HN del 4 de agosto[8], con 173 puntos, llevaba en el título 120 tokens/s en un iPhone, que no he podido comprobar. Con llama.cpp sobre CPU, mi máximo fue 172,84.
Cuántos hilos usar para generar en una CPU
En esta VM, la generación rindió más con 6 hilos y se desplomó a partir de 10, mientras que el prefill siguió subiendo hasta 16. Los puntos de 4, 6, 8 y 16 hilos son las medianas de las cinco rondas. Los de 2, 10, 12 y 14 salen de una sola llamada de llama-bench con dos repeticiones por modelo y una carga de 6,59 a 11,46.
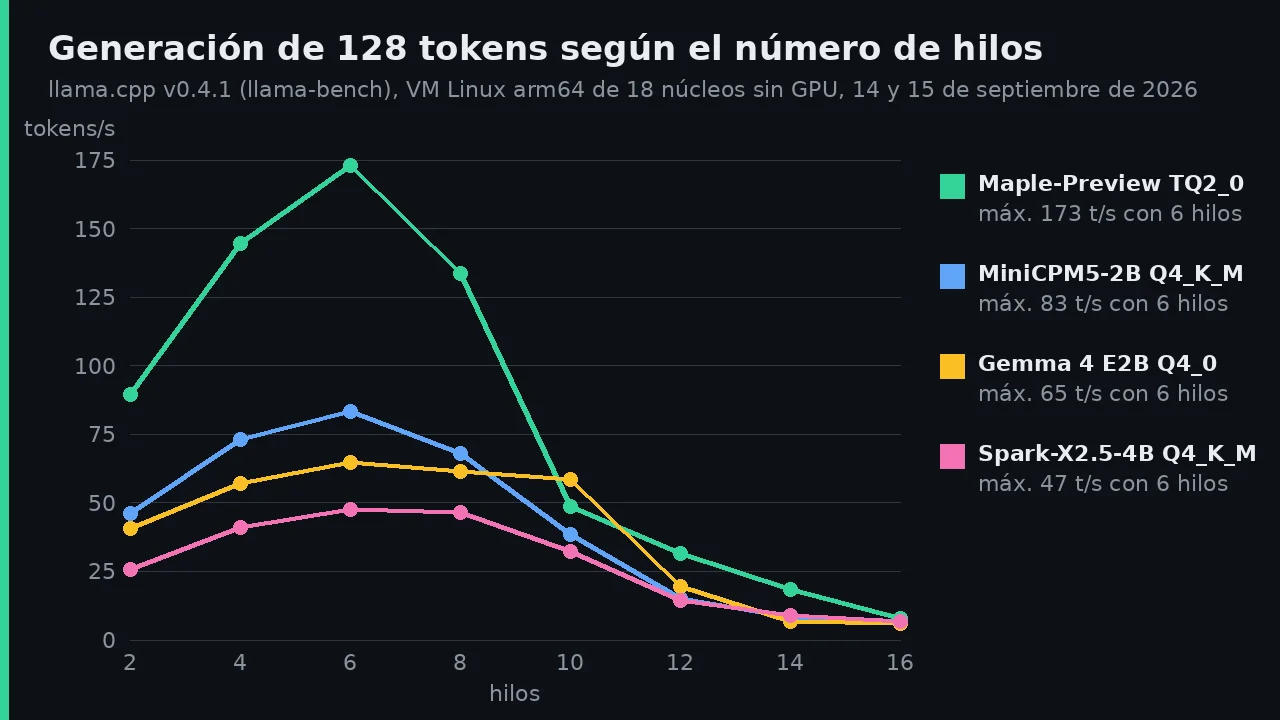
Generar un token exige leer de la memoria todos los pesos activos, así que la velocidad depende más del ancho de banda de memoria que de los núcleos. Además, llama.cpp reparte cada operación del grafo de cálculo entre los hilos y no pasa a la siguiente hasta que terminan todos, de modo que un hilo que se retrasa frena al resto. En una VM compartida, cuantos más hilos, más probable es que el anfitrión retrase alguno. No he aislado cuál de los dos efectos pesa más aquí.
Con la máquina ocupada por otros procesos, el punto óptimo baja todavía más. Con una carga media de 37 sobre 18 núcleos, antes de las rondas, llama-bench dio para MiniCPM5-2B estas cifras:
| Hilos | Prefill de 16 tokens (tokens/s) | Generación de 32 tokens (tokens/s) |
|---|---|---|
| 2 | 33,00 | 9,15 |
| 4 | 21,92 | 2,96 |
| 8 | 15,61 | 1,43 |
En mi primera prueba de las cinco tareas, con 8 hilos y esa carga, MiniCPM5 tardó 560 s en contestar la cuenta de la compra. La guía de instalación llegó a lo mismo con Gemma 4: sin -t, el modelo no terminó de leer la pregunta en 60 s.
Cuánta memoria y disco ocupa cada modelo
Maple es el que más RAM pide, pero la diferencia es menor de lo que sugiere su tamaño en disco. Lancé llama-server con 16.384 tokens de contexto y una sola ranura, le hice una petición corta y leí VmHWM en /proc. Lo repetí tres veces por modelo, con la caché de páginas caliente y una carga media de 23 a 27:
| Modelo | Fichero | RSS máxima | Pesos mapeados | Pesos reempaquetados | Caché KV | Hasta el primer 200 de /health |
|---|---|---|---|---|---|---|
| Maple TQ2_0 | 5,49 GiB | 5,79 GiB | 5.456 MiB | 167 MiB | 228 MiB | 0,69 a 1,41 s |
| MiniCPM5 Q4_K_M | 1,45 GiB | 3,27 GiB | 1.268 MiB | 1.340 MiB | 672 MiB | 1,90 a 1,96 s |
| Spark Q4_K_M | 2,42 GiB | 5,56 GiB | 2.461 MiB | 2.474 MiB | 684 MiB | 2,38 a 2,46 s |
| Gemma 4 E2B Q4_0 | 2,63 GiB | 4,24 GiB | 2.695 MiB | 1.407 MiB | 108 MiB | 1,97 a 2,05 s |
La columna de pesos reempaquetados explica la sorpresa. En ARM, llama.cpp copia los tensores Q4_K y Q4_0 a un búfer CPU_REPACK con un formato que sus núcleos NEON procesan mejor. Por eso los pesos de MiniCPM5 y Spark aparecen dos veces en la RSS: la copia mapeada del fichero y la reempaquetada. Los tensores TQ2_0 de Maple se usan tal cual, y solo reempaqueta la cabeza de salida.
En un disco normal, el kernel puede liberar las páginas mapeadas que ya no se leen; aquí, al estar en tmpfs, contaron como memoria compartida.
La caché KV también cambia. La de MiniCPM5 es la mayor porque sus 42 capas usan atención completa. Maple y Spark limitan tres de cada cuatro capas a una ventana de 512 tokens, y Gemma 4 E2B también usa ventana deslizante. Para estimar tu caso con otro contexto, usa la calculadora de modelos de lenguaje locales.
Cómo respondieron a cinco tareas en español
Es una prueba de cordura, no un banco de pruebas: cinco preguntas en español y una muestra por pregunta. Usé temperatura 1,0, top_p 0,95, min_p 0 y top_k desactivado (lo que recomienda la ficha de MiniCPM5; la de Spark coincide en temperatura y top_p), con semilla fija. Las lancé contra llama-server con el modo de razonamiento que trae cada modelo por defecto y un tope de 4.096 tokens. Estas son las tareas:
- Hecho: fecha y estaciones de la primera línea del Metro de Madrid (17 de octubre de 1919, Cuatro Caminos a Sol).
- Resumen: un párrafo de 101 palabras sobre una migración de correo, en dos frases y 40 palabras como máximo.
- Extracción: un correo convertido a JSON con contacto, empresa, fecha, hora e importe sin IVA (12.500 €).
- Cuenta: 12 cuadernos a 2,35 € con un 10 % de descuento, 3 bolígrafos a 1,20 € y un billete de 50 € (devuelven 21,02 €).
- Código: una función de Python que valide la letra de un DNI, que ejecuté contra 9 casos en un contenedor sin red.
| Tarea | Maple-Preview | MiniCPM5-2B | Spark-X2.5-4B | Gemma 4 E2B |
|---|---|---|---|---|
| 1. Hecho | Incorrecta | Incorrecta | Incorrecta | Incorrecta |
| 2. Resumen | Parcial | Incorrecta | Correcta | Correcta |
| 3. JSON | Correcta | Correcta | Correcta | Correcta |
| 4. Cuenta | Correcta | Correcta, en inglés | Sin respuesta en 4.096 tokens | Correcta |
| 5. Código | Correcta, 9 de 9 | Correcta, 9 de 9 | Correcta, 9 de 9 | Sin respuesta en 4.096 tokens |
| Tokens generados en total | 2.755 | 2.792 | 8.199 | 6.361 |
La pregunta de cultura general la falló todo el mundo, y ninguno dijo que no lo sabía.
Maple respondió "el 10 de abril de 1919, entre las estaciones de Atocha y Moncloa". MiniCPM5 dijo "1914" y unas estaciones "Cívico y Urraca", y Spark, "28 de julio de 1910" entre "Plaza de Toros y Champernowy". Gemma se quedó en "el 20 de junio de 1919", entre Argüelles y Sol. Para datos concretos, estos modelos necesitan que les pases el texto o una herramienta de búsqueda.
En español hubo diferencias claras. Spark y Maple razonaron en español; MiniCPM5 y Gemma lo hicieron en inglés, y MiniCPM5 llegó a contestar la cuenta entera en inglés, con LaTeX y \boxed{21.02}.
El resumen de MiniCPM5 empezó con "Las incidentes nocturnos": falla la concordancia y el texto original no dice que fueran de noche. El de Maple convirtió a los dos usuarios afectados en "Tres usuarios sin correo en móvil" y se pasó de las 40 palabras. En la cuenta, Maple acertó los 21,02 € con una frase sin sentido por medio: "se le devuelve el doble que el valor pagado".
La primera versión de la tarea 3 pedía una clave nombre ambigua, porque el correo nombra a tres personas. Maple eligió a la destinataria, MiniCPM5 al remitente y Gemma a la persona de la reunión. Cambié la clave por contacto, con la aclaración "la persona con la que es la reunión", y repetí esas tres respuestas; con esa redacción acertaron los cuatro.
Cuánto cuesta el modo de razonamiento en una CPU
El razonamiento multiplicó los tokens por 4,7 en MiniCPM5, por 9,1 en Spark y por 2,6 en Gemma, y en una CPU cada token se paga en segundos. Repetí las cinco tareas con "chat_template_kwargs": {"enable_thinking": false} en la petición, que desactiva el razonamiento en las plantillas de MiniCPM5, Spark y Gemma:
| Modelo | Tokens con razonamiento | Tokens sin razonamiento | Correctas sin razonamiento |
|---|---|---|---|
| MiniCPM5-2B | 2.792 | 588 | 2 de 5 |
| Spark-X2.5-4B | 8.199 | 903 | 2 de 5, y 2 parciales |
| Gemma 4 E2B | 6.361 | 2.459 | 2 de 5, y 1 parcial |
A la velocidad medida con 6 hilos, las cinco respuestas de Spark con razonamiento suman unos 173 s de generación, frente a 19 s sin él. En Gemma son 99 s frente a 38 s, y en MiniCPM5, 34 s frente a 7 s. Maple las generó todas en unos 16 s. Son cotas inferiores, porque llama-bench mide la generación con el contexto vacío y con miles de tokens acumulados va algo más lenta.
Sin razonamiento, la calidad bajó en los tres. MiniCPM5 escribió una función con un error de sintaxis (if not digit.isdigit() for digit in digits:) y Gemma se inventó una suma ponderada que no existe en el algoritmo del DNI. Spark envolvió el JSON en un bloque de código aunque el enunciado decía "No escribas nada más". Spark, en cambio, resolvió la cuenta en 549 tokens sin razonar, la misma cuenta que con razonamiento no terminó en 4.096.
Maple no tiene interruptor. Su plantilla abre la etiqueta de pensamiento en cada respuesta y no lee enable_thinking. Probé también a arrancar llama-server con --reasoning-budget 0, y con la misma semilla las cinco respuestas salieron idénticas, carácter a carácter, a las de la ejecución sin esa opción. Aun así fue el más contenido: 2.755 tokens en total, el tope nunca le afectó y, a su velocidad, piensa y responde antes que los demás.
Qué modelo usar según la tarea
La respuesta depende de si te sobra RAM o CPU:
- Máxima velocidad de generación con 6 GiB de RAM libres: Maple-Preview. Generó 172,84 tokens/s con 6 hilos y procesó el prompt a 425,99 tokens/s con 8. Asume que siempre razona y que se inventa datos.
- Poca memoria o un equipo pequeño: MiniCPM5-2B, con 1,45 GiB de fichero y 3,27 GiB de RSS a 16.384 tokens. Desactiva el razonamiento solo para extracción o formato, y ten presente que su español es el más flojo de los tres.
- Español y tareas con pasos intermedios, con tiempo: Spark-X2.5-4B. Fue el que mejor resumió y razonó en español, pero es el más lento por token y su razonamiento se alarga: sube
max_tokenso desactívalo en tareas cortas. - Visión o audio: ninguno de los tres, que solo generan texto. El repositorio GGUF de Gemma 4 E2B sí incluye el proyector multimodal (
mmproj).
Para situar estos modelos entre el resto de lanzamientos recientes, repasa qué modelos abiertos de agosto de 2026 merece la pena ejecutar. Y si lo que quieres es lo contrario, un MoE de cientos de GB en un equipo modesto, Colibri lee los expertos desde el disco.
Preguntas frecuentes
¿Se puede ejecutar un LLM sin GPU a una velocidad útil?
Sí, si eliges un modelo pequeño o con pocos parámetros activos. En esta VM arm64, con 6 hilos, Maple-Preview generó 172,84 tokens/s, MiniCPM5-2B 83,19 y Spark-X2.5-4B, el más lento, 47,41. Con la máquina cargada, limita los hilos con -t.
¿Hace falta un fork de llama.cpp para Maple-Preview o Spark-X2.5?
No desde la v0.4.1. Maple necesita una compilación que incluya el PR 27000 (fusionado el 14 de septiembre de 2026) y Spark una igual o posterior a la b10828. Los GGUF oficiales cargaron sin reconvertir, aunque sus fichas todavía enlacen a forks.
¿Cuál de los tres responde mejor en español?
En esta prueba, Spark-X2.5-4B: razonó en español, hizo el único resumen correcto de los tres y resolvió la cuenta en español sin razonamiento. Maple también razonó en español, con algún error gramatical, y MiniCPM5, que solo declara inglés y chino, contestó una tarea entera en inglés.
Conclusión
Sin GPU, Maple-Preview es la opción cuando la velocidad de generación manda y tienes unos 6 GiB libres. MiniCPM5-2B encaja cuando la memoria es el límite, y Spark-X2.5-4B cuando el texto en español importa más que los segundos. Ninguno sirve como fuente de datos sin contexto: los cuatro inventaron la fecha de la primera línea del Metro de Madrid. Si vas a elegir cuantización para alguno de ellos, empieza por cómo funcionan la cuantización y llama.cpp en un portátil.
Fuentes
- Maple-Preview
- MiniCPM5-2B
- Spark-X2.5-4B
- PR 27000
- PR 27868
- GGUF de Maple
- GGUF de Spark
- Show HN del 4 de agosto
- Notas de la versión v0.4.1 de llama.cpp
- PR 8151: empaquetado ternario TQ1_0 y TQ2_0
- Repositorio de MiniCPM en GitHub
- GGUF oficial de MiniCPM5-2B
- GGUF de Gemma 4 E2B de ggml-org
- Historial de versiones de Gemma (Google AI for Developers)
- Línea 1 del Metro de Madrid en Wikipedia