Cómo importar un modelo de Hugging Face en Ollama 0.34
Índice de contenidos
- Puntos clave
- Qué cambió al importar modelos en Ollama 0.34.1
- Qué necesitas antes de importar un modelo de Hugging Face
- Cómo descargar el modelo con hf download
- Cómo convertir los safetensors a GGUF con llama.cpp
- Cómo cuantizar el GGUF con llama-quantize
- Cómo crear el modelo en Ollama con un Modelfile
- Por qué no hace falta escribir TEMPLATE en el Modelfile
- Qué pasa si importas los safetensors directamente
- Cuánto rinde el modelo importado en CPU
- Cuándo descargar el GGUF con ollama pull hf.co
- Errores al importar en Ollama 0.34.1 y cómo resolverlos
- Preguntas frecuentes
- ¿Puedo seguir cuantizando con ollama create --quantize?
- ¿Puedo importar un adaptador LoRA en Ollama 0.34.1?
- ¿Puedo borrar el GGUF después de importarlo?
- Conclusión
- Fuentes
Desde Ollama 0.34.1, ollama create ya no convierte ni cuantiza los pesos que descargas de Hugging Face: esa parte la hace llama.cpp. La versión lleva fecha del 14 de septiembre de 2026, y la orden de una línea que convertía una carpeta de safetensors a GGUF ahora responde con un error. Esta guía importa MiniCPM5-2B de principio a fin con las herramientas que funcionaron el 16 de septiembre, con los tiempos, tamaños y errores que obtuve en una CPU arm64 sin GPU. Tienes también la versión en inglés de esta guía.
Puntos clave
- En Ollama 0.34.1,
ollama create --quantize q4_K_Mrespondeunsupported --quantize "q4_K_M": la opción solo acepta los formatos MLXint4,int8,nvfp4,mxfp4ymxfp8. - La ruta que no depende de MLX es
convert_hf_to_gguf.pyyllama-quantizede llama.cpp v0.4.1, y despuésollama createdesde el GGUF. - Con MiniCPM5-2B, la conversión a BF16 tardó 35 s, la cuantización a Q4_K_M 21 s y la importación 2 s, medianas de tres ejecuciones.
- Ollama usa la plantilla de chat Jinja que llama.cpp guarda en el GGUF: el modelo importado anunció herramientas y razonamiento sin una línea
TEMPLATE. - En Linux sin MLX, importar safetensors falla con
MLX runtime is not available, yADAPTERytypical_pya no se aceptan. - Con la máquina ocupada, fija
PARAMETER num_thread: con 4 hilos respondió a 52,48 tokens/s y con los 18 por defecto no terminó en 4 minutos.
Qué cambió al importar modelos en Ollama 0.34.1
Ollama 0.34.1 dejó la conversión y la cuantización de GGUF en manos de llama.cpp. Las notas de la versión lo resumen en una frase: "GGUF model creation now requires using llama.cpp tooling for safetensor conversion and quantization". El cambio llega con el PR 14969 de Ollama[1], de Daniel Hiltgen, abierto en marzo y fusionado horas antes de la versión, que elimina el conversor interno y la cuantización en el servidor. GitHub fecha la versión el 14 de septiembre a las 22:14 UTC, aunque la etiqueta apunta a un commit del 15 y la imagen Docker se construyó ese mismo día.
La guía de importación de Ollama[2] lo explica sin rodeos:
"Ollama does not quantize GGUF models during import. Prepare and quantize them first with a GGUF tool such as llama.cpp’s llama-quantize." (documentación de Ollama, "Importing a Model")
Probé las mismas órdenes en la versión anterior, la 0.34.0, y en la 0.34.1, con la carpeta de MiniCPM5-2B y con su GGUF. Esto respondió cada una:
| Orden o instrucción | Ollama 0.34.0 | Ollama 0.34.1 |
|---|---|---|
ollama create -q q4_K_M desde safetensors |
Convierte y cuantiza: 1,6 GB en 106 s | unsupported --quantize "q4_K_M" |
ollama create -q q4_K_M desde un GGUF BF16 |
Cuantiza: 1,6 GB en 17 s | create-time quantization is only supported for safetensors imports |
ADAPTER en el Modelfile |
Lee el fichero del adaptador | LoRA adapters are no longer supported |
PARAMETER typical_p 0.9 |
Crea el modelo | typical_p is no longer supported |
--experimental |
Activa la creación experimental desde safetensors | Opción oculta que no hace nada |
El PR 18448[3] detalla el caso de typical_p: los modelos GGUF que ya lo tienen lo conservan, pero no puedes crear uno nuevo con ese parámetro. La 0.34.1 trae además otros cambios que no afectan a la importación, como un /api/tags que, según las pruebas que citan sus notas, pasa de 3,1 s a 294 ms en frío.
Qué necesitas antes de importar un modelo de Hugging Face
Necesitas Ollama 0.34.1, las herramientas de conversión de llama.cpp y la línea de comandos de Hugging Face, más unos 13 GB libres para un modelo de 2500 millones de parámetros. Si aún no tienes Ollama, sigue la guía para instalar Ollama en tu ordenador. Estas son las piezas; de las dos primeras basta una, porque producen el mismo fichero:
- Imagen Docker
full:ghcr.io/ggml-org/llama.cpp:full-v0.4.1ocupa 3,91 GB y traeconvert_hf_to_gguf.py,llama-quantizey las dependencias de Python - Instalación local: el código de la v0.4.1 más un entorno virtual con sus requisitos, que ocupó 956 MB; los binarios salen de la guía de instalación de llama.cpp
- Línea de comandos
hf: viene en el paquetehuggingface_hub, versión 1.31.0 del 10 de septiembre
El espacio se reparte así: 5,03 GB de safetensors, 5,04 GB del GGUF en BF16, 1,56 GB del GGUF cuantizado y otros 1,56 GB de la copia que guarda Ollama.
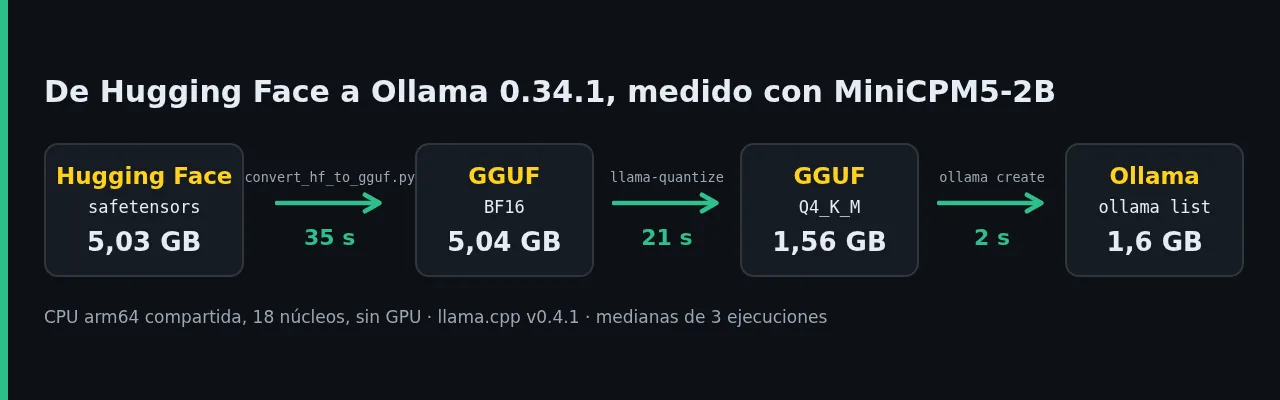
El modelo de la prueba es MiniCPM5-2B[4], que OpenBMB publicó el 6 de septiembre de 2026 con licencia Apache-2.0. Tiene 2516 millones de parámetros, 42 capas y un contexto de 131 072 tokens, y usa la arquitectura estándar LlamaForCausalLM, así que llama.cpp lo convierte sin parches. Todas las pruebas se hicieron en una máquina virtual Linux arm64 sobre Apple silicon, con 18 núcleos, 121 GB de RAM y sin GPU, compartida con otros trabajos.
Cómo descargar el modelo con hf download
hf download baja el repositorio completo a una carpeta local. Fija la revisión si quieres que la conversión se pueda repetir con los mismos pesos:
pip install "huggingface_hub==1.31.0"
hf download openbmb/MiniCPM5-2B \
  --revision 12a3808a956f869c767195e9266b59c4d21d92e2 \
  --local-dir ./MiniCPM5-2B
La descarga trajo 11 ficheros y 5,05 GB en 68 s, contando la instalación del paquete. La carpeta contiene config.json, tokenizer.json, chat_template.jinja y un único model-00000-of-00001.safetensors de 5 033 557 096 bytes. Sin token, hf avisa de que las peticiones anónimas tienen límites más bajos; para un modelo con acceso restringido, exporta HF_TOKEN antes.
Cómo convertir los safetensors a GGUF con llama.cpp
convert_hf_to_gguf.py lee la carpeta de Hugging Face y escribe un GGUF con los pesos, el tokenizador y los metadatos. Convierte a BF16, el tipo original de MiniCPM5-2B, y cuantiza después. Con la imagen Docker full, --convert ejecuta el script:
docker run --rm -u "$(id -u):$(id -g)" -e HOME=/tmp \
  -v "$PWD:/models" \
  ghcr.io/ggml-org/llama.cpp:full-v0.4.1 \
  --convert /models/MiniCPM5-2B --outtype bf16 \
  --outfile /models/MiniCPM5-2B-BF16.gguf
Sin Docker, clona la etiqueta v0.4.1 e instala los requisitos del conversor en un entorno virtual. La instalación tardó 24 s y dejó torch 2.11.0 para CPU, transformers 4.57.6 y gguf 0.19.0:
git clone --depth 1 --branch v0.4.1 \
  https://github.com/ggml-org/llama.cpp
python3 -m venv .venv && . .venv/bin/activate
pip install -r llama.cpp/requirements/requirements-convert_hf_to_gguf.txt
python llama.cpp/convert_hf_to_gguf.py ./MiniCPM5-2B \
  --outtype bf16 --outfile MiniCPM5-2B-BF16.gguf
Las dos vías produjeron un fichero idéntico byte a byte, de 5 039 008 704 bytes y 381 tensores. Repetí la conversión con Docker tres veces: 35,0 s, 41,2 s y 32,3 s, con una carga media de 31 a 37 sobre 18 núcleos. El único aviso fue Unknown separator token '<s>' in TemplateProcessing<pair>, que no afectó al resultado.
El script guarda en el GGUF la plantilla de chat de chat_template.jinja y los valores de muestreo de generation_config.json: temperatura 1,0 y top_p 0,95. Si el modelo necesita transformers 5, la documentación de llama-quantize[5] indica que puedes actualizarlo con pip install -U transformers; con MiniCPM5-2B no hizo falta.
Cómo cuantizar el GGUF con llama-quantize
llama-quantize reduce el GGUF de 16 bits a Q4_K_M en una sola orden. La cuantización de modelos con llama.cpp explica el fundamento. Aquí eliges el tipo en el último argumento:
docker run --rm -u "$(id -u):$(id -g)" -v "$PWD:/models" \
  ghcr.io/ggml-org/llama.cpp:full-v0.4.1 \
  --quantize /models/MiniCPM5-2B-BF16.gguf \
  /models/MiniCPM5-2B-Q4_K_M.gguf Q4_K_M
Con llama.cpp instalado en el sistema, la orden equivalente es llama-quantize MiniCPM5-2B-BF16.gguf MiniCPM5-2B-Q4_K_M.gguf Q4_K_M. El final de la salida resume la reducción:
llama_model_quantize_impl: model size  =  4800.66 MiB (16.00 BPW)
llama_model_quantize_impl: quant size  =  1484.08 MiB (4.95 BPW)
llama_quantize: quantize time = 20647.62 ms
Las tres ejecuciones tardaron 32,3 s, 20,5 s y 20,6 s, con una carga media de 34 a 38. Q4_K_M no deja todo en 4 bits. La herramienta pasó a Q6_K la matriz de salida y los tensores attn_v y ffn_down de 21 de las 42 capas, así que la media queda en 4,95 bits por peso. También generé un Q8_0 de 2550,66 MiB para comparar.
OpenBMB publica sus propios GGUF en MiniCPM5-2B-GGUF[6], con un fichero de 16 bits en F16 y no en BF16. Mis tres ficheros miden 2016 bytes más que los suyos: 1 561 320 384 frente a 1 561 318 368 bytes en Q4_K_M. La diferencia constante apunta a los metadatos, no a los pesos. La imagen Docker de Ollama 0.34.1 incluye su propio llama-quantize en /usr/lib/ollama, compilado con la b10864 de llama.cpp que Ollama lleva dentro, pero no el conversor de Python.
Cómo crear el modelo en Ollama con un Modelfile
ollama create copia el GGUF a su almacén y le añade los parámetros del Modelfile. Este es el Modelfile que usé, en la misma carpeta que el GGUF:
FROM ./MiniCPM5-2B-Q4_K_M.gguf
PARAMETER num_ctx 8192
PARAMETER num_thread 4
SYSTEM """Responde en español de España."""
El parámetro num_ctx sube el contexto desde los 4096 tokens que Ollama asigna por defecto en un equipo sin GPU, según su propio registro. El parámetro num_thread limita los hilos de CPU, y la sección de rendimiento explica por qué lo añadí. La línea SYSTEM fija el idioma de las respuestas. Después, crea y comprueba el modelo:
ollama create minicpm5-2b
ollama show minicpm5-2b
ollama run minicpm5-2b --think=false --verbose \
  "Resume en una frase qué es un Modelfile de Ollama."
La importación tardó 2,25 s, 1,93 s y 1,99 s en tres repeticiones con una carga media de 5,5. La orden ollama show confirmó la arquitectura y las capacidades que Ollama detectó en el GGUF:
  Model
    architecture        llama
    parameters          2.5B
    context length      131072
    embedding length    2048
    quantization        Q4_K_M

  Capabilities
    tools
    thinking
    completion
Con --verbose, ollama run imprime las métricas al final. Esta es la primera de tres ejecuciones, con la máquina a una carga media de 51:
Un Modelfile de Ollama es una configuración que permite personalizar
y gestionar las modelos que utiliza para la creación de contenido.
total duration:       606.975347ms
prompt eval count:    41 token(s)
prompt eval cached:   40 token(s)
eval count:           30 token(s)
eval rate:            52.48 tokens/s
El error de concordancia de la respuesta ("las modelos") viene del propio MiniCPM5-2B, que con 2500 millones de parámetros comete fallos en español. En otra prueba con el razonamiento activado, definió GGUF como "una archivación de audio". Sin --think=false, MiniCPM5-2B razona antes de contestar y Ollama devuelve ese texto en el campo thinking de la API, separado de la respuesta. Si vas a darle herramientas, la guía de function calling con Ollama explica cómo declararlas.
Por qué no hace falta escribir TEMPLATE en el Modelfile
Ollama 0.34.1 usa la plantilla Jinja guardada en el GGUF si el Modelfile no trae plantilla. También la prefiere cuando declara más capacidades que la plantilla Go del Modelfile, y el registro lo anota al cargar el modelo:
msg="template selection" model=…/minicpm5-2b:openbmb-template
selected=gguf_chat_template go_template=[completion]
chat_template="[tools thinking completion]"
Esa línea corresponde a una prueba con el Modelfile de la guía de OpenBMB para Ollama[7], que añade un bloque TEMPLATE en Go. La guía afirma que "Ollama 0.24 does not directly evaluate the GGUF-embedded Jinja chat template". En la 0.34.1 ese bloque no se usa: su plantilla solo cubre completion, así que Ollama eligió la del GGUF y el razonamiento siguió funcionando. Según el código de la 0.34.1, si defines OLLAMA_GO_TEMPLATE=1 en el servidor, Ollama usa el TEMPLATE del Modelfile aunque el GGUF traiga plantilla.
La ruta antigua no guardaba esa plantilla. El GGUF que generó Ollama 0.34.0 tenía 32 claves de metadatos y ninguna tokenizer.chat_template, y ollama show solo le reconocía completion. El que genera llama.cpp tiene 69 claves, la plantilla incluida. Añade TEMPLATE solo si el GGUF no trae plantilla, o si quieres forzar un formato con OLLAMA_GO_TEMPLATE.
Qué pasa si importas los safetensors directamente
En Linux arm64, ollama create desde la carpeta de safetensors falla en menos de un segundo, porque la 0.34.1 envía esa importación a MLX. Un Modelfile con FROM ./MiniCPM5-2B produjo esto:
importing safetensors model
Error: MLX runtime is not available: failed to load MLX dynamic
library (searched: [/usr/lib/ollama …])
La opción --force salta esa validación. Con ella, Ollama importó el modelo en 26 s como 386 capas y 5,0 GB, pero ollama run devolvió Error: 500 Internal Server Error: MLX runtime is not available. Borrarlo con ollama rm redujo el almacén de blobs de 7,7 GB a 3,0 GB.
El Dockerfile de Ollama v0.34.1[8] explica el fallo: copia la compilación de MLX, con backend CUDA 13, solo en la imagen amd64, y la imagen arm64 no la tiene. No pude probar esa compilación amd64 ni la ruta de un Mac con Apple silicon, donde MLX es nativo y --quantize acepta int4 o nvfp4: no tengo un Mac ni una GPU de NVIDIA. Si trabajas en Mac y buscas una alternativa basada en MLX, lee qué es oMLX y en qué se diferencia de Ollama.
Cuánto rinde el modelo importado en CPU
Con 4 hilos, las medianas de generación del Q4_K_M fueron de 32 a 70 tokens/s según la herramienta y la carga. El número de hilos por defecto fue el problema más serio de la prueba. Sin num_thread, Ollama arrancó su llama-server interno con 18 hilos, uno por núcleo.
En dos intentos, con la carga media entre 10 y 62, ninguna de las dos respuestas había terminado a los 4 minutos. Con num_thread 4, tres ejecuciones con carga de 48 a 51 dieron 52,48, 53,40 y 50,69 tokens/s.
Para medir los formatos usé llama-bench con 4 hilos, tres ejecuciones de tres repeticiones cada una y una carga media de 11,3 a 13,4. La perplejidad sale de 20 fragmentos de 512 tokens del Quijote de Project Gutenberg[9], con 8 hilos:
| Formato | Tamaño | Prompt de 128 tokens | Generación de 64 tokens | Perplejidad |
|---|---|---|---|---|
| Q4_K_M | 1,56 GB | 104,68 tokens/s | 32,52 tokens/s | 26,90 ± 1,18 |
| Q8_0 | 2,68 GB | 165,60 tokens/s | 33,70 tokens/s | 25,50 ± 1,12 |
| BF16 | 5,04 GB | 2,67 tokens/s | 2,28 tokens/s | Sin medir |
En esta CPU, Q8_0 procesó el prompt un 58 % más deprisa que Q4_K_M y generó al mismo ritmo, y Q4_K_M sube la perplejidad un 5,5 % respecto a Q8_0. Q4_K_M ocupa un 42 % menos en disco que Q8_0; en memoria, /api/ps informó de 2,03 GB con num_ctx 8192 y de 1,79 GB con el contexto por defecto. El BF16 solo sirve como paso intermedio: a 2,28 tokens/s no es utilizable en este procesador.
Importar no penaliza la velocidad frente a llama.cpp. Comparé Ollama con la imagen server-v0.4.1 de llama.cpp sobre el mismo GGUF, con 4 hilos, temperatura 0, 128 tokens y el razonamiento desactivado, en cinco rondas alternas:
| Carga media | Ollama 0.34.1 | llama-server v0.4.1 |
|---|---|---|
| 8,6 a 9,6 | 69,99 tokens/s | 59,49 tokens/s |
| 15,9 a 17,6 | 49,29 tokens/s | 29,72 tokens/s |
Son medianas de generación. No aislé la causa de la diferencia: la compilación de Ollama no usa OpenMP y carga el modelo sin mmap, mientras que la imagen de llama.cpp sí usa OpenMP y mmap.
Cuándo descargar el GGUF con ollama pull hf.co
Si el autor ya publica un GGUF, no necesitas convertir nada: ollama pull hf.co/usuario/repositorio:cuantización lo descarga desde el Hub. La documentación del Hub sobre Ollama[10] indica que, sin etiqueta, se elige Q4_K_M si existe. Con el GGUF oficial de MiniCPM5-2B:
ollama pull hf.co/openbmb/MiniCPM5-2B-GGUF:Q4_K_M
La descarga de 1,6 GB tardó 21 s, y el modelo mostró las mismas capacidades que el importado a mano. El Hub le añadió además cinco secuencias de parada, porque el repositorio no tiene fichero params: <s>, <|im_start|>, <|im_end|>, <think> y <|im_start|>user. Importa tú el modelo cuando no exista un GGUF, cuando quieras una cuantización que el autor no publica o cuando partas de un ajuste fino propio. Para elegir tamaño y variante, compara con Gemma 4 con Ollama en tu propio equipo.
Errores al importar en Ollama 0.34.1 y cómo resolverlos
Cuatro mensajes de error salieron en las pruebas, y los cuatro tienen arreglo:
unsupported --quantize "q4_K_M": supported types are int4, int8, nvfp4, mxfp4, mxfp8: la orden antigua desde safetensors; convierte y cuantiza con llama.cppcreate-time quantization is only supported for safetensors imports; quantize GGUF models before importing: quita--quantizey pasa porllama-quantizeMLX runtime is not available: failed to load MLX dynamic library: estás importando safetensors en un sistema sin MLX; convierte a GGUFLoRA adapters are no longer supported: fusiona el adaptador con el modelo base antes de convertirlo, porqueADAPTERya no existe
Un quinto caso no da error y cuesta más detectarlo: el modelo no responde, o tarda minutos, porque usa todos los núcleos en una máquina ocupada. PARAMETER num_thread lo corrige.
Preguntas frecuentes
¿Puedo seguir cuantizando con ollama create –quantize?
Solo para importaciones de safetensors por MLX, y únicamente con int4, int8, nvfp4, mxfp4 o mxfp8. Para un GGUF, la 0.34.1 rechaza la opción y te pide cuantizar antes con llama-quantize.
¿Puedo importar un adaptador LoRA en Ollama 0.34.1?
No. La instrucción ADAPTER devuelve LoRA adapters are no longer supported y ya no figura en la referencia del Modelfile. La salida es fusionar el adaptador con el modelo base y convertir el resultado a GGUF.
¿Puedo borrar el GGUF después de importarlo?
Sí. ollama create copia el fichero a su almacén de blobs, que en la imagen Docker está en /root/.ollama/models/blobs. El modelo sigue funcionando sin el GGUF original, y ollama rm libera esa copia.
Conclusión
Para importar un modelo de Hugging Face en Ollama 0.34.1, descarga los safetensors con hf download, conviértelos con convert_hf_to_gguf.py, cuantiza con llama-quantize y crea el modelo con un Modelfile que fije num_ctx y, en una máquina compartida, num_thread. No escribas TEMPLATE si el GGUF trae su plantilla. El 15 de septiembre ya había una v0.34.2-rc0 en prerelease cuyas notas solo dicen "llama.cpp updates"; las revisé el 16 de septiembre y no cambian este procedimiento. Antes de repetir la guía con otra versión, lee sus notas en la página de versiones de Ollama[11].
Fuentes
- PR 14969 de Ollama
- guía de importación de Ollama
- PR 18448
- MiniCPM5-2B
- documentación de llama-quantize
- MiniCPM5-2B-GGUF
- guía de OpenBMB para Ollama
- Dockerfile de Ollama v0.34.1
- Quijote de Project Gutenberg
- documentación del Hub sobre Ollama
- página de versiones de Ollama
- Notas de la versión v0.34.1 de Ollama
- Referencia del Modelfile de Ollama
- Script convert_hf_to_gguf.py de llama.cpp
- Imágenes Docker de llama.cpp
- Notas de la versión v0.4.1 de llama.cpp
Código fuente
Accede a todo el código fuente de este artículo en GitHub.
Ver en GitHub