Cómo arreglar el error «typical_p is no longer supported» en Ollama
Índice de contenidos
- Puntos clave
- Qué significa el error typical_p is no longer supported
- Qué versiones de Ollama dan el error
- Cómo reproduje el error en Docker
- Qué clientes siguen enviando typical_p
- Cómo arreglar el error: cuatro salidas probadas
- Quita typical_p de las opciones
- Vuelve a Ollama 0.34.0
- Usa el endpoint compatible con OpenAI
- Pon un proxy que quite el campo
- Qué cambia con Ollama 0.40.0
- Preguntas frecuentes
- ¿Poner typical_p a 1.0 evita el error?
- ¿Mis modelos con typical_p en el Modelfile dejan de funcionar?
- ¿Afecta a llama.cpp o a LM Studio?
- Conclusión
- Fuentes
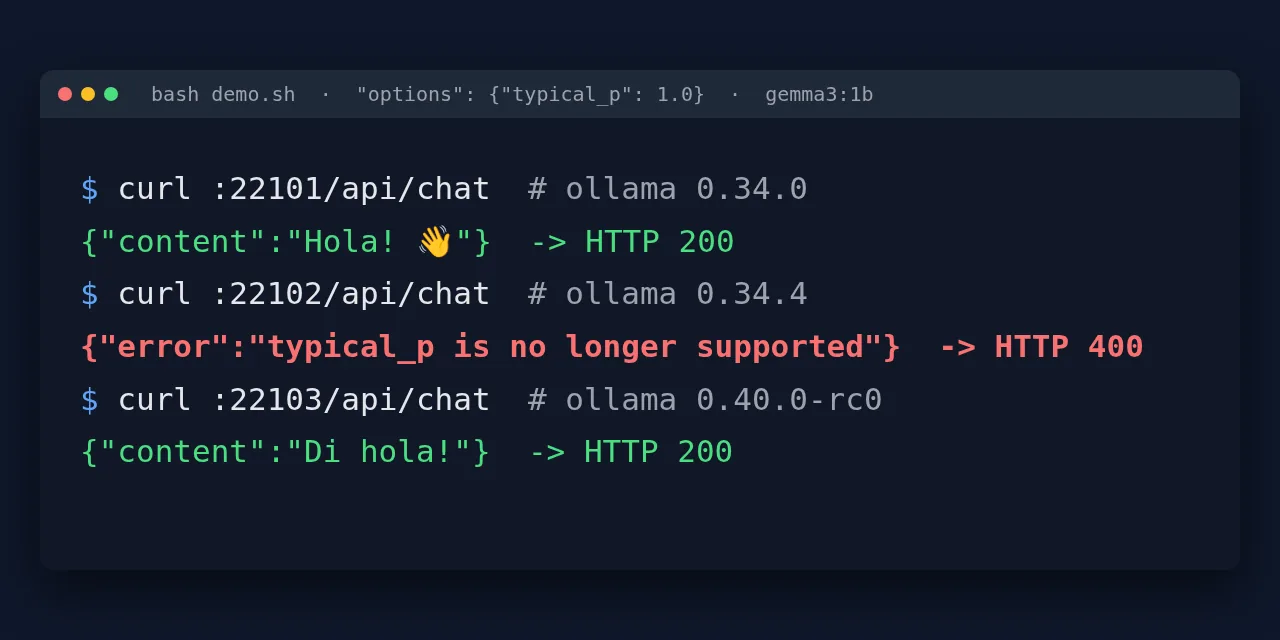
Si Ollama te responde {"error":"typical_p is no longer supported"}, tu cliente está enviando el parámetro typical_p a una versión entre la 0.34.1 y la 0.34.4, que lo rechazan con un HTTP 400 aunque valga 1.0. El modelo no tiene nada roto. Lo reproduje el 27 de septiembre de 2026 con cuatro versiones de Ollama en Docker y probé las cuatro salidas que funcionan: quitar el campo, volver a la 0.34.0, pasar por el endpoint /v1 o subir a la 0.40.0, que solo deja un aviso en el log. Hay una versión en inglés de esta guía.
Puntos clave
- Ollama 0.34.1 (14 de septiembre de 2026) retiró
typical_p, y hasta la 0.34.4 cualquier petición a/api/chato/api/generateque lo incluya enoptionsrecibe un 400. - El valor no importa: 0.7 y 1.0 fallan igual. Solo pasa un
typical_pausente onull. - SillyTavern 1.19.0 y la integración home-llm de Home Assistant lo envían siempre; la biblioteca
ollamade Python, solo si tú lo pones. - El endpoint compatible con OpenAI (
/v1/chat/completions) ignoratypical_p, así que esos clientes no se ven afectados. - La 0.40.0 (preliminar
0.40.0-rc0desde el 25 de septiembre) vuelve a aceptarlo por petición y solo registra un aviso, peroollama createsigue rechazándolo en un Modelfile.
Qué significa el error typical_p is no longer supported
El mensaje sale de Ollama, no del modelo ni del cliente. En el código de la 0.34.4, server/routes.go define el error typical_p is no longer supported y lo devuelve antes de cargar el modelo siempre que options traiga la clave typical_p con un valor distinto de null. El manejador lo traduce a un HTTP 400 con el cuerpo JSON que ves en tu cliente.
typical_p controla el muestreo típico (typical sampling), un filtro de tokens que Ollama aplicaba desde hace años con valor por defecto 1.0, es decir, desactivado. Las notas de la versión 0.34.1 de Ollama[1] lo anuncian en una línea: "Deprecated typical_p: it can no longer be set when creating new models, existing GGUF models retain support".
La nota habla de crear modelos, pero el PR #18448[2], de Daniel Hiltgen, también bloqueó el parámetro en cada petición a la API. Por eso el problema apareció al actualizar, sin tocar nada más.
Qué versiones de Ollama dan el error
Las versiones afectadas son la 0.34.1, 0.34.2, 0.34.3 y 0.34.4, publicadas entre el 14 y el 24 de septiembre de 2026. Comprueba la tuya con ollama -v o con curl localhost:11434/api/version.
| Versión | typical_p en una petición |
PARAMETER typical_p en ollama create |
|---|---|---|
| 0.34.0 y anteriores | Aceptado | Aceptado |
| 0.34.1 a 0.34.4 | HTTP 400 | Error |
| 0.40.0-rc0 | Aceptado, con un aviso en el log | Error |
El 24 de septiembre se fusionó el PR #18627[3], que corrige el bloqueo. Su descripción lo resume: "Switch from rejecting API requests to logging a warning. Model creation still rejects the deprecated param". Ese cambio llegó tarde para la 0.34.4, publicada ese mismo día horas antes, y entró en la 0.40.0-rc0.
El 27 de septiembre, la página de versiones de Ollama[4] mantenía la 0.34.4 como última estable y marcaba la 0.40.0-rc0 como preliminar. Mira esa página antes de decidir: si ya hay una 0.40.0 final, subir es la salida más directa.
Cómo reproduje el error en Docker
Levanté cuatro versiones de Ollama a la vez con Docker Compose en un equipo aarch64 de 18 núcleos sin GPU, todas con el mismo modelo gemma3:1b. Cada una escucha en su puerto: 22101 para la 0.34.0, 22102 para la 0.34.4 y 22103 para la 0.40.0-rc0. La 0.34.1 la probé aparte y da el mismo 400. Este es un servicio del compose.yaml; los otros solo cambian la etiqueta de la imagen y el puerto:
services:
  ollama-0344:
    image: ollama/ollama:0.34.4
    ports: ["127.0.0.1:22102:11434"]
    volumes: ["./models:/root/.ollama/models"]
    environment: [OLLAMA_NOPRUNE=1]
La petición mínima que falla es un chat con typical_p a 1.0, el mismo valor que Ollama usaba por defecto. Contra la 0.34.4 devuelve un 400 antes de generar nada. Si tu Ollama usa el puerto estándar, cambia 22102 por 11434:
curl -s -i localhost:22102/api/chat -d '{"model": "gemma3:1b",
  "messages": [{"role": "user", "content": "hola"}],
  "options": {"typical_p": 1.0}}'
# HTTP/1.1 400 Bad Request
# {"error":"typical_p is no longer supported"}
Repetí la prueba con tres valores en las tres versiones. /api/generate y la respuesta en streaming dan el mismo 400, y un typical_p a null pasa porque el código lo trata como no definido:
options.typical_p |
0.34.0 | 0.34.4 | 0.40.0-rc0 |
|---|---|---|---|
| 0.7 | 200 | 400 | 200 |
| 1.0 | 200 | 400 | 200 |
null |
200 | 200 | 200 |
Qué clientes siguen enviando typical_p
Los clientes que fallan son los que meten typical_p en options aunque no lo hayas tocado. Lo comprobé en su código fuente y en sus incidencias abiertas; no ejecuté SillyTavern ni Home Assistant:
- SillyTavern: la versión 1.19.0 incluye
typical_pen la listaOLLAMA_KEYSdesrc/constants.jsy lo envía con valor 1 por defecto. La incidencia #18542[5] de Ollama cuenta que, tras actualizar, "all SillyTavern message generation requests" dejaron de funcionar - home-llm (integración de LLM locales para Home Assistant): la incidencia #399[6] sitúa el campo en
backends/ollama.py, de la versión 0.4.6 a la 0.4.11 - Tu propio código: la documentación de la API de Ollama[7] traía hasta la 0.34.0 un ejemplo con todas las opciones que ponía
"typical_p": 0.7, y ese bloque se ha copiado en scripts de todo tipo
La biblioteca oficial de Python solo lo manda si lo pasas tú. Con ollama 0.6.2 y options={"typical_p": 1.0}, la 0.34.4 lanza ResponseError: 400 typical_p is no longer supported. Open WebUI no lo envía por defecto: en su código solo llega a Ollama si lo añades como parámetro personalizado.
El SDK de OpenAI no falla porque habla con /v1/chat/completions. La capa compatible de Ollama solo traslada a options siete campos (stop, max_tokens, temperature, seed, frequency_penalty, presence_penalty y top_p), así que typical_p se descarta en silencio. Con openai 3.19.2 y extra_body={"typical_p": 0.7}, la 0.34.4 respondió con un 200.
Cómo arreglar el error: cuatro salidas probadas
La salida correcta depende de si controlas el código del cliente. Quitar el campo es la solución definitiva; las otras tres sirven mientras esperas a que el cliente se actualice. Si instalaste Ollama siguiendo la guía para instalar Ollama en tu equipo, las cuatro se aplican igual.
Quita typical_p de las opciones
Si el código es tuyo, borra la clave de options o ponla a None. Con la biblioteca ollama de Python queda así, y la misma llamada con typical_p es la que devolvió el 400:
import ollama

client = ollama.Client(host="http://localhost:11434")
r = client.chat(model="gemma3:1b",
                messages=[{"role": "user", "content": "Di hola"}],
                options={"num_predict": 8})
print(r.message.content)
En home-llm, la incidencia #399 confirma que borrar la línea "typical_p": typical_p de los dos bloques options.update(...) de backends/ollama.py lo resuelve. En SillyTavern no hay un interruptor para excluirlo, y ese es justo el motivo de la incidencia #18542.
Vuelve a Ollama 0.34.0
Fijar la imagen en la 0.34.0 devuelve el comportamiento anterior: en mi prueba aceptó typical_p con los tres valores. Cambia la etiqueta en tu compose.yaml a ollama/ollama:0.34.0 y recrea el contenedor.
El precio es perder las correcciones de la 0.34.1 a la 0.34.4. Una de ellas es el /api/tags más rápido con bibliotecas grandes: de 3,1 s a 294 ms en frío, según las notas de la 0.34.1. Esa versión también cambió cómo se crea un GGUF a partir de safetensors, que ahora exige las herramientas de llama.cpp. Explico el proceso en la guía para importar un modelo de Hugging Face en Ollama.
Usa el endpoint compatible con OpenAI
Si tu cliente puede hablar con una API compatible con OpenAI, apúntalo a http://localhost:11434/v1. Ollama ignora ahí typical_p, así que la petición pasa en la 0.34.4. SillyTavern tiene un modo de chat compatible con OpenAI, aunque no lo he probado con Ollama.
La contrapartida es que por /v1 solo pasan esos siete campos: pierdes min_p, top_k, repeat_penalty y el resto de opciones nativas. Si tu flujo depende de herramientas, revisa también cómo se comportan en ese endpoint, como cuento en function calling con Ollama.
Pon un proxy que quite el campo
Cuando no puedes cambiar el cliente ni la versión de Ollama, un proxy HTTP pequeño puede borrar typical_p de cada petición antes de reenviarla. Escribí este con la biblioteca estándar de Python 3.14; la primera mitad lee el cuerpo, quita la clave y prepara la petición:
import json, os, urllib.request
from http.server import ThreadingHTTPServer, BaseHTTPRequestHandler

UPSTREAM = os.environ.get("OLLAMA_UPSTREAM", "http://127.0.0.1:11434")
PORT = int(os.environ.get("PROXY_PORT", "11435"))

class Proxy(BaseHTTPRequestHandler):
    def do_POST(self):
        body = self.rfile.read(int(self.headers.get("Content-Length", 0)))
        try:
            data = json.loads(body)
            data.get("options", {}).pop("typical_p", None)
            body = json.dumps(data).encode()
        except (ValueError, AttributeError):
            pass
        req = urllib.request.Request(UPSTREAM + self.path, data=body or None,
            headers={"Content-Type": "application/json"},
            method=self.command)
La segunda mitad envía la petición a Ollama y devuelve la respuesta por trozos, de modo que el streaming sigue funcionando. do_GET reutiliza el mismo método para /api/tags y /api/version:
        try:
            resp = urllib.request.urlopen(req)
        except urllib.error.HTTPError as e:
            resp = e
        self.send_response(resp.status)
        self.send_header("Content-Type", resp.headers["Content-Type"])
        self.end_headers()
        while chunk := resp.read1(8192):
            self.wfile.write(chunk)
            self.wfile.flush()

    do_GET = do_POST

ThreadingHTTPServer(("127.0.0.1", PORT), Proxy).serve_forever()
Arráncalo apuntando a tu Ollama y configura el cliente contra el puerto del proxy. En mi prueba, delante de la 0.34.4, la misma petición con typical_p a 1.0 pasó de 400 a 200:
OLLAMA_UPSTREAM=http://127.0.0.1:22102 PROXY_PORT=22111 \
  python3 strip_typical_p.py
# 127.0.0.1 - - [27/Sep/2026 11:44:43] "POST /api/chat HTTP/1.1" 200 -
Es un apaño: no tiene TLS ni autenticación y lee el cuerpo entero en memoria. Escúchalo solo en 127.0.0.1 y retíralo cuando actualices.
Qué cambia con Ollama 0.40.0
La 0.40.0-rc0 acepta typical_p en cada petición y deja una línea de aviso en el log, que en mi contenedor fue esta: level=WARN source=routes.go:185 msg="deprecated option provided" option=typical_p. SillyTavern, home-llm y tu script vuelven a funcionar sin cambios.
Crear modelos sigue igual de cerrado. Un Modelfile con PARAMETER typical_p 0.9 falla en la 0.40.0-rc0 con un mensaje nuevo, "typical_p is deprecated and cannot be set as a model parameter; pass it as a request option instead". Los modelos que ya lo tenían funcionan: uno creado en la 0.34.0 con ese parámetro respondió con normalidad en la 0.34.4.
La documentación actual de la API avisa además de que "typical_p is deprecated and may be removed in a future release". Aunque la 0.40.0 te saque del apuro, quita el campo cuando puedas. La referencia del Modelfile[8] ya solo lista once parámetros: num_ctx, repeat_last_n, repeat_penalty, temperature, seed, stop, num_predict, draft_num_predict, top_k, top_p y min_p.
Preguntas frecuentes
¿Poner typical_p a 1.0 evita el error?
No. En la 0.34.1 a la 0.34.4 el error salta con cualquier valor, porque Ollama solo comprueba si la clave existe. Lo único que pasa es no enviarla o enviarla como null.
¿Mis modelos con typical_p en el Modelfile dejan de funcionar?
No. Un modelo creado antes de la 0.34.1 conserva el parámetro y sigue respondiendo. Lo que falla es crear uno nuevo con PARAMETER typical_p, también en la 0.40.0-rc0.
¿Afecta a llama.cpp o a LM Studio?
No. El error es una comprobación del servidor de Ollama en su API nativa. Si usas llama.cpp directamente, llama-server expone sus propias opciones de muestreo, como explico en cómo instalar llama.cpp.
Conclusión
El error typical_p is no longer supported es un 400 de Ollama 0.34.1 a 0.34.4 ante una clave que tu cliente envía aunque no la uses. Si el código es tuyo, borra typical_p de options. Si usas SillyTavern o home-llm, sube a la 0.40.0 cuando salga la versión final, o mientras tanto vuelve a la 0.34.0 o pon el proxy. Antes de elegir, mira la página de versiones: el 27 de septiembre de 2026 la última estable seguía siendo la 0.34.4.
Fuentes
Código fuente
Accede a todo el código fuente de este artículo en GitHub.
Ver en GitHub