Qué modelos abiertos de septiembre de 2026 merece la pena ejecutar en tu equipo
Índice de contenidos
- Puntos clave
- Qué cubre este repaso y cómo lo he probado
- Qué se publicó con pesos descargables
- Los grandes laboratorios pasaron septiembre en silencio
- Cómo respondieron los modelos a cinco tareas reales
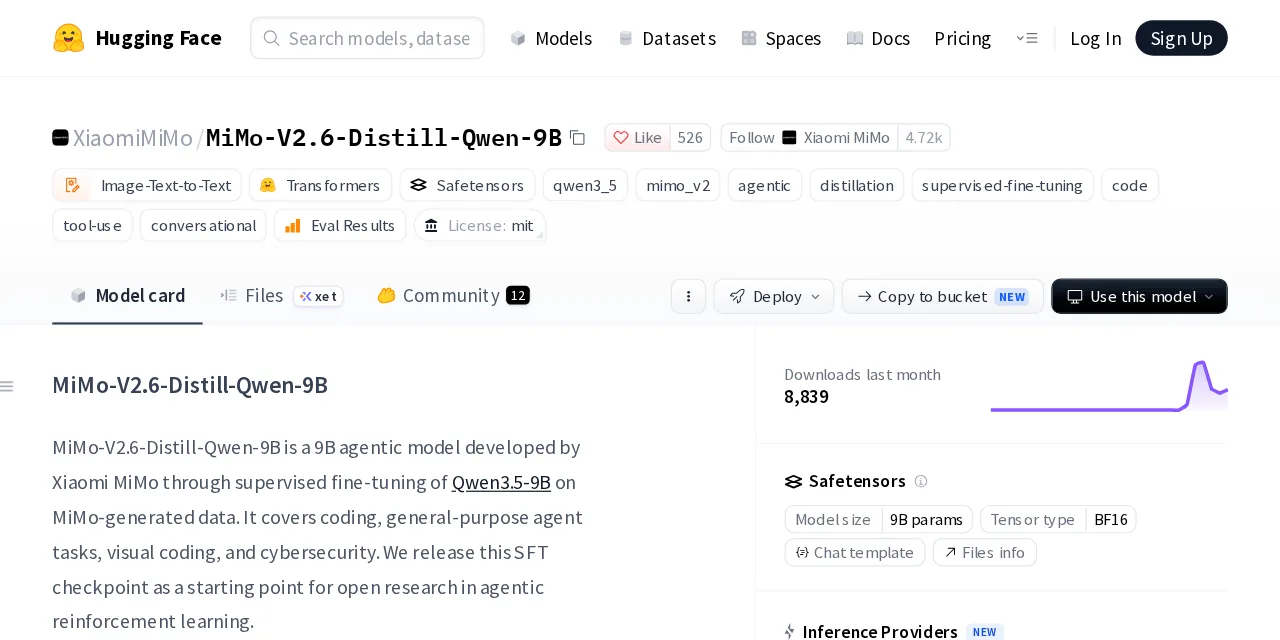
- MiMo-V2.6-Distill-Qwen-9B, el lanzamiento que vale la pena
- MiniCPM5-2B como referencia pequeña
- DFM Mimir v1.5, fuera de su idioma
- Qué velocidad dan en una CPU arm64 sin GPU
- Los modelos que no son lo que parecen
- Qué permite de verdad cada licencia
- Cómo ejecutarlos en tu equipo con llama.cpp
- Qué elegir según la memoria que tengas
- Preguntas frecuentes
- ¿Por qué no aparecen Qwen, Gemma o Llama en el repaso de septiembre?
- ¿Es fiable MiMo-V2.6-Distill para un agente que toca mi servidor?
- ¿Temperatura 0 garantiza respuestas repetibles en llama.cpp?
- Conclusión
- Fuentes
Septiembre de 2026 ha sido un mes flojo para quien ejecuta modelos en su propio equipo, y eso ya es información. Ni Qwen, ni Mistral, ni Google, ni Meta publicaron un modelo de texto nuevo en sus organizaciones de Hugging Face. Lo que sí llegó en tamaño doméstico lo he descargado y ejecutado en una máquina arm64 sin GPU con llama.cpp v0.5.0, sobre cinco tareas fijas en español. Este repaso dice qué salió, con qué licencia y qué hizo cada modelo cuando le pedí trabajo real.
Puntos clave
- MiMo-V2.6-Distill-Qwen-9B, de Xiaomi, es el lanzamiento del mes que merece sitio en tu disco: 9.410 millones de parámetros, visión y licencia MIT declarada en la ficha.
- En mis pruebas, MiMo encadenó bien las dos llamadas a herramientas, devolvió JSON limpio y leyó una captura de
docker ps, pero inventó la opción--auto-healen los cinco intentos con el muestreo por defecto. - MiniCPM5-2B, del 6 de septiembre, pesa 1,56 GB en Q4_K_M, encadenó las mismas herramientas que MiMo y desmintió la opción inventada en cuatro de cinco intentos.
- DFM Mimir v1.5 es un modelo danés de 1.787 millones de parámetros: en español responde con frases vacías e inventa órdenes de Docker.
- Los modelos grandes del mes (DeepSeek-V4.1-Flash, MiMo-V2.6-Pro-RL, Intern-S2) tienen pesos abiertos, pero entre 403.000 millones y más de un billón de parámetros.
Qué cubre este repaso y cómo lo he probado
Cubre lo publicado entre el 1 y el 28 de septiembre de 2026, y los datos se comprobaron el 28 de septiembre. Para cada modelo leí su ficha en Hugging Face, la API pública del repositorio (fecha de creación, licencia, número de parámetros) y el fichero LICENSE cuando existe. Es el mismo método del repaso de los modelos abiertos de agosto de 2026, con una diferencia: esta vez los modelos pequeños los he ejecutado.
La prueba es deliberadamente modesta. Una máquina aarch64 con 18 núcleos y sin GPU, compartida con otros trabajos, el servidor de llama.cpp en su imagen oficial server-v0.5.0 y cuantizaciones Q4_K_M. Cinco tareas iguales para todos, con temperatura 0:
- Explicar en cinco frases qué es un proxy inverso y cuándo elegir Traefik frente a Nginx
- Reiniciar un contenedor y consultar la memoria libre usando dos herramientas declaradas
- Extraer un JSON con tres claves de un registro de
dockercon un código 137 - Escribir una función de Python
to_bytes()que corrijo con siete casos - Responder para qué sirve
docker run --auto-heal, una opción que no existe
Cinco preguntas no son un banco de pruebas. Sirven para ver cómo se comporta un modelo cuando le das trabajo de verdad, que es lo que las tablas de las fichas no enseñan. La velocidad y la memoria las medí aparte, con la máquina en reposo, y están en su propia sección más abajo.
Qué se publicó con pesos descargables
Estos son los modelos de septiembre que se pueden descargar hoy. La columna de tamaño es el fichero GGUF en Q4_K_M cuando existe:
| Modelo | Fecha | Parámetros | Licencia | ¿Para un equipo propio? |
|---|---|---|---|---|
| MiMo-V2.6-Distill-Qwen-9B | 21 sep | 9.410 M | MIT (solo en la ficha) | Sí, 5,84 GB en Q4_K_M |
| MiniCPM5-2B | 6 sep | 2.517 M | Apache 2.0 | Sí, 1,56 GB en Q4_K_M |
| DFM Mimir v1.5 | 23 sep | 1.787 M | Apache 2.0 | Sí, 1,17 GB, solo danés e inglés |
| Nex-N2.5-mini | 8 sep | 35.107 M, MoE | Apache 2.0 (solo en la ficha) | Justo, 22,32 GB en Q4_K_M |
| VibeVoice-ASR-Streaming-1.5B | 2 sep | 2.814 M | MIT | Sí, es transcripción de voz |
| Intern-Decision 0.8B / 2B / 4B | 26 sep | 853 / 2.213 / 4.539 M | Apache 2.0 | Sí, pero no conversa |
| DeepSeek-V4.1-Flash | 10 sep | 763.205 M | MIT | No |
| MiMo-V2.6-Pro-RL | 21 sep | 1,02 billones | MIT | No |
| Intern-S2-397B | 13 sep | 403.423 M | Apache 2.0 | No |
Las cuatro primeras filas son las que interesan a quien tiene un portátil o un servidor casero delante. El resto son pesos abiertos con licencias limpias que piden un servidor con GPU de centro de datos.
Los grandes laboratorios pasaron septiembre en silencio
El dato más llamativo del mes es una ausencia. Consulté sus organizaciones de Hugging Face ordenadas por fecha, y esto es lo que hay:
- Qwen: solo modelos de imagen, la familia Qwen-Image-2.1
- Mistral: nada nuevo desde el 16 de julio
- Google: solo GNM v3, un modelo paramétrico 3D de cabezas humanas, el 1 de septiembre
- IBM: solo conversiones MLX de Granite 4.2
- Meta: sigue sin repositorio de Muse Spark 1.2, que anunció como abierto en agosto
Hay una corrección que debo al repaso anterior: DeepSeek-V4-Flash-Vision-Exp aparecía en agosto como un modelo solo de API, porque a 30 de agosto no tenía repositorio. Sus pesos se publicaron el 31 de agosto, con licencia MIT y 304.647 millones de parámetros, y ggml-org subió los GGUF el 2 de septiembre. La regla sigue valiendo (sin repositorio en la organización oficial no hay pesos), solo que un repositorio puede aparecer al día siguiente.
Cómo respondieron los modelos a cinco tareas reales
MiMo y MiniCPM5 empataron con las herramientas, MiMo fue el único que devolvió el JSON bien tipado y ninguno de los tres es fiable escribiendo código ni ante una pregunta trampa. Esta es la primera pasada, con temperatura 0:
| Tarea | MiMo-V2.6-Distill 9B | MiniCPM5-2B | DFM Mimir v1.5 |
|---|---|---|---|
| Explicación en español | Correcta, cinco frases | Correcta pero pobre | Repetitiva y vacía |
| Llamadas a herramientas | Encadena las dos | Encadena las dos | Ninguna, responde en prosa |
| JSON del registro | Perfecto | Código 137 como texto | Clave mal escrita |
Función to_bytes() |
0 de 7 casos | 7 de 7 casos | No ejecuta |
Trampa --auto-heal |
La desmiente | La inventa | La inventa |
Esa primera pasada engaña, porque a temperatura 0 no hay una sola respuesta. llama.cpp agrupa las peticiones que llegan a la vez, y eso cambia los redondeos: repetí la tarea de código con MiMo y la segunda versión pasó 6 de 7 casos. Por eso repetí la trampa cinco veces y la función y el JSON tres veces, con el muestreo que trae cada GGUF, que es el que usarás tú:
| Repetición con muestreo por defecto | MiMo-V2.6-Distill 9B | MiniCPM5-2B | DFM Mimir v1.5 |
|---|---|---|---|
Trampa --auto-heal, 5 intentos |
La inventa en 5 | La desmiente en 4 | La inventa en 5 |
Función to_bytes(), 3 intentos |
1, 0 y 1 de 7 | 0 de 7, no ejecuta, 6 de 7 | No ejecuta en ninguno |
| JSON del registro, 3 intentos | 3 correctos | Código como texto en 3 | Clave mal escrita en 2 |
La trampa es la que cambia de lado. MiMo la desmintió a temperatura 0 y la inventó las cinco veces con el muestreo por defecto, mientras que MiniCPM5 hizo justo lo contrario.
MiMo-V2.6-Distill-Qwen-9B, el lanzamiento que vale la pena
Xiaomi lo presenta como un ajuste fino de Qwen3.5-9B con datos generados por sus modelos grandes, y lo dice sin adornos: "We release this SFT checkpoint as a starting point for open research in agentic reinforcement learning". Es un punto de partida para investigar, no un producto pulido, y se nota en los dos sentidos. Según su ficha, pasa de 32,0 a 44,6 en SWE Pro y de 25,9 a 35,2 en Toolathlon-Verified respecto al Qwen3.5-9B original.
En mis tareas, lo agéntico funcionó. Pidió restart_container con el argumento jellyfin y, cuando le devolví el resultado, llamó a host_memory sin que se lo recordara. El JSON salió con el código como entero y la causa en una frase en español. También leyó una captura de docker ps: detectó el contenedor en bucle de reinicios y el que tenía el control de salud fallando, aunque interpretó el (137) como "137 reinicios" cuando es el código de salida.
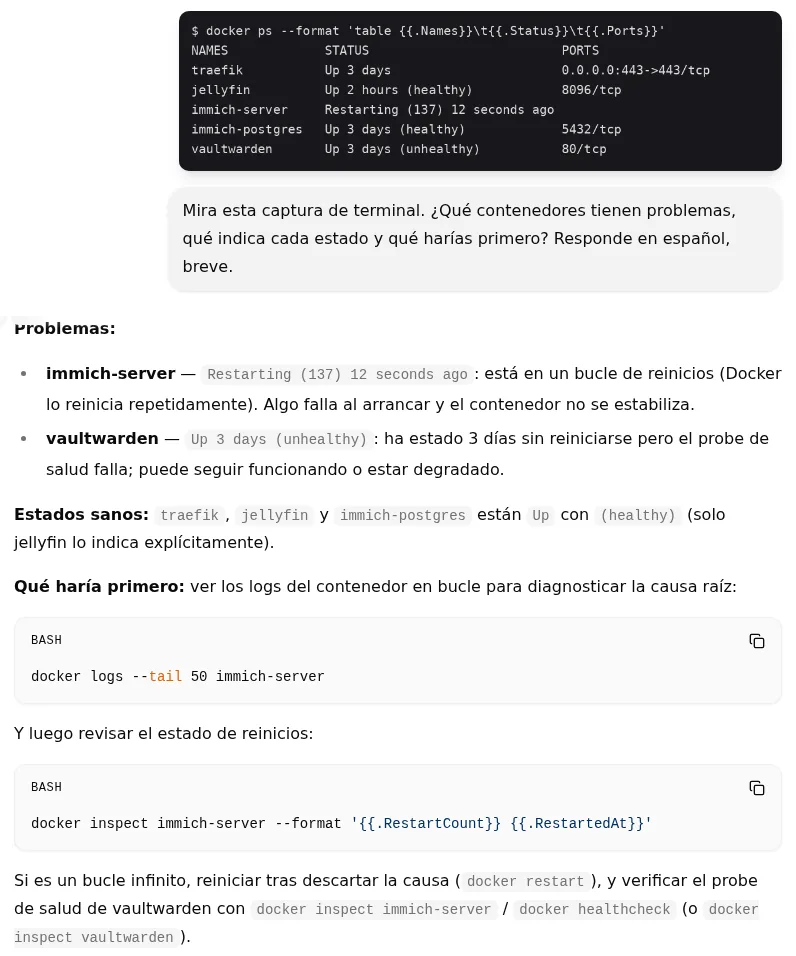
La captura es de la interfaz web de llama.cpp, recortada para quitar las cifras de velocidad. En esa versión de la respuesta ya no confunde el código de salida, pero termina recomendando docker healthcheck, que no es una orden de Docker.
Lo que falla es la frontera de su conocimiento. En la primera pasada desmintió --auto-heal y recomendó --restart unless-stopped, pero en la misma respuesta propuso --healthcheck-interval y --auto-rm, que tampoco existen (las reales son --health-interval y --rm). Con el muestreo por defecto la inventó en los cinco intentos. Tres veces la trasladó a docker service create, que tampoco la tiene, y dos la describió como un alias de --restart=always.
MiniCPM5-2B como referencia pequeña
MiniCPM5-2B es de este mes y ya lo medí a fondo en el artículo sobre LLM sin GPU en arm64, así que aquí hace de vara de medir. Con 2.517 millones de parámetros, su primera función to_bytes() pasó los siete casos, incluidos 2.5 GiB con punto y 0,5 MB con coma, aunque en las tres repeticiones solo una se acercó (6 de 7). En herramientas hizo lo mismo que MiMo: primero el reinicio y, con el resultado delante, la memoria.
Donde se queda corto es en todo lo que pide criterio. La explicación en español fue correcta pero hueca ("Traefik ofrece una experiencia más fluida"). El JSON devolvió el código como cadena y la causa con el mensaje del kernel copiado entero.
Y a temperatura 0 la trampa la respondió con seguridad: --auto-heal reinicia el contenedor si falla el control de salud y se activa con true. Su propio razonamiento decía "I’m not 100% sure" justo antes de afirmarlo. Con el muestreo por defecto la desmintió en cuatro de cinco intentos, y en uno de ellos propuso a cambio un --update que docker run no tiene (la opción real es --pull).
DFM Mimir v1.5, fuera de su idioma
Mimir es un proyecto serio de la Danish Foundation Models, entrenado desde cero en danés e inglés. Su arquitectura recurrente (HRM-Text) reutiliza sus 16 capas en ocho pasadas (seis del módulo L y dos del H) por cada razonamiento completo. llama.cpp la soporta desde la v0.5.0, publicada el 23 de septiembre. Lo probé en español porque es lo que te interesa, y también en inglés y en danés para ser justo.
En español no sirve: repitió tres veces la misma idea sobre Traefik y Nginx, escribió codice_salida en lugar de codigo_salida y su función de Python ni siquiera ejecuta. En inglés y danés las respuestas fueron más limpias, pero igual de genéricas, y en inglés también explicó --auto-heal como si existiera. Para tareas con herramientas tampoco: razonó en voz alta, inventó una orden docker memory y no emitió ninguna llamada. Cuando le di el resultado del reinicio ya hecho, respondió que no tenía acceso a la memoria del host en lugar de llamar a host_memory.
Qué velocidad dan en una CPU arm64 sin GPU
MiniCPM5-2B generó 56,85 tokens/s de mediana y MiMo-V2.6-Distill, 18,03: el modelo que acierta más cuesta tres veces más por token. Medí los cuatro modelos el 28 de septiembre de 2026, uno detrás de otro y con la máquina sola, con el servidor de llama.cpp v0.5.0 en Q4_K_M y 6 hilos. Cada cifra es la mediana de 5 peticiones tras una de calentamiento, con un prompt de 761 a 841 tokens según el tokenizador, 256 tokens generados y una petición a la vez:
La carga media de un minuto estaba por debajo de 3 (entre 2,45 y 2,96) al empezar cada modelo; durante la medida subía hasta 9,8 por el propio llama.cpp. La memoria es la lectura de docker stats al terminar, con el contexto por defecto de 8.192 tokens (4.096 en Mimir) y MiMo sin el proyector de visión. Usé 6 hilos porque en esta máquina rinden más que 16, como ya medí en el artículo de LLM sin GPU en arm64. Allí MiniCPM5 dio 83,19 tokens/s con otra versión de llama.cpp y otro prompt, así que compara cifras solo dentro de una misma tabla.
Dos resultados llaman la atención. Nex-N2.5-mini, con 35.107 millones de parámetros, genera más deprisa que MiMo porque solo activa 8 de sus 256 expertos por token. Mimir, con menos de la mitad de parámetros que MiniCPM5, va más de cuatro veces más lento, porque su arquitectura recurrente pasa ocho veces por sus 16 capas en cada razonamiento completo.
Los modelos que no son lo que parecen
Cinco lanzamientos de septiembre aparecen en las listas de "modelos nuevos" y no son un asistente que puedas usar en un chat:
- Intern-Decision (InternLM): puntúa opciones de un esquema en una sola pasada. Su ficha lo dice: "It does not call generate() or sample free-form text"
- LFM2.5-VL-3B-DSpark (Liquid AI): un borrador de 279,5 millones de parámetros para la decodificación especulativa de LFM2.5-VL-3B, no un modelo que se use solo
- EVIE-4.5B y WeVisDoc (Tencent): recuperación de documentos visuales, para búsquedas sobre PDF escaneados
- LensVLM-9B (Apple): comparte base y tamaño con MiMo, pero su licencia lo limita a investigación
- VibeVoice-ASR-Streaming (Microsoft): transcripción de voz con identificación de hablante en 10 idiomas, español incluido, en 1.500 y 7.000 millones de parámetros
Nex-N2.5-mini merece una mención aparte. Es un modelo de mezcla de expertos (MoE) con la arquitectura de Qwen3.5-35B-A3B, 256 expertos y 8 activos por token, que su fabricante despliega en dos H100.
En GGUF baja a 22,32 GB en Q4_K_M, así que cabe en un equipo con 32 GB de memoria, y en mi máquina generó 25,15 tokens/s. Solo le pasé tres de las cinco tareas: encadenó bien las dos herramientas y devolvió el JSON correcto, pero ante la opción inventada agotó los 3.000 tokens razonando sin llegar a responder.
Qué permite de verdad cada licencia
La licencia que muestra la web de Hugging Face no siempre tiene un fichero detrás, y eso importa si vas a meter el modelo en un producto. Esto es lo que encontré al abrir cada repositorio:
- MIT sin fichero: MiMo-V2.6-Distill-Qwen-9B declara
license: miten los metadatos de la ficha, pero el repositorio no tiene fichero LICENSE. Nex-N2.5-mini hace lo mismo con Apache 2.0. Es una declaración válida del autor, aunque para un uso comercial conviene guardar una copia de la ficha tal como estaba - Apache 2.0 con fichero: DFM Mimir e Intern-Decision incluyen el texto completo
- MIT con fichero: DeepSeek-V4.1-Flash
- Apple Machine Learning Research Model License: LensVLM-9B solo se puede usar "exclusively for Research Purposes", y la licencia excluye "any commercial exploitation, product development or use in any commercial product or service"
- Qwen Research License: Qwen-Image-2.1 es solo para uso no comercial
- CC BY-NC 4.0 y acceso restringido: tiny-aya-l2-thinker, de Cohere Labs, exige aceptar condiciones para descargarlo y prohíbe el uso comercial
Cómo ejecutarlos en tu equipo con llama.cpp
Ninguno de los modelos pequeños del mes está en la biblioteca oficial de Ollama: sus páginas devolvían 404 el 28 de septiembre. La vía directa es llama.cpp con un GGUF de Hugging Face. Estas son las órdenes que usé para MiMo, con su proyector de visión:
mkdir -p modelos && cd modelos
repo=https://huggingface.co/bartowski/MiMo-V2.6-Distill-Qwen-9B-GGUF
curl -LO "$repo/resolve/main/MiMo-V2.6-Distill-Qwen-9B-Q4_K_M.gguf"
curl -LO "$repo/resolve/main/mmproj-MiMo-V2.6-Distill-Qwen-9B-f16.gguf"
La primera descarga son los pesos cuantizados y la segunda, el codificador de imagen. El GGUF de ggml-org solo existe en Q8_0 (9,53 GB), por eso usé la cuantización Q4_K_M de bartowski. Después arranca el servidor en Docker:
docker run -d --name llama -p 127.0.0.1:8080:8080 \
  -v "$PWD":/models:ro \
  ghcr.io/ggml-org/llama.cpp:server-v0.5.0 \
  -m /models/MiMo-V2.6-Distill-Qwen-9B-Q4_K_M.gguf \
  --mmproj /models/mmproj-MiMo-V2.6-Distill-Qwen-9B-f16.gguf \
  --host 0.0.0.0 --port 8080 --jinja -c 8192
Ejecútalo desde el mismo directorio modelos.
La opción --jinja activa la plantilla de chat del modelo, sin la cual las llamadas a herramientas no llegan como tool_calls. En http://127.0.0.1:8080 tienes la interfaz web y en /v1/chat/completions, la API compatible con OpenAI. En mi máquina el 8080 estaba ocupado y publiqué el 24101; el resto de la orden es idéntica. Si prefieres Ollama, la guía para importar un modelo de Hugging Face en Ollama cubre el mismo GGUF.
Qué elegir según la memoria que tengas
La cifra que manda es el tamaño del fichero cuantizado, más la caché de contexto que añadas encima. Con eso en la cabeza:
Menos de 8 GB de RAM. MiniCPM5-2B en Q4_K_M ocupa 1,56 GB y generó 56,85 tokens/s en mi CPU con 6 hilos. No le pidas criterio ni datos que no puede saber, y revisa siempre el código que escriba, pero para herramientas simples cumple. Si vas a usarlo en un agente, antes de decidir mira qué modelos abiertos manejan bien las llamadas a herramientas.
Entre 8 y 16 GB. MiMo-V2.6-Distill-Qwen-9B en Q4_K_M son 5,84 GB de pesos y 0,92 GB más si cargas la visión. Genera 18,03 tokens/s en CPU, suficiente para un agente que no tiene prisa. Es mi recomendación del mes para tareas agénticas y lectura de capturas, siempre con una comprobación externa de lo que afirma sobre opciones y versiones.
32 GB o más. Nex-N2.5-mini en Q4_K_M, 22,32 GB, es el candidato a probar: al ser MoE generó 25,15 tokens/s, más que MiMo. Si vienes de los modelos densos, repasa antes cómo afecta la cuantización a la calidad en llama.cpp, porque en un MoE bajar a Q3 o IQ2 cambia más cosas que el tamaño.
Preguntas frecuentes
¿Por qué no aparecen Qwen, Gemma o Llama en el repaso de septiembre?
Porque no publicaron modelos de texto nuevos ese mes. Lo comprobé listando sus organizaciones en Hugging Face por fecha de creación el 28 de septiembre de 2026. Qwen solo subió modelos de imagen, Google nada de texto y Meta no ha publicado todavía los pesos de Muse Spark 1.2.
¿Es fiable MiMo-V2.6-Distill para un agente que toca mi servidor?
Para elegir herramientas y rellenar sus argumentos, sí en mis pruebas. Para afirmar qué opciones tiene un programa, no: inventó --auto-heal en los cinco intentos con el muestreo por defecto y mezcló opciones reales e inventadas en la misma respuesta. Valida cualquier orden que proponga antes de ejecutarla, o dale una herramienta que consulte la documentación.
¿Temperatura 0 garantiza respuestas repetibles en llama.cpp?
No del todo. Con dos o más peticiones simultáneas, llama.cpp las procesa en lote y los redondeos cambian, así que la misma pregunta puede dar otra respuesta. A mí me pasó con la función de Python de MiMo: la primera versión falló los siete casos y la segunda pasó seis.
Conclusión
Septiembre de 2026 deja un solo lanzamiento que cambia algo para un equipo doméstico: MiMo-V2.6-Distill-Qwen-9B. Es un 9B con visión y licencia MIT que en mis pruebas eligió bien las herramientas y devolvió JSON limpio. También deja una lección que ninguna tabla de la ficha enseña: el mismo modelo que desmiente una opción inexistente con temperatura 0 la inventa con el muestreo por defecto.
Descárgalo, úsalo para lo agéntico y no le creas una opción de línea de órdenes sin comprobarla. La versión en inglés de este artículo está en Which open models of September 2026 are worth running.
Fuentes: [1] Xiaomi MiMo, ficha de MiMo-V2.6-Distill-Qwen-9B[1], [2] bartowski, GGUF de MiMo-V2.6-Distill-Qwen-9B[2], [3] OpenBMB, ficha de MiniCPM5-2B[3], [4] Danish Foundation Models, ficha de DFM Mimir v1.5[4], [5] notas de la versión v0.5.0 de llama.cpp[5], [6] Nex-AGI, ficha de Nex-N2.5-mini[6], [7] DeepSeek, ficha de DeepSeek-V4.1-Flash[7], [8] DeepSeek, ficha de DeepSeek-V4-Flash-Vision-Exp[8], [9] InternLM, ficha de Intern-Decision-4B[9], [10] Apple, licencia de LensVLM-9B[10], [11] Microsoft, ficha de VibeVoice-ASR-Streaming-1.5B[11], [12] referencia de docker run en la documentación de Docker[12].
Fuentes
- Xiaomi MiMo, ficha de MiMo-V2.6-Distill-Qwen-9B
- bartowski, GGUF de MiMo-V2.6-Distill-Qwen-9B
- OpenBMB, ficha de MiniCPM5-2B
- Danish Foundation Models, ficha de DFM Mimir v1.5
- notas de la versión v0.5.0 de llama.cpp
- Nex-AGI, ficha de Nex-N2.5-mini
- DeepSeek, ficha de DeepSeek-V4.1-Flash
- DeepSeek, ficha de DeepSeek-V4-Flash-Vision-Exp
- InternLM, ficha de Intern-Decision-4B
- Apple, licencia de LensVLM-9B
- Microsoft, ficha de VibeVoice-ASR-Streaming-1.5B
- referencia de docker run en la documentación de Docker