Reranking local en tu RAG con llama.cpp y pgvector, medido
Índice de contenidos
- Puntos clave
- Qué hace un reranker y por qué va después de pgvector
- Qué monté: pgvector 0.8.6 y tres servidores llama-server
- El flag --reranking ya activa el pooling rank
- Cómo construí un conjunto de evaluación honesto
- La consulta en pgvector y la dificultad de ef_search
- Cómo llamar a /v1/rerank desde tu código
- Cuánto mejora la calidad con reranking
- Cuántos candidatos pasar al reranker
- ¿Compensa más que una búsqueda híbrida con BM25?
- Qué cuesta en CPU reordenar 50 pasajes
- Seguridad: top_n negativo y un puerto que no debes publicar
- Qwen3-Reranker no cupo en 4 GiB
- Límites de esta medición
- Preguntas frecuentes
- ¿Necesito una GPU para usar un reranker local?
- ¿Qué reranker elijo para documentos en español?
- ¿Puedo usar el mismo llama-server para embeddings y reranking?
- Conclusión
- Fuentes
Añadir reranking a un RAG con pgvector subió el nDCG@10 de 0,805 a 0,850 en 300 preguntas reales en español, con bge-reranker-v2-m3 servido por llama.cpp en CPU. El reranker es un segundo modelo que relee los pasajes que devuelve la búsqueda vectorial y los reordena. Lo monté entero en Docker, con pgvector 0.8.6, llama-server b11206 y el conjunto de evaluación MIRACL, y aquí tienes cómo, cuánto mejora, cuántos candidatos pasarle y con qué dificultades me he topado por el camino. También está la versión en inglés de esta prueba.
Puntos clave
- Reordenar los 20 primeros candidatos de pgvector con bge-reranker-v2-m3 subió el nDCG@10 de 0,805 a 0,850 y el MRR@10 de 0,845 a 0,879, en 300 preguntas de MIRACL en español.
- Pasar 20 candidatos al reranker bastó: con 50 el nDCG@10 fue 0,847 y el reranker procesó 2,7 veces más tokens. En CPU con 4 hilos, reordenar 20 pasajes costó 3,04 s de mediana con BGE y 9,77 s con Qwen3, frente a 12,6 ms del embedding y 14,8 ms de pgvector.
- Qwen3-Reranker-0.6B empató con BGE (0,853 frente a 0,847 en 162 preguntas; la diferencia no se distingue de cero).
- Sobre la búsqueda de texto completo de PostgreSQL, el reranker llevó el nDCG@10 de 0,306 a 0,709, pero no alcanzó a BGE-M3 sin reranker.
- Con el
ef_searchpor defecto de pgvector, unLIMIT 50por HNSW devuelve 40 filas; súbelo por encima del número de candidatos. - llama-server no valida
top_n: un valor negativo devuelve un HTTP 500 (CVE-2026-52132), así que no publiques su puerto.
Qué hace un reranker y por qué va después de pgvector
Un reranker es un modelo que recibe la pregunta y un pasaje a la vez y devuelve una puntuación de relevancia para ese par. La búsqueda vectorial hace otra cosa: convierte pregunta y pasajes en vectores por separado y compara distancias, así que nunca lee los dos textos juntos. La ficha de bge-reranker-v2-m3[1] lo explica así: "Different from embedding model, reranker uses question and document as input and directly output similarity instead of embedding".
Esa lectura conjunta cuesta una pasada del modelo por cada pasaje candidato, y por eso el reranker no sustituye a pgvector. El flujo tiene tres pasos:
- pgvector devuelve los N pasajes más cercanos al embedding de la pregunta, con N entre 10 y 50
- el reranker puntúa esos N pares pregunta y pasaje, y reordena
- los primeros k, entre 3 y 10, van al prompt del modelo que genera la respuesta
La teoría y la comparación con servicios como Cohere están en el artículo sobre re-ranking en RAG. Aquí lo he montado en mi propia máquina y he medido cuánto sube la calidad con preguntas reales en español.
Qué monté: pgvector 0.8.6 y tres servidores llama-server
El laboratorio corre en Docker sobre una VM Linux arm64 de 18 núcleos sin GPU, compartida con otros trabajos. Cada contenedor tiene 4 CPU y llama-server usa 4 hilos (-t 4). Estas son las piezas, en sus versiones del 28 de septiembre de 2026:
| Pieza | Versión | Licencia |
|---|---|---|
| PostgreSQL con pgvector | pgvector/pgvector:0.8.6-pg18-trixie (PostgreSQL 18.6) |
PostgreSQL |
| llama-server | ghcr.io/ggml-org/llama.cpp:server-b11206 |
MIT |
| Embeddings | BGE-M3, GGUF Q8_0 de gpustack (1024 dimensiones) | MIT |
| Reranker 1 | bge-reranker-v2-m3, GGUF Q8_0 de gpustack | Apache-2.0 |
| Reranker 2 | Qwen3-Reranker-0.6B, GGUF Q8_0 de ggml-org | Apache-2.0 |
pgvector 0.8.6 salió el 29 de julio de 2026, según su registro de cambios[2]. La imagen de llama.cpp informa de sí misma con --version: version: 0.5.0-dev (build 11206, commit 2b129ccfa), compilada para aarch64. Si aún no tienes llama.cpp en marcha, la guía de instalación de llama.cpp cubre Docker, Linux y macOS.
Este es el servicio del reranker en el compose.yaml. El de embeddings es igual, con el modelo BGE-M3 y --embedding --pooling cls en lugar de --reranking:
  rerank:
    image: ghcr.io/ggml-org/llama.cpp:server-b11206
    command: >
      -m /models/bge-reranker-v2-m3-Q8_0.gguf --reranking
      -c 16384 -b 2048 -ub 2048 -np 8 -t 4
      --no-cache-prompt --cache-ram 0
      --host 0.0.0.0 --port 8080
    volumes:
      - ./models:/models:ro
    ports: ["127.0.0.1:24902:8080"]
    cpus: 4
    mem_limit: 4g
-c 16384 con -np 8 deja 2048 tokens por slot, porque llama-server reparte el contexto entre los slots. En la primera prueba, con -c 8192, cada slot tenía 1024, y un texto de 3004 tokens devolvió un 400: input (3004 tokens) is larger than the max context size (1024 tokens). skipping. Los dos flags de la línea siguiente apagan la caché de prompts, que en un reranker apenas se reutiliza y, como cuento más abajo, dispara la memoria. El puerto se publica solo en 127.0.0.1, por el motivo que explico en la sección de seguridad.
El flag –reranking ya activa el pooling rank
La documentación de llama-server[3] dice que el endpoint de reranking "Requires a reranker model (such as bge-reranker-v2-m3) and the --embedding --pooling rank options". En la build b11206 no hacen falta: el manejador de --reranking en common/arg.cpp[4] fija embedding = true y pooling_type = LLAMA_POOLING_TYPE_RANK. El registro del contenedor lo confirma al arrancar solo con --reranking: model default pooling_type is [-1], but [4] was specified.
Cómo construí un conjunto de evaluación honesto
Medir un reranker exige preguntas con respuestas marcadas por personas, y no las inventé yo. Usé MIRACL[5], un conjunto de recuperación sobre Wikipedia en 18 idiomas con más de 726 000 juicios de relevancia hechos por hablantes nativos. En concreto, la partición de desarrollo en español de la versión MIRACLRetrievalHardNegatives de MTEB[6], que según su ficha se creó "by pooling the 250 top documents per query from BM25, e5-multilingual-large and e5-mistral-instruct".
Esa partición tiene 648 preguntas, 146 750 pasajes y 2 987 juicios positivos. Embeber los 146 750 pasajes en CPU con 4 hilos no cabía en el presupuesto de la prueba, así que monté un subconjunto de 12 000 pasajes con esta receta:
- Juzgados: los 5 636 pasajes con juicio humano, 2 987 relevantes y 2 679 marcados como no relevantes
- Relleno: 6 364 pasajes al azar (semilla 20261028) del resto del corpus; cada uno estuvo entre los 250 primeros de BM25 o e5 para alguna de estas preguntas, así que también son distractores difíciles
- Texto: título, salto de línea y pasaje, recortado a 2 000 caracteres; afecta a 120 de los 12 000
Cada pregunta tiene entre 1 y 10 pasajes relevantes, 4,6 de media. Los pasajes sin juicio cuentan como no relevantes, que es la convención de MIRACL y perjudica a todos los sistemas por igual. Mido recall@k (qué fracción de los pasajes relevantes aparece entre los k primeros), nDCG@10 (premia tener los relevantes arriba) y MRR@10 (inverso de la posición del primer relevante). Para cómo elegir métricas sin engañarte, está la guía para evaluar un sistema RAG.
La consulta en pgvector y la dificultad de ef_search
La primera etapa es una consulta de vecinos más cercanos por distancia coseno. La tabla guarda el vector de 1024 dimensiones junto al texto, y el índice HNSW usa los valores por defecto de pgvector (m = 16, ef_construction = 64):
CREATE TABLE pasajes (
  id        text PRIMARY KEY,
  titulo    text NOT NULL,
  texto     text NOT NULL,
  embedding vector(1024)
);
CREATE INDEX ON pasajes USING hnsw (embedding vector_cosine_ops);

SET hnsw.ef_search = 100;
SELECT id FROM pasajes
ORDER  BY embedding <=> $1::vector
LIMIT  50;
El SET hnsw.ef_search = 100 no es decorativo. La FAQ de pgvector[7] avisa: "Results are limited by the size of the dynamic candidate list (hnsw.ef_search), which is 40 by default". Lo comprobé: con el valor por defecto, LIMIT 50 devolvió 40 filas por el índice HNSW, y con 100 devolvió 50. Si tu reranker espera 50 candidatos, sube ef_search por encima de N o recibirá menos sin ningún error.
Hubo una segunda sorpresa. Con 12 000 filas, el planificador de PostgreSQL eligió un recorrido secuencial exacto en lugar del índice, incluso tras un ANALYZE; para medir el HNSW tuve que forzarlo con SET enable_seqscan = off. A este tamaño el planificador no se equivoca: la consulta de 50 vecinos tardó 14,8 ms de mediana en exacto y 14,9 ms con HNSW.
Con ef_search = 100, el HNSW devolvió la misma lista de 50 que la búsqueda exacta en 560 de las 648 preguntas. El solapamiento medio fue del 99,5 %, y el nDCG@10 bajó solo de 0,811 a 0,809. Con ef_search = 40 devolvió 40 filas en todas las preguntas menos en una, que recibió 41.
Cómo llamar a /v1/rerank desde tu código
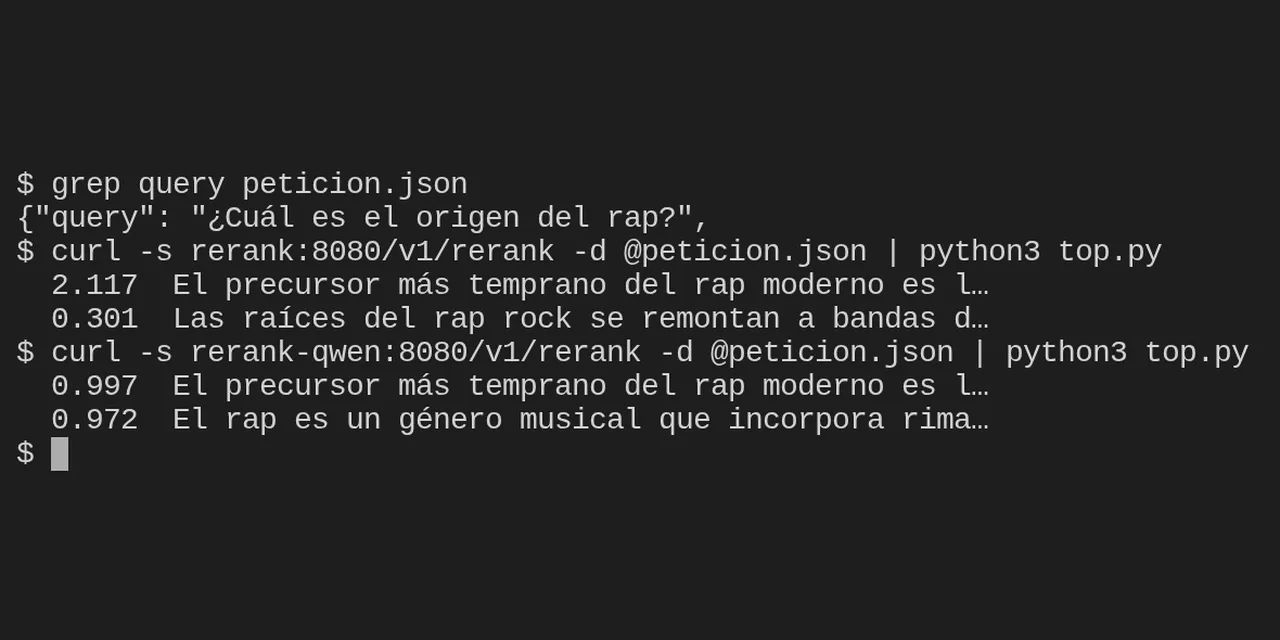
El endpoint recibe la pregunta y una lista de textos, y devuelve índices con su puntuación ordenados de mayor a menor. Acepta también las rutas /rerank, /reranking y /v1/reranking. Esta es una petición real con tres frases cortas, guardada en peticion.json:
{"query": "¿Cuál es el origen del rap?",
 "top_n": 2,
 "documents": [
  "El rap es un género musical que incorpora rima y habla rítmica.",
  "El precursor más temprano del rap moderno es la tradición griot del oeste de África.",
  "Las raíces del rap rock se remontan a bandas de la old school."]}
La envías con curl y recibes el ranking con la puntuación de cada índice:
curl -s http://127.0.0.1:24902/v1/rerank \
  -H 'Content-Type: application/json' -d @peticion.json
bge-reranker-v2-m3 colocó primero el pasaje sobre el griot, con 2,117, y después el de rap rock, con 0,301; la definición del género quedó fuera del top_n. Con el servidor en reposo, seis repeticiones dieron exactamente esas cifras.
Mientras atendía otras peticiones, la misma llamada devolvió 0,435 para el rap rock y 2,105 para el griot. La puntuación varía según cómo agrupe llama-server los pares en lotes, aunque aquí el orden no cambió. Qwen3-Reranker-0.6B coincidió en el primero, el griot con 0,9969, pero puso segunda la definición, con 0,9709.
Las dos escalas no son comparables. BGE devuelve el logit sin transformar (su ficha indica que una sigmoide lo lleva a [0, 1]) y Qwen3 devuelve ya una probabilidad. Si fijas un umbral de corte, fíjalo por modelo.
El otro dato de la respuesta es usage.prompt_tokens: 86 tokens en BGE y 301 en Qwen3 para la misma petición. La diferencia sale de que la GGUF de Qwen3 envuelve cada par en una plantilla de chat con la instrucción "Given a web search query, retrieve relevant passages that answer the query".
El flujo completo en Python cabe en una función. Recibe el vector de la pregunta, pide 50 candidatos a pgvector y devuelve los k mejores según el reranker:
def buscar(conn, pregunta, qvec, n=50, k=5):
    with conn.cursor() as cur:
        cur.execute("SET hnsw.ef_search = 100")
        cur.execute(
            "SELECT id, titulo || E'\\n' || texto FROM pasajes "
            "ORDER BY embedding <=> %s::vector LIMIT %s",
            (str(qvec), n))
        filas = cur.fetchall()
    r = requests.post(RERANK_URL, timeout=60, json={
        "query": pregunta,
        "documents": [t[:2000] for _, t in filas]})
    r.raise_for_status()
    orden = r.json()["results"][:k]
    return [filas[x["index"]][0] for x in orden]
Cuánto mejora la calidad con reranking
Con bge-reranker-v2-m3 reordenando los 20 primeros candidatos de pgvector, el nDCG@10 subió de 0,805 a 0,850 en 300 preguntas elegidas al azar entre las 648. La mejora media es de 0,045, con un intervalo de confianza del 95 % entre 0,028 y 0,062 (bootstrap pareado por pregunta, 10 000 remuestreos):
El primer resultado fue relevante en el 76 % de las preguntas sin reranker y en el 80 % con él. El recall@5 no llega a 1 en ningún caso porque algunas preguntas tienen hasta 10 pasajes relevantes.
La media esconde que el reranker también empeora respuestas. De las 300 preguntas, el nDCG@10 mejoró en 165, empeoró en 87 y quedó igual en 48.
Un caso claro de mejora es "¿Por qué David Bowie usaba maquillaje?". BGE-M3 llenó los primeros puestos con pasajes de la biografía de Bowie que no hablan de maquillaje. Dejó en el puesto 11 el de Ziggy Stardust, que cuenta que Bowie se inspiró en el maquillaje del kabuki, y en el 16 el de glam rock. El reranker los subió al segundo y al primer puesto.
Qwen3-Reranker-0.6B dio un resultado equivalente. Lo evalué en las primeras 162 preguntas de la misma muestra, porque procesa más tokens por pasaje y no llegó a las 300 en el tiempo de la prueba. Sobre esas 162, con 20 candidatos:
La diferencia a favor de Qwen3 es de 0,007 en nDCG@10, con un intervalo del 95 % entre -0,015 y 0,029: no se distingue de cero. Qwen3 ganó en 66 preguntas y BGE en 65. Con estos datos, la elección entre los dos depende de otras cosas, como la memoria y los tokens que cuesta cada uno, que trato más abajo.
Cuántos candidatos pasar al reranker
Pasar 20 candidatos al reranker basta en este conjunto. Con 10, el nDCG@10 queda en 0,835; con 20 llega a 0,850, y con 30 o 50 se queda en 0,848 y 0,847.
La razón está en la primera etapa. BGE-M3 ya coloca el 91,3 % de los pasajes relevantes entre sus 10 primeros y el 99,7 % entre sus 50 primeros. Por debajo del puesto 20 apenas queda nada que rescatar.
El gráfico recoge las tres curvas sobre las 151 preguntas que evaluaron todas las configuraciones, así que sus cifras difieren un poco de las tablas:
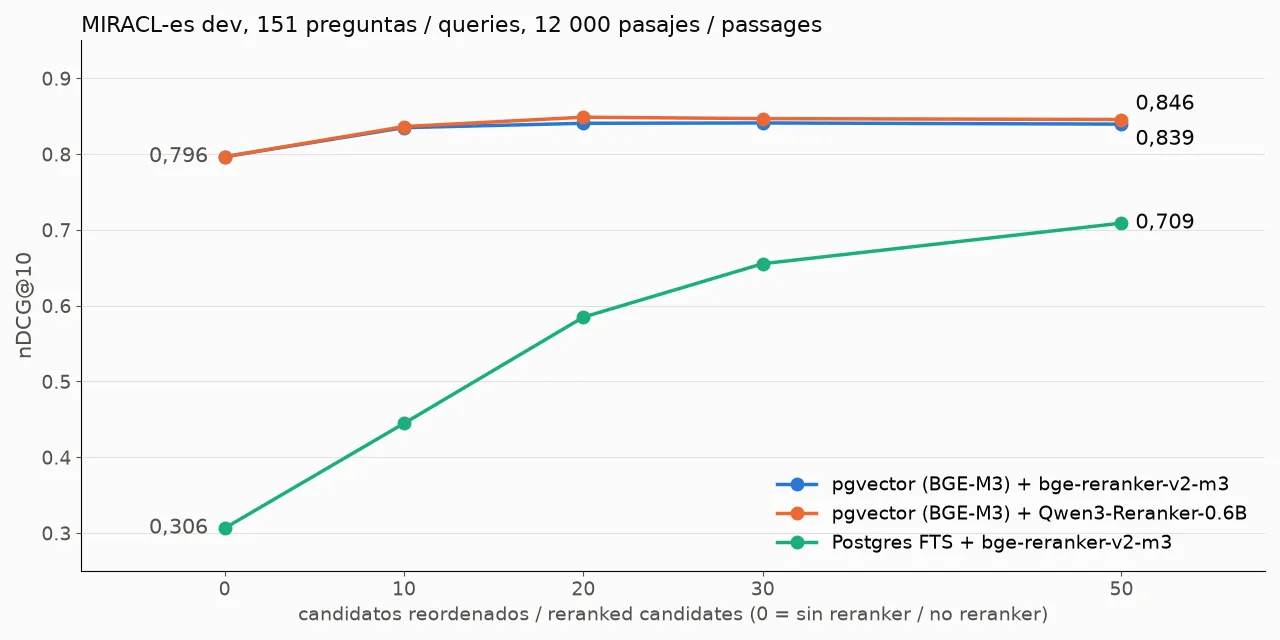
Con 10 candidatos, el recall@10 no puede cambiar, porque el reranker solo reordena los mismos 10 pasajes; la mejora viene toda de colocar mejor los relevantes. Con 20 ya puede traer pasajes desde los puestos 11 a 20, y el recall@10 sube de 0,913 a 0,944.
Esta cifra depende de tu primera etapa. Si tus embeddings recuperan peor, como en un corpus técnico con jerga que el modelo no vio, los relevantes caen más abajo y compensa pasar más candidatos. Mide el recall@50 de tu primera etapa antes de elegir N: si ya está cerca de 1, un N pequeño basta.
¿Compensa más que una búsqueda híbrida con BM25?
No, en esta prueba. La búsqueda híbrida combina una búsqueda por palabras con la vectorial. La monté con lo que ya trae PostgreSQL: una columna tsvector con la configuración spanish, un índice GIN y una consulta que une con OR los lexemas de la pregunta, ordenada por ts_rank_cd. Esa búsqueda de texto completo (FTS) sola se quedó en un nDCG@10 de 0,309 sobre las 648 preguntas.
Fusionar las dos listas con Reciprocal Rank Fusion (RRF, con k = 60) dio 0,642, por debajo de los 0,811 de BGE-M3 sola. La FTS era tan floja que metía ruido en la lista buena. Un BM25 de verdad, con consultas mejor construidas, cambiaría este resultado, así que tómalo como una advertencia sobre la FTS de PostgreSQL tal cual, no sobre toda búsqueda híbrida.
El reranker sí rescata una primera etapa floja. Sobre 151 preguntas, reordenar los 50 primeros resultados de la FTS subió su nDCG@10 de 0,306 a 0,709 y el MRR@10 de 0,404 a 0,829. El primer resultado pasó de ser relevante en el 24,5 % de las preguntas al 76,2 %. En "¿En qué países es bitcoin una moneda oficial?", el pasaje correcto saltó del puesto 43 al primero.
Aun así, FTS más reranker quedó por debajo de BGE-M3 sin reranker, 0,709 frente a 0,796 en esas mismas preguntas. El techo lo pone la primera etapa: la FTS solo tenía entre sus 50 primeros el 75,7 % de los pasajes relevantes, y el reranker no puede subir lo que no recibe. Aquí la profundidad sí importa: con la FTS, cada salto de 10 a 20, 30 y 50 candidatos siguió mejorando el nDCG@10.
Qué cuesta en CPU reordenar 50 pasajes
Reordenar es la parte cara del flujo, y el campo usage.prompt_tokens de cada respuesta permite contarlo sin cronómetro. En una muestra de 20 preguntas, embeber la pregunta costó 14 tokens de media. Reordenar sus 20 candidatos con bge-reranker-v2-m3 costó 3 420 tokens, y los 50 candidatos, 9 066: unas 240 y 640 veces más trabajo que el embedding.
Qwen3-Reranker-0.6B añade la plantilla de chat a cada par, unos 72 tokens más por pasaje en la petición de ejemplo (301 frente a 86 con tres frases). Con pasajes cortos, esa plantilla puede duplicar los tokens que procesa el reranker.
Este es el argumento práctico para elegir N con la curva anterior. Pasar de 20 a 50 candidatos multiplicó por 2,7 los tokens del reranker y no mejoró el nDCG@10.
En tiempo, el reranker pesa más de cien veces lo que pesan las otras dos etapas. Medí 40 preguntas en secuencia, tres veces, con cada servidor limitado a 4 hilos y la caché de prompts desactivada, y doy la mediana de las tres ejecuciones. La carga media de un minuto estaba entre 2,55 y 2,95 al empezar cada ejecución:
| Paso, por pregunta | Mediana | p95 |
|---|---|---|
| Embedding de la pregunta (BGE-M3) | 12,6 ms | 17,7 ms |
| pgvector, 50 vecinos, búsqueda exacta | 14,8 ms | 17,7 ms |
| pgvector, 50 vecinos, HNSW | 14,9 ms | 18,0 ms |
| bge-reranker-v2-m3, 10 / 20 / 50 pasajes | 1,45 / 3,04 / 7,99 s | 2,34 / 4,22 / 9,64 s |
| Qwen3-Reranker-0.6B, 10 / 20 / 50 pasajes | 4,75 / 9,77 / 25,8 s | 6,79 / 12,6 / 29,4 s |
Con 4 hilos de CPU, reordenar 20 pasajes con BGE añadió 3 s por pregunta, unas 110 veces lo que tardaron el embedding y pgvector juntos. Qwen3 fue 3,2 veces más lento que BGE con la misma calidad. Si ese retraso no cabe en tu presupuesto, reduce N, recorta los pasajes o lleva el reranker a una GPU.
Seguridad: top_n negativo y un puerto que no debes publicar
llama-server no valida top_n. El código de server-common.cpp[8] ordena los resultados y llama a resize con el mínimo entre top_n y el número de documentos, sin comprobar el signo. El CVE-2026-52132[9], publicado el 1 de septiembre de 2026, describe una denegación de servicio "via a negative top_n value in a POST request to /rerank" hasta el commit 97f06e9.
En la build b11206 lo probé con "top_n": -1. La respuesta fue un HTTP 500 con el mensaje vector::_M_default_append, y el servidor siguió respondiendo 200 en /health. No reproduje una caída, pero la entrada sigue sin validarse, así que haz tres cosas:
- valida
top_nen tu aplicación antes de reenviarlo - publica el puerto solo en
127.0.0.1o en una red interna de Docker - actualiza la imagen de llama.cpp: el 28 de septiembre usé la b11206 y el feed de versiones ya tenía la b11223, del día anterior
Qwen3-Reranker no cupo en 4 GiB
Le di a Qwen3-Reranker-0.6B la misma configuración que a BGE (-c 16384, -ub 2048, 8 slots) y un límite de 4 GiB. El contenedor murió a los pocos minutos de carga, marcado por Docker con OOMKilled y código de salida 137.
Lo relancé con 8 GiB. Aun así, su memoria siguió creciendo hasta rozar el nuevo límite, porque llama-server guarda por defecto una caché de prompts de hasta 8192 MiB (--cache-ram). En un reranker cada petición es distinta y esa caché aporta poco, así que la desactivé con --cache-ram 0 y la memoria dejó de crecer.
En la medición de latencia, ya con la caché desactivada en los tres servidores, Qwen3 llegó a un pico de 4,96 GiB y se quedó en 4,5 GiB en reposo. BGE tuvo un pico de 2,99 GiB y el servidor de embeddings, de 1,06 GiB.
Límites de esta medición
Estos resultados vienen de un único conjunto de datos, y conviene leerlos con sus condiciones:
- Dominio: preguntas factuales sobre Wikipedia en español; tus documentos internos pueden comportarse de otra forma
- Posible ventaja de dominio: la ficha de BGE-M3 agradece a MIRACL entre sus datos abiertos, así que la familia BGE pudo ver datos parecidos; por eso importa la mejora relativa más que la cifra absoluta
- Corpus reducido: 12 000 pasajes, no los millones de un despliegue real; con más pasajes la primera etapa falla más y el reranker tiene más que corregir
- Etiquetas incompletas: un pasaje relevante sin juicio cuenta como fallo
- Cuantización: GGUF Q8_0, no los pesos originales
- Muestra: el reranking se evaluó sobre 300 de las 648 preguntas, elegidas al azar, por presupuesto de CPU, y Qwen3 y la FTS sobre las primeras 162 y 151 de esa misma muestra
- Puntuaciones con ruido: las puntuaciones se calcularon con el servidor atendiendo peticiones en paralelo, y varían ligeramente con el lote
Preguntas frecuentes
¿Necesito una GPU para usar un reranker local?
No para probarlo, aunque en producción la latencia pesa. Todo este laboratorio corrió en CPU arm64 con 4 hilos por servidor, y bge-reranker-v2-m3 tardó 3,04 s de mediana en reordenar 20 pasajes. Los tres modelos Q8_0 ocupan en disco entre 634 y 640 MB cada uno.
¿Qué reranker elijo para documentos en español?
En esta prueba con preguntas en español, bge-reranker-v2-m3 y Qwen3-Reranker-0.6B empataron en calidad. Con 20 candidatos sacaron 0,847 y 0,853 de nDCG@10, una diferencia dentro del margen de error. BGE fue 3,2 veces más rápido con 20 candidatos y cupo en un contenedor de 4 GiB, así que es el punto de partida más barato. Qwen3 permite cambiar la instrucción, pero en llama-server va fija dentro de la plantilla de la GGUF.
¿Puedo usar el mismo llama-server para embeddings y reranking?
No en la misma instancia: --reranking fija el pooling en rank, y los embeddings de BGE-M3 necesitan cls. Levanta dos contenedores con la misma imagen, cada uno con su modelo, como en el compose.yaml de arriba.
Conclusión
Un reranker local mejora un RAG con pgvector, y en esta prueba la mejora fue medible pero moderada. Sumó 4,5 puntos de nDCG@10 sobre una primera etapa que ya era buena, con BGE-M3 recuperando el 91 % de los relevantes entre sus 10 primeros. Donde brilla es cuando la primera etapa falla: sobre la FTS de PostgreSQL, el mismo reranker multiplicó por 2,3 el nDCG@10.
La receta que saco de aquí tiene cuatro pasos:
- mide primero el recall@50 de tu búsqueda vectorial con tus propias preguntas; si está cerca de 1, pasa 20 candidatos y no más
- empieza con bge-reranker-v2-m3 en llama-server, con
--rerankingy un contenedor que no publique el puerto - sube
hnsw.ef_searchpor encima del número de candidatos - valida
top_nen tu código y mantén la imagen de llama.cpp al día
El siguiente paso es montar tu propio conjunto de preguntas etiquetadas, aunque sean 50, y repetir la medición con tus documentos. Para llevar el conjunto a producción, la guía de RAG con Postgres y pgvector en producción cubre el resto del camino.
Fuentes: [1] README de llama-server[3], [2] common/arg.cpp de llama.cpp[4], [3] server-common.cpp de llama.cpp[8], [4] CVE-2026-52132[9], [5] Ficha de bge-reranker-v2-m3[1], [6] Ficha de BGE-M3[10], [7] Ficha de Qwen3-Reranker-0.6B[11], [8] pgvector[7], [9] Registro de cambios de pgvector[2], [10] MIRACL[5], [11] MIRACLRetrievalHardNegatives de MTEB[6].
Fuentes
Código fuente
Accede a todo el código fuente de este artículo en GitHub.
Ver en GitHub