CVE-2026-80521 en Docker y k3s: cómo saber si te afecta y cómo mitigarlo
Índice de contenidos
- Puntos clave
- Qué es CVE-2026-80521 y por qué escapa del contenedor
- Qué kernels están afectados
- Cómo comprobar tu kernel y si hay paquete corregido
- Cómo ver el kernel de cada nodo en k3s
- Cómo parchear y reiniciar sin sorpresas
- Qué mitigaciones cortan el camino mientras no parcheas
- Por qué userns-remap, rootless y no-new-privileges no bastan
- El perfil seccomp sin AF_UNIX: bloquea, pero rompe cosas
- gVisor: la mitigación que no rompe tus aplicaciones
- gVisor en k3s con una RuntimeClass
- Máquinas virtuales ligeras para lo que no es de fiar
- Qué hago yo según el tipo de host
- Preguntas frecuentes
- ¿Me afecta CVE-2026-80521 si solo uso Docker Desktop en el Mac?
- ¿El seccomp por defecto de Docker o el RuntimeDefault de Kubernetes me protegen?
- ¿Sirve de algo ejecutar el contenedor como usuario no root?
- Conclusión
- Fuentes
CVE-2026-80521 es un fallo del kernel Linux que permite a un proceso sin privilegios dentro de un contenedor Docker o Kubernetes por defecto hacerse root en el host. El fallo vive en el recolector de basura de los sockets Unix (AF_UNIX), la corrección está en el kernel desde agosto y el exploit es público desde el 22 de septiembre de 2026. Aquí tienes cómo saber si tu host o tu nodo k3s está afectado, qué paquete lo corrige en cada distribución y qué mitigaciones funcionan mientras no puedes reiniciar. Las he probado en Docker y en k3s sin tocar el exploit. También está la versión en inglés de esta guía.
Puntos clave
- El CVE tiene una puntuación CVSS de 7,8 y afecta a los kernels 6.10 y posteriores sin corregir, y a las ramas 6.1 y 6.6 desde las versiones 6.1.141 y 6.6.93.
- Las versiones upstream corregidas son 6.12.111, 6.18.53, 7.1.10 y 7.2. Debian 13 ya tiene paquete (6.12.111-1); a 30 de septiembre, Ubuntu 24.04 y 26.04 y RHEL 10 siguen sin él.
- userns-remap, no-new-privileges, quitar todas las capabilities o el seccomp por defecto no cortan el camino: en mis pruebas, un contenedor así crea sockets Unix y pasa descriptores con SCM_RIGHTS sin problema.
- Un perfil seccomp que prohíbe crear sockets AF_UNIX sí bloquea esas llamadas con EPERM, pero PostgreSQL no arranca con él y nginx se queda sin procesos worker.
- gVisor (runsc) atiende los sockets Unix del contenedor en su propio kernel de espacio de usuario: 500 pares de sockets dentro del sandbox no crearon ninguno en el host.
- La única corrección real es el kernel parcheado y un reinicio. Todo lo demás reduce la exposición mientras llega.
Qué es CVE-2026-80521 y por qué escapa del contenedor
CVE-2026-80521 es un use-after-free en net/unix/garbage.c, el código que libera los sockets Unix que quedan en ciclos al pasarse descriptores de archivo con mensajes SCM_RIGHTS. Una carrera entre un sendmsg() y un close() deja en una lista interna un puntero a memoria ya liberada, y la siguiente pasada del recolector la lee. El commit de la corrección[1], firmado por Kuniyuki Iwashima el 4 de agosto de 2026, explica la carrera y la cierra desenlazando esa entrada antes de liberar el vértice.
Un contenedor comparte el kernel del host. Si un proceso del contenedor corrompe memoria del kernel, ya no importan los namespaces ni los cgroups: el código del atacante corre con privilegios de kernel. El registro del CVE[2] lo resume en su vector CVSS: ataque local, complejidad baja y privilegios bajos, porque cualquier usuario puede crear sockets Unix y pasarse descriptores. El fallo apareció con la reescritura del recolector (commit 4090fa373f0e, marzo de 2024), que llegó a Linux 6.10.
DepthFirst publicó el 22 de septiembre su análisis y el exploit[3], firmado por Zhenpeng Lin. La empresa explotó el fallo en julio en kernelCTF, el programa de recompensas de Google, contra el kernel 6.12.95. Según su cronología, al reportarlo el 5 de agosto supieron que otro investigador de OpenAI ya lo había enviado; el commit atribuye el reporte a Kyle Zeng.
El artículo cuenta 5 976 CVE del kernel publicados entre el 1 de enero y el 16 de septiembre de 2026, y sostiene que el contenedor ya no es una frontera fiable. Sobre este fallo es tajante: "We have released our complete container escape exploit for CVE-2026-80521 here, which successfully targets the latest Ubuntu 26.04."
No he ejecutado ni descargado ese exploit. Lo que sigue se apoya en los trackers de cada distribución, en el código del kernel y en pruebas de las mitigaciones en mi laboratorio.
Qué kernels están afectados
Estás afectado si tu kernel incluye el recolector nuevo y no incluye la corrección. El registro del CVE en cve.org, que publica el propio equipo del kernel como CNA, da estos rangos para kernels upstream:
| Rama | Estado |
|---|---|
| Hasta 6.9 (salvo 6.1 y 6.6) | No afectada |
| 6.1.141 en adelante | Afectada, sin versión corregida publicada |
| 6.6.93 en adelante | Afectada, sin versión corregida publicada |
| 6.10, 6.11 y 6.13 a 6.17 | Afectadas; ramas sin mantenimiento |
| 6.12 | Corregida desde 6.12.111 |
| 6.18 | Corregida desde 6.18.53 |
| 6.19 y 7.0 | Afectadas; ramas sin mantenimiento |
| 7.1 | Corregida desde 7.1.10 |
| 7.2 y posteriores | Corregidas |
Los kernels de distribución no siguen estos números. Cada distribución retroporta parches a su propia versión, así que el número que ves en uname -r no basta y manda el tracker de tu distribución. A 30 de septiembre de 2026, así estaban:
| Distribución | Kernel | Estado |
|---|---|---|
| Ubuntu 26.04 LTS | linux 7.0 | Vulnerable, "work in progress" |
| Ubuntu 24.04 LTS | linux 6.8, HWE 6.17 y 7.0 | Vulnerable |
| Ubuntu 22.04 LTS | linux 5.15 | No afectado (el HWE 6.8 sí) |
| Debian 13 trixie | 6.12.111-1 (DSA-6528-1) | Corregido |
| Debian 12 bookworm | 6.1.187-1 | Vulnerable |
| Debian 11 bullseye | 5.10 | No afectado |
| RHEL 10 | kernel | Afectado |
| RHEL 6, 7, 8 y 9 | kernel | No afectado |
La tabla sale del tracker de Ubuntu[4] (actualizado el 24 de septiembre), del tracker de Debian[5] y de la página de Red Hat[6]. Red Hat lo califica como Important y dice que no tiene mitigación que cumpla sus criterios. Ubuntu 24.04 lleva un kernel 6.8, que en upstream no estaría afectado. Su tracker lo marca como vulnerable, así que el código afectado está en ese kernel aunque el número diga 6.8.
Cómo comprobar tu kernel y si hay paquete corregido
Mira primero qué kernel está corriendo, no cuál está instalado. Un paquete corregido no sirve de nada hasta que reinicias. Para kernels upstream (compilados por ti, de un proveedor cloud que sigue las ramas estables o de una imagen tipo Talos), este script clasifica la versión según los rangos del CVE:
#!/usr/bin/env bash
# Clasifica una version upstream de Linux frente a CVE-2026-80521.
# Solo vale para kernels vanilla o stable: los de distro, al tracker.
v=${1:-$(uname -r)}
IFS=. read -r maj min pat <<<"${v%%[-+]*}"
pat=${pat:-0}
k=$((maj * 1000 + min))
st=AFECTADO
case $k in
  6001) ((pat < 141)) && st="no afectado" ;;
  6006) ((pat < 93)) && st="no afectado" ;;
  6012) ((pat >= 111)) && st=CORREGIDO ;;
  6018) ((pat >= 53)) && st=CORREGIDO ;;
  7001) ((pat >= 10)) && st=CORREGIDO ;;
esac
((k < 6010 && k != 6001 && k != 6006)) && st="no afectado"
((k >= 7002)) && st=CORREGIDO
echo "$v: $st"
Sin argumentos lee uname -r; con uno, clasifica la versión que le pases. Esto devolvió en mi laboratorio:
7.0.14-orbstack-00380-ga7e0a2dc9535: AFECTADO
6.12.111: CORREGIDO
6.8.0-142-generic: no afectado
La primera línea es el kernel de mi laboratorio, un 7.0 de OrbStack, en una rama sin corrección. La tercera muestra el límite del script. El kernel 6.8.0-142 de Ubuntu 24.04 sale como no afectado porque en upstream no lo estaría, pero el tracker de Ubuntu dice lo contrario.
Con un kernel de distribución, usa el gestor de paquetes. En Debian 13, apt-cache policy enseña la versión instalada y la candidata:
$ apt-get update
$ apt-cache policy linux-image-arm64 | head -4
linux-image-arm64:
  Installed: (none)
  Candidate: 6.12.111-1
  Version table:
Lo ejecuté en un contenedor debian:trixie, por eso Installed sale vacío; en tu host verás la versión instalada.
En un host amd64 el paquete se llama linux-image-amd64. Si la instalada es anterior a 6.12.111-1, te falta el parche. En Debian 12 la candidata era 6.1.187-1, todavía vulnerable. En Ubuntu 24.04 la candidata de linux-image-generic era 6.8.0-142.142 y en 26.04, 7.0.0-34.34, ambas sin corrección según el tracker.
En la familia RHEL, dnf updateinfo busca un aviso de seguridad que cite el CVE. En AlmaLinux 10.2, con el kernel 6.12.0-211.56.1.el10_2, no devolvió nada, lo que cuadra con que Red Hat aún no ha publicado la corrección:
dnf updateinfo list --cve CVE-2026-80521
Cómo ver el kernel de cada nodo en k3s
El nodo de k3s usa el kernel del host, igual que Docker. kubectl te da el de todos los nodos de una vez:
$ kubectl get nodes -o custom-columns=NODE:.metadata.name,\
KERNEL:.status.nodeInfo.kernelVersion
NODE           KERNEL
24774a916b97   7.0.14-orbstack-00380-ga7e0a2dc9535
Si montaste k3s como en la guía de k3s para el homelab, cada nodo es un host Debian o Ubuntu y aplica todo lo anterior nodo a nodo.
Cómo parchear y reiniciar sin sorpresas
La corrección es instalar el kernel nuevo y reiniciar. En Debian 13, apt-get -s simula la actualización y muestra qué versión instalaría:
$ apt-get -s install linux-image-arm64 \
    | awk '/^Inst linux-image/ {print $2, $3}'
linux-image-6.12.111+deb13-arm64 (6.12.111-1
linux-image-arm64 (6.12.111-1
Quita -s para instalarlo de verdad, reinicia y comprueba que uname -r devuelve 6.12.111+deb13-arm64 o superior. En un clúster k3s, vacía cada nodo con kubectl drain antes de reiniciarlo y hazlo de uno en uno. Mi laboratorio corre en el kernel de OrbStack, así que no he reiniciado un host real con este parche: la instalación la he simulado y el resto es el procedimiento estándar de Debian.
Los parches en caliente, como Canonical Livepatch o kpatch en RHEL, solo sirven cuando el proveedor publica uno para este CVE. A 30 de septiembre, ni Ubuntu ni Red Hat tenían paquete corregido, así que compruébalo en su tracker antes de contar con ello.
Qué mitigaciones cortan el camino mientras no parcheas
Casi ninguna de las medidas habituales de endurecimiento de contenedores bloquea este fallo. Todas limitan qué puede hacer el proceso sobre el host, pero el exploit solo necesita crear sockets Unix y pasarse descriptores, dos cosas que cualquier programa puede hacer. Para comprobarlo escribí un probador en Python que intenta exactamente eso, sin disparar el fallo:
import os, socket

def scm_rights():
    a, b = socket.socketpair()
    socket.send_fds(a, [b"x"], [os.open("/", os.O_RDONLY)])
    socket.recv_fds(b, 1, 1)
    return [a, b]

tests = {
    "socket(AF_UNIX)": lambda: [socket.socket(socket.AF_UNIX)],
    "socketpair()": lambda: list(socket.socketpair()),
    "SCM_RIGHTS": scm_rights,
    "socket(AF_INET)": lambda: [socket.socket(socket.AF_INET)],
}
for name, make in tests.items():
    try:
        for s in make():
            s.close()
        print(f"{name}: OK")
    except OSError as e:
        print(f"{name}: {e}")
Lo ejecuté en python:3.14-alpine con cinco configuraciones. Las de runc corrieron en Docker 29.5.2; userns-remap y gVisor, en un dockerd 29.8.1 anidado, para no tocar el daemon compartido. Este es el resultado:
| Configuración | socket(AF_UNIX) | socketpair | SCM_RIGHTS | ¿Llega al código vulnerable del host? |
|---|---|---|---|---|
| runc, seccomp por defecto | OK | OK | OK | Sí |
runc, no-new-privileges, --cap-drop ALL, usuario 1000 |
OK | OK | OK | Sí |
| runc con userns-remap | OK | OK | OK | Sí |
| runc, seccomp sin AF_UNIX | EPERM | EPERM | EPERM | No |
| runsc (gVisor) | OK | OK | OK | No, lo atiende gVisor |
Por qué userns-remap, rootless y no-new-privileges no bastan
userns-remap hace que el root del contenedor sea un usuario sin privilegios en el host. Con "userns-remap": "default" en daemon.json, el daemon creó el usuario dockremap con el rango 165536:65536, y un sleep lanzado como root en el contenedor apareció en el host como UID 165536:
$ docker exec probe cat /proc/self/uid_map
         0     165536      65536
$ ps -o user,pid,args | grep 'sleep 300'
165536     739 sleep 300
Eso protege frente a errores de configuración, como un volumen del host montado con permisos de más. No protege de un fallo del kernel: el exploit corrompe memoria del kernel, y el kernel no mira qué UID tenía el proceso que la corrompió. Docker rootless y Podman sin root se apoyan en el mismo mecanismo de user namespaces; no los he probado aquí, pero el razonamiento es el mismo.
no-new-privileges solo impide ganar privilegios con binarios setuid, y quitar capabilities no afecta a los sockets Unix. En Kubernetes vi lo mismo: un pod con runAsNonRoot, capabilities.drop: ["ALL"] y seccomp RuntimeDefault imprimió socketpair OK.
El perfil seccomp sin AF_UNIX: bloquea, pero rompe cosas
El perfil seccomp por defecto de Docker permite socket() para los dominios 0 a 2, es decir, AF_UNIX incluido, y socketpair() sin condiciones. Tomé el perfil por defecto de moby[7] y cambié dos cosas: quité socketpair de la lista permitida y dejé socket() solo para el dominio 2 (AF_INET). La acción por defecto del perfil devuelve EPERM para lo demás:
import json

d = json.load(open("default.json"))
allow = d["syscalls"][0]
allow["names"] = [n for n in allow["names"] if n != "socketpair"]
rule = d["syscalls"][2]
assert rule["names"] == ["socket"]
assert rule["args"][0]["op"] == "SCMP_CMP_LT"
rule["args"] = [{"index": 0, "value": 2, "op": "SCMP_CMP_EQ"}]
json.dump(d, open("no-af-unix.json", "w"), indent=1)
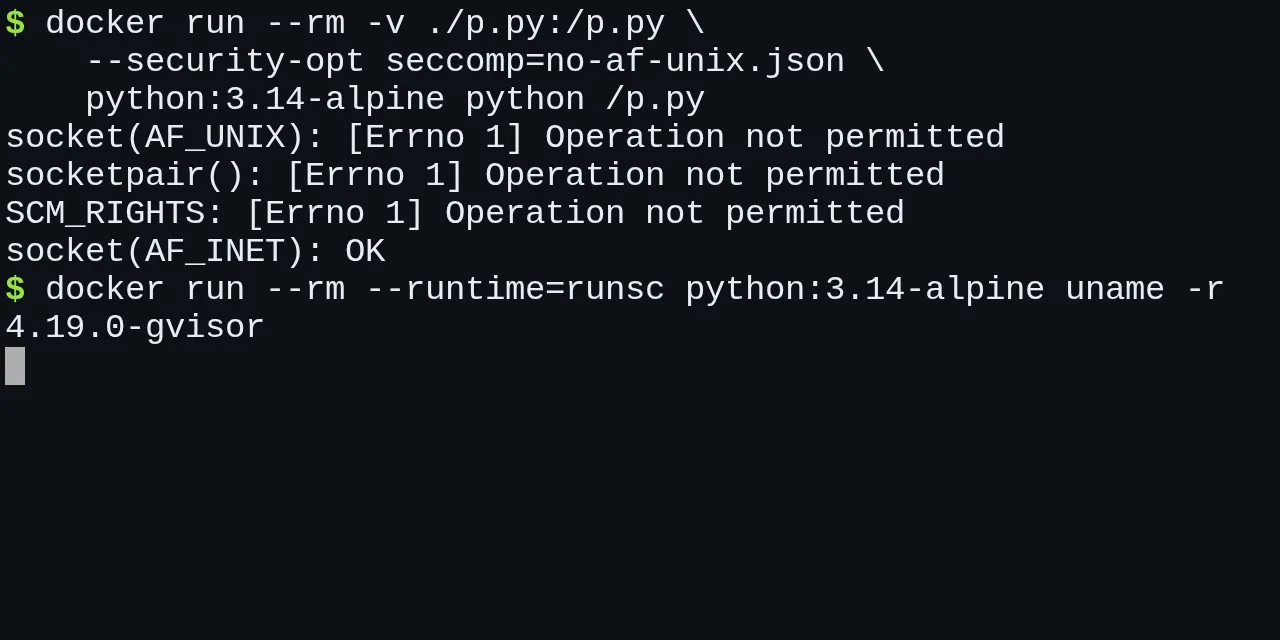
Los índices 0 y 2 son los del default.json que descargué el 30 de septiembre; los assert fallan si cambian. Con el perfil aplicado, las tres llamadas de sockets Unix devuelven Operation not permitted y el TCP sigue funcionando:
$ docker run --rm -v ./p.py:/p.py \
    --security-opt seccomp=no-af-unix.json \
    python:3.14-alpine python /p.py
socket(AF_UNIX): [Errno 1] Operation not permitted
socketpair(): [Errno 1] Operation not permitted
SCM_RIGHTS: [Errno 1] Operation not permitted
socket(AF_INET): OK
El precio es alto, porque AF_UNIX está en todas partes. Arranqué tres imágenes habituales con el perfil:
- postgres:18-alpine: no arranca.
FATAL: could not create any Unix-domain sockets - nginx-unprivileged:alpine: el proceso sigue vivo, pero el log repite
socketpair() failed while spawning "worker process"y no queda ningún worker que atienda peticiones - redis:8.10.2-alpine: arranca y acepta conexiones TCP
- asyncio de Python:
asyncio.run()falla conPermissionError, porque el bucle de eventos usa unsocketpair()interno
Úsalo solo para cargas concretas que hayas probado, como un worker que solo habla TCP. Hay otro límite: el perfil impide crear sockets Unix, pero no usar uno que el contenedor ya reciba abierto. Si montas /var/run/docker.sock o cualquier socket del host, el contenedor tiene un AF_UNIX en la mano y el perfil no lo cubre. En Kubernetes el perfil se instala en /var/lib/kubelet/seccomp/profiles/ de cada nodo y se referencia en el pod:
spec:
  securityContext:
    seccompProfile:
      type: Localhost
      localhostProfile: profiles/no-af-unix.json
En k3s v1.37.0 un pod con ese perfil devolvió socketpair: [Errno 1] Operation not permitted.
gVisor: la mitigación que no rompe tus aplicaciones
gVisor ejecuta el contenedor sobre su propio kernel, el Sentry, que atiende las llamadas al sistema en espacio de usuario. La documentación de seguridad de gVisor[8] lo explica así: "the application’s direct interactions with the host System API are intercepted by the Sentry, which implements the System API instead." Los sockets Unix del contenedor viven dentro del Sentry, así que el recolector vulnerable del host no llega a verlos. Ya lo presentamos en el artículo sobre gVisor para contenedores multi-tenant.
Para comprobarlo abrí 500 pares de sockets con Python dentro de un contenedor runc y dentro de otro runsc, y conté los sockets que tenía cada proceso en el host:
== runc: socketpairs open: 500 | uname -r: 7.0.14-orbstack-00380-ga7e0a2dc9535
== runsc: socketpairs open: 500 | uname -r: 4.19.0-gvisor
== host processes running python /h.py
pid 1430: 1000 sockets
== gVisor Sentry on the host
pid 1490 gvisor_sentry: 8 sockets
Con runc, los 500 pares son 1000 sockets reales del kernel del host. Con runsc, el proceso de Python ni siquiera existe en el host y el Sentry solo mantiene 8 sockets propios. El probador pasó entero dentro de gVisor, y las dos imágenes que el perfil seccomp rompía funcionaron con runsc: PostgreSQL 18.6 aceptó consultas y nginx sirvió su página de bienvenida. Para usarlo en Docker, instala runsc desde la guía de instalación de gVisor[9] (el tarball gvisor.tar.zstd trae runsc, el shim de containerd y un directorio gvisor-bin) y registra el runtime:
{
  "runtimes": {
    "runsc": {
      "path": "/usr/local/bin/runsc",
      "runtimeArgs": ["--platform=systrap"]
    }
  }
}
Después, docker run --runtime=runsc aísla solo los contenedores que elijas. Usé la versión release-20260921.0 para arm64. runsc falló la primera vez con sidecar "gvisor_sentry" not usable porque solo había copiado el binario: el directorio gvisor-bin tiene que estar junto a él, en /usr/local/bin/gvisor-bin/.
gVisor en k3s con una RuntimeClass
k3s no detecta runsc por sí solo: su lista de runtimes automáticos incluye crun y los de NVIDIA, pero no gVisor. Se añade con una plantilla de containerd en /var/lib/rancher/k3s/agent/etc/containerd/config-v3.toml.tmpl, tal como describe la documentación avanzada de k3s[10]:
{{ template "base" . }}

[plugins.'io.containerd.cri.v1.runtime'.containerd.runtimes.'runsc']
  runtime_type = "io.containerd.runsc.v1"
Tras reiniciar k3s, una RuntimeClass con handler: runsc deja que cada pod elija gVisor con runtimeClassName:
apiVersion: node.k8s.io/v1
kind: RuntimeClass
metadata:
  name: gvisor
handler: runsc
En k3s v1.37.0+k3s1 con containerd 2.3.4, un pod con runtimeClassName: gvisor devolvió 4.19.0-gvisor en uname -r. gVisor no es gratis: añade coste a cada llamada al sistema y no todas las aplicaciones funcionan igual dentro. No he medido ese coste aquí; pruébalo con tu carga antes de moverla.
Máquinas virtuales ligeras para lo que no es de fiar
Puede que ejecutes código de terceros: runners de CI, sandboxes de agentes o clientes distintos en el mismo nodo. Para eso, DepthFirst recomienda dar a cada carga su propio kernel con Kata Containers o Firecracker. Ninguno lo he probado aquí: necesitan /dev/kvm y mi laboratorio no lo tiene.
En un servidor expuesto a internet, un fallo local como este se suma a cualquier intrusión en una aplicación. Filtrar ese primer paso con CrowdSec reduce la ventana, aunque no sustituye al parche.
Qué hago yo según el tipo de host
La decisión depende de quién puede ejecutar código en tus contenedores. Este es el orden que sigo:
- Comprueba el kernel en ejecución de cada host y nodo contra el tracker de tu distribución
- Si hay paquete corregido, instálalo y reinicia hoy; en un clúster, nodo a nodo con
drain - Si no lo hay y tus contenedores solo ejecutan software tuyo o de proveedores de confianza, el riesgo pasa por que alguien entre antes en una aplicación: vigila el tracker y parchea en cuanto salga
- Si ejecutas código no confiable, pásalo a gVisor ya, o a una microVM si puedes
- Si una carga concreta solo habla TCP y no puede ir a gVisor, prueba con ella el perfil seccomp sin AF_UNIX
Preguntas frecuentes
¿Me afecta CVE-2026-80521 si solo uso Docker Desktop en el Mac?
Docker Desktop y OrbStack ejecutan los contenedores en una máquina virtual Linux con su propio kernel. El escape llevaría al atacante a esa máquina virtual, no directamente a macOS. Mi laboratorio, en OrbStack, corre un 7.0.14, una rama afectada. Actualiza la aplicación cuando el fabricante publique un kernel corregido.
¿El seccomp por defecto de Docker o el RuntimeDefault de Kubernetes me protegen?
No. Los dos permiten crear sockets AF_UNIX y pasar descriptores con SCM_RIGHTS, que es todo lo que el fallo necesita. Lo comprobé en Docker 29.5.2 y en k3s v1.37.0.
¿Sirve de algo ejecutar el contenedor como usuario no root?
Frente a este fallo, no. El vector CVSS indica privilegios bajos y el probador pasó entero como usuario 1000 sin capabilities. Sigue siendo buena práctica para otros riesgos.
Conclusión
CVE-2026-80521 convierte cualquier contenedor en un posible camino a root del host mientras el kernel no esté corregido, y el exploit es público. La corrección es un kernel parcheado y un reinicio: Debian 13 lo tiene desde la DSA-6528-1, y en Ubuntu y RHEL toca vigilar el tracker. Mientras tanto, las medidas habituales de endurecimiento no cortan el camino. gVisor sí, sin romper las aplicaciones que probé, y un perfil seccomp sin AF_UNIX sirve para cargas concretas.
Empieza hoy por uname -r en cada host y cada nodo.