Cómo instalar Gatus con Docker, monitorización como código frente a Uptime Kuma
Índice de contenidos
- Puntos clave
- Qué es Gatus y en qué se diferencia de un monitor con interfaz
- Qué necesitas antes de empezar
- Cómo instalar Gatus con Docker Compose
- Cómo configurar la persistencia y la alerta
- Cómo definir los checks HTTP, TCP y de certificado
- Cómo vigilar SPF y DMARC con el nuevo check DNS TXT
- Cómo arrancar Gatus y comprobar que carga la configuración
- Qué pasa cuando un servicio cae
- Cómo validar la configuración antes de hacer commit
- Limitaciones que encontré en la prueba
- Gatus o Uptime Kuma: cuál elegir
- Preguntas frecuentes
- ¿Gatus puede usar PostgreSQL en lugar de SQLite?
- ¿Gatus reinicia los contenedores que fallan?
- ¿Puedo vigilar servicios que Gatus no alcanza por red?
- Conclusión
- Fuentes
Gatus es un monitor de disponibilidad autoalojado que se configura entero en YAML: cada servicio es un endpoint con condiciones, y la alerta salta cuando fallan tres seguidas. Esta guía lo instala con Docker Compose y la versión v5.37.0, publicada el 24 de septiembre de 2026, con persistencia en SQLite, checks HTTP, TCP, de certificado y el nuevo tipo DNS TXT, y un webhook que recibe las alertas. Todo lo ejecuté el 27 de septiembre de 2026, incluida una caída provocada de nginx. Al final tienes una comparación con Uptime Kuma y la versión en inglés de esta guía.
Puntos clave
- La imagen
ghcr.io/twin/gatus:v5.37.0ocupa 24,4 MB, tiene variante arm64 y no incluye shell: se configura solo con ficheros montados. - Si
GATUS_CONFIG_PATHapunta a un directorio, Gatus fusiona todos sus.yaml, así que puedes separar alertas, endpoints y DNS en ficheros distintos. - Sin
storage, el historial vive en memoria y se pierde al reiniciar; con SQLite en un volumen sobrevivió a reinicios y a un bucle de fallos. - Con checks cada 10 s y umbrales de 3 fallos y 2 éxitos, la alerta llegó a los 30,0 s de detener nginx y la resolución a los 19,9 s de arrancarlo (medianas de 5 rondas).
- Un error en el YAML recargado en caliente tumba el proceso con
panicy código de salida 2; valida la configuración antes de subirla. - Con cinco checks equivalentes, Gatus usó una mediana de 25 MiB de RAM y Uptime Kuma 2.5.5, 123 MiB, unas 5 veces más.
Qué es Gatus y en qué se diferencia de un monitor con interfaz
Gatus es un programa en Go que lanza peticiones a tus servicios cada cierto intervalo. Sobre cada respuesta evalúa condiciones: el código de estado, el cuerpo, el tiempo de respuesta, la IP o los días que le quedan al certificado. El README de Gatus[1] explica por qué hace falta junto a las métricas: "Neither of these can tell you that there’s a problem if there are no clients actively calling the endpoint". Si nadie llama a tu API, Prometheus no ve errores; Gatus sí, porque genera él mismo el tráfico.
La diferencia con Uptime Kuma está en dónde vive la configuración. En Uptime Kuma creas monitores con formularios y quedan en su base de datos. En Gatus no hay formulario: el panel es de solo lectura y todo sale de ficheros que puedes revisar en un pull request, copiar entre entornos y restaurar con git checkout.
Qué necesitas antes de empezar
La guía asume un servidor Linux con Docker Engine y el plugin de Compose. Yo lo probé en una VM Linux arm64 de 18 núcleos (OrbStack sobre Apple silicon) con Docker 29.5.2 y Compose v2.40.3, compartida con otros trabajos. Necesitas además:
- Salida a internet hacia
ghcr.iopara bajar la imagen - Acceso UDP al puerto 53 de un resolvedor público si vas a usar los checks DNS
- Un puerto libre para el panel; aquí uso el 8080 ligado a
127.0.0.1
Cómo instalar Gatus con Docker Compose
Crea un directorio con tres piezas: compose.yaml, una carpeta config/ con el YAML de Gatus y una carpeta hook/ con el receptor de alertas. Este compose.yaml levanta Gatus y tres servicios de prueba (nginx, Redis y el receptor):
services:
  gatus:
    image: ghcr.io/twin/gatus:v5.37.0
    restart: unless-stopped
    ports:
      - "127.0.0.1:8080:8080"
    environment:
      GATUS_CONFIG_PATH: /config
    volumes:
      - ./config:/config:ro
      - gatus-data:/data
  webapp:
    image: nginx:1.30.1-alpine
  cache:
    image: redis:8.6.3-alpine
  hook:
    image: python:3.12-alpine
    command: ["python", "-u", "/hook/receiver.py"]
    volumes:
      - ./hook:/hook:ro
volumes:
  gatus-data:
Monta la carpeta config/ entera y no un fichero suelto. El README avisa de que la recarga en caliente puede no detectar cambios si montas el fichero directamente, y con la carpeta montada puedes repartir la configuración en cuatro o más YAML. En mi laboratorio los nombres de contenedor llevaban un prefijo y el panel estaba en otro puerto porque el 8080 estaba ocupado; el resto es idéntico.
El receptor de alertas es un servidor HTTP de 20 líneas que imprime cada POST con la hora. Guárdalo como hook/receiver.py:
from datetime import datetime, timezone
from http.server import BaseHTTPRequestHandler, HTTPServer

class Hook(BaseHTTPRequestHandler):
    def do_POST(self):
        size = int(self.headers.get("Content-Length", 0))
        body = self.rfile.read(size).decode()
        now = datetime.now(timezone.utc).strftime("%H:%M:%S")
        print(f"{now} {body}")
        self.send_response(204)
        self.end_headers()

    def log_message(self, *args):
        pass

HTTPServer(("0.0.0.0", 9000), Hook).serve_forever()
Quería enviar las alertas a un servidor ntfy en Docker, pero Docker Hub devolvió 429 Too Many Requests al bajar su imagen durante la prueba. El proveedor ntfy de Gatus se configura con alerting.ntfy.url y alerting.ntfy.topic; ese camino no lo ejecuté.
Cómo configurar la persistencia y la alerta
El fichero config/config.yaml define dónde se guarda el historial y a quién se avisa. Sin el bloque storage, Gatus usa memoria y pierde resultados y eventos en cada reinicio:
storage:
  type: sqlite
  path: /data/gatus.db

alerting:
  custom:
    url: "http://hook:9000/gatus"
    method: "POST"
    body: |
      {"state": "[ALERT_TRIGGERED_OR_RESOLVED]",
       "endpoint": "[ENDPOINT_GROUP]/[ENDPOINT_NAME]",
       "errors": "[RESULT_ERRORS]"}
    default-alert:
      failure-threshold: 3
      success-threshold: 2
      send-on-resolved: true
El proveedor custom hace una petición HTTP a la URL que quieras y sustituye los marcadores entre corchetes. default-alert evita repetir umbrales en cada endpoint: tres fallos seguidos abren la incidencia y dos éxitos la cierran. Los dos primeros valores coinciden con los de fábrica, pero send-on-resolved viene desactivado y sin él no recibes el aviso de recuperación.
Al arrancar, el registro lista los proveedores configurados y los ignorados. En v5.37.0 salieron custom y otros 40, entre ellos Slack, Telegram, ntfy, Matrix, PagerDuty y Gotify.
Cómo definir los checks HTTP, TCP y de certificado
Cada endpoint tiene una URL, un intervalo y una lista de condiciones. Si falla una sola, Gatus lo marca como caído. Guarda esto como config/endpoints.yaml:
endpoints:
  - name: webapp
    group: interno
    url: "http://webapp/"
    interval: 10s
    conditions:
      - "[STATUS] == 200"
      - "[BODY] == pat(*Welcome to nginx*)"
      - "[RESPONSE_TIME] < 500"
    alerts:
      - type: custom
        description: "nginx no responde"
  - name: redis
    group: interno
    url: "tcp://cache:6379"
    interval: 30s
    conditions:
      - "[CONNECTED] == true"
  - name: jacar-tls
    group: externo
    url: "https://jacar.es/"
    interval: 1h
    conditions:
      - "[STATUS] == 200"
      - "[CERTIFICATE_EXPIRATION] > 336h"
El check webapp comprueba el código, que el cuerpo contenga el texto de bienvenida de nginx y que la respuesta tarde menos de 500 ms. El prefijo tcp:// convierte redis en una prueba de conexión: [CONNECTED] == true solo garantiza que algo escucha en el puerto, no que Redis responda bien. El tercero falla si al certificado le quedan menos de 14 días (336 horas); el de jacar.es caduca el 10 de diciembre de 2026.
Solo webapp lleva alerts. Un endpoint sin esa lista aparece en el panel pero no avisa, aunque exista un default-alert.
Cómo vigilar SPF y DMARC con el nuevo check DNS TXT
La v5.37.0 añade TXT a los tipos de consulta DNS, según las notas de la versión 5.37.0[2] (PR #1679). Sirve para detectar que alguien ha borrado o cambiado el registro SPF o la política DMARC de tu dominio. Ese fallo no rompe ninguna web: lo descubres cuando tus correos acaban en spam. Guarda esto como config/dns.yaml:
endpoints:
  - name: spf
    group: correo
    url: "1.1.1.1"
    interval: 15m
    dns:
      query-name: "jacar.es"
      query-type: "TXT"
    conditions:
      - "[DNS_RCODE] == NOERROR"
      - "[BODY] == pat(*v=spf1 *-all*)"
  - name: dmarc
    group: correo
    url: "1.1.1.1"
    interval: 15m
    dns:
      query-name: "_dmarc.jacar.es"
      query-type: "TXT"
    conditions:
      - "[DNS_RCODE] == NOERROR"
      - "[BODY] == pat(v=DMARC1; p=reject*)"
La url de un check DNS es el resolvedor, no el dominio. Un dominio puede tener más de un registro TXT: jacar.es tiene cuatro, tres de verificación de Google y el SPF. Leyendo el código del cliente DNS de Gatus[3] comprobé que v5.37.0 une todas las respuestas TXT con un salto de línea en [BODY]. Por eso el patrón SPF empieza y acaba con *: sin el primero, el check fallaría por el orden de las respuestas.
Ese mismo código muestra una diferencia con los demás tipos: para A, MX o NS, [BODY] guarda solo la última respuesta. Si un dominio tiene dos registros A, una condición [BODY] == 203.0.113.10 puede fallar según el orden en que conteste el resolvedor.
Cómo arrancar Gatus y comprobar que carga la configuración
Levanta el stack desde el directorio del proyecto y mira el registro de Gatus:
docker compose up -d
docker compose logs gatus | grep -E "Reading|Validated|success"
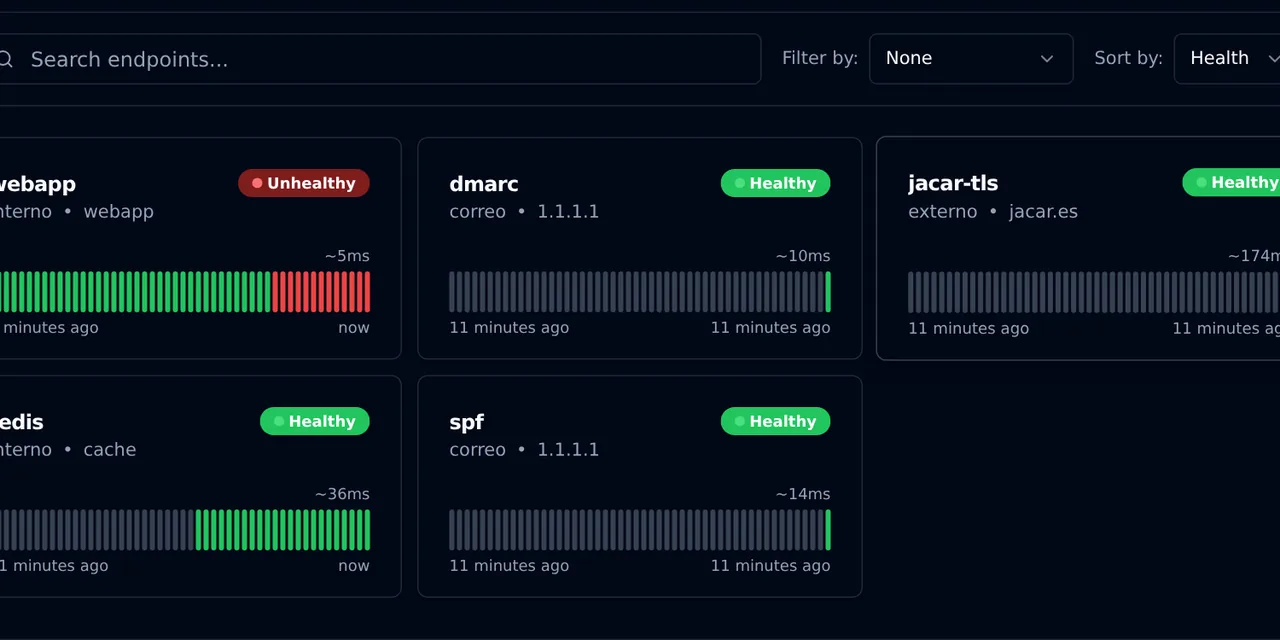
En mi arranque aparecieron las tres lecturas de fichero, Validated 5 endpoints y una línea por check con success=true, salvo una que explico en las limitaciones. El panel queda en http://127.0.0.1:8080 y la API en /api/v1/endpoints/statuses, que devuelve cada resultado con sus condiciones evaluadas.
Para probar la recarga en caliente, edité endpoints.yaml con Gatus en marcha. Gatus revisa los ficheros cada 30 s, así que un cambio tarda hasta 30 s en aplicarse. En cinco pruebas, Configuration file has been modified apareció entre 10,3 y 14,1 s después de guardar (mediana 14,0 s). El servicio volvió en 1,0 s, sin reiniciar el contenedor.
Luego reinicié el contenedor con docker compose restart gatus: el endpoint webapp conservó sus 19 resultados y sus 4 eventos, que siguen en gatus.db dentro del volumen.
Qué pasa cuando un servicio cae
Para ver el ciclo completo detuve nginx con docker stop y lo volví a arrancar cinco veces, con una media de carga de 1 minuto por debajo de 1,7. La alerta llegó en una mediana de 30,0 s (entre 28,7 y 30,0 s) y el aviso de resolución, 19,9 s después de arrancar nginx. Estas líneas son las que imprimió el receptor en la primera ronda:
17:58:02 {"state": "TRIGGERED",
 "endpoint": "interno/webapp",
 "errors": "Get \"http://webapp/\": dial tcp: lookup webapp
 on 127.0.0.11:53: no such host"}
17:58:22 {"state": "RESOLVED",
 "endpoint": "interno/webapp",
 "errors": ""}
El error no es un timeout sino no such host: al detener el contenedor, el DNS interno de Docker deja de resolver su nombre. Esos tiempos los fijan el intervalo y los umbrales, no la máquina. La alerta sale con el tercer check fallido, entre 20 y 30 s después de la caída según en qué punto del intervalo ocurra, y la resolución con el segundo check correcto.
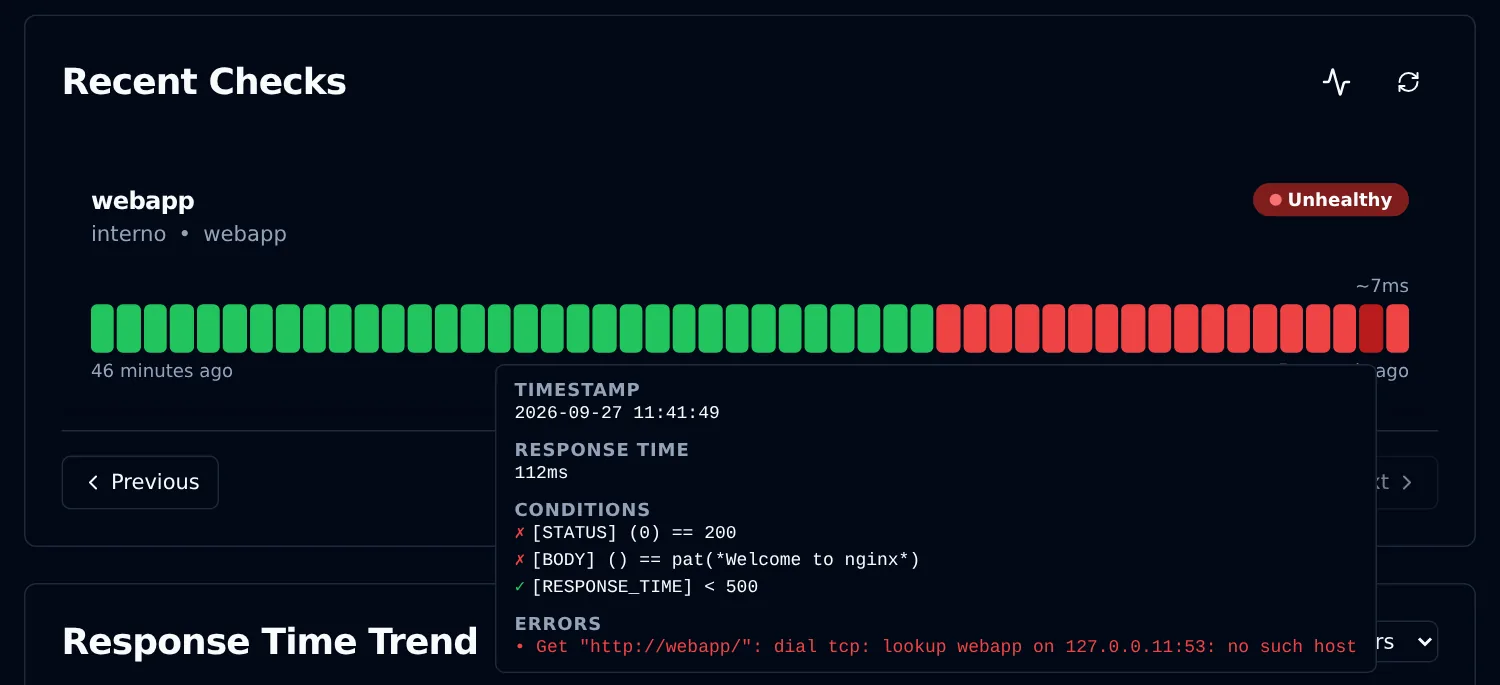
En el panel, cada barra es un check. Al pasar el ratón por una roja, Gatus enseña qué condición falló y con qué valor: [STATUS] (0) == 200 indica que no hubo respuesta HTTP.
Cómo validar la configuración antes de hacer commit
Un error en un fichero recargado en caliente no se queda en un aviso. Cambié TXT por TXTX a propósito y Gatus terminó con este mensaje y código de salida 2:
panic: error parsing config: invalid endpoint correo_spf:
invalid query type in the DNS configuration
Con restart: unless-stopped, Docker lo reinició ocho veces en bucle hasta que corregí el fichero. El historial sobrevivió porque estaba en SQLite, pero el panel y las alertas estuvieron caídos todo ese tiempo. El README ofrece skip-invalid-config-update: true para seguir con la configuración anterior, aunque advierte de que entonces el siguiente reinicio falla igual.
La imagen no trae un comando de validación, así que uso el propio arranque como prueba. Este comando lanza Gatus sin red y con /data en memoria durante 8 s:
timeout 8 docker run --rm --network none --tmpfs /data \
  -e GATUS_CONFIG_PATH=/config -v "$PWD/config:/config:ro" \
  ghcr.io/twin/gatus:v5.37.0 >/dev/null 2>&1
echo $?
Con una configuración válida devuelve 124, porque timeout corta un proceso que seguía vivo; con la errónea devuelve 2. --network none impide que la prueba envíe alertas reales, y --tmpfs /data hace falta porque sin él SQLite no puede crear la base y el arranque falla con unable to open database file (14). Ponlo en un hook de pre-commit o en tu CI y el YAML roto no llegará al servidor.
Limitaciones que encontré en la prueba
Tres cosas no funcionaron como esperaba o merecen aviso antes de usar Gatus en producción:
- Caducidad de dominios .es: la condición
[DOMAIN_EXPIRATION] > 720hsobre jacar.es se resolvió a-2562047h47m16sy marcó el endpoint como caído. Gatus consulta RDAP y, si no hay, WHOIS; el registro de RDAP de IANA[4] no incluye.es. Quité la condición; con dominios.comu.orgsí hay RDAP. - Panel abierto: la sección
securityestá vacía por defecto, así que cualquiera que llegue al puerto ve tus servicios y sus URL. Configurasecurity.basiccon un hash bcrypt osecurity.oidc, o pon Gatus detrás de un proxy con autenticación. - Un solo punto de vista: si cae el servidor donde corre Gatus, nadie te avisa. Ejecútalo en una máquina distinta de lo que vigila.
Gatus o Uptime Kuma: cuál elegir
Los dos vigilan disponibilidad y envían alertas; cambian el modo de trabajo y el consumo. Para medir la memoria monté Uptime Kuma 2.5.5 en la misma red con los mismos cinco checks: keyword HTTP, puerto TCP, HTTPS y dos consultas DNS TXT. Reinicié los dos contenedores, esperé 5 minutos y tomé 12 muestras con docker stats, una cada 30 s:
| Criterio | Gatus v5.37.0 | Uptime Kuma 2.5.5 |
|---|---|---|
| Configuración | Ficheros YAML | Formularios web |
| Versionar en git | Directo | Copiar la base de datos |
| Imagen local (arm64) | 24,4 MB | 602,8 MB |
| RAM mediana, 5 checks | 25 MiB (11 a 35) | 123 MiB (115 a 146) |
| Intervalo mínimo | Sin mínimo fijo | 20 s |
| Canales de alerta | 41 proveedores | Más de 90 servicios |
| Condiciones sobre la respuesta | Cuerpo, JSONPath, IP, tiempo | Palabra clave, JSON, condiciones DNS |
| Páginas de estado | El propio panel | Una o más, con dominio propio |
La media de carga de 1 minuto estuvo entre 0,3 y 1,5 durante las muestras. La memoria de Gatus salta entre dos niveles, de 11 a 17 MiB y de 32 a 35 MiB, y su mediana queda entre ambos. Aun así, Uptime Kuma usó unas 5 veces más. Las cifras de canales y el intervalo de Uptime Kuma salen de su README en GitHub[5].
Elige Gatus si ya gestionas la infraestructura como código, quieres revisar cada cambio de monitorización en un pull request o necesitas condiciones sobre el cuerpo de una API. Elige Uptime Kuma si otras personas van a añadir monitores sin tocar ficheros, o si quieres páginas de estado públicas con dominio propio. Para métricas de CPU y disco de los servidores, ninguno de los dos basta: combínalo con Beszel en Docker o con Prometheus en Docker.
Preguntas frecuentes
¿Gatus puede usar PostgreSQL en lugar de SQLite?
Sí. Cambia storage.type a postgres y pon en storage.path la URL de conexión, del tipo postgres://usuario:clave@host:5432/gatus. La v5.36.0 añadió índices que, según sus notas, mejoran unas 15 veces el rendimiento en PostgreSQL.
¿Gatus reinicia los contenedores que fallan?
No. Gatus observa y avisa, pero no actúa sobre Docker. Para reinicios automáticos usa los healthchecks y políticas de reinicio de Docker Compose, o apunta una alerta custom a un servicio tuyo que haga el reinicio.
¿Puedo vigilar servicios que Gatus no alcanza por red?
Sí, con external-endpoints: el servicio remoto envía su resultado a la API de Gatus con un token, en lugar de que Gatus lo consulte.
Conclusión
Gatus v5.37.0 cabe en una imagen de 24,4 MB, se configura con cuatro ficheros YAML y en mi prueba detectó y resolvió una caída real con alertas por webhook. El nuevo check DNS TXT cubre un hueco que casi ningún monitor vigila, el de los registros SPF y DMARC. A cambio, un YAML roto tumba el proceso y la caducidad de dominios .es no funciona.
El siguiente paso es meter la carpeta config/ en git, añadir la validación con timeout a tu CI y cambiar el webhook de prueba por un canal real, como un servidor ntfy o Telegram.
Fuentes: [1] Notas de Gatus v5.37.0[2], [2] README de Gatus[1], [3] Cliente DNS de Gatus en v5.37.0[3], [4] Registro RDAP de IANA para dominios[4], [5] Versiones de Uptime Kuma[6], [6] README de Uptime Kuma[5].
Fuentes
Código fuente
Accede a todo el código fuente de este artículo en GitHub.
Ver en GitHub