Ollama 0.40 usa MLX por defecto en Mac: qué cambia y cómo comprobarlo
Índice de contenidos
- Puntos clave
- Qué cambia en Ollama 0.40 en un Mac
- Cómo elige Ollama entre MLX y llama.cpp
- Cómo comprobar qué motor usa cada modelo
- Qué cambia si ya usabas oMLX o LM Studio
- Qué no he probado
- Preguntas frecuentes
- ¿Tengo que volver a descargar mis modelos para usar MLX?
- ¿Puedo seguir usando llama.cpp en un Mac?
- ¿Ollama 0.40 usa MLX en Linux con una GPU de NVIDIA?
- Conclusión
- Fuentes
Ollama 0.40, publicado el 25 de septiembre de 2026, ejecuta con MLX por defecto los modelos de arquitectura compatible en los Mac con Apple Silicon, en lugar de con llama.cpp. MLX es el framework de Apple para aprendizaje automático en sus chips, el mismo que usan oMLX y LM Studio para exprimir la memoria unificada. He leído el código de la versión 0.40.0 para ver cómo decide Ollama qué motor usar, y lo he probado en Linux con Docker para ver qué pasa fuera de un Mac. No he podido medir velocidades en un Mac para este artículo. Hay una versión en inglés.
Puntos clave
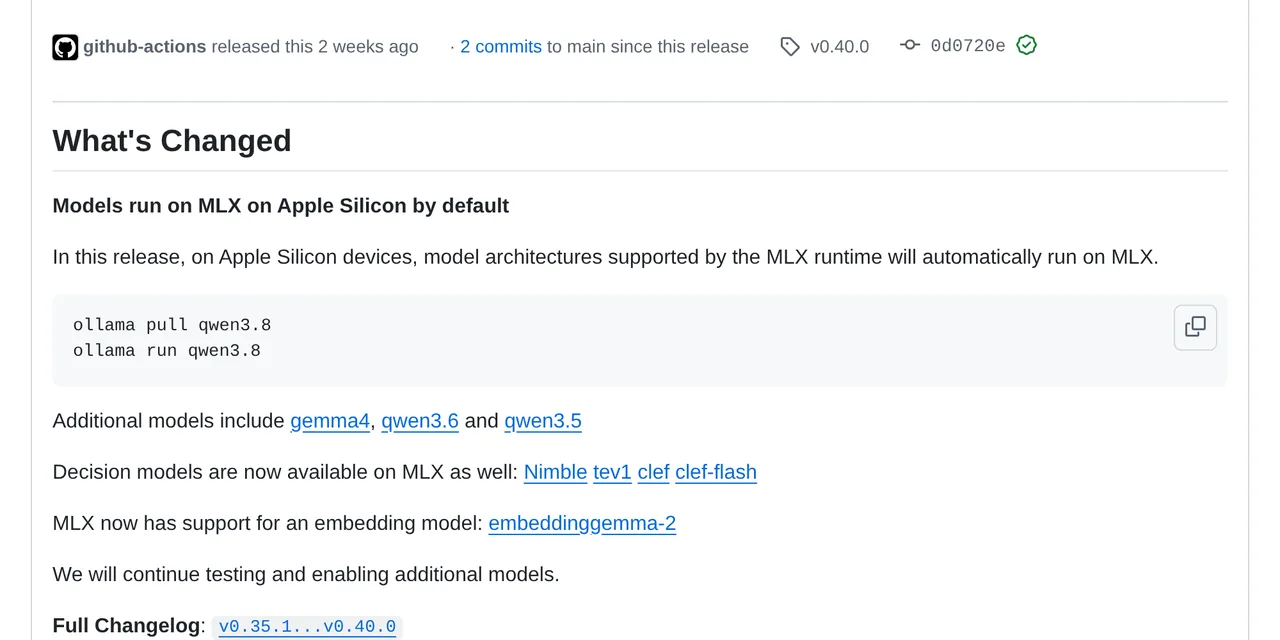
- Las notas de la 0.40.0 lo dicen así: "on Apple Silicon devices, model architectures supported by the MLX runtime will automatically run on MLX."
- Los modelos con variante MLX en esa versión son qwen3.8, gemma4, qwen3.6, qwen3.5, los modelos de decisión Nimble, tev1, Clef y Clef-flash, y el modelo de embeddings embeddinggemma-2.
- El motor se elige al descargar: cada modelo publica una lista de variantes, y en macOS arm64 Ollama prefiere
mlx, luegollamacppy luegoggml. En el resto de sistemas el orden es el inverso. ollama pstiene una columna nueva, RUNNER, que muestra qué motor sirve cada modelo cargado. En Linux mostróllamacpp.- Forzar MLX en Linux con la opción oculta
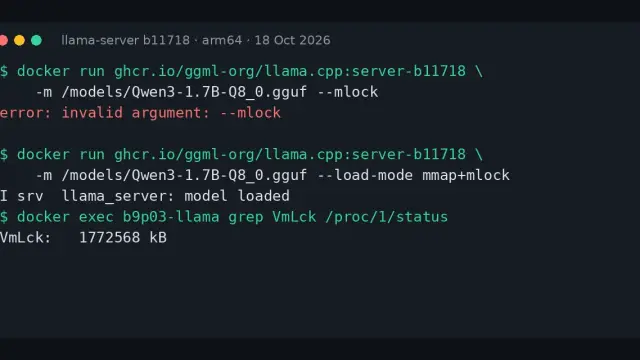
--runner mlxfalló con "this model requires MLX support, but the MLX runtime is not available".
Qué cambia en Ollama 0.40 en un Mac
Hasta la 0.40, Ollama ejecutaba todos los modelos con llama.cpp, que en un Mac usa Metal pero trabaja con ficheros GGUF. Con MLX, los modelos compatibles se ejecutan en formato safetensors sobre el motor de Apple, como lo hacen oMLX o mlx-lm.
En el código de la 0.40.0, un modelo es MLX cuando su formato es safetensors: la función IsMLX() de server/images.go solo comprueba eso. Los GGUF siguen yendo por llama.cpp, también en un Mac. Por eso el cambio no afecta a cualquier modelo, solo a los que Ollama publica con una variante MLX en su biblioteca.
Para quien ya usa Ollama, el cambio es transparente en los comandos: ollama pull qwen3.8 y ollama run qwen3.8 son los mismos que antes. Lo que cambia es el fichero que se descarga y el motor que lo sirve.
Cómo elige Ollama entre MLX y llama.cpp
Cada modelo con soporte MLX se publica como una lista de manifiestos, una variante por motor. Al descargar, Ollama recorre una lista de preferencias y se queda con la primera variante disponible. La función runnerPreferences() de manifest/manifest.go lo resuelve así:
func runnerPreferences() []string {
    if runtime.GOOS == "darwin" && runtime.GOARCH == "arm64" {
        return []string{RunnerMLX, RunnerLlamaCPP, RunnerGGML}
    }
    return []string{RunnerLlamaCPP, RunnerGGML, RunnerMLX}
}
En un Mac con Apple Silicon gana MLX si existe la variante; si no, llama.cpp. En Linux y Windows gana llama.cpp, y MLX queda como último recurso para modelos que solo existan en safetensors. La guía de desarrollo de la 0.40 explica que MLX puede compilarse fuera de macOS con CUDA 13 mediante OLLAMA_MLX_BACKENDS, pero los binarios publicados para Linux no lo traen.
Las órdenes ollama pull y ollama run aceptan una opción --runner (con los valores mlx, ggml y llamacpp) para forzar una variante. Está marcada como oculta en el código, así que no aparece en --help y puede cambiar sin aviso.
Cómo comprobar qué motor usa cada modelo
ollama ps lista los modelos cargados en memoria, y en la 0.40 añade la columna RUNNER. Lo comprobé en Linux, dentro de la imagen ollama/ollama:0.40.0, con el modelo qwen3.5 de 0,8B:
$ ollama ps
NAME          ID            SIZE    PROCESSOR  CONTEXT  RUNNER    UNTIL
qwen3.5:0.8b  de63045f2975  829 MB  100% CPU   4096     llamacpp  4 minutes
                                                                  from now
En un Mac con un modelo compatible, esa columna debería mostrar mlx. Después intenté forzar la variante MLX en Linux:
ollama pull --runner mlx qwen3.5:0.8b
# Error: this model requires MLX support,
# but the MLX runtime is not available
El error confirma que la variante existe en el registro y que el binario de Linux no trae el motor MLX. La API también expone el motor: las peticiones de pull, show, generate, chat y embed admiten un campo runner para elegir variante.
Qué cambia si ya usabas oMLX o LM Studio
Si ya servías modelos MLX en tu Mac con oMLX o LM Studio, Ollama 0.40 no te obliga a cambiar nada, pero cambia el reparto:
| Ollama 0.40 | oMLX | |
|---|---|---|
| Motor en Apple Silicon | MLX para los modelos con variante MLX; llama.cpp para el resto | MLX para todo |
| Catálogo | Biblioteca de Ollama, con lista de variantes | Cualquier repositorio MLX de Hugging Face |
| Modelos de decisión | Sí, con /v1/systemone |
No |
| Ajustes de MLX | Los decide Ollama | Panel propio con caché, TTL y decodificación especulativa |
| Mismo flujo en Linux y Mac | Sí, con llama.cpp fuera del Mac | Solo macOS |
La ventaja de Ollama es que el mismo comando funciona en tu Mac y en un servidor Linux, y elige el mejor motor en cada sitio. La de oMLX es el control: puedes ajustar la memoria, la caché en disco y los modelos de borrador, como explico en la guía para instalar oMLX en un M5 Max.
Qué no he probado
Este artículo se basa en las notas de la versión, en el código de la etiqueta v0.40.0 y en una prueba en Linux. No he medido en un Mac cuánto más rápido genera un modelo con MLX frente a llama.cpp, ni el consumo de memoria de cada variante. Antes de cambiar tu flujo, compara tú mismo un modelo con --runner mlx y --runner llamacpp en tu equipo y mira la columna RUNNER de ollama ps.
Preguntas frecuentes
¿Tengo que volver a descargar mis modelos para usar MLX?
Sí, si quieres la variante MLX. Los modelos descargados antes de la 0.40 son GGUF y seguirán funcionando con llama.cpp. Al hacer ollama pull de nuevo en un Mac con Apple Silicon, Ollama elegirá la variante MLX si el modelo la tiene.
¿Puedo seguir usando llama.cpp en un Mac?
Sí. La opción oculta --runner llamacpp de ollama pull y ollama run fuerza la variante de llama.cpp, y los modelos sin variante MLX siguen usando llama.cpp de todas formas.
¿Ollama 0.40 usa MLX en Linux con una GPU de NVIDIA?
No con los binarios publicados. La guía de desarrollo explica cómo compilar MLX con CUDA 13, pero en Linux la preferencia por defecto sigue siendo llama.cpp.
Conclusión
Ollama 0.40 no cambia cómo usas Ollama, cambia qué ejecuta por debajo en un Mac: los modelos con variante MLX se descargan en safetensors y corren sobre el motor de Apple. La columna RUNNER de ollama ps es la forma más directa de saber qué motor tienes delante.
El siguiente paso, si tienes un Mac con Apple Silicon, es actualizar a la 0.40, volver a descargar un modelo compatible como qwen3.8 y comparar su velocidad con la variante de llama.cpp en tu propio equipo.
Fuentes: [1] Ollama v0.40.0, notas de la versión[1], [2] Selección de variante en manifest.go[2], [3] Guía de desarrollo de Ollama, motor MLX[3], [4] MLX de Apple[4], [5] Imagen ollama/ollama en Docker Hub[5].
Fuentes
Código fuente
Accede a todo el código fuente de este artículo en GitHub.
Ver en GitHub