Qué es Colibri y cómo ejecuta modelos MoE gigantes leyendo expertos del disco
Índice de contenidos
- Puntos clave
- Qué es Colibri y quién lo desarrolla
- Por qué un modelo MoE se puede leer desde el disco
- Qué pasa a ser el cuello de botella cuando los expertos están en el SSD
- En qué se diferencia de FreeToken, llama.cpp y oMLX
- Qué velocidad esperar y para qué sirve
- Instalación y primera ejecución en Linux ARM64
- Qué pasa al obligarle a leer los expertos del disco
- Límites y riesgos antes de dedicarle un SSD
- Preguntas frecuentes
- ¿Necesito una GPU para usar Colibri?
- ¿Colibri puede cargar modelos GGUF de llama.cpp?
- ¿Leer expertos del disco a todas horas estropea el SSD?
- Conclusión
- Fuentes
GLM-5.2 ocupa unos 370 GB en disco y Colibri nació ejecutándolo en un portátil de 12 núcleos con 25 GB de RAM. Lo consigue sin comprimir el modelo hasta que quepa, porque no lo carga entero. El motor deja en memoria la parte que cada token usa siempre y lee del SSD, bajo demanda, los expertos que el router elige. Este artículo explica por qué esa idea funciona con los modelos Mixture-of-Experts (MoE), en qué se diferencia de FreeToken, llama.cpp y oMLX, qué velocidad publica el proyecto y qué medimos al compilar la versión 1.11.0 en una máquina ARM64 sin GPU. La versión en inglés está en /en/colibri-giant-moe-models-from-disk/.
Puntos clave
- Colibri es un motor de inferencia en C con licencia Apache 2.0, creado por Vincenzo Fornaro (JustVugg). La versión 1.11.0 salió el 13 de septiembre de 2026 y el repositorio suma 31 868 estrellas en diez semanas.
- Funciona porque un MoE activa poco de lo que tiene: GLM-5.2 usa 8 de sus 256 expertos por capa, unos 11 GB de expertos por token de los 370 GB totales.
- Con los expertos en disco, la velocidad la marcan el ancho de banda del SSD, la caché de página y la tasa de acierto de la caché de expertos. Con un NVMe PCIe 5.0, el límite vuelve a ser la CPU.
- Las cifras que publica el proyecto para GLM-5.2 van de 0,05 tok/s en un portátil de 25 GB a 6,8 tok/s con seis RTX 5090: sirve para trabajos por lotes, no para conversar.
- En nuestra prueba con OLMoE, recortar la caché de 64 a 8 expertos por capa y forzar la lectura del disco bajó la mediana de 2,84 a 1,52 tok/s; con el disco limitado a 300 MiB/s, de 1,25 a 0,35 tok/s.
- Antes de adoptarlo, pesa tres riesgos: contenedores de pesos que solo lee Colibri, ocho avisos de seguridad publicados en agosto y un proyecto de diez semanas cuyas fusiones pasan casi todas por su autor.
Qué es Colibri y quién lo desarrolla
Colibri es un motor de inferencia para modelos Mixture-of-Experts escrito en C, sin dependencias externas en el motor y con licencia Apache 2.0. Lo firma el usuario de GitHub JustVugg, cuyo perfil lo identifica como Vincenzo Fornaro, fundador del proyecto. El autor lo escribe «colibrì», con acento italiano; en el repositorio y en la línea de comandos es colibri.
El historial de Git fecha el primer commit el 1 de julio de 2026 y el primer motor, para GLM-5.2, el 5 de julio. La versión 1.0.0 se etiquetó el 19 de julio y la 1.11.0 el 13 de septiembre, diecisiete versiones en ocho semanas. El 14 de septiembre la página de GitHub marcaba 31 868 estrellas y 3 378 bifurcaciones.
La arquitectura del código es poco habitual: un fichero C por familia de modelos (colibri.c para GLM-5.2, kimi_k3.c, olmoe.c…) sobre cabeceras compartidas para el lector de safetensors, el tokenizador y la caché de expertos. Por encima hay un lanzador en Python, coli, con las órdenes chat, serve, web, doctor, plan y tune. Python solo interviene en ese lanzador, en la conversión de pesos y en la pasarela HTTP; la inferencia es C puro con OpenMP.
El README declara nueve familias: GLM-5.2 y 5.3, GLM-5.3-Flash, Inkling, Kimi K3, DeepSeek V4 Flash y V4.1 Flash, Qwen3.8-Flash-Next, Qwen3.6 y OLMoE. Su promesa de diseño cabe en una frase del propio README: «there is no SLA on speed, and a hard guarantee on semantics». Traducido a la práctica, colocar un experto en disco o en VRAM puede cambiar la velocidad, pero no la precisión de los pesos ni las decisiones del router.
Por qué un modelo MoE se puede leer desde el disco
Un modelo MoE sustituye la capa de avance de cada bloque por un conjunto de redes pequeñas, los expertos, y un router que elige unas pocas para cada token. Los parámetros totales miden lo que ocupa el modelo; los activos, lo que calcula en cada paso. Si ya conoces cómo funciona Mixtral 8x22B, el principio es el mismo con 256 expertos por capa en lugar de 8. Estas son las cifras de los ficheros config.json y del recuento de tensores de Hugging Face:
| Modelo | Parámetros totales | Capas | Expertos por capa | Expertos por token |
|---|---|---|---|---|
| GLM-5.2 (Z.ai) | 753 300 millones | 78 (75 MoE) | 256 + 1 compartido | 8 |
| Kimi K3 (Moonshot AI) | 2,78 billones | 93 (92 MoE) | 896 + 2 compartidos | 16 |
| DeepSeek V4 Flash | 290 900 millones | 43 | 256 + 1 compartido | 6 |
| OLMoE 1B-7B 0125 (Ai2) | 6 919 millones | 16 | 64 | 8 |
Con GLM-5.2 la cuenta sale así. Cada experto tiene tres matrices de 6 144 × 2 048, es decir, 37,7 millones de parámetros, que en int4 con escalas por grupos de 64 ocupan unos 19 MB. Un token pasa por 75 capas MoE y en cada una usa 8 expertos: 600 expertos, unos 11,3 GB. El modelo tiene 19 456 expertos en total (incluida la capa de predicción multitoken), unos 370 GB.
La diferencia entre los 753 300 millones de Hugging Face y los 744 000 millones que cita Colibri es esa última capa: 256 expertos de 37,7 millones suman 9 660 millones. La parte densa (atención, experto compartido y embeddings) ronda los 17 000 millones de parámetros y se queda residente en RAM, 9,9 GB en int4. El resto no necesita caber en memoria: necesita un sitio desde el que llegar a tiempo.
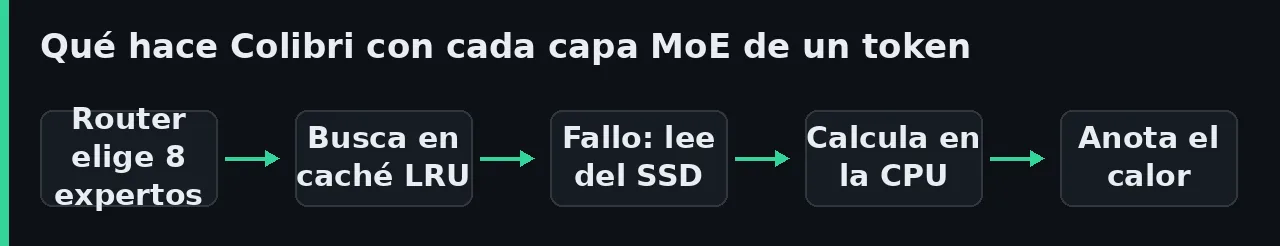
Que funcione depende de que el enrutado no sea aleatorio. Colibri registra en un fichero .coli_usage qué expertos elige tu carga de trabajo y fija en RAM los más usados. Además aplica el router de la capa siguiente sobre el estado de la actual para adelantar lecturas. Según su guía de ajuste, ese truco acierta el 71,6 % de los expertos de la capa siguiente en GLM-5.2.
Qué pasa a ser el cuello de botella cuando los expertos están en el SSD
Cuando los expertos viven en disco, la decodificación queda limitada por los bytes que puedes leer por segundo. Una fila de las pruebas de la comunidad lo muestra: un i9-12900K con 64 GB y un Samsung 990 Pro leía unos 9,9 GB por token de GLM-5.2. Repartía el tiempo en un 48 % de disco, un 34 % de multiplicación de matrices y un 12 % de atención.
Hay tres palancas, y conviene medirlas por separado:
- Ancho de banda de lectura: en un Ryzen 9 9950X con 123 GB, pasar el modelo de un SSD QLC PCIe 3.0 (1,51 GB/s con caché) a un Samsung 9100 PRO PCIe 5.0 (8,81 GB/s con
O_DIRECT) subió la velocidad de 0,10 a 0,28 tok/s. El perfil pasó de un 66 % de tiempo en disco a un 57 % de cálculo - Caché de página: Linux guarda en RAM las páginas leídas, así que la memoria libre funciona como un nivel más. El modo
DIRECT=1(O_DIRECT) se salta esa caché; el README cita un 34 % más de decodificación en un equipo Blackwell con Windows, y avisa de que en discos QLC o virtuales puede empeorar - Localidad del enrutado: la tasa de acierto de la caché de expertos. Con dos NVMe en controladoras independientes y el modo espejo de Colibri, un Threadripper PRO 7965WX pasó de 0,80 a 1,10 tok/s, un 37,5 % más
La consecuencia práctica es que la RAM sigue importando, aunque de otra manera. Cada gigabyte que no ocupan los pesos densos ni la caché KV es un gigabyte de expertos que no hay que volver a leer. En la sección de DeepSeek V4 Flash, el README llama a --ram «the single most valuable knob». Aun así, una prueba en un M1 Max con 64 GB fue más lenta con más RAM asignada, así que mide en tu equipo.
En qué se diferencia de FreeToken, llama.cpp y oMLX
Los cuatro sacan parte del trabajo de la memoria rápida, pero solo Colibri trata el SSD como un nivel para los pesos de los expertos, con caché y prefetch guiados por el enrutado. El motor FreeToken, que analizamos en agosto, reparte los expertos entre GPU, CPU y RAM del sistema según el ancho de banda que mide en cada paso. En llama.cpp, el sistema operativo pagina los pesos con mmap. Y oMLX usa el SSD para la caché KV, no para los pesos.
| Criterio | Colibri 1.11.0 | FreeToken 0.1.2 | llama.cpp | oMLX |
|---|---|---|---|---|
| Dónde viven los expertos que no caben | SSD, con caché LRU y fijados en RAM | RAM del sistema; la GPU cachea los calientes | Donde los pagine mmap, o en CPU con --cpu-moe |
Tienen que caber en memoria unificada |
| Quién decide la ubicación | Calor de enrutado medido y prefetch una capa por delante | Ancho de banda medido en cada paso | Fija al cargar (-ot, --n-cpu-moe) |
No aplica a los pesos |
| Para qué usa el SSD | Pesos de los expertos | No como nivel de pesos | Implícito, vía mmap | Bloques fríos de caché KV |
| Hardware | CPU x86 y ARM, CUDA, Metal, Vulkan | GPU NVIDIA RTX 30, 40 y 50 | CPU, CUDA, Metal, Vulkan, SYCL y más | Apple Silicon |
| Formato de pesos | Contenedores propios o checkpoint original, según familia | Checkpoints de Hugging Face y formato FTW | GGUF | MLX |
| Versión de referencia | 1.11.0, 13 de septiembre de 2026 | 0.1.2, 19 de agosto de 2026 | Rama principal | 0.6.4 |
La elección depende de dónde tengas la memoria. Si el modelo cabe en RAM, FreeToken o llama.cpp sacan más tokens por segundo, porque no pagan lecturas. Si tienes un Mac y el modelo cabe en memoria unificada, oMLX es la opción cómoda. Colibri tiene sentido cuando el modelo no cabe en ninguna memoria de tu equipo y aceptas que el disco marque el ritmo.
Qué velocidad esperar y para qué sirve
Las cifras de GLM-5.2 que publica el proyecto van de 0,05 a 6,8 tokens por segundo, y la diferencia es el hardware, no el motor. Todas proceden del README y de la tabla de pruebas de la comunidad; no las hemos reproducido:
| Máquina, según el proyecto | Configuración | Decodificación |
|---|---|---|
| 6 × RTX 5090, 2 Xeon Silver 4510, 251 GB | Todos los expertos en VRAM y RAM | 5,8–6,8 tok/s |
| Ryzen AI Max+ 395, 128 GB, NVMe PCIe 4.0 | Solo CPU, caché aprendida | 1,83 tok/s |
| Core Ultra 9 185H, 32 GB, QLC, RTX 5070 Ti | Tubería residente en GPU | 1,07 tok/s |
| Equipo de desarrollo, 25 GB, disco WSL2 a ~1 GB/s | En frío, todo desde disco | 0,05–0,1 tok/s |
| Apple M3, 16 GB (OLMoE int8, no GLM-5.2) | Solo CPU | 3,69–4,18 tok/s |
Pasado a tiempos, una respuesta de 500 tokens tarda 83 minutos a 0,1 tok/s, 8 minutos a 1 tok/s y 83 segundos a 6 tok/s. A eso hay que sumar el procesado del prompt: en DeepSeek V4 Flash el proyecto midió 90 s para un prompt de 3 324 tokens con una RTX 5080. Eso descarta los agentes con bucles largos de herramientas y la conversación fluida en el hardware de casa.
Lo que sí encaja son los trabajos que puedes dejar corriendo por la noche. Por ejemplo, resumir o clasificar un lote de documentos, revisar código sin enviarlo a una API o evaluar un modelo abierto de frontera antes de pagar su hardware. Para el día a día con un modelo que quepa en tu máquina, la calculadora de modelos para tu propio equipo te dice qué tamaño aguanta tu memoria.
Instalación y primera ejecución en Linux ARM64
La versión 1.11.0 publica binarios para Linux x86_64, macOS ARM64 y Windows x86_64, pero no para Linux ARM64, así que compilamos desde el código. La prueba se hizo el 14 de septiembre de 2026 en una máquina virtual OrbStack sobre un Mac: Linux ARM64, 18 núcleos, 121 GB de RAM, sin GPU y con gcc 14.2.
git clone https://github.com/JustVugg/colibri
cd colibri && git checkout v1.11.0
cd c && ./setup.sh
make olmoe
setup.sh comprueba el compilador y OpenMP y compila el motor de GLM-5.2: tardó 9,3 s en total, y el motor de OLMoE, 2,2 s. Los binarios pesan 552 KB (colibri) y 210 KB (olmoe). La autoprueba que describe la guía no se ejecutó, porque busca un modelo diminuto de referencia que no viene en el repositorio clonado.
Como no íbamos a descargar 372 GB, usamos la familia más pequeña, OLMoE-1B-7B-0125-Instruct de Ai2. No hay contenedor precompilado: se convierte con un script del repositorio que necesita PyTorch.
python3 -m venv venv && . venv/bin/activate
pip install torch --index-url https://download.pytorch.org/whl/cpu
pip install safetensors numpy huggingface_hub
python tools/convert_olmoe_merged.py \
  --model ~/modelos/OLMoE-1B-7B-0125-Instruct \
  --out /var/tmp/olmoe_i8
La conversión pasó los 13,8 GB del checkpoint en bf16 a un contenedor int8 de 7,0 GB en 45,5 s: 1 024 expertos y 147 tensores densos. Después validamos el motor contra la referencia de transformers que trae el repositorio: generó los 12 tokens esperados de 12. Cargó los pesos densos en 0,9 s y ocupaba 1,79 GB de RSS.
SNAP=/var/tmp/olmoe_i8 ./olmoe 64 8 ref_olmoe_real.json
python3 coli doctor --model /var/tmp/olmoe_i8
El primer argumento de olmoe es la caché de expertos por capa y el segundo, los bits. coli doctor repasó el modelo, los safetensors y la RAM. Su plan: 1,0 GB densos, 6,5 GB de expertos en caché, 64 por capa y un 100 % de residencia prevista.
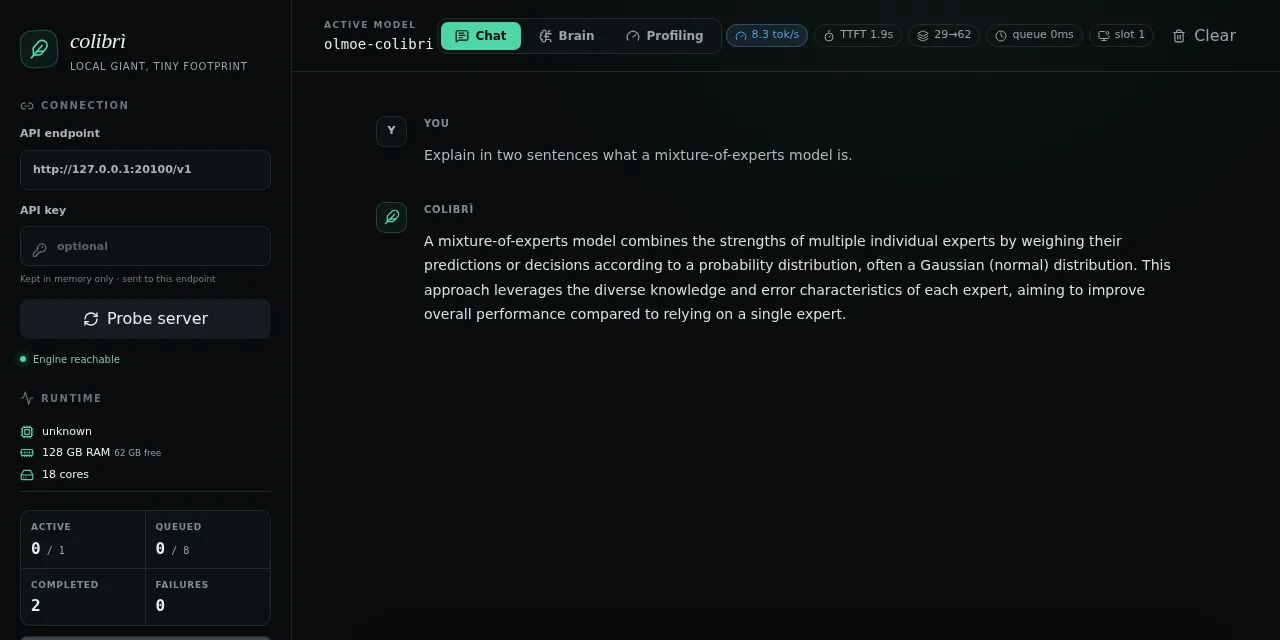
Con el motor validado, coli serve levanta la API compatible con OpenAI. Por defecto escucha en 127.0.0.1:8000; lo movimos al puerto 20100 y lo probamos con curl:
python3 coli serve --model /var/tmp/olmoe_i8 --port 20100
curl -s http://127.0.0.1:20100/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model": "olmoe-colibri", "max_tokens": 80, "temperature": 0,
    "messages": [{"role": "user",
      "content": "Explain in two sentences what a mixture-of-experts model is."
    }]}'
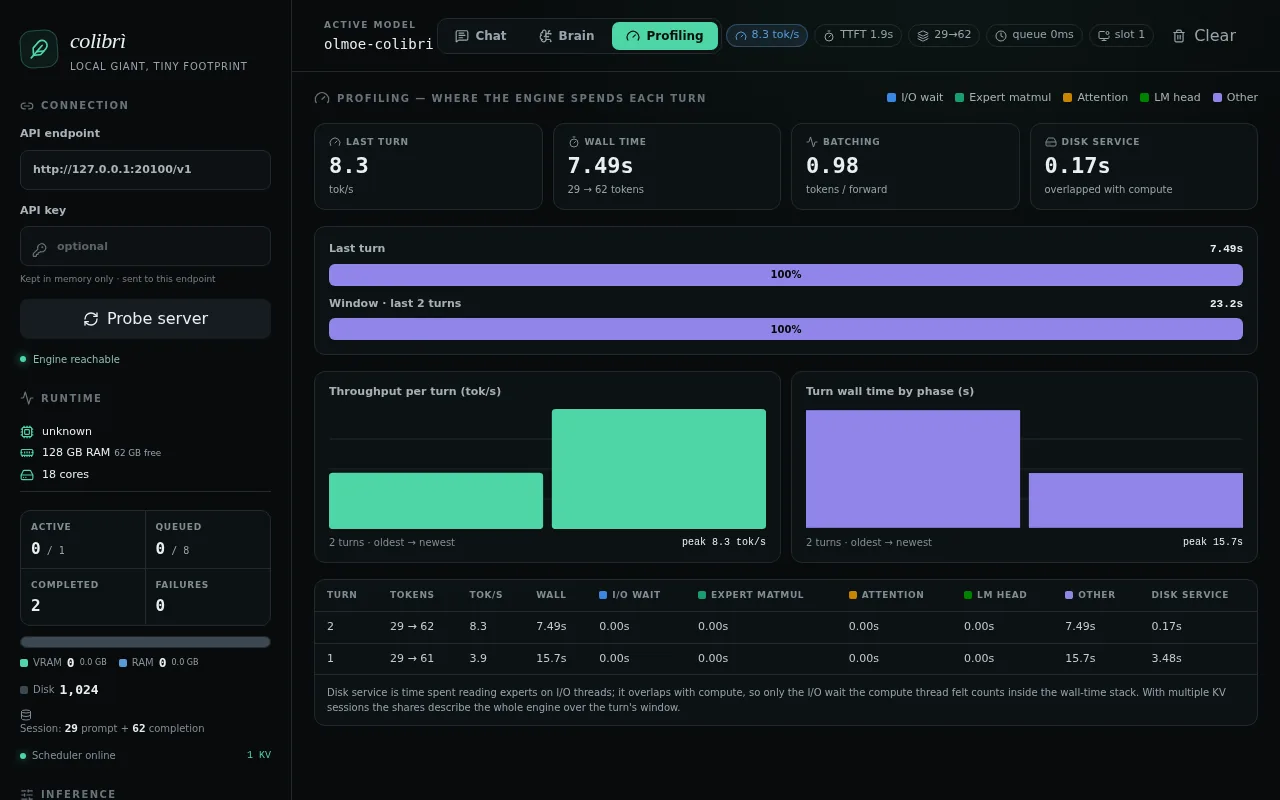
La primera petición devolvió 61 tokens en 15,7 s, de los que 3,48 s fueron lectura de expertos en frío según el endpoint /profile. En las tres siguientes, con la caché caliente, la lectura de disco bajó a 0 s y la mediana fue de 3,62 tok/s, con una carga media de 31 sobre 18 núcleos. Según su documentación, el servidor atiende una generación a la vez y, con OLMoE, rechaza las herramientas con un error HTTP 400.
El panel web se compila aparte (cd web && npm ci && npm run build; la compilación con Vite tardó menos de un segundo) y lo sirve el mismo proceso. Tiene tres pestañas: chat con la velocidad y el tiempo hasta el primer token, Brain con la rejilla de 16 capas por 64 expertos y Profiling con el tiempo por fases. Con OLMoE, el desglose por fases solo rellena la lectura de disco, y el reparto por niveles siguió marcando los 1 024 expertos como disco aunque, con la caché caliente, se servían desde RAM.
Qué pasa al obligarle a leer los expertos del disco
La caché de expertos es la palanca que convierte a Colibri en un motor de disco, así que la recortamos a propósito. Con OLMoE, pasar de 64 expertos por capa a 8 y obligar a leer cada fallo del SSD bajó la mediana de 2,84 a 1,52 tok/s. Con la lectura del disco limitada a 300 MiB/s, la caída fue de 1,25 a 0,35 tok/s.
El motor de OLMoE acepta la caché como primer argumento. Por defecto, Linux conserva en la caché de página lo que ya se leyó, así que un fallo no vuelve al disco. Con EXPERT_DROP=1, el motor descarta esas páginas tras cada lectura (fadvise(DONTNEED)) y cada fallo es una lectura real. Alargamos la referencia del repositorio a 64 tokens y alternamos las cuatro configuraciones en seis rondas:
export SNAP=/var/tmp/olmoe_i8 OMP_NUM_THREADS=4
./olmoe 64 8 ref_64.json                 # todo en caché
EXPERT_DROP=1 ./olmoe 8 8 ref_64.json    # 8 por capa, lee del SSD
| Caché por capa | Origen de cada fallo | Aciertos | Lecturas de expertos (datos) | Mediana tok/s (mín–máx) | RSS pico |
|---|---|---|---|---|---|
| 64 | Caché de página del sistema | 89,8 % | 889 (5,7 GB) | 2,84 (2,11–11,86) | 7,02 GB |
| 16 | SSD (EXPERT_DROP=1) |
49,4 % | 4 407 (28,4 GB) | 1,85 (1,49–3,77) | 3,30 GB |
| 8 | SSD (EXPERT_DROP=1) |
22,0 % | 6 785 (43,7 GB) | 1,52 (1,27–2,59) | 2,55 GB |
| 8 | Caché de página del sistema | 22,0 % | 6 785 (desde RAM) | 2,33 (1,64–4,11) | 2,55 GB |
Las columnas de aciertos y lecturas son deterministas: se repitieron idénticas en las seis rondas. Con 8 expertos por capa, cada token generado provoca 106 lecturas de 6,4 MB, unos 680 MB por token.
La velocidad, en cambio, varió hasta cinco veces entre rondas, porque la máquina la compartían otros procesos con una carga media de 20 a 48 sobre 18 núcleos. El orden sí se mantuvo: la caché completa ganó a la de 8 con lectura de disco en las seis rondas. Esa dispersión nos hizo desconfiar de cualquier cifra suelta de velocidad, incluidas las nuestras.
Hay un matiz que cambia la lectura de esa tabla. Nuestro disco es virtual y el Mac anfitrión sirve sus lecturas desde su propia caché. La herramienta del proyecto, iobench, midió 17,9 GB/s con O_DIRECT y bloques de 6,4 MB, algo que no alcanza ningún NVMe de consumo, así que esas penalizaciones son un mínimo. Para ver el régimen de un SSD real, repetimos la prueba en un contenedor Docker con la lectura del disco limitada:
G=/lib/aarch64-linux-gnu/libgomp.so.1
docker run --rm --device-read-bps /dev/vdb:300mb \
  -v /var/tmp:/var/tmp -v "$PWD":/colibri:ro -v $G:$G:ro \
  -e SNAP=/var/tmp/olmoe_i8 -e OMP_NUM_THREADS=4 -e EXPERT_DROP=1 \
  -w /colibri debian:13 ./olmoe 8 8 /var/tmp/ref_32.json
| Límite de lectura | Caché por capa | Ejecuciones (tok/s) | Mediana |
|---|---|---|---|
| 300 MiB/s | 64, caché de página | 1,19 · 1,25 · 1,55 | 1,25 tok/s |
| 300 MiB/s | 8, EXPERT_DROP=1 |
0,35 · 0,33 · 0,35 | 0,35 tok/s |
| 1 500 MiB/s | 8, EXPERT_DROP=1 |
1,12 · 1,85 · 1,39 | 1,39 tok/s |
A 300 MiB/s, los 22,8 GB de expertos que pide la caché de 8 para 32 tokens necesitan 73 s solo de lectura. La ejecución completa duró entre 91 y 98 s, así que el disco explica entre el 75 % y el 80 % del tiempo. Es el mismo régimen que describen las pruebas de GLM-5.2 en equipos reales, donde cada token lee 9,9 GB en lugar de 0,68 GB. La caché de 64 también paga su arranque (749 expertos, 4,8 GB), pero después deja de leer.
Un último aprendizaje sirve fuera de Colibri. En una ejecución de 32 tokens con los 18 hilos que asigna OpenMP por defecto, la caché completa dio 0,84 tok/s en la máquina cargada; con 4 hilos, 2,01 tok/s. En un equipo compartido, baja OMP_NUM_THREADS antes de culpar al disco.
Límites y riesgos antes de dedicarle un SSD
El desgaste del SSD por lecturas es menor de lo que se repite. Los ciclos de programación y borrado son los que gastan las celdas NAND; leer no los consume. Leer el mismo bloque una y otra vez sí altera el voltaje de las celdas vecinas, y el controlador lo corrige con lo que el estudio de Cai y otros sobre errores de lectura en memoria flash llama read reclaim: «remap the data in a block to a new flash block, if the block has experienced a high number of reads». Eso son escrituras, pero ocasionales. No hemos medido el desgaste de un SSD con Colibri; la escritura que sí cuenta es la conversión inicial de cientos de gigabytes.
Los contenedores te atan al motor. El contenedor recomendado de GLM-5.2, publicado por mastouri en Hugging Face, usa un formato int4 con escalas por grupos (fmt=4) dentro de ficheros safetensors que solo lee Colibri. No es GGUF, así que si cambias de motor vuelves a descargar el original. Kimi K3, DeepSeek V4 Flash, DeepSeek V4.1 Flash y Qwen3.8-Flash-Next son la excepción, porque Colibri lee sus checkpoints oficiales sin convertir.
El cargador ha tenido fallos de seguridad. El 5 de agosto de 2026 el proyecto publicó ocho avisos, entre ellos escrituras fuera de límites en el lector de safetensors con ficheros de modelo manipulados y un endpoint /profile sin autenticar. La propia ficha del contenedor de GLM-5.2 pide la versión 1.5.0 o posterior. Usa la 1.11.0 y contenedores de origen conocido, porque cargar un modelo de un tercero es ejecutar un parser en C sobre datos que no controlas.
Cada modelo trae su licencia. Colibri es Apache 2.0, GLM-5.2 y DeepSeek V4 Flash son MIT y OLMoE es Apache 2.0. Kimi K3 usa una licencia propia de estilo MIT con una cláusula: una empresa que ofrezca modelos como servicio y facture más de 20 millones de dólares en doce meses necesita un acuerdo aparte con Moonshot AI.
El proyecto tiene diez semanas. Suma 2 228 commits, 825 pull requests fusionadas, 398 incidencias cerradas y 58 abiertas. La actividad es de comunidad, con 161 direcciones de autor distintas, pero las fusiones pasan por una persona: 745 de los 777 commits de fusión son de Vincenzo Fornaro, que además firma 448 de los 1 451 commits restantes. Otro dato para calibrar el ritmo: 443 de esos commits llevan la línea de coautoría de Claude, el asistente de Anthropic. La propia web muestra contadores antiguos (25 157 estrellas y «seis semanas»), así que la documentación va por detrás del código.
Preguntas frecuentes
¿Necesito una GPU para usar Colibri?
No: el README indica que ninguna de las nueve familias necesita GPU y que la tarjeta gráfica solo acelera. Con OLMoE lo comprobamos en una máquina ARM64 sin GPU. Para GLM-5.2 el README pide 372 GB en un disco rápido y al menos 16 GB de RAM. Aun así, en sus pruebas un i5-12450H con 16 GB y un SSD QLC sin DRAM no llegó a dar cifra de decodificación.
¿Colibri puede cargar modelos GGUF de llama.cpp?
No. Lee safetensors: contenedores convertidos para Colibri, como el int4 de GLM-5.2, o los checkpoints oficiales en el caso de Kimi K3 y DeepSeek V4 Flash. Si ya tienes modelos en GGUF, sigue con llama.cpp y sus opciones de cuantización en tu portátil.
¿Leer expertos del disco a todas horas estropea el SSD?
Las lecturas no consumen ciclos de escritura. Lo que provocan, cuando un bloque acumula un número alto de lecturas, es que el controlador copie sus datos a otro bloque para evitar errores. Es un coste pequeño comparado con escribir el modelo, pero no lo hemos medido con Colibri.
Conclusión
Colibri demuestra algo que parecía reservado a los centros de datos: un modelo de 744 000 millones de parámetros responde en un equipo de casa si aceptas que el SSD marque el ritmo. La idea es sólida porque aprovecha la dispersión del MoE y la estructura del enrutado, y el proyecto la documenta con cifras reproducibles y con sus fracasos. Nuestra prueba con OLMoE confirma el mecanismo: menos caché significa más lecturas y menos tokens por segundo, con la misma salida.
Para trabajo interactivo, un modelo que quepa en tu memoria sigue siendo mejor opción; repasa los modelos abiertos de agosto de 2026 antes de comprar un disco. Si quieres evaluar un modelo de frontera en tu propio equipo y tienes paciencia y un NVMe de gama alta, Colibri 1.11.0 es hoy el camino más directo. Úsalo siempre con contenedores de confianza.
Fuentes
- Repositorio JustVugg/colibri, README y documentación
- Versión 1.11.0 de Colibri
- Perfil de JustVugg en GitHub
- Pruebas de rendimiento de Colibri
- Guía de ajuste de Colibri
- Referencia de la API de Colibri
- Avisos de seguridad de Colibri
- GLM-5.2 en Hugging Face
- Kimi K3 en Hugging Face
- DeepSeek V4 Flash en Hugging Face
- OLMoE-1B-7B-0125-Instruct en Hugging Face
- Contenedor int4 g64 de GLM-5.2 para Colibri
- Repositorio de FreeToken
- Opciones del servidor de llama.cpp
- Repositorio de oMLX
- Cai y otros, Read Disturb Errors in MLC NAND Flash Memory
- Web oficial de colibrì
Código fuente
Accede a todo el código fuente de este artículo en GitHub.
Ver en GitHub