Cómo instalar OpenObserve con Docker y alertar por SLO
Índice de contenidos
- Puntos clave
- Qué es OpenObserve y qué trae la versión 1.0
- Qué parte es AGPL y qué parte es Enterprise
- Qué necesitas antes de empezar
- Cómo levantar OpenObserve con Docker Compose
- Cómo enviar logs y métricas con Vector
- Por qué Vector 0.58 devuelve 401 con una contraseña correcta
- Cómo consultar logs con SQL y métricas con PromQL
- Cómo crear un SLO con alerta de burn rate
- El SLO de disponibilidad
- Por qué un SLO nuevo marca "No data"
- La alerta de burn rate
- El destino del webhook y el filtro SSRF
- Cuánta memoria y disco ocupa OpenObserve
- OpenObserve frente a Grafana, Loki y Prometheus
- Preguntas frecuentes
- ¿Los SLO de OpenObserve son de pago?
- ¿Qué imagen de Docker es la de código abierto?
- ¿Puedo usar Fluent Bit o el OpenTelemetry Collector en lugar de Vector?
- Conclusión
- Fuentes
OpenObserve 1.0 es un único binario escrito en Rust que guarda logs, métricas y trazas, los consulta con SQL y PromQL y, desde el 11 de septiembre de 2026, calcula SLO con alertas de burn rate. Esta guía lo instala con Docker Compose, le envía logs y métricas de un nginx con Vector, consulta ambos, crea un SLO de disponibilidad y hace saltar su alerta con errores provocados. Lo probé con la imagen v1.0.4 en una máquina arm64 y apunto lo que ocupó y las cuatro dificultades con las que me he topado.
Puntos clave
- La imagen
public.ecr.aws/zinclabs/openobserve:v1.0.4es la edición AGPL-3.0, pesa 144 MB para arm64 y ya incluye SLO y alertas de burn rate. - La guía oficial arranca la imagen Enterprise, que tiene otra licencia y es gratis hasta 50 GB/día; si quieres código abierto, cambia la imagen.
- Vector 0.58 ya no sustituye
${VARIABLE}en su configuración: mandó la contraseña literal y cada envío devolvió 401 hasta que la leí de un secreto. - Un SLO nuevo sobre 7 días marcó "No data" hasta rellenar el histórico, un día por pasada; tardó unos 5 minutos en llegar al 100 % de cobertura.
- En una VM arm64 de 18 núcleos sin otra carga, OpenObserve aceptó 2 millones de registros sintéticos a unos 436 000 por segundo (mediana de 3), los guardó en 12,4 MB de Parquet y no pasó de 665 MiB de memoria.
Qué es OpenObserve y qué trae la versión 1.0
OpenObserve es una plataforma de observabilidad que guarda la telemetría en ficheros Parquet, en disco local o en almacenamiento de objetos, y la sirve desde un solo proceso. Los logs y las trazas se consultan con SQL; las métricas, con PromQL o SQL. El README del proyecto[1] la presenta como alternativa a Datadog, Splunk y Elasticsearch y afirma que "The open source edition is feature-complete and production-ready".
La versión 1.0.0[2] salió el 11 de septiembre de 2026. Según sus notas, es la primera versión estable de la serie 1.x y reúne 375 commits (295 del código abierto y 80 de la parte Enterprise) desde la 0.92.2. Estos son los cambios que importan para esta guía:
- SLO: objetivos de nivel de servicio con alertas de burn rate, sobre conteos SQL, PromQL o franjas de tiempo
- Alertas compuestas: una alerta que combina otras alertas
- Biblioteca de alertas: alertas ya hechas que se instalan en bloque
- Exportación a Terraform y OpenTofu de alertas y SLO
- Monitorización sintética: pasa entera al código abierto
Desde entonces han salido cuatro parches. La 1.0.1 corrige cómo se escribe el estado del SLO y la 1.0.2, el silencio durante el periodo de espera de una alerta. La 1.0.3 trae arreglos de PromQL y de identidad de series OTLP. La 1.0.4 del 24 de septiembre[3] es la que uso aquí.
Qué parte es AGPL y qué parte es Enterprise
OpenObserve se distribuye en dos ediciones con licencias distintas. La edición de código abierto es AGPL-3.0, según el fichero LICENSE del repositorio. La edición Enterprise usa un contrato comercial propio que el README describe como "not AGPL". La página de licencia y precios[4] la deja gratis hasta 50 GB/día de ingesta, unos 1,5 TB al mes, uso comercial incluido.
Por encima pide una licencia de pago, y si superas el límite más de 3 veces en un mes natural bloquea las búsquedas.
| Función | Edición AGPL | Edición Enterprise |
|---|---|---|
| Logs, métricas, trazas, paneles | Sí | Sí |
| SLO y alertas de burn rate | Sí (probado) | Sí |
| Alertas compuestas y biblioteca de alertas | Sí | Sí |
| SSO (OIDC, SAML, LDAP) y RBAC avanzado | No | Sí |
| Registro de auditoría | No | Sí |
| Búsqueda federada entre clústeres | No | Sí |
| Redacción de datos sensibles | No | Sí |
| Gestión de incidentes, agente SRE, asistente de IA | No | Sí |
| Downsampling automático de métricas | No | Sí |
La tabla sale de la lista de funciones Enterprise[5]. Las notas de la 1.0.0 marcan las dos funciones de SLO con un número de pull request del repositorio abierto y ninguno del Enterprise. Lo comprobé en la práctica: la imagen AGPL muestra Reliability > SLOs y el formulario de alertas de burn rate.
La dificultad está en la guía de inicio[6]. Su docker run usa o2cr.ai/openobserve/openobserve-enterprise:latest, así que quien copia ese comando instala la edición Enterprise sin saberlo. La misma página lista las dos imágenes: openobserve-enterprise y openobserve, que es la AGPL.
Qué necesitas antes de empezar
Necesitas Docker con el plugin Compose y unos 200 MB de disco para las imágenes. Yo lo probé en una VM Linux arm64 con 18 núcleos y 47 GB de RAM, compartida con otros trabajos, con Docker Compose 2.40.3. El montaje tiene cinco piezas:
- OpenObserve 1.0.4, la imagen AGPL, con un volumen para los datos
- nginx 1.30.5 como aplicación que genera logs y métricas
- Vector 0.58.0 como agente: lee los logs del contenedor por el socket de Docker y rasca la página
stub_statusde nginx - Un generador de carga con
wgeten bucle - Un receptor de webhooks: un servidor HTTP de 12 líneas en Python que imprime cada POST, para ver llegar la alerta
Si ya tienes un Prometheus en Docker, el remote write del paso de métricas funciona igual desde él.
Cómo levantar OpenObserve con Docker Compose
OpenObserve solo necesita tres variables para arrancar en modo de un nodo: el correo y la contraseña del usuario raíz y el directorio de datos. Con ZO_LOCAL_MODE a su valor por defecto guarda los metadatos en SQLite dentro de ese directorio. Crea primero la contraseña, en un fichero para Vector y en .env para Compose:
printf '%s' "Aa9-$(openssl rand -hex 12)" > o2_password
echo "O2_PASSWORD=$(cat o2_password)" > .env
chmod 600 .env
El prefijo Aa9- no es decorativo. Mi primer intento usó openssl rand -base64 24 sin símbolos, y OpenObserve entró en un bucle de reinicios con este pánico: ZO_ROOT_USER_PASSWORD is too weak: Password must be 8-128 characters and contain at least one lowercase letter, one uppercase letter, one digit, and one special character. Este es el servicio de OpenObserve en compose.yaml:
services:
  openobserve:
    image: public.ecr.aws/zinclabs/openobserve:v1.0.4
    environment:
      ZO_ROOT_USER_EMAIL: admin@example.com
      ZO_ROOT_USER_PASSWORD: ${O2_PASSWORD}
      ZO_DATA_DIR: /data
      ZO_TELEMETRY: "false"
      ZO_MMDB_DISABLE_DOWNLOAD: "true"
      ZO_SKIP_SSRF_CHECKS: "true"
      ZO_WEB_URL: http://localhost:5080
    volumes:
      - o2-data:/data
    ports:
      - "127.0.0.1:5080:5080"
    restart: unless-stopped

volumes:
  o2-data:
Cada variable extra responde a algo que vi o que dice la lista de variables de entorno[7]:
ZO_TELEMETRY: valetruepor defecto y envía telemetría anónimaZO_MMDB_DISABLE_DOWNLOAD: la documentación dice que valetrue, pero sin ella mi primer arranque descargó las bases GeoLite2 City y ASN, 74 MB, y arrancó con 325 MiB de memoria; con ella, nada y unos 145 MiBZO_SKIP_SSRF_CHECKS: permite webhooks hacia redes privadas; sin ella, el destino de la alerta falla (lo explico más abajo)ZO_WEB_URL: la dirección que ponen los enlaces de las notificaciones
En mi máquina los contenedores llevan un prefijo en el nombre y el puerto publicado es otro, porque la comparto; el resto de los ficheros es el que ejecuté. Arranca el servicio y comprueba que responde:
docker compose up -d openobserve
curl -s http://127.0.0.1:5080/healthz
Devolvió {"status":"ok"} en un segundo. En ese primer arranque el log muestra las migraciones de SQLite y una línea que conviene leer: Caches info: Disk max size 500.00 GB, MEM max size 11.76 GB.
La caché de memoria se dimensiona al 25 % de la RAM del anfitrión, no del contenedor, así que en un servidor compartido conviene limitar el contenedor. La interfaz web queda en http://localhost:5080/web/ con el usuario raíz. La imagen es distroless y no trae shell, así que no admite un healthcheck de Compose con curl dentro.
Cómo enviar logs y métricas con Vector
Vector recoge los logs del contenedor nginx por el socket de Docker, los parsea con la función parse_nginx_log y los envía al endpoint _json de OpenObserve; las métricas de stub_status van por Prometheus remote write. Ambos caminos están en la guía de ingesta con Vector[8] y en la de remote write[9]. Añade estos servicios al mismo compose.yaml:
  web:
    image: public.ecr.aws/nginx/nginx:1.30-alpine
    container_name: web
    volumes:
      - ./nginx.conf:/etc/nginx/conf.d/default.conf:ro

  vector:
    image: ghcr.io/vectordotdev/vector:0.58.0-alpine
    secrets: [o2_password]
    volumes:
      - ./vector.yaml:/etc/vector/vector.yaml:ro
      - /var/run/docker.sock:/var/run/docker.sock:ro
    command: ["--config", "/etc/vector/vector.yaml"]
    depends_on: [openobserve, web]

secrets:
  o2_password:
    file: ./o2_password
Uso las imágenes de ECR y GHCR porque Docker Hub me devolvió 429 Too Many Requests durante la prueba; son las mismas versiones. El nginx.conf responde 200 en /, 503 en /fail y publica stub_status:
server {
    listen 80;
    location = /stub_status { stub_status; }
    location /fail { return 503; }
    location / { return 200 "ok\n"; }
}
La primera mitad de vector.yaml declara el secreto, las dos fuentes y la transformación. La transformación borra las etiquetas de Docker, que OpenObserve convertía en 11 columnas label_* por registro:
secret:
  o2:
    type: directory
    path: /run/secrets

sources:
  web_logs:
    type: docker_logs
    include_containers: ["web"]
  web_metrics:
    type: nginx_metrics
    endpoints: ["http://web/stub_status"]
    scrape_interval_secs: 15

transforms:
  parsed:
    type: remap
    inputs: [web_logs]
    source: |
      p, err = parse_nginx_log(.message, "combined")
      if err == null { . = merge(., p) }
      del(.label)
      del(.container_created_at)
La segunda mitad define los dos destinos. El organismo por defecto de OpenObserve se llama default y el stream nginx se crea con el primer envío:
sinks:
  o2_logs:
    type: http
    inputs: [parsed]
    uri: http://openobserve:5080/api/default/nginx/_json
    method: post
    auth:
      strategy: basic
      user: admin@example.com
      password: SECRET[o2.o2_password]
    compression: gzip
    encoding:
      codec: json
      timestamp_format: rfc3339
  o2_metrics:
    type: prometheus_remote_write
    inputs: [web_metrics]
    endpoint: http://openobserve:5080/api/default/prometheus/api/v1/write
    healthcheck:
      enabled: false
    auth:
      strategy: basic
      user: admin@example.com
      password: SECRET[o2.o2_password]
Por qué Vector 0.58 devuelve 401 con una contraseña correcta
La primera versión de este fichero ponía password: ${O2_PASSWORD} y pasaba la variable al contenedor. Cada envío acabó en 401 y en Not retriable; dropping the request, aunque la misma contraseña funcionaba con curl. La causa está en la página de variables de entorno de Vector[10]: "By default, environment variable interpolation is disabled (the default changed in v0.57.0)". Vector enviaba el texto ${O2_PASSWORD} tal cual.
Hay dos salidas: arrancar con --dangerously-allow-env-var-interpolation o usar el backend de secretos[11]. Elegí el segundo: el backend directory lee /run/secrets, donde Compose monta el secreto, y SECRET[o2.o2_password] lo sustituye al cargar la configuración. El healthcheck desactivado del destino de métricas evita otro error de arranque: la comprobación de Vector recibía 405 Method Not Allowed del endpoint de remote write, aunque los envíos reales devolvían 200.
Cómo consultar logs con SQL y métricas con PromQL
Los logs se consultan con SQL desde Logs en la interfaz o por la API _search, que espera el intervalo en microsegundos. Este script envuelve la llamada; el primer argumento es la consulta y el segundo, los minutos hacia atrás:
#!/bin/sh
MIN=${2:-15}
END=$(($(date +%s) * 1000000)); START=$((END - MIN * 60 * 1000000))
curl -s -u "admin@example.com:$(cat o2_password)" \
  http://127.0.0.1:5080/api/default/_search \
  -H 'Content-Type: application/json' \
  -d "{\"query\":{\"sql\":\"$1\",\"start_time\":$START,\"end_time\":$END}}"
Con ./q.sh "SELECT status, count(*) AS n FROM nginx GROUP BY status" obtuve 291 respuestas 200 y 5 respuestas 503 en los primeros minutos. Los campos que produce parse_nginx_log (status, request, size, agent) llegan tipados, así que status < 500 compara números sin conversiones. Las métricas se piden por la API compatible con Prometheus:
curl -s -u "admin@example.com:$(cat o2_password)" \
  http://127.0.0.1:5080/api/default/prometheus/api/v1/query \
  --data-urlencode 'query=sum(rate(nginx_http_requests_total[5m]))'
La respuesta tiene el formato de Prometheus ("resultType":"vector", en mi caso 17,6 peticiones por segundo). Por eso un Grafana en Docker puede usar esa ruta como fuente de datos Prometheus si prefieres sus paneles. Cada métrica de Vector aparece como un stream propio: nginx_http_requests_total, nginx_connections_active y seis más.
Cómo crear un SLO con alerta de burn rate
Un SLO de OpenObserve mide un indicador (SLI): el porcentaje de eventos buenos sobre el total en una ventana móvil de 7, 30 o 90 días. La alerta de burn rate avisa cuando el presupuesto de error se gasta más deprisa de lo que la ventana permite. La documentación de SLO[12] define el burn rate como la tasa de error dividida entre 100 - objetivo: con un objetivo del 99 %, un 5 % de errores es un burn rate de ×5. Si el concepto de presupuesto de error es nuevo para ti, empieza por cómo funcionan los SLO y los presupuestos de error.
El SLO de disponibilidad
Este SLO cuenta como buena toda petición a nginx que no devuelve un 5xx, excluye las lecturas de stub_status que hace Vector y pide un 99 % sobre 7 días con franjas de un minuto. Lo creé por la API:
{
  "name": "web-disponibilidad",
  "sli_type": "count",
  "config": {"source": {"mode": "single_query", "query": {
    "stream": "nginx",
    "stream_type": "logs",
    "scope": "status IS NOT NULL AND request NOT LIKE '%stub_status%'",
    "good_expr": "status < 500"
  }}},
  "target": 99,
  "window_secs": 604800,
  "slice_interval_secs": 60
}
Guarda ese JSON como slo.json, envíalo y activa el SLO con el identificador que devuelve la primera llamada:
A="admin@example.com:$(cat o2_password)"
curl -s -u "$A" -H 'Content-Type: application/json' -d @slo.json \
  http://127.0.0.1:5080/api/default/slos
curl -s -u "$A" -X PUT \
  "http://127.0.0.1:5080/api/default/slos/7509928088713560064/enable?value=true"
La segunda llamada no sobra. El SLO creado por la API quedó guardado con "enabled": false, y la respuesta del POST ("SLO saved") no lo avisa.
Por qué un SLO nuevo marca "No data"
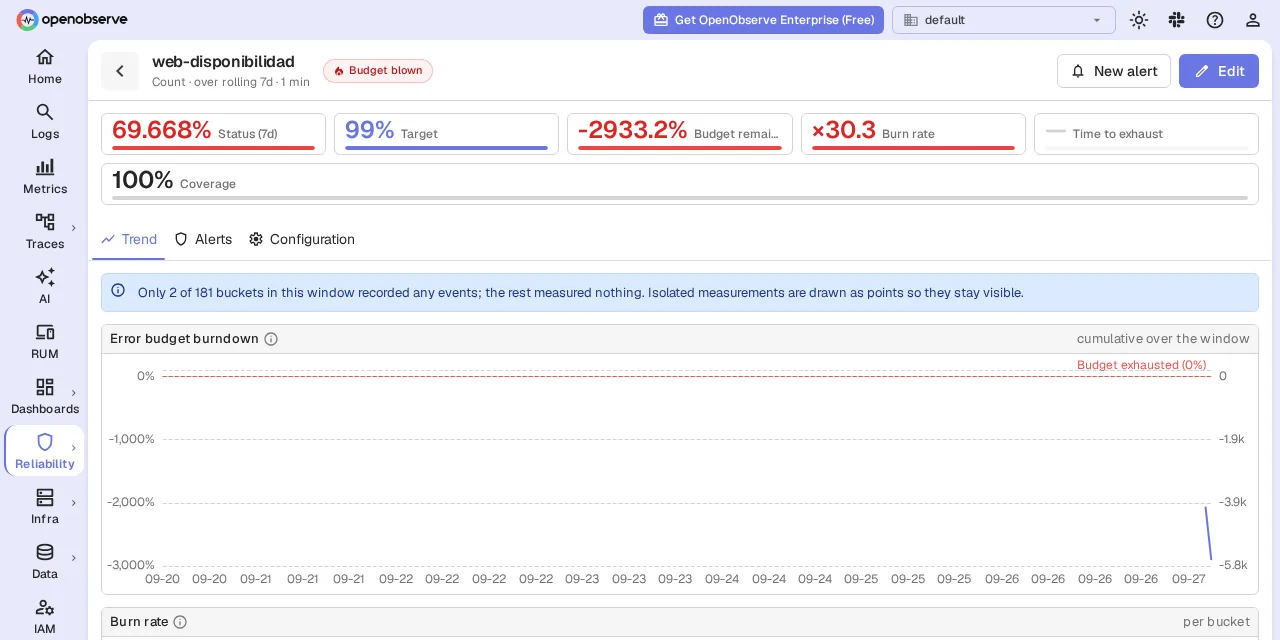
Nada más crearlo, la página del SLO mostró Frozen: not enough coverage con un 14 % de cobertura. OpenObserve solo da un SLI cuando al menos el 90 % de la ventana está medido (ZO_SLO_MIN_COVERAGE), y rellena el histórico por bloques de un día (ZO_SLO_BACKFILL_CHUNK_SECS). En mi caso, la cobertura pasó por 29 %, 43 %, 57 %, 71 % y 86 % hasta el 100 % en unos 5 minutos, una pasada por día de ventana. Los días sin datos cuentan como medidos con cero eventos, no como huecos, porque es un SLO de conteo.
Con la cobertura completa ya contaban el 2 % de errores del generador de carga y una tanda de errores provocados. El SLO marcó un SLI del 69,4 %, un burn rate de ×30,6 y un presupuesto restante del −2956,8 %. OpenObserve no recorta ese número a cero: la documentación explica que "apenas agotado" y "agotado del todo" son situaciones distintas.
La alerta de burn rate
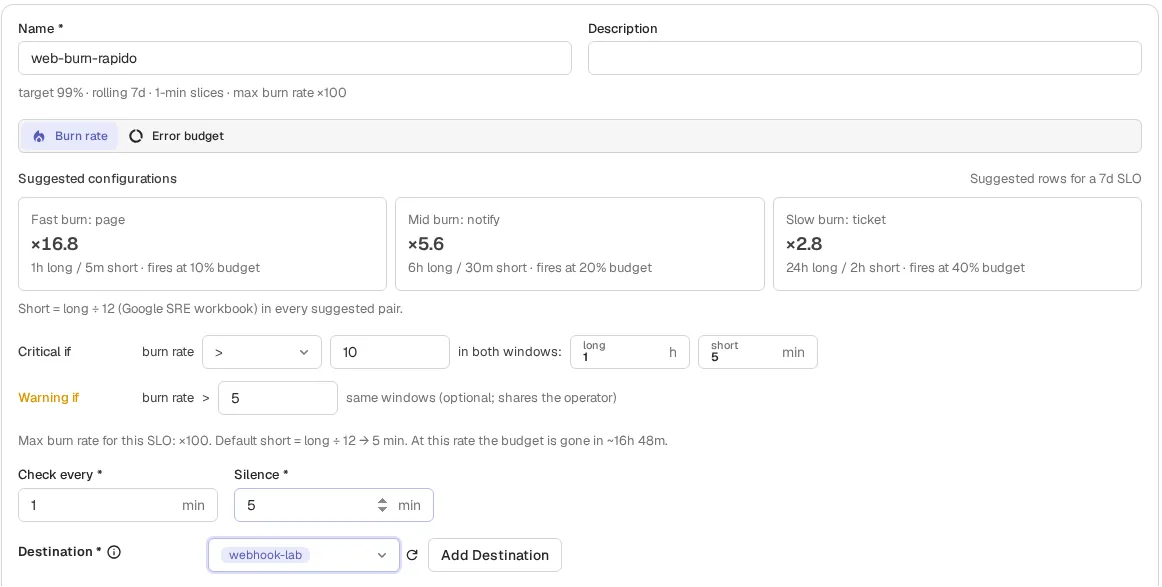
Las alertas de un SLO se crean desde su página, en la pestaña Alerts, y no ejecutan consultas: leen la medición que el SLO ya guardó. El formulario ofrece tres configuraciones con ventanas de la guía de alertas sobre SLO[13], que sigue el libro de SRE de Google (ventana corta = larga ÷ 12). Para un SLO de 7 días:
| Preajuste | Umbral | Ventanas | Presupuesto gastado al saltar |
|---|---|---|---|
| Fast burn: page | ×16,8 | 1 h / 5 min | ~10 % |
| Mid burn: notify | ×5,6 | 6 h / 30 min | 20 % |
| Slow burn: ticket | ×2,8 | 24 h / 2 h | 40 % |
Configuré un crítico por encima de ×10 y un aviso por encima de ×5, con ventanas de 1 h y 5 min, comprobación cada minuto y silencio de 5 minutos. Las dos ventanas tienen que superar el umbral para que salte, y el nivel final es el menos grave de los dos: si la ventana corta ya se ha recuperado, la alerta no salta.
El destino del webhook y el filtro SSRF
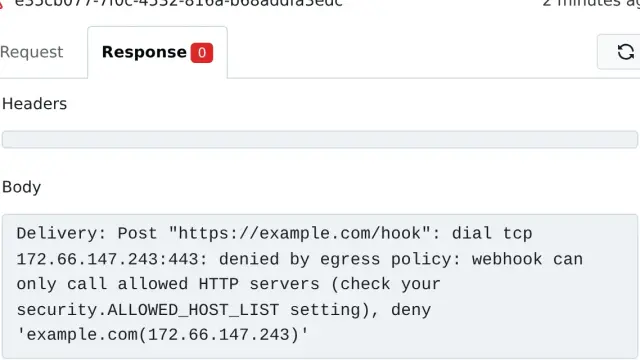
El destino de la alerta es un webhook hacia el contenedor hook de la misma red, y OpenObserve lo rechazó al guardarlo: Destination URL blocked by SSRF guard: Access to private IP address 172.25.0.6 is not allowed. La protección contra falsificación de peticiones del lado del servidor (SSRF) bloquea por defecto las redes privadas. ZO_SSRF_ALLOW_LOOPBACK solo abre 127.0.0.1; para un servicio en otra IP privada, como un ntfy o un Gotify de tu red, hace falta ZO_SKIP_SSRF_CHECKS=true, que es lo que lleva el compose.yaml de arriba. Actívala solo si confías en todas las URL de destino que se configuren en la instancia.
Para provocar el disparo lancé un contenedor que pide /fail 40 veces cada 5 segundos, alrededor del 50 % de las peticiones. lab_default es la red que Compose crea para un proyecto en el directorio lab:
docker run -d --name chaos --network lab_default alpine:3.24 sh -c \
  'while true; do for i in $(seq 1 40); do
     wget -qO- http://web/fail >/dev/null 2>&1; done; sleep 5; done'
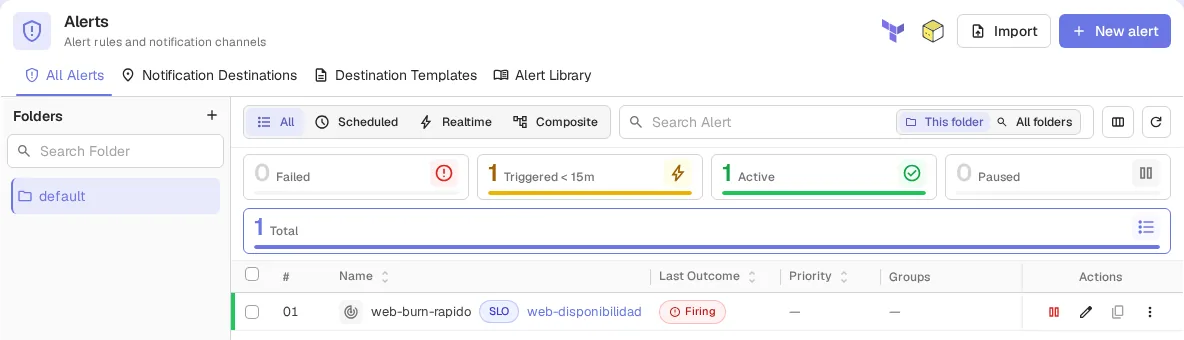
Mientras la ventana de una hora no tuvo cobertura suficiente, el log de OpenObserve repetía SLO alert evaluation frozen (unobserved): congelada, ni dispara ni se resuelve. A mitad de la prueba la VM estuvo suspendida 37 minutos, así que no puedo darte un tiempo limpio hasta el disparo. Con la VM ya reanudada, 11 minutos después, el webhook recibió esto:
{"title": "[critical] web-burn-rapido on ",
 "severity": "critical",
 "rows": [{"slo_name": "web-disponibilidad", "slo_window": "7d",
           "slo_target": 99.0, "burn_rate": 14.910179640718567,
           "sli": 85.08982035928143,
           "error_budget_remaining": -1391.0179640718568}],
 "fields": {"Threshold": "= 0", "Value": "14.910179640718567"}}
El burn rate de la notificación (×14,9) es el de la ventana que decidió, no el de los 7 días (×30), y el SLI y el presupuesto salen de esa misma ventana. La plantilla por defecto escribe Threshold: = 0 y un título que acaba en on, restos del formato de las alertas de consulta. Si la notificación va a un canal que leen personas, crea una plantilla propia con los campos slo_*.
Cuánta memoria y disco ocupa OpenObserve
Con el tráfico de nginx del laboratorio, unas 17 peticiones por segundo, OpenObserve se quedó por debajo de 235 MiB. Para medir la ingesta y el disco con más volumen envié además 2 millones de registros sintéticos por la API _json. Repetí el envío 3 veces, cada una sobre un volumen nuevo y con OpenObserve solo, y una cuarta con todo el montaje en marcha.
La máquina es una VM Linux arm64 de 18 núcleos y 47 GB de RAM (OrbStack sobre Apple silicon), con el volumen de Docker en btrfs sobre un disco virtio. Solo acepté ejecuciones que empezaban con una carga media de un minuto por debajo de 3; empezaron entre 0,54 y 1,00, y la propia ingesta sube la carga mientras dura. Las cifras de memoria salen de docker stats cada segundo y las de disco, de du sobre el volumen:
| Medida | Valor |
|---|---|
Imagen openobserve:v1.0.4 (arm64) |
144 MB |
| Memoria recién arrancado, sin datos (3 arranques) | 140–182 MiB |
| Memoria con el tráfico de nginx y el SLO, a los 5, 10 y 15 minutos | 196, 227 y 232 MiB |
| Ingesta de 2 millones de registros (mediana de 3) | 435 937 registros/s, 88,7 MB/s |
| Pico de memoria durante la ingesta (4 ejecuciones) | 532–665 MiB |
| Memoria de 5 a 25 minutos después de la ingesta | 278–369 MiB |
| Memoria de Vector | 46–73 MiB |
| 2 millones de registros: tamaño original según OpenObserve | 355,6 MB |
| Los mismos registros en Parquet | 12,36 MB |
Metadatos SQLite (/data/db) |
6 MB |
La relación de 29 a 1 en disco es la de mis datos, no una promesa. Los registros sintéticos repiten cinco rutas, cuatro códigos y un solo agente de usuario. Parquet comprime mejor cuanto más se repiten los valores de una columna; unos logs reales con mensajes libres comprimirán menos. Los registros pasan unos minutos en el registro de escritura anticipada (WAL) y en memoria antes de convertirse en Parquet: ZO_MAX_FILE_RETENTION_TIME vale 600 s por defecto.
Las tres ejecuciones dieron 426 145, 435 937 y 451 119 registros por segundo, entre 4,4 y 4,7 s cada una. La cuarta, con Vector, nginx y el SLO activos, dio 475 103.
Los MB/s cuentan el JSON sin comprimir que envía el cliente. Es un script de Python con 4 hilos en la misma máquina, que manda lotes de 5000 registros de unos 200 bytes y 8 campos. OpenObserve confirma cada lote cuando lo tiene en el WAL, no en Parquet. No tomes la cifra como capacidad de producción: con registros más grandes, más campos o un cliente en otra máquina el número será otro.
Las consultas sobre los 2 millones de registros, ya en Parquet, tardaron entre 6 y 9 ms según el campo took de la API (mediana de 5 repeticiones tras una primera en frío). Un count(*) con el percentil 99 de duration_ms tardó 9 ms (29 ms en frío) y un GROUP BY status, 6 ms (7 ms en frío). Descarté una tercera consulta porque la caché de resultados respondía a partir de la segunda vez.
OpenObserve frente a Grafana, Loki y Prometheus
La diferencia práctica está en cuántas piezas mantienes. Con el stack de Grafana, los logs van a Loki, las métricas a Prometheus, los paneles a Grafana y el enrutado de alertas a Alertmanager. Los SLO necesitan reglas propias o una herramienta más. Tenemos guías de Loki con Docker, de Prometheus y de Grafana por separado; OpenObserve junta las cuatro funciones en un proceso y un volumen.
| Criterio | OpenObserve 1.0 | Grafana + Loki + Prometheus |
|---|---|---|
| Servicios que mantener | 1 | 3, más Alertmanager |
| Lenguaje de logs | SQL | LogQL |
| Lenguaje de métricas | PromQL o SQL | PromQL |
| SLO con alertas de burn rate | Integrados | Reglas de registro y alerta a mano |
| Almacenamiento | Parquet en disco o S3 | Formatos propios de Loki y del TSDB de Prometheus |
| Licencia | AGPL-3.0 (Enterprise aparte) | Grafana y Loki AGPL-3.0, Prometheus Apache-2.0 |
| Ecosistema y documentación | Joven, serie 1.x desde septiembre de 2026 | Maduro y extendido |
Me quedaría con OpenObserve para un servidor o un clúster pequeño donde quieres logs, métricas y SLO sin montar cuatro servicios. Me quedaría con el stack de Grafana si ya lo tienes o si dependes de paneles y exportadores de la comunidad. También si necesitas SSO y control de acceso por roles sin pagar, porque en OpenObserve eso es Enterprise.
Preguntas frecuentes
¿Los SLO de OpenObserve son de pago?
No. Las notas de la versión 1.0.0 atribuyen los SLO y las alertas de burn rate al repositorio abierto, y la imagen AGPL openobserve:v1.0.4 los incluye: los creé y los hice saltar con ella. Lo que es Enterprise es, entre otras cosas, el SSO, el RBAC avanzado, la auditoría y la gestión de incidentes.
¿Qué imagen de Docker es la de código abierto?
public.ecr.aws/zinclabs/openobserve es la edición AGPL-3.0. openobserve-enterprise, que es la que usa el docker run de la guía oficial, tiene licencia comercial y es gratis hasta 50 GB/día de ingesta.
¿Puedo usar Fluent Bit o el OpenTelemetry Collector en lugar de Vector?
Sí, la documentación de ingesta incluye los dos, y OpenObserve acepta OTLP. En esta prueba solo usé Vector; si ya tienes Fluent Bit recogiendo logs, apúntalo al mismo endpoint _json o al de compatibilidad con Elasticsearch.
Conclusión
OpenObserve 1.0 cumple lo que promete para un nodo. Es un contenedor de 144 MB con logs en SQL, métricas en PromQL y SLO con alertas de burn rate en la edición AGPL. Con mi carga no pasó de 370 MiB en reposo.
Las cuatro dificultades con las que me he topado te costarán una tarde si no las conoces. Son la imagen Enterprise de la guía oficial, la interpolación desactivada de Vector 0.58, la política de contraseñas y el filtro SSRF de los webhooks.
El siguiente paso razonable es moverlo a almacenamiento S3 y probar la retención con tus propios logs antes de apagar Loki.
Esta guía también está en inglés.
Fuentes: [1] OpenObserve v1.0.0 release notes[2], [2] OpenObserve v1.0.4 release[3], [3] OpenObserve README y licencia[1], [4] OpenObserve: License and Pricing[4], [5] OpenObserve: Enterprise Features[5], [6] OpenObserve: Getting Started[6], [7] OpenObserve: Environment Variables[7], [8] OpenObserve: Service Level Objectives[12], [9] OpenObserve: Alerting on SLOs[13], [10] OpenObserve: Vector[8], [11] OpenObserve: Prometheus remote write[9], [12] Vector: Environment Variables[10], [13] Vector: Secrets[11].
Fuentes
- README del proyecto
- versión 1.0.0
- 1.0.4 del 24 de septiembre
- página de licencia y precios
- lista de funciones Enterprise
- guía de inicio
- lista de variables de entorno
- guía de ingesta con Vector
- remote write
- página de variables de entorno de Vector
- backend de secretos
- documentación de SLO
- guía de alertas sobre SLO
Código fuente
Accede a todo el código fuente de este artículo en GitHub.
Ver en GitHub