Qué hace Soup, la CLI de fine-tuning que te dice cuándo no entrenar
Índice de contenidos
- Puntos clave
- Qué es Soup y qué problema resuelve
- Cómo funciona el flujo de decidir, entrenar y publicar
- Qué pasó al probarlo en un equipo sin GPU
- Qué es el layer streaming y cuánto promete
- Cuándo conviene el layer streaming frente a DeepSpeed
- Qué devuelve la puerta soup ship
- Cómo se compara con Axolotl, Unsloth y LLaMA-Factory
- Qué conviene vigilar antes de adoptarlo
- Preguntas frecuentes
- ¿Soup necesita una GPU?
- ¿Es gratis Soup?
- ¿Sustituye a Axolotl o a Unsloth?
- Conclusión
- Fuentes
Soup es una interfaz de línea de comandos (CLI) de código abierto que agrupa en un solo programa todo el post-entrenamiento de un modelo de lenguaje: decidir si compensa entrenar, preparar los datos, escribir la configuración, entrenar, evaluar y decidir si el resultado se publica. La instalé el 15 de octubre de 2026, versión 0.76.1, en un equipo Linux arm64 sin GPU, entrené un adaptador LoRA de prueba y pasé el resultado por su puerta de calidad. Aquí cuento qué hace, qué funcionó y dónde conviene leer la letra pequeña.
Puntos clave
- Soup 0.76.1 trae 78 comandos y ocho meses de vida: el repositorio nació el 20 de febrero de 2026 y lleva 181 versiones en PyPI.
soup quickstartentrenó un LoRA sobre TinyLlama 1.1B en 30 s de CPU, ajustando 2,25 millones de parámetros (el 0,20 % del modelo).soup advisedesaconsejó entrenar con los propios datos de ejemplo del quickstart: 20 filas no llegan a su mínimo de 50.- El layer streaming entrena un Llama 3.1 8B en una GPU de 4 GB, pero los autores advierten que la cifra de velocidad no se traslada a otra máquina.
soup shipdio DON’T SHIP a ese adaptador (código 2): acertó 5 de 6 preguntas, igual que el modelo base.- La telemetría está desactivada por defecto en 0.76.1; el registro de auditoría local, no.
Qué es Soup y qué problema resuelve
Soup resuelve el tramo que queda fuera de un script de entrenamiento: decidir si entrenar, elegir el método y saber si el modelo resultante es mejor que el de partida. Hacer fine-tuning de un LLM suele acabar en una pila de herramientas sueltas: un framework para entrenar, otro para evaluar, scripts propios para limpiar datos y una hoja de cálculo para comparar ejecuciones. Su web lo resume en una frase: "Every other tool stops at ‘hit train and hope.’"
El proyecto lo publican Rafik Mamedov y Alpamys Makazhan bajo MePlay, Inc., con licencia Apache 2.0. Funciona con Python 3.10 a 3.12, en GPU NVIDIA y, de forma experimental, en Apple Silicon a través de MLX. Por debajo usa las piezas de siempre: Transformers, PEFT y TRL de Hugging Face, bitsandbytes para cuantizar y, opcionalmente, Unsloth, DeepSpeed o vLLM.
El ritmo de desarrollo es alto. El 15 de octubre el repositorio tenía 9050 estrellas, 1473 forks y 196 incidencias abiertas, y la versión 0.76.1 salió el 14 de octubre, dos días después de la 0.76.0. Esa cadencia tiene una lectura doble: corrige rápido, pero las opciones cambian entre versiones y conviene fijar la que uses.
Cómo funciona el flujo de decidir, entrenar y publicar
El flujo tiene cuatro fases y cada una es un comando: soup advise decide, soup train entrena, soup ship dictamina y soup diagnose o soup why explican lo que salió mal. Todo parte de un único archivo soup.yaml. soup init lo genera a partir de 21 plantillas: chat, código, razonamiento, llamada a herramientas, visión, DPO, KTO o perfiles de cumplimiento como HIPAA o la Ley de IA de la UE.
Las fases y sus comandos:
soup advise: analiza el conjunto de datos y recomienda una de cinco vías: ingeniería de prompts, RAG, SFT, DPO o GRPOsoup train: entrena con 23 métodos (SFT, DPO, ORPO, SimPO, KTO, GRPO, PPO, entre otros) y LoRA o QLoRAsoup ship: compara el modelo ajustado con el base en tu tarea y en ocho suites generales, y devuelve SHIP o DON’T SHIPsoup diagnose: busca siete modos de fallo después de entrenar, como olvido catastrófico, rechazos de más o memorizaciónsoup migrate: convierte configuraciones de Axolotl, LLaMA-Factory o cuadernos de Unsloth
Si ya conoces LoRA y QLoRA, la novedad no está en el entrenamiento, que delega en TRL, sino en lo que lo rodea. Las preferencias tipo DPO y sus alternativas a RLHF están cubiertas, y GRPO también.
Qué pasó al probarlo en un equipo sin GPU
En CPU, Soup instala, entrena un modelo pequeño y evalúa, aunque cada paso es lento. Lo probé en un contenedor Linux arm64 con 18 núcleos y 47 GB de RAM, sin aceleradora. La instalación con uv trajo PyTorch 2.14.1, Transformers 5.19.0, PEFT 0.21.2 y TRL 0.29.1. soup doctor dio el entorno por bueno con un aviso: "Training will be slow without GPU."
uv venv -p 3.12 .venv && . .venv/bin/activate
uv pip install "soup-cli[train]"
soup doctor
soup quickstart --yes
Estos cuatro comandos crean el entorno, instalan Soup con las dependencias de entrenamiento, comprueban el sistema y lanzan la demostración. soup quickstart escribe 20 ejemplos en formato Alpaca y una configuración mínima, y entrena un adaptador LoRA de rango 16 sobre TinyLlama 1.1B. El entrenamiento duró 30 s y el comando entero, 46 s. La pérdida de validación quedó en 2,63.
Dos detalles de la salida delatan las prisas del proyecto. El panel final dice "Duration: 0m" y "Loss: -" aunque las métricas de TRL, unas líneas más arriba, traen los valores reales. Y soup --version no existe: la versión se consulta con soup version.
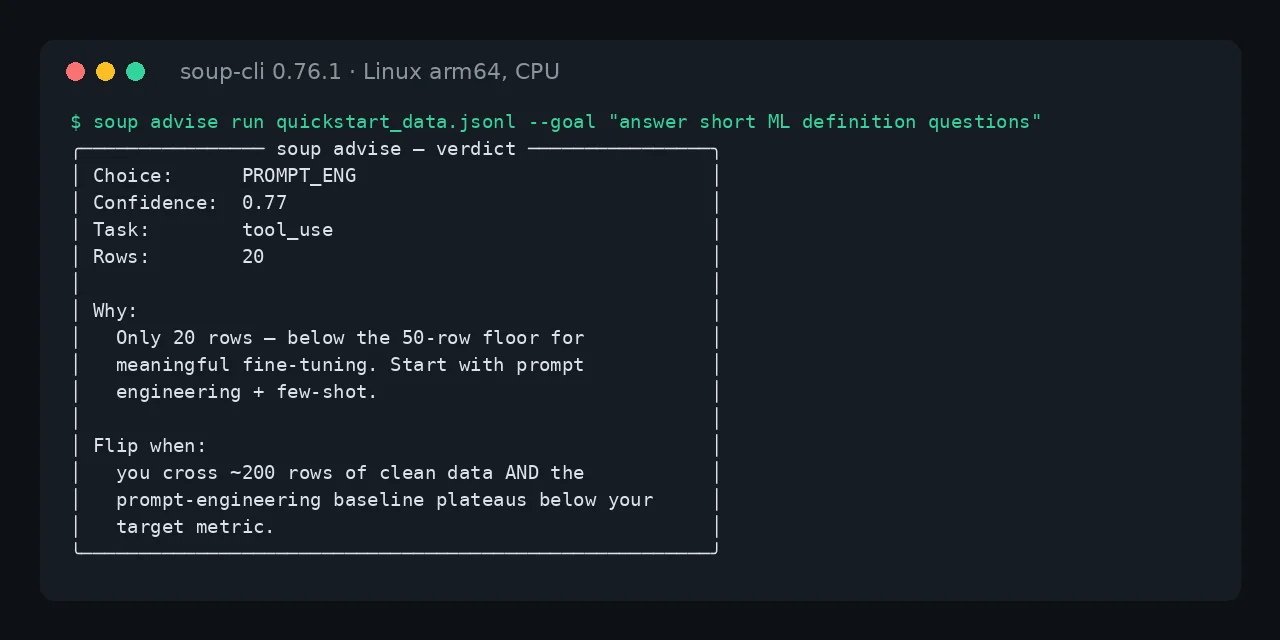
Lo más útil de la prueba llegó después. Pasé los mismos 20 ejemplos por soup advise y la herramienta recomendó no entrenar: "Only 20 rows, below the 50-row floor for meaningful fine-tuning". Propone empezar por ingeniería de prompts y cambiar de vía al superar unas 200 filas limpias. Clasificó la tarea como tool_use, que no lo es, pero el veredicto era el correcto.
Qué es el layer streaming y cuánto promete
El layer streaming guarda el modelo base congelado en la RAM o en un NVMe y copia a la VRAM una capa del decodificador cada vez. Así, la memoria de vídeo deja de limitar el tamaño del modelo. Con el modelo base cuantizado a NF4, los autores entrenan un LoRA sobre Llama 3.1 8B en una RTX 3050 de portátil con 4 GB. Se activa con una clave, stream_layers: true, y está en beta.
Las cifras vienen con más salvedades que de costumbre, y eso habla bien del proyecto. La fila de 8B es anterior a una reparación de los gradientes en NF4 y su pico de VRAM fue de 3,32 GB. Nada por encima de 8B se ha medido en ese portátil, y la ralentización frente a entrenar con el modelo entero en la GPU (1,43 veces) solo se midió con 0,5B. La propia documentación lo dice así: "Treat the mechanism as the claim, not the multiplier."
La validación externa, en una máquina prestada con ocho H100, encontró un fallo serio. En NF4, por encima de unos 165 MiB por capa, el streaming producía gradientes erróneos mientras la pérdida parecía normal. Afectaba a Qwen2.5 32B y 72B, no a 8B ni a 14B, y se corrigió en la 0.73.0. Si entrenaste un modelo grande con la 0.72, la documentación pide repetirlo.
Cuándo conviene el layer streaming frente a DeepSpeed
El layer streaming sirve cuando tienes una sola GPU demasiado pequeña, no para ganar velocidad. En la misma H100 y en bf16, el streaming entrenó a 63,52 tokens/s con 3935 MiB de VRAM. DeepSpeed ZeRO-3 con descarga a CPU se quedó en 21,65 tokens/s y ocupó 38 135 MiB.
Los autores no venden esa diferencia como una victoria. Su informe dice que el streaming "is not faster than DeepSpeed, built for a different situation, namely one card that is too small", y añade que ocho tarjetas con ZeRO-3 van más lentas que una sola si el modelo cabe entero en ella. La regla práctica sale de su propia documentación: si el modelo cabe en tu tarjeta, no actives el streaming.
Qué devuelve la puerta soup ship
soup ship combina dos preguntas en un solo veredicto: si el modelo ajustado gana en tu tarea y si ha olvidado lo que ya sabía. La primera pata usa un archivo JSONL con tus casos de prueba. La segunda corre ocho suites incluidas en el paquete, que se puntúan sin red: MMLU reducido, sentido común, instrucciones, aritmética, llamadas a herramientas, JSON, seguridad y rechazos de más. Por defecto, una caída de más de 5 puntos en la segunda pata ya es DON’T SHIP.
soup ship --base TinyLlama/TinyLlama-1.1B-Chat-v1.0 \
  --adapter quickstart_output \
  --task-eval tasks.jsonl --device cpu -o verdict.json \
  --general-suite mini_mmlu,mini_arithmetic
echo $?
Este comando evalúa el modelo base y el ajustado con seis preguntas propias y dos de las ocho suites, y guarda el veredicto en JSON. El código de salida es lo que lo hace útil en integración continua: 0 es SHIP, 2 es DON’T SHIP, 3 es un error de uso y 1 un fallo de ejecución. Un error de configuración nunca se confunde con un suspenso.
Lo limité a dos suites porque la evaluación completa no terminó: con las ocho suites, el modelo en float32 y sin GPU, llevaba más de hora y media generando cuando la corté. Con dos tardó 957 s y devolvió DON’T SHIP con código 2. El adaptador del quickstart acertó 5 de 6 preguntas, igual que el modelo base, y Soup exige una mejora estricta para publicar.
La caída en MMLU equivale a una respuesta de 26 y queda por debajo del umbral de 5 puntos, así que la segunda pata dio el modelo por bueno. El veredicto es el sensato: cinco pasos con 18 ejemplos genéricos no enseñan nada al modelo. Con tan pocas preguntas, la opción --noise-floor es la que conviene, porque repite el modelo base para medir cuánto varía la propia evaluación.
La documentación no explica el formato del archivo de tareas. Lo saqué del código: cada línea es un objeto con prompt y, opcionalmente, expected y scoring (exact, contains, regex o semantic, entre otros).
Cómo se compara con Axolotl, Unsloth y LLaMA-Factory
Soup no compite con Axolotl, Unsloth o LLaMA-Factory en la mecánica de entrenar; compite en todo lo que ocurre antes y después. Por eso importa sus configuraciones: probé soup migrate --from axolotl con un YAML de QLoRA y tradujo adapter: qlora a quantization: 4bit y lora_target_linear: true a target_modules: auto. La web avisa de que los nombres de conjuntos de datos de Hugging Face hay que cambiarlos a mano por rutas locales.
| Necesidad | Qué ofrece Soup | Qué haces sin él |
|---|---|---|
| Decidir si entrenar | soup advise con cinco veredictos |
Criterio propio |
| Escribir la configuración | soup init, 21 plantillas |
YAML de Axolotl o LLaMA-Factory |
| Entrenar en una GPU pequeña | Layer streaming (beta) | QLoRA o DeepSpeed |
| Decidir si se publica | soup ship, códigos 0 y 2 |
lm-eval y scripts propios |
| Migrar | soup migrate desde tres herramientas |
No aplica |
Qué conviene vigilar antes de adoptarlo
Lo primero es la velocidad de cambio. Soup lleva 181 versiones en ocho meses y arrastra un historial de fallos silenciosos, como gradientes erróneos en 32B o adaptadores vacíos antes de la 0.75.1. Fija la versión en tu requirements.txt y lee las notas antes de actualizar.
Lo segundo, la telemetría y la auditoría. La ayuda de 0.76.1 describe --no-telemetry como una opción para desactivar una telemetría anónima, pero el código la deja apagada salvo que exportes SOUP_TELEMETRY=1. Lo que sí está activo por defecto es un registro local: cada comando añade una línea a ~/.soup/audit.jsonl con el usuario, un identificador de la máquina y los argumentos. Se desactiva con --no-audit-log o SOUP_NO_AUDIT_LOG=1.
Lo tercero, el tamaño. 78 comandos en la raíz cubren desde un generador de ML-BOM hasta un servidor del Model Context Protocol (MCP) para agentes de programación. Para un uso concreto bastan seis: init, advise, train, ship, export y serve. Si luego quieres servir el adaptador, soup export lo convierte a GGUF para Ollama.
Preguntas frecuentes
¿Soup necesita una GPU?
No para probarlo. En CPU instala, entrena modelos pequeños y evalúa, como hice con TinyLlama 1.1B, pero un modelo de 7B u 8B necesita una GPU NVIDIA o un Mac con Apple Silicon.
¿Es gratis Soup?
Sí. Es código abierto con licencia Apache 2.0 y no tiene versión de pago; las donaciones financian horas de GPU. El equipo prepara una aplicación de escritorio, Soup Zero, basada en la misma CLI.
¿Sustituye a Axolotl o a Unsloth?
No del todo, porque usa Unsloth como motor opcional e importa configuraciones de Axolotl. Su aportación son el consejo previo, la puerta de publicación y el layer streaming.
Conclusión
Soup merece la pena por sus dos extremos más que por el entrenamiento en sí. soup advise me habría ahorrado un entrenamiento inútil con 20 filas, soup ship lo confirmó con un DON’T SHIP y convierte "parece que va mejor" en un código de salida que una canalización puede respetar. El layer streaming es la función llamativa, pero sus propios autores piden tratarla con cautela, y es razonable hacerles caso.
Si haces fine-tuning con cierta frecuencia, empieza por soup advise con tus datos reales antes de reservar horas de GPU. También tienes este análisis de Soup en inglés.
Fuentes: [1] Soup, web oficial[1], [2] Repositorio de Soup en GitHub[2], [3] soup-cli en PyPI[3], [4] Documentación del layer streaming[4], [5] Validación externa en 8x H100[5], [6] Documentación de soup ship[6].
Fuentes
Código fuente
Accede a todo el código fuente de este artículo en GitHub.
Ver en GitHub