El function calling permite que un modelo que ejecutas con Ollama en tu propia máquina pida a tu código que llame a una función (consultar el clima, buscar en una base de datos) y use el resultado para responder. Desde julio de 2024 Ollama soporta herramientas; en 2026 modelos como qwen3 o llama3.3 lo hacen con fiabilidad razonable.
Qwen-Agent es el framework oficial del equipo Qwen para dar herramientas a sus modelos: function calling, un interprete de código en sandbox, RAG y MCP. Va por la version 0.0.34, publicada en febrero de 2026, suma unas 16.800 estrellas en GitHub y contiene la implementacion canonica del tool calling de Qwen3, tanto en la nube como en tu propia maquina.
Hermes 4 es la familia de modelos open-weight que Nous Research publicó en agosto de 2025, con variantes de 14B, 70B y 405B parámetros. Su gran novedad es el razonamiento híbrido: un mismo modelo responde directo o delibera con etiquetas think antes de contestar, y conserva el formato de herramientas de Hermes.
Hermes 3 es la familia de modelos open-weight de Nous Research, afinada sobre Llama 3.1 en tamaños de 8B, 70B y 405B. Su punto fuerte es el uso de herramientas mediante llamadas a funciones en formato JSON. Puedes ejecutarlo en tu propia máquina con Ollama o vLLM y darle capacidades agénticas sin depender de una API de pago.
Haystack es un framework de Python de deepset, con licencia Apache 2.0, para construir aplicaciones de IA como pipelines de componentes conectados: recuperadores, generadores y routers. Desde la reescritura de la versión 2.0 admite ciclos, lo que permite añadir un componente Agent que llama a herramientas en bucle. Sirve tanto para RAG como para agentes en producción.
Agno, el framework de Python antes conocido como Phidata, construye agentes de IA con un objetivo claro: rendimiento. En nuestra prueba con la versión 3.0.10, cada agente costó unos 4 microsegundos y 5,5 KiB. Ofrece agentes, equipos, flujos de trabajo y el tiempo de ejecución AgentOS, y la 3.0 exige migrar la base de datos desde la 2.x.
Mastra es un framework open-source de TypeScript para construir agentes y aplicaciones de IA con un solo paquete: agentes, herramientas, workflows, memoria, RAG y evaluaciones. Lo creó el equipo detrás de Gatsby, alcanzó la versión 1.0 en enero de 2026 y conecta con más de 40 proveedores de modelos desde una única interfaz.
Semantic Kernel es el kit de código abierto de Microsoft para integrar modelos de IA en C#, Python y Java mediante un kernel que orquesta plugins y funciones. En 2026 su relevo es Microsoft Agent Framework, el sucesor que fusiona Semantic Kernel y AutoGen; Semantic Kernel sigue con soporte al menos un año más.
LlamaIndex es un framework de Python centrado en conectar tus datos con un modelo de lenguaje. Desde su módulo AgentWorkflow puedes construir agentes que razonan y llaman a herramientas: FunctionAgent para modelos con function calling y ReActAgent para cualquier modelo. Esta guía muestra cómo convertir un flujo RAG en un agente que actúa sobre tus documentos.
Google ADK (Agent Development Kit) es el framework de código abierto de Google para construir, evaluar y desplegar agentes de IA. Es code-first, funciona con Gemini y con otros modelos vía LiteLLM, y ofrece agentes de flujo, herramientas y memoria. Su versión 2.5.0 llegó en julio de 2026 y despliega directamente en Vertex AI.
smolagents es la biblioteca de agentes de Hugging Face: con su lógica en un solo archivo, te deja crear un agente que razona escribiendo Python en lugar de rellenar JSON. Su CodeAgent da alrededor de un 30% menos de pasos que el tool calling clásico, y lo probamos con la versión 1.26.0 y un modelo local en Ollama.
Pydantic AI es el framework de agentes del equipo de Pydantic: construyes agentes en Python donde cada salida del modelo se valida contra un tipo que tú defines. Declaras la respuesta esperada como un modelo Pydantic y el agente garantiza esa estructura, con inyección de dependencias, herramientas y soporte para más de veinte proveedores de modelos.
El OpenAI Agents SDK es un framework de Python ligero para construir agentes y flujos multiagente con pocas primitivas: agentes, herramientas, traspasos (handoffs), barreras de seguridad, sesiones y trazado integrado. Es la evolución lista para producción de Swarm, funciona con la API de OpenAI y con más de 100 LLMs.
Continue es un asistente de código open source para VS Code y JetBrains que reúne chat, autocompletado, edición en línea y un modo agente en un solo panel. Con licencia Apache 2.0, funciona con más de cien modelos, incluidos los que ejecutas de forma local con Ollama, así que tú eliges el modelo y conservas el control de tu código.
Windsurf es el editor de código agéntico creado por Codeium: un fork de VS Code cuyo agente lee tu proyecto, planifica y edita varios archivos con tu aprobación. En julio de 2025 lo compró Cognition, la empresa de Devin, y el 2 de junio de 2026 pasó a llamarse Devin Desktop; su agente Cascade llegó a su fin de vida el 1 de julio de 2026 y lo sustituyó Devin Local.
Gemini CLI es el agente de código de Google para la terminal: open source, con un contexto de un millón de tokens y el modelo Gemini 3. Desde el 18 de junio de 2026 su capa gratuita para particulares se trasladó a Antigravity CLI, pero la herramienta sigue funcionando con una clave de API de AI Studio o una licencia de empresa.
Goose es un agente de IA de código abierto creado en Block que se ejecuta en tu propia máquina como app de escritorio, CLI y API. Lee y escribe archivos, ejecuta comandos y pruebas, y funciona con más de quince proveedores de modelos y con extensiones MCP. Es gratuito, con licencia Apache 2.0, y solo pagas el uso del modelo.
OpenHands, antes OpenDevin, es una plataforma de código abierto que resuelve tareas de programación de principio a fin: recibe un encargo, abre un contenedor sandbox y edita archivos, ejecuta comandos y navega la web hasta terminar. Se ejecuta con Docker en tu propio equipo y funciona con el modelo que elijas.
El Codex CLI es el agente de código de OpenAI que trabaja dentro de tu terminal: le describes una tarea, lee tu repositorio, propone los cambios y ejecuta comandos dentro de un sandbox que tú controlas. Es open source, se instala con npm y funciona con tu cuenta de ChatGPT o con una clave de API.
Roo Code es una extensión de código abierto para VS Code, nacida como fork de Cline, que convierte el editor en un equipo de agentes con modos especializados (Code, Architect, Debug, Ask y Orchestrator). El proyecto se archivó en mayo de 2026 en la versión 3.54.0, pero su continuación comunitaria ZooCode mantiene vivas las mismas funciones.
Cline es una extensión de VS Code que convierte tu editor en un agente de código autónomo: lee tu proyecto, planifica los cambios en el modo Plan y los ejecuta en el modo Act, mostrando cada edición como un diff que tú apruebas. Es open source y funciona con tu propia clave de API o con modelos locales.
Un sistema multiagente reparte una tarea entre varios agentes especializados coordinados por un patrón de diseño. Los tres más habituales son orquestador-trabajadores, en el que un agente líder delega en subagentes paralelos; el jerárquico, con equipos de equipos; y el de red, donde cualquier agente cede el control a otro mediante un traspaso.
ReAct y plan-and-execute son los dos patrones de control de un agente de IA. ReAct decide un paso cada vez, razonando y actuando en bucle; plan-and-execute traza primero un plan completo y luego lo ejecuta paso a paso. El primero se adapta mejor a lo imprevisto; el segundo gasta menos llamadas y planifica tareas largas con más orden.
La ingeniería de contexto es el arte de decidir qué información entra en la ventana de un modelo en cada paso de un agente. Frente a la ingeniería de prompts, gestiona todo el conjunto de tokens: instrucciones, herramientas, memoria e historial. Su meta es el conjunto más pequeño de tokens de alta señal que logre la tarea.
El human-in-the-loop es el patrón que mantiene a una persona en el bucle de decisión de un agente de IA: el agente se detiene en un punto de aprobación antes de una acción irreversible, espera tu confirmación y reanuda con el estado intacto. Frameworks como LangGraph y el Agents SDK de OpenAI lo implementan con interrupciones y aprobación de herramientas.
La memoria es lo que permite a un agente de IA recordar más allá de una sola conversación. La memoria de trabajo es su ventana de contexto, efímera y limitada; la memoria a largo plazo guarda hechos, experiencias y procedimientos en un almacén externo, casi siempre una base de datos vectorial, y los recupera cuando hacen falta.
El patrón de reflexión hace que un agente critique su propia salida y la reescriba antes de darla por buena. Un modelo genera, otro paso evalúa y señala fallos, y un tercero corrige, en un bucle de una o dos rondas. Mejora la calidad en tareas con criterios claros, pero cada ciclo añade llamadas al modelo, tokens y latencia.
La planificación permite a un agente de IA resolver tareas largas: en lugar de improvisar paso a paso, primero descompone el objetivo en una lista de subtareas ordenadas y luego las ejecuta. El patrón planificador-ejecutor separa el pensamiento de la acción, reduce el número de llamadas al modelo y permite replanificar cuando algo falla a mitad del trabajo.
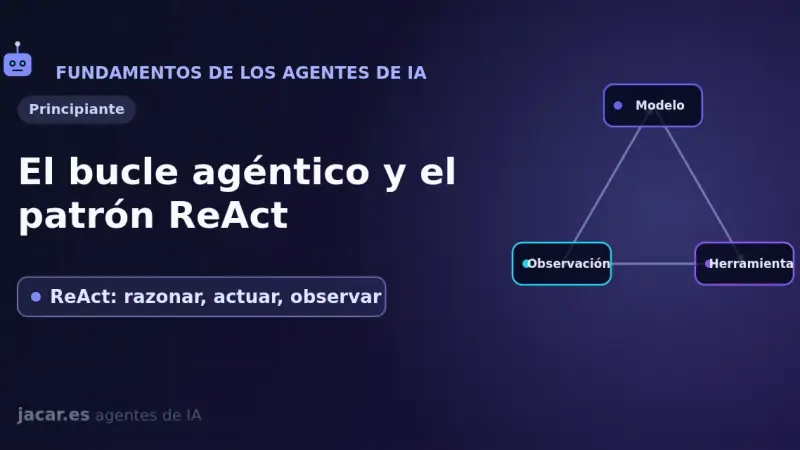
El patrón ReAct (Reason + Act) organiza un agente como un bucle de tres pasos que se repite: razonar sobre qué hacer, ejecutar una acción con una herramienta y observar el resultado. Presentado por Yao y sus colegas en 2022, entrelaza el razonamiento y la acción para que el modelo planifique, consulte fuentes externas y corrija sus errores sobre la marcha.
Un agente de IA es un programa que usa un modelo de lenguaje como cerebro para decidir por sí mismo qué pasos dar hacia un objetivo: razona, llama a herramientas externas, observa el resultado y repite ese bucle hasta terminar. A diferencia de un chatbot, no se limita a responder, sino que actúa.
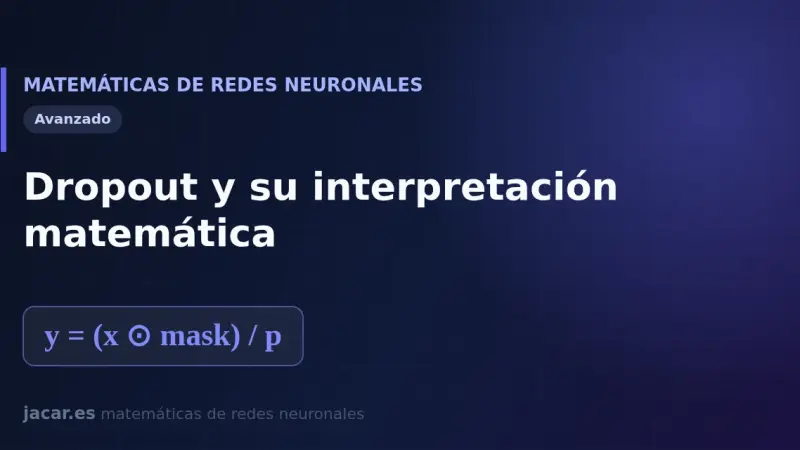
El dropout es una técnica de regularización que desactiva neuronas al azar durante el entrenamiento, con probabilidad de retención p, y divide las activaciones supervivientes entre p para conservar su escala. En inferencia la red completa actúa sin apagar nada. Matemáticamente equivale a promediar un ensemble enorme de subredes que comparten pesos.
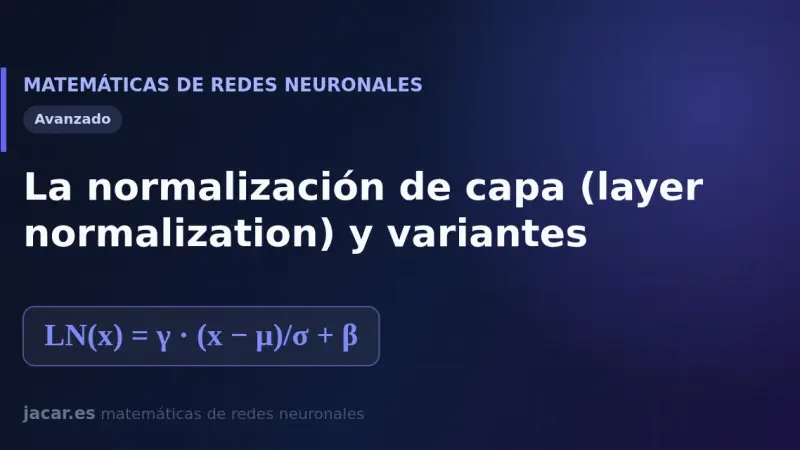
La normalización de capa estabiliza el entrenamiento normalizando cada ejemplo por separado, con la media y la desviación típica de sus propias activaciones. A diferencia de la normalización por lotes, no depende del tamaño del lote, y por eso los transformers la adoptaron. RMSNorm es su variante más ligera y extendida hoy.
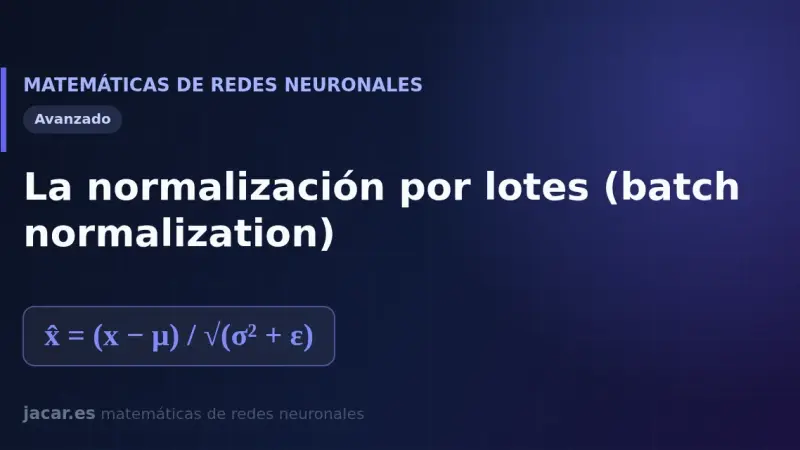
La normalización por lotes (batch normalization) es una técnica que normaliza las activaciones de cada capa usando la media y la varianza del minilote, y después las reescala con dos parámetros aprendibles, gamma y beta. Introducida en 2015, permite tasas de aprendizaje más altas, acelera el entrenamiento y estabiliza las redes profundas.
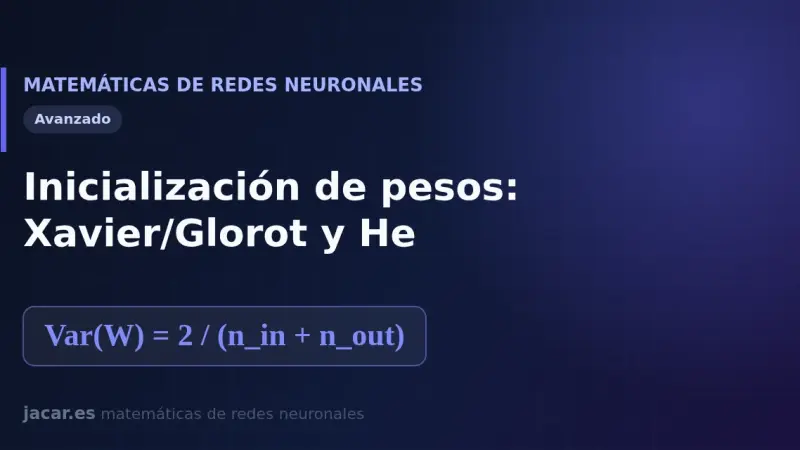
La inicialización de pesos fija la escala de los valores iniciales de la matriz W antes de entrenar. Xavier/Glorot, de 2010, reparte la varianza entre entradas y salidas y sirve para sigmoide y tanh; He, de 2015, la duplica para ReLU, que anula la mitad de las activaciones. Elegir mal frena o rompe el aprendizaje.
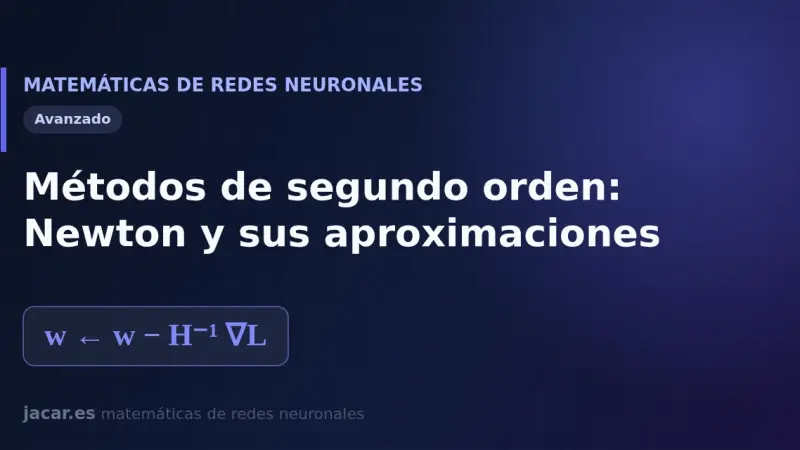
Los métodos de segundo orden usan la hessiana, la matriz de segundas derivadas de la pérdida, para orientar mejor cada paso que el gradiente solo. El método de Newton actualiza los pesos restando la inversa de la hessiana por el gradiente, pero invertirla es demasiado costoso en redes grandes, así que se recurre a aproximaciones cuasi-Newton.
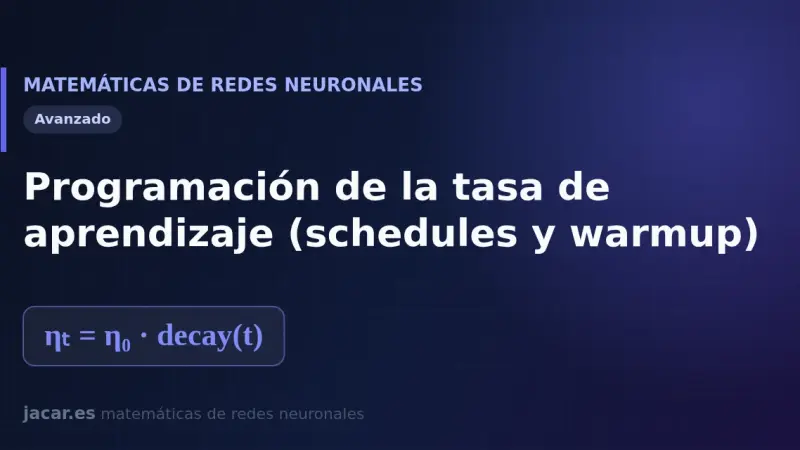
La programación de la tasa de aprendizaje cambia el valor de η a lo largo del entrenamiento en lugar de dejarlo fijo. Empieza con un calentamiento que sube η desde casi cero, mantiene un pico y después la reduce con decaimiento por pasos, exponencial o coseno para converger más rápido y con menos oscilación.
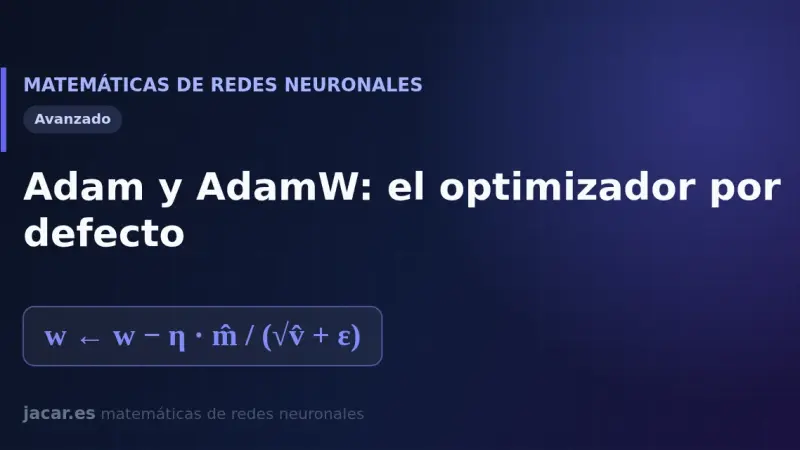
Adam combina el momento de primer orden (media móvil del gradiente) y el de segundo orden (media de sus cuadrados) para dar a cada parámetro su propia tasa de aprendizaje. Con la corrección de sesgo y los valores por defecto β1=0,9, β2=0,999 y ε=1e-8, converge rápido y casi sin ajustar nada.
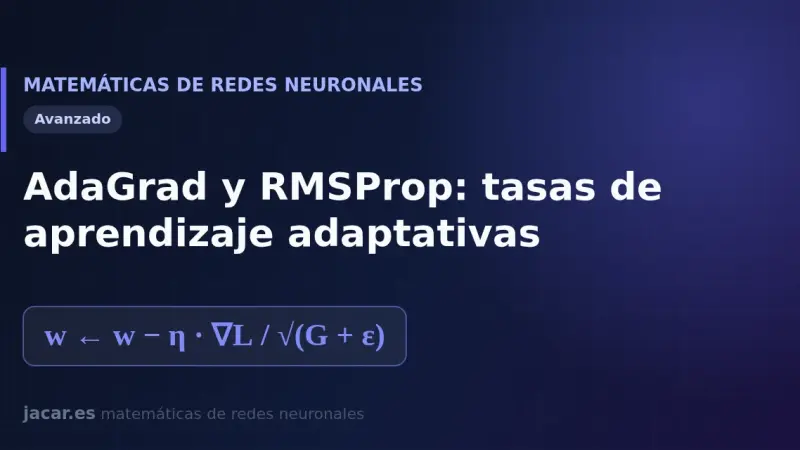
AdaGrad y RMSProp son optimizadores que dan a cada peso su propia tasa de aprendizaje. AdaGrad acumula el cuadrado de todos los gradientes y divide el paso por su raíz, lo que la apaga con el tiempo. RMSProp lo corrige con una media móvil que olvida el pasado con un factor de 0,9.
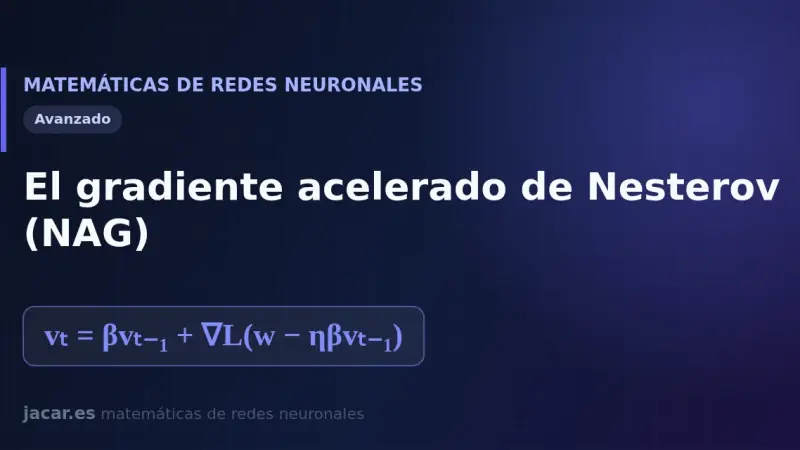
El gradiente acelerado de Nesterov mejora el momentum clásico calculando el gradiente en un punto adelantado, el que la inercia va a alcanzar, en lugar del punto actual. Ese paso de anticipación corrige la trayectoria antes de pasarse y logra una convergencia O(1/k²) en problemas convexos suaves, la más rápida posible para un método de primer orden.
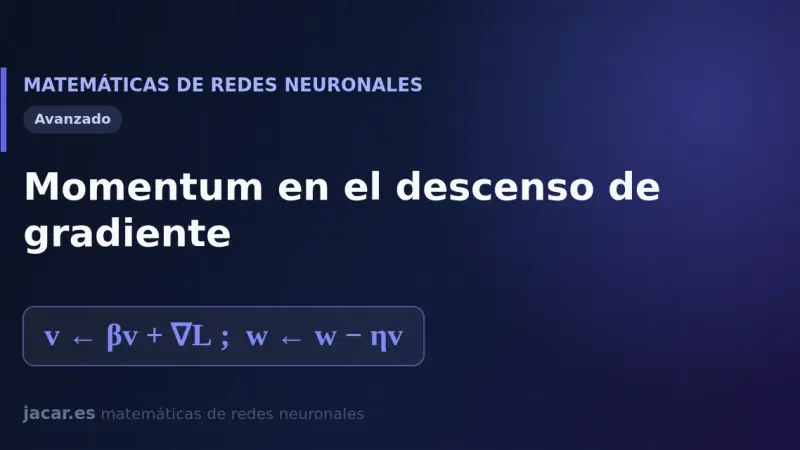
El momentum es una mejora del descenso de gradiente que acumula una velocidad a partir de los gradientes anteriores en lugar de mirar solo el actual. Con un coeficiente β cercano a 0,9, esa inercia suaviza el zigzag del SGD puro, atraviesa los valles alargados y hace que el entrenamiento converja bastante más rápido.
En redes neuronales grandes la superficie de pérdida casi nunca atrapa al entrenamiento en un mínimo local malo. El obstáculo real son los puntos de silla, mucho más abundantes en alta dimensión. Este artículo explica mínimos locales frente a globales, por qué el descenso de gradiente estocástico los esquiva y qué papel juega la convexidad.
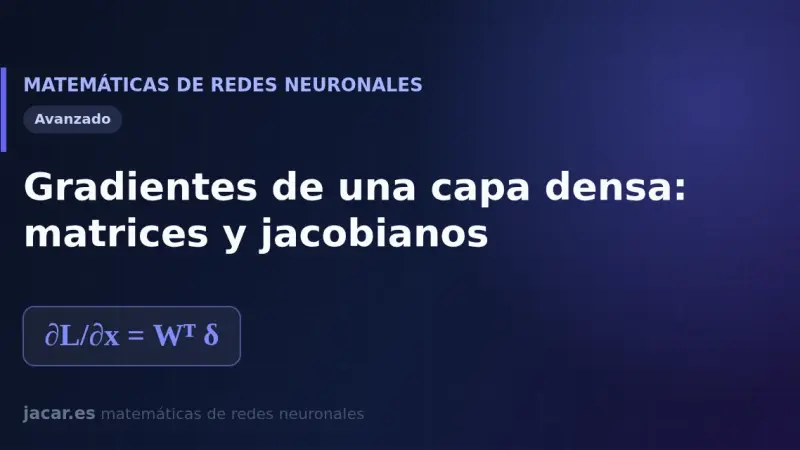
En una capa densa con z igual a Wx más b, la matriz jacobiana de la salida respecto a la entrada es la propia matriz de pesos W. De ahí salen las dos reglas del entrenamiento: el gradiente respecto a los pesos vale delta por x transpuesta, y el gradiente respecto a la entrada vale W transpuesta por delta.
Un grafo computacional representa una función como una red de operaciones elementales. La diferenciación automática recorre ese grafo para calcular derivadas exactas: el modo inverso, base de la retropropagación, obtiene el gradiente de todos los pesos en una sola pasada hacia atrás. Es el mecanismo que hace posible entrenar redes con miles de millones de parámetros.
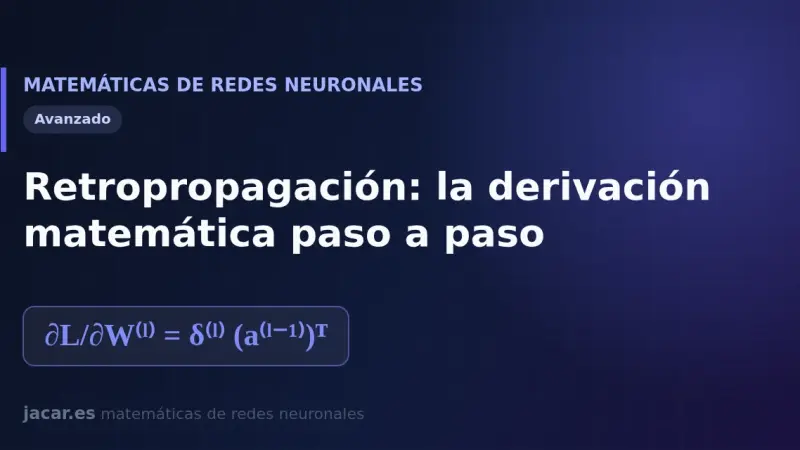
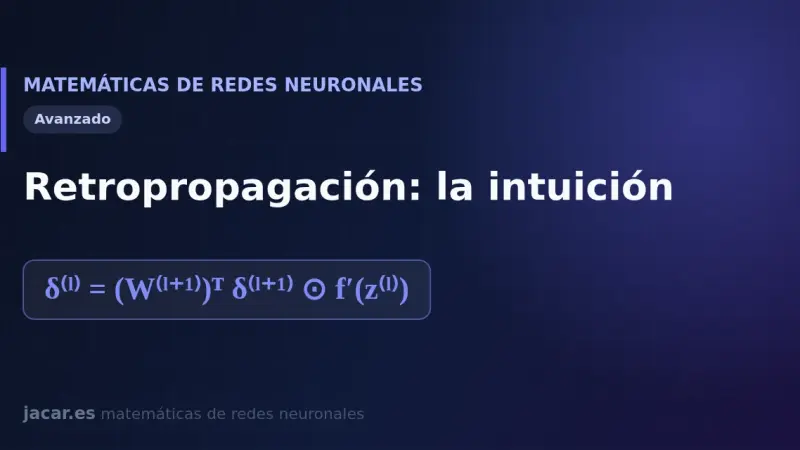
La retropropagación aplica la regla de la cadena para repartir el error de una red capa por capa. Primero se calcula el error de la última capa, luego se propaga hacia atrás y con él se obtienen los gradientes de todos los pesos y sesgos en una sola pasada, resumidos en cuatro ecuaciones.
La retropropagación reparte la culpa del error entre todos los pesos de una red neuronal. Propaga hacia atrás una señal de error capa por capa, multiplicando por las derivadas locales, y así obtiene el gradiente de cada peso en una sola pasada. Esa idea, publicada en 1986, es la que hace posible entrenar redes profundas.
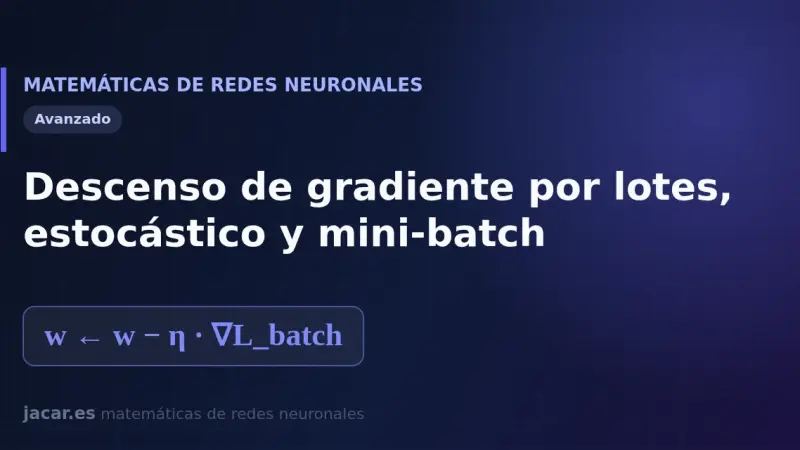
El descenso de gradiente por lotes usa todos los datos en cada paso, el estocástico usa una sola muestra y el mini-batch escoge un grupo intermedio, casi siempre de 32 a 256 ejemplos. Esta guía compara las tres variantes, su coste, su ruido y por qué el mini-batch se ha convertido en el estándar del entrenamiento.
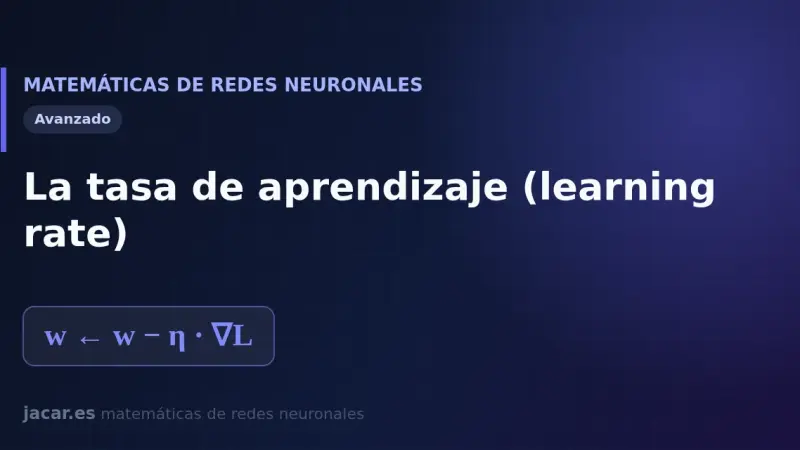
La tasa de aprendizaje es el hiperparámetro que fija el tamaño de cada paso al ajustar los pesos durante el entrenamiento. Un valor demasiado alto hace que la pérdida diverja; uno demasiado bajo la vuelve lentísima. Los valores típicos van de 0,001 con Adam a 0,1 con descenso de gradiente clásico.
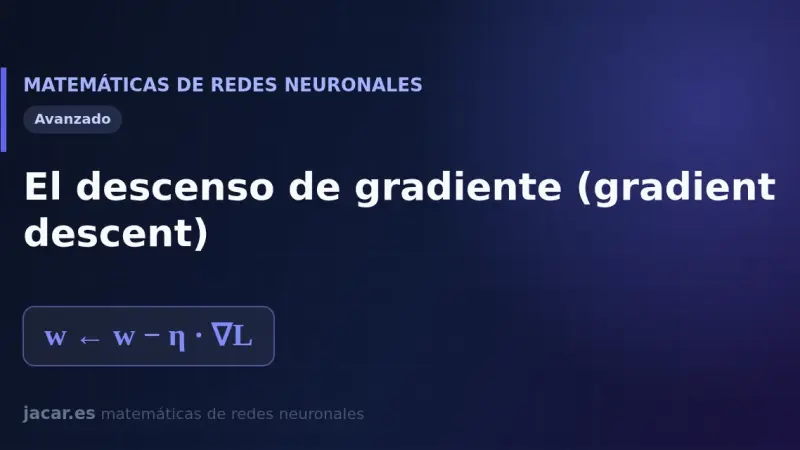
El descenso de gradiente es el algoritmo que entrena casi todas las redes neuronales. Calcula la pendiente de la función de pérdida respecto a cada peso y da un paso pequeño en la dirección contraria, controlado por la tasa de aprendizaje, hasta acercarse a un mínimo donde el error deja de bajar.
7 min26
Usamos cookies propias y de terceros para analizar el tráfico del sitio. Puedes aceptarlas, rechazarlas o configurar tu elección.
Más información sobre las cookies
Preferencias de cookies
NecesariasImprescindibles para el funcionamiento del sitio. Siempre activas.
AnalíticasNos ayudan a entender cómo se usa el sitio (Google Analytics).