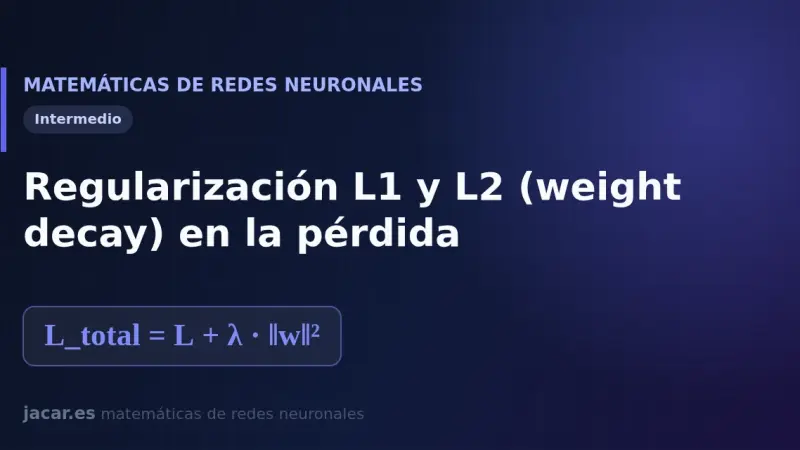
La regularización L1 y L2 añade a la función de pérdida un término que penaliza los pesos grandes. La L2, o weight decay, encoge los pesos de forma suave hacia cero; la L1 los lleva exactamente a cero y produce modelos dispersos. Ambas reducen el sobreajuste y mejoran la capacidad de generalización de una red neuronal.
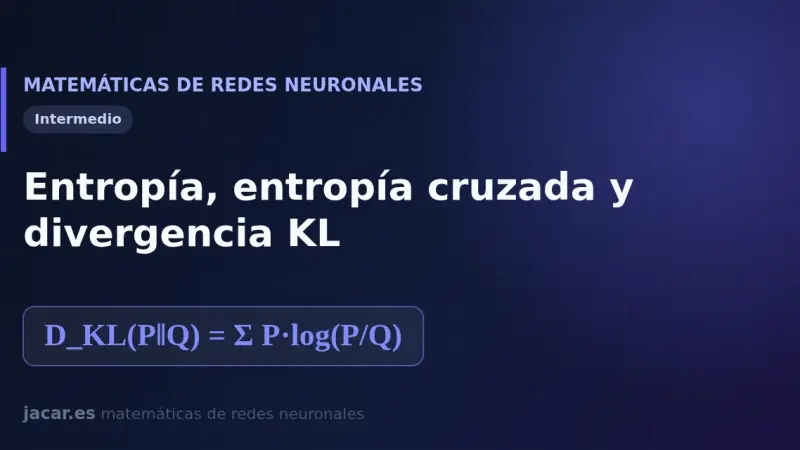
La entropía mide la incertidumbre media de una distribución en bits, la entropía cruzada mide el coste de codificar los datos reales con un modelo equivocado y la divergencia KL es la diferencia entre ambas. Por eso minimizar la entropía cruzada al entrenar equivale a minimizar la divergencia KL frente a las etiquetas.
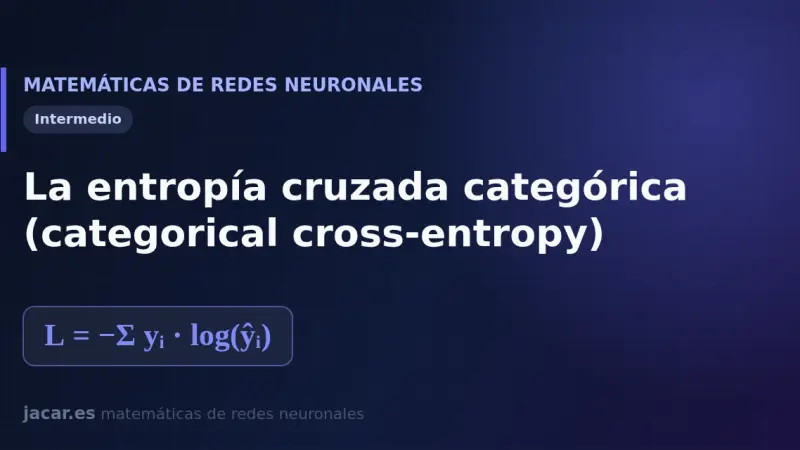
La entropía cruzada categórica es la función de pérdida estándar para clasificar en varias clases mutuamente excluyentes. Compara la distribución que predice la red, normalmente tras una softmax, con la etiqueta real codificada en formato one-hot, y penaliza con fuerza asignar poca probabilidad a la clase correcta.
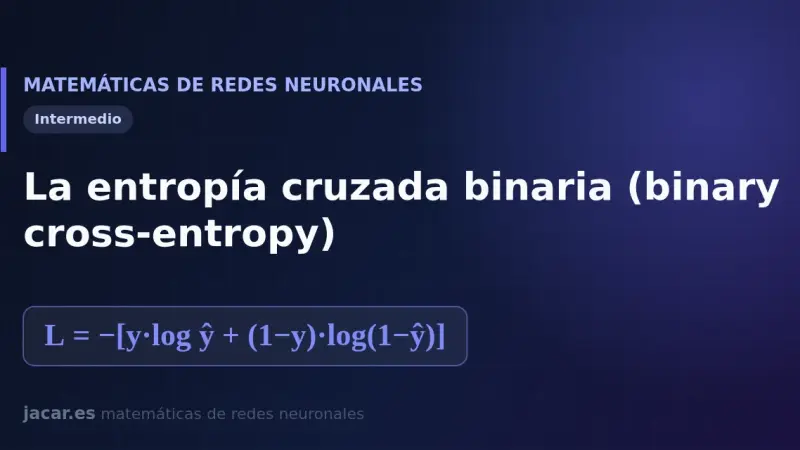
La entropía cruzada binaria es la función de pérdida estándar para clasificar entre dos clases. Compara la probabilidad que devuelve la sigmoide con la etiqueta real, 0 o 1, y castiga con fuerza los fallos seguros. Su fórmula nace de la máxima verosimilitud y su derivada se combina con la sigmoide en un gradiente muy simple.
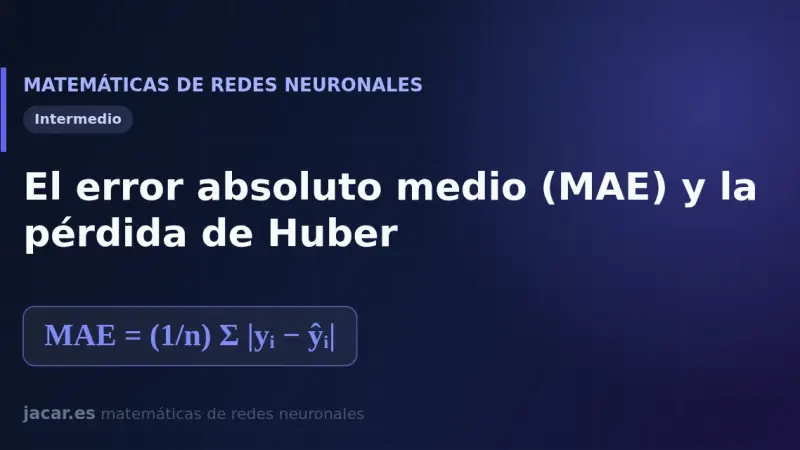
El error absoluto medio (MAE) promedia el valor absoluto de la diferencia entre predicción y realidad, así que un valor atípico pesa lo justo y no dispara la pérdida. La pérdida de Huber combina esa robustez con la suavidad del error cuadrático medio mediante un parámetro delta que decide dónde cambia de comportamiento.
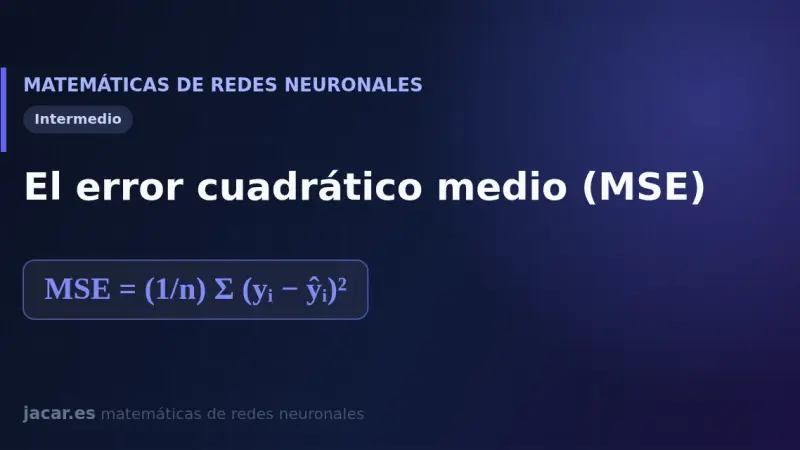
El error cuadrático medio (MSE) es la función de pérdida más común en regresión: promedia el cuadrado de la diferencia entre cada valor real y su predicción. Elevar al cuadrado castiga con fuerza los fallos grandes, hace la función derivable y fija un objetivo claro para el descenso de gradiente.
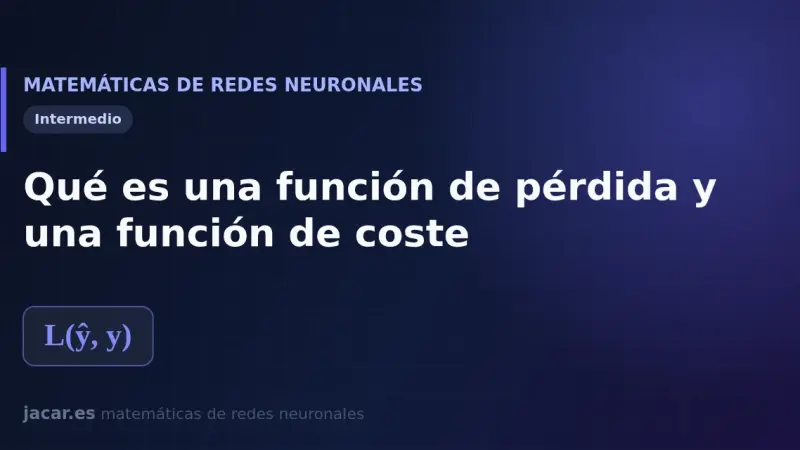
Una función de pérdida mide cuánto se equivoca una red neuronal en un solo ejemplo, comparando su predicción con el valor correcto. La función de coste promedia esa pérdida sobre todo el conjunto de datos. Ese número único es el que el entrenamiento intenta reducir paso a paso con el descenso de gradiente.
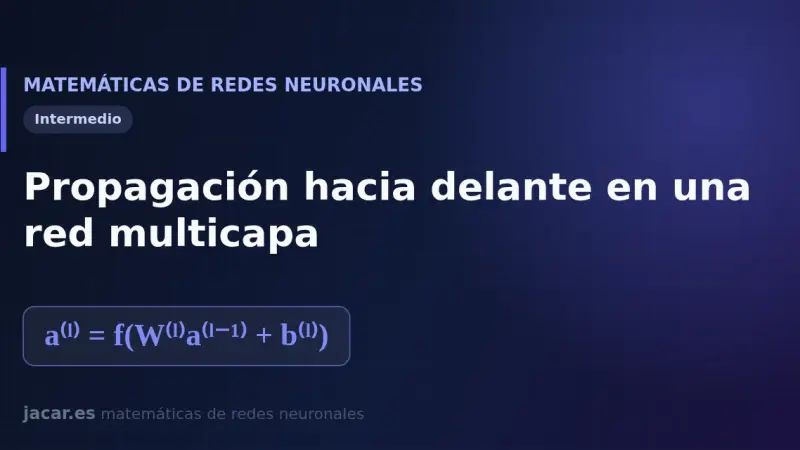
La propagación hacia delante es el proceso por el que una red neuronal transforma la entrada en una predicción, capa por capa. En cada capa multiplica el vector de entradas por una matriz de pesos, suma un sesgo y aplica una función de activación, de modo que la salida de una capa alimenta a la siguiente hasta el resultado final.
El gradiente explosivo ocurre cuando la norma del gradiente crece sin control al retropropagar el error, sobre todo en redes profundas y recurrentes con pesos grandes. El entrenamiento se desestabiliza y la pérdida se vuelve NaN. El recorte de gradiente, junto con una buena inicialización y normalización, es la solución estándar.
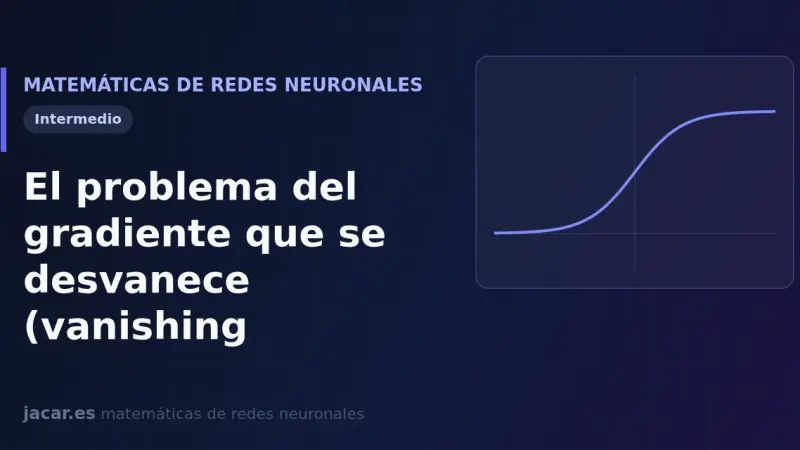
El gradiente que se desvanece aparece cuando la señal de error se encoge al retropropagarse por muchas capas. Las funciones sigmoide y tangente hiperbólica tienen derivadas pequeñas, y su producto tiende a cero, así que las primeras capas apenas aprenden. ReLU, una buena inicialización y la normalización resuelven el problema.
Elegir una función de activación es sencillo con una regla base: usa ReLU en las capas ocultas, GELU o SiLU en transformers y reserva la salida para softmax en clasificación multiclase, sigmoide en problemas binarios y una activación lineal en regresión. Esta comparativa reúne fórmulas, rangos y casos de uso.
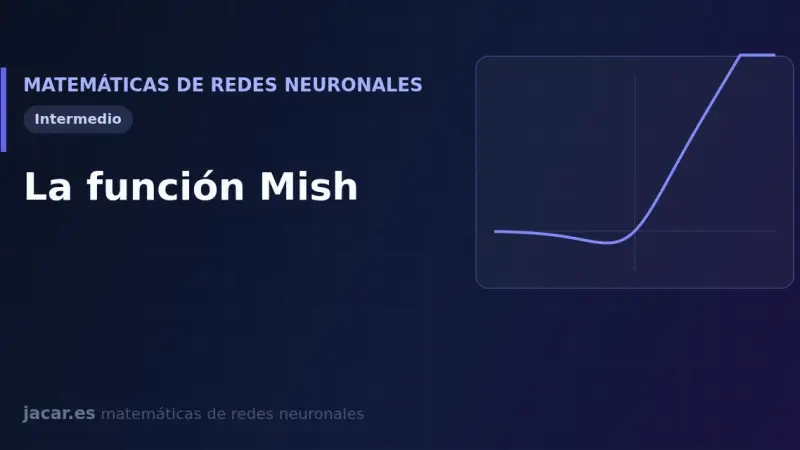
La función Mish se define como mish(x) = x·tanh(softplus(x)). Es suave, no monótona y se autorregulariza, propiedades que le permiten superar a Swish y a ReLU en muchas pruebas. El detector de objetos YOLOv4 la adoptó en su columna vertebral como activación por defecto.
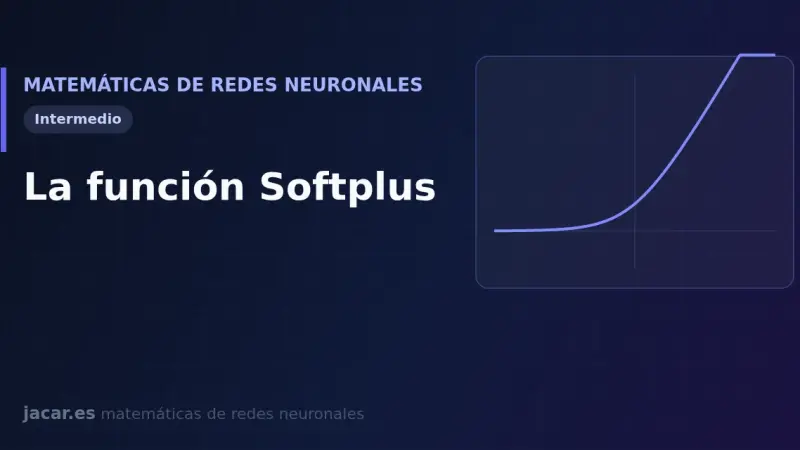
La función Softplus se define como softplus(x) = ln(1 + eˣ): una aproximación suave y siempre positiva de ReLU cuya derivada es exactamente la sigmoide. Es derivable en todo su dominio, evita el vértice anguloso de ReLU y su salida nunca llega a cero del todo.
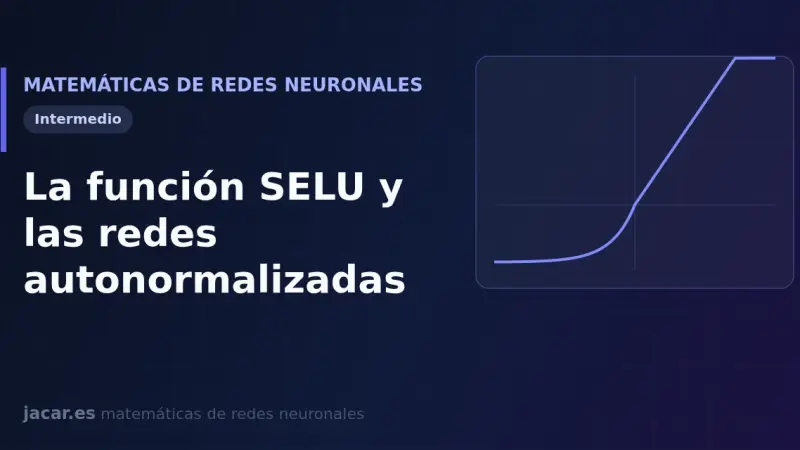
La función SELU (Scaled Exponential Linear Unit) se define como SELU(x) igual a lambda por ELU(x), con lambda cercano a 1,0507 y alfa cercano a 1,6733. Esas dos constantes hacen que las activaciones converjan solas hacia media cero y varianza uno capa tras capa, y crean redes profundas que se normalizan a sí mismas sin batch normalization.
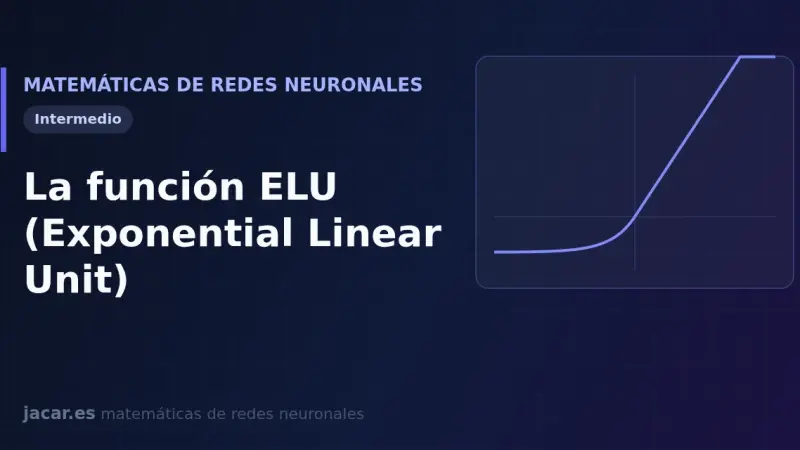
La función ELU (Exponential Linear Unit) devuelve x cuando la entrada es positiva y α(eˣ−1) cuando es negativa. Al permitir valores negativos suaves, acerca a cero la media de las activaciones, acelera la convergencia frente a ReLU y evita las neuronas muertas gracias a un gradiente que nunca se anula del todo.
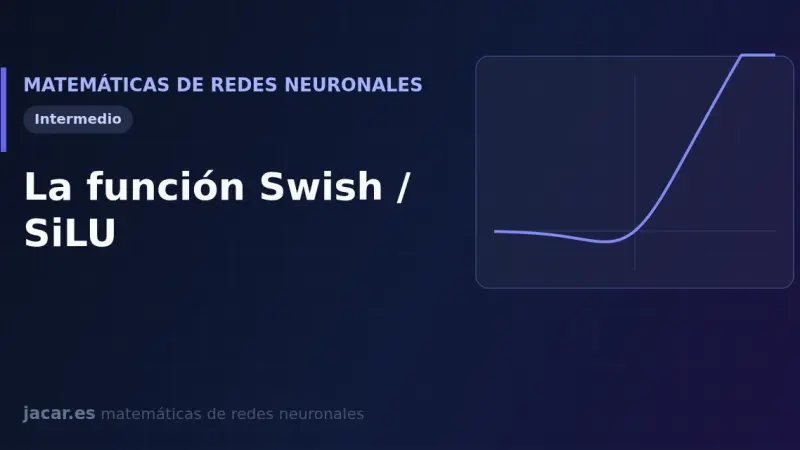
La función Swish, también llamada SiLU, multiplica la entrada por su sigmoide: swish(x) = x·σ(x). Es suave, no monótona y se autorregula, por lo que suele superar a ReLU en redes profundas. Modelos como LLaMA y EfficientNet la usan como activación por defecto.
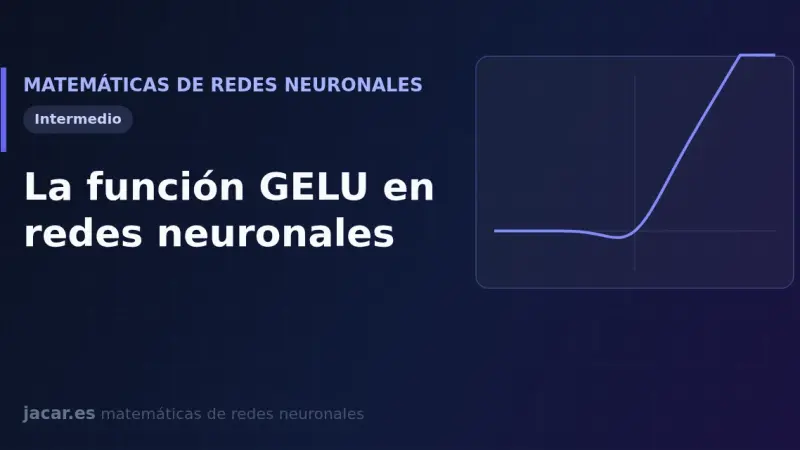
La función GELU (Gaussian Error Linear Unit) multiplica cada valor de entrada por la probabilidad de que la normal estándar sea menor que ese valor. El resultado es una curva suave, con derivada continua, que pesa las entradas por su magnitud y se ha convertido en la activación por defecto de BERT y GPT.
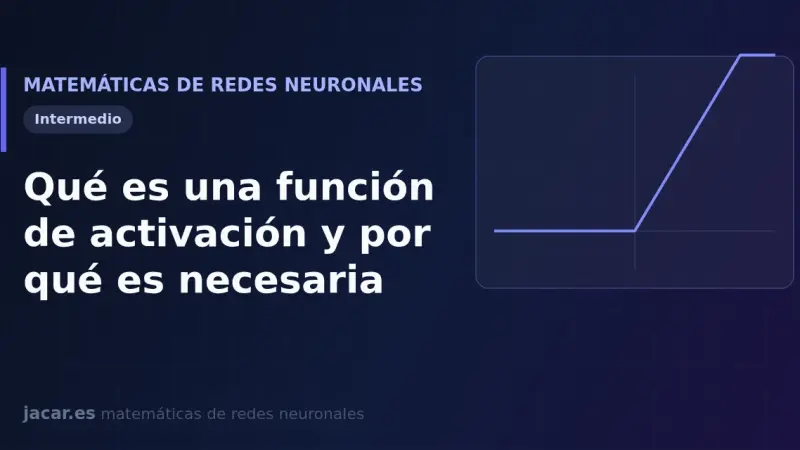
Una función de activación es la operación no lineal que cada neurona aplica a su suma ponderada z para producir su salida a igual a f de z. Sin ella, apilar capas solo encadena transformaciones lineales y toda la red se reduce a una sola. La no linealidad es lo que permite aprender patrones complejos.
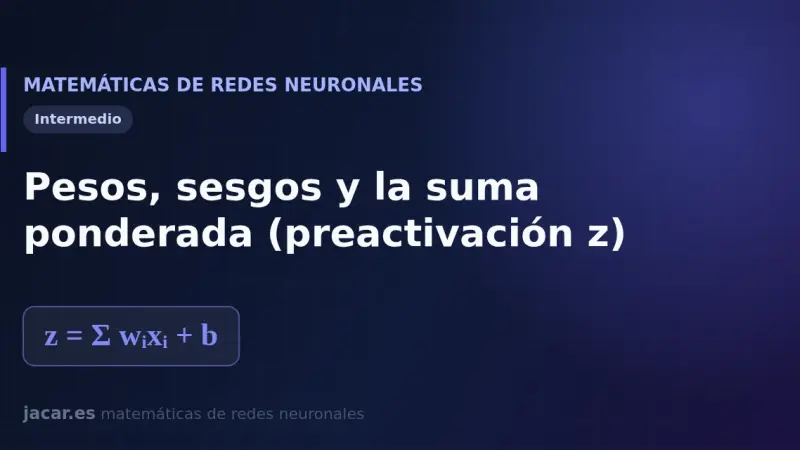
En una neurona artificial, los pesos miden la importancia de cada entrada y el sesgo desplaza el resultado. La neurona multiplica cada entrada por su peso, suma todo y añade el sesgo para obtener la suma ponderada z = Wx + b, el número que luego pasa por la función de activación.
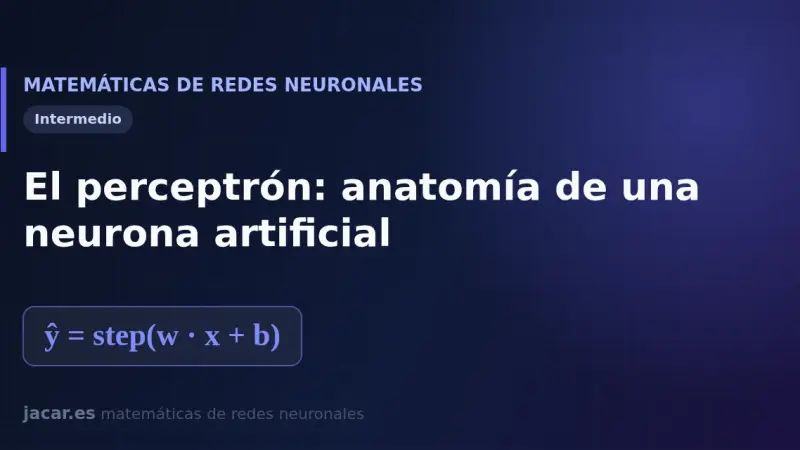
El perceptrón es la neurona artificial más simple: recibe varias entradas, las multiplica por sus pesos, suma un sesgo y aplica una función de activación que decide entre dos salidas. Frank Rosenblatt lo presentó en 1958 y sigue siendo la pieza básica con la que se construyen las redes neuronales modernas.
La probabilidad en redes neuronales aparece en tres ideas: una distribución asigna pesos a los resultados posibles, el valor esperado promedia esos resultados y la verosimilitud mide cómo de bien encaja el modelo con los datos. De esas tres piezas nacen la softmax y la entropía cruzada.
La función exponencial eˣ y su inversa, el logaritmo natural ln(x), aparecen una y otra vez en el aprendizaje profundo. La exponencial construye la sigmoide y la softmax para convertir números en probabilidades, y el logaritmo natural define la entropía cruzada, la pérdida con la que se entrenan los clasificadores.
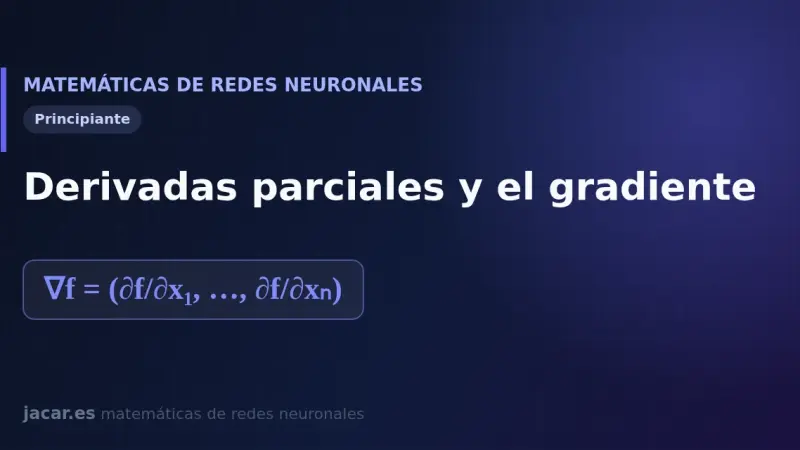
Una derivada parcial mide cómo cambia una función cuando movemos solo una de sus variables y dejamos fijas las demás. El gradiente reúne todas esas derivadas parciales en un vector que apunta hacia el ascenso más pronunciado; en una red neuronal, moverse en sentido contrario reduce el error y guía el entrenamiento.
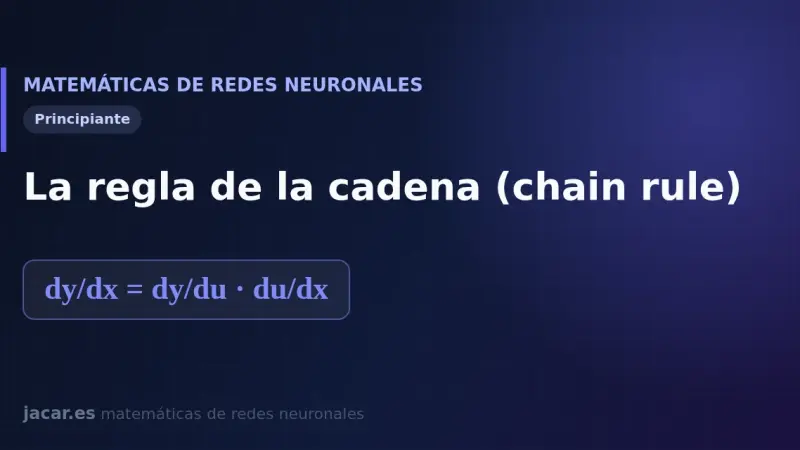
La regla de la cadena calcula la derivada de una función compuesta multiplicando las derivadas de sus eslabones: si y depende de u y u depende de x, entonces dy/dx es dy/du por du/dx. Esa multiplicación de derivadas capa por capa es exactamente lo que hace la retropropagación para entrenar una red neuronal.
Las reglas de derivación esenciales son un puñado de fórmulas que convierten cualquier función en su derivada: la regla de la potencia, las del producto y del cociente, y las del exponencial y el logaritmo. Con ellas, más la regla de la cadena, una red neuronal calcula gradientes y aprende ajustando sus pesos.
Una derivada mide la tasa de cambio de una función: cuánto varía su salida cuando la entrada cambia un poco. En una red neuronal, esa pendiente indica en qué dirección y con qué fuerza ajustar cada peso para reducir el error, y es la base del descenso de gradiente y la retropropagación.
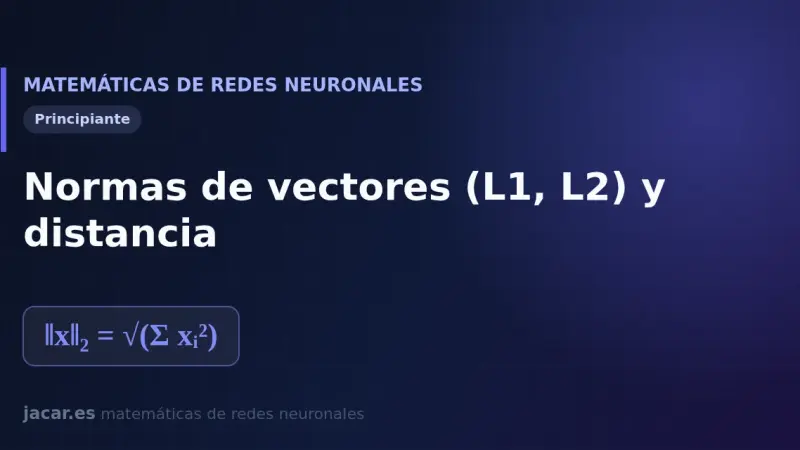
La norma de un vector mide su longitud o magnitud. La norma L1 suma los valores absolutos de las componentes y la norma L2 aplica el teorema de Pitágoras: raíz de la suma de cuadrados. Ambas definen distancias distintas entre puntos y son la base de la regularización que evita el sobreajuste en las redes neuronales.
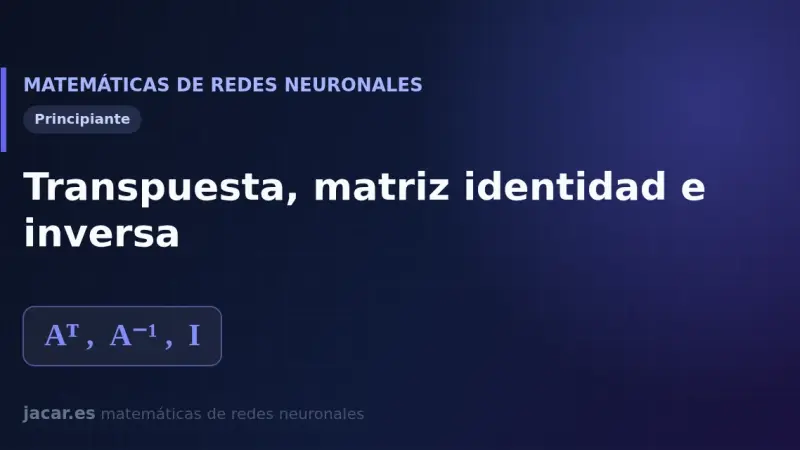
La matriz transpuesta intercambia filas por columnas y aparece en cada paso de la retropropagación; la matriz identidad actúa como el 1 del álgebra de matrices y no altera ningún vector, y la matriz inversa deshace una transformación, aunque solo existe cuando la matriz es cuadrada y su determinante no es cero.
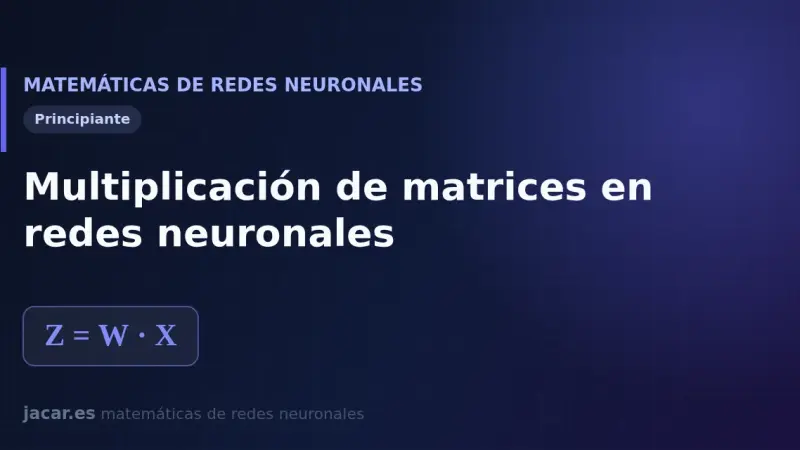
La multiplicación de matrices es la operación central de una red neuronal: cada capa agrupa sus pesos en una matriz W y calcula su salida como el producto W por X. Esa sola operación, repetida capa tras capa, es la que convierte las entradas en predicciones y explica por qué las tarjetas gráficas dominan el aprendizaje profundo.
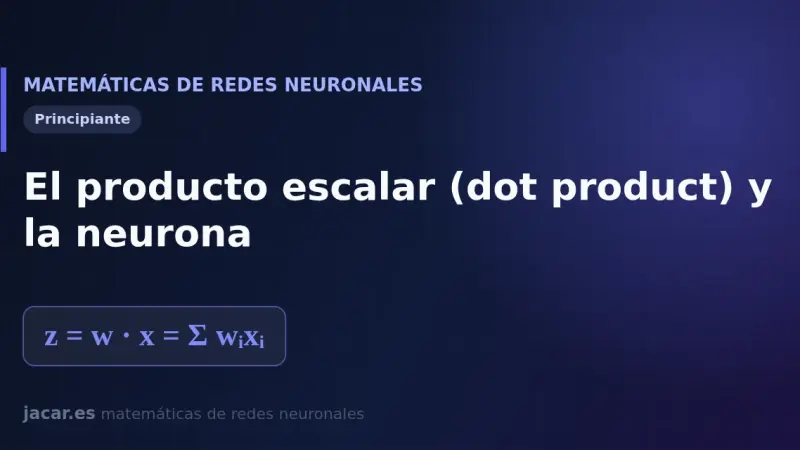
El producto escalar multiplica cada entrada por su peso y suma los resultados en un solo número. Una neurona usa esa operación para calcular su suma ponderada z igual a w por x más el sesgo b, y ese valor decide, tras la activación, cuánto se enciende la neurona ante los datos que recibe.
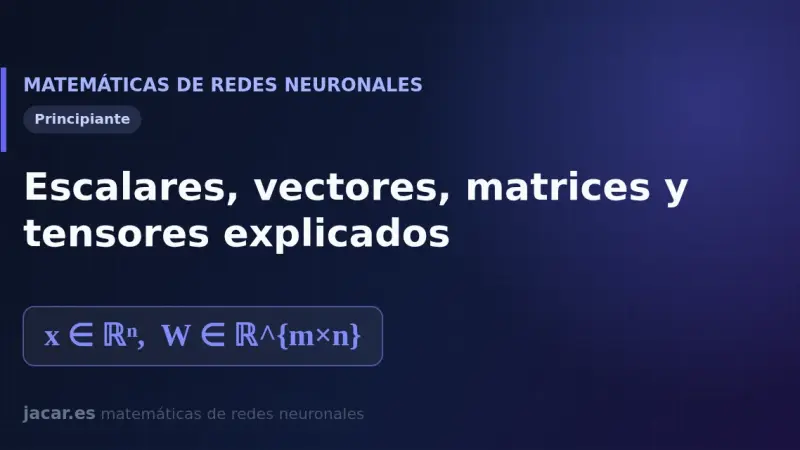
Un escalar es un solo número, un vector una lista ordenada de números, una matriz una tabla de dos dimensiones y un tensor la generalización a cualquier número de dimensiones. En una red neuronal los datos entran como vectores y los pesos forman matrices, de modo que cada capa calcula z = Wx + b combinando ambos.
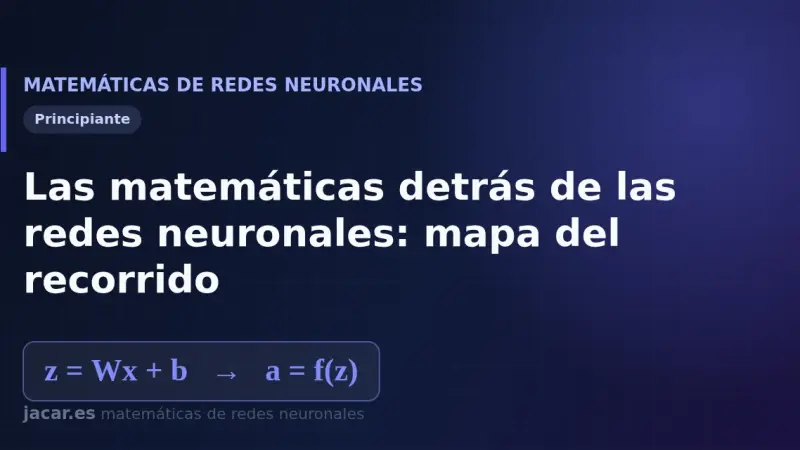
Las matemáticas de las redes neuronales se apoyan en tres bloques: el álgebra lineal representa datos y pesos como vectores y matrices, el cálculo con derivadas y la regla de la cadena permite que la red aprenda mediante el descenso de gradiente, y la probabilidad da forma a las funciones de pérdida. Este mapa recorre ese camino de principio a fin.
Docker Agent es un complemento de la línea de comandos de Docker para crear y ejecutar agentes de inteligencia artificial sin escribir código: describes el modelo, las herramientas MCP y los subagentes en un fichero YAML, arrancas todo con docker agent run y distribuyes el agente por cualquier registro OCI. Compatible con OpenAI, Anthropic, Gemini, Bedrock y Mistral.
Open GSD (Git. Ship. Done.) es un conjunto de herramientas de código abierto con licencia MIT para dirigir agentes de programación sin que pierdan el contexto: estructura el trabajo en cinco fases (discutir, planificar, ejecutar, verificar y enviar) y delega la parte pesada en subagentes con contexto limpio. Su núcleo son el motor gsd-core y el agente de terminal gsd-pi.
Un embedding vectorial es una lista de números reales que representa el significado semántico de un texto, imagen o cualquier otro dato. Dos frases con el mismo sentido producen vectores cercanos; dos sin relación, vectores lejanos. Sobre ese principio funcionan la búsqueda semántica, el RAG y los sistemas de recomendación modernos.
Postgres con pgvector es la opción por defecto para RAG en producción hasta diez millones de vectores: un índice HNSW, una base de datos y un plan de backup. Con reranking de dos etapas, búsqueda híbrida BM25 y SLOs medibles (p95 menor de 700 ms, recall@10 mayor de 0,85), la pila escala sin infraestructura adicional.
Desde el 2 de agosto de 2026 se aplican la transparencia (Art. 50) y las facultades sancionadoras de la Comisión Europea; el AI Omnibus aplazó el alto riesgo del Anexo III al 2 de diciembre de 2027. El primer paso es clasificar cada sistema en prohibido, alto riesgo, GPAI o riesgo mínimo. Checklist técnica por categoría, con plantilla descargable.
La especificación OpenTelemetry GenAI semconv define en 2026 los atributos estándar para instrumentar llamadas a LLMs, ejecución de herramientas y operaciones de agentes. Se instrumenta una vez con el SDK de Anthropic, se recolectan trazas con OTel Collector y se consultan con TraceQL en Grafana Tempo. El resultado es un dashboard portable que sobrevive a cambios de modelo, proveedor y framework sin reescritura.
Receta para oMLX 0.6.4 en un Mac M5 Max con 128 GB: instalación, Claude Code y ajustes avanzados con capturas (Lightning MTP, VLM MTP y DFlash). Incluye benchmarks propios de septiembre de 2026, con hasta 1,88x más tokens por segundo.
LangGraph, CrewAI y Autogen son los tres frameworks de referencia para sistemas multi-agente en 2026. Cada uno encarna un modelo mental distinto: grafo explícito, jerarquía de roles o conversación de grupo. Esta guía compara los tres con código real, resuelve el mismo pipeline de investigación tres veces y explica cuándo elegir cada uno.
Esta guía muestra cómo construir un agente productivo con el SDK de Anthropic en Python: el bucle de tool use con la Messages API, streaming con backpressure mediante una cola acotada, prompt caching con cache_control, un servidor MCP propio registrado con el Claude Agent SDK, trazas OTel GenAI y un contenedor Docker no-root listo para producción.
Tres agentes de código (Claude Code, Cursor y GitHub Copilot) medidos sobre cinco tareas reales de un equipo de plataforma: endpoint REST, refactor multi-fichero, depuración de CI, revisión de PR de seguridad y ficheros de fixtures. Claude Code lidera en refactor y revisiones; Cursor brilla en exploración interactiva; Copilot sigue siendo el más ágil para autocompletado puntual.
Tras dieciocho meses de adopción multi-vendor, MCP es el estándar de hecho para conectar modelos a herramientas. Esta es la guía completa: arquitectura, servidores, políticas, autenticación, composición y los antipatrones que ya hemos visto en producción.
Los datos sintéticos han dejado de ser un sustituto precario de los datos reales para convertirse en un componente central del entrenamiento moderno de modelos: el patrón más fiable amplía un núcleo real de 500 ejemplos con miles de parafraseos sintéticos, siempre que se valide diversidad, corrección y distribución, y se mantenga al menos un 30% de datos reales para evitar el colapso del modelo.
El Model Context Protocol, propuesto por Anthropic a finales de 2024 y adoptado durante 2025-2026 por Anthropic, OpenAI, Google y la comunidad open source, ya tiene patrones operativos probados: separar servidores genéricos de los propios, políticas explícitas por herramienta, credenciales fuera del modelo, composición con prefijos y tests de contrato. Este es el estado del arte en 2026.
Usar un LLM como juez de otro LLM se generalizó en 2024 y sigue siendo, en 2026, la única forma escalable de evaluar calidad cualitativa en sistemas con LLM. Es fiable si la correlación juez-humano supera 0,7 en 30 casos y se recalibra cada trimestre; por debajo de ese umbral, no fiarse del número.
Claude Sonnet 4.6 es el modelo por defecto en la mayoría de cargas de producción de 2026: cubre el 80% del tráfico con calidad indistinguible de Opus 4.7 en pruebas ciegas y un coste por token que ronda el 60% del de Opus. Sigue haciendo falta Opus en razonamiento complejo y coding agéntico sobre bases grandes.
El RAG híbrido en 2026 combina búsqueda densa y léxica fusionadas con RRF, reranking cross-encoder sobre los top-50, chunking consciente de estructura y evaluación continua con Ragas o TruLens. Es el patrón que sobrevive en sistemas serios tres años después del boom inicial de embeddings.
5 min6614,6
Usamos cookies propias y de terceros para analizar el tráfico del sitio. Puedes aceptarlas, rechazarlas o configurar tu elección.
Más información sobre las cookies
Preferencias de cookies
NecesariasImprescindibles para el funcionamiento del sitio. Siempre activas.
AnalíticasNos ayudan a entender cómo se usa el sitio (Google Analytics).