
Ruta de aprendizaje Intermedio
LLMs en local: ejecuta modelos en tu hardware
Ejecuta modelos de lenguaje en tu propio hardware, sin API ni cuotas: de Ollama a servir modelos grandes en un Mac, más memoria vectorial para RAG.
- 10 recursos
- 10 visitas
- ~165 min
Ejecuta modelos de lenguaje en tu propia máquina — sin claves de API, sin cuotas y con tus datos siempre en casa. La ruta va de la instalación de Ollama al ajuste fino en un Mac con Apple Silicon, y termina dándole memoria a tu modelo con una base de datos vectorial para RAG.

Cómo instalar Ollama para ejecutar LLM en tu ordenador
Ollama hace trivial ejecutar modelos como Llama 2 o Mistral en tu propio ordenador: un binario, un comando y los pesos cuantizados descargándose al disco sin compilar nada. Esta guía cubre la instalación en macOS, Linux y Windows, con una valoración honesta de lo que la inferencia local puede y no puede hacer frente a los modelos de frontera.

Cómo instalar Ollama en macOS con Apple Silicon
Instalar Ollama en un Mac con Apple Silicon es tan simple como ejecutar un comando de Homebrew. Después, elige el modelo según la RAM disponible (Phi-3 con 8 GB, Llama 3.1 8B con 16 GB) y expón la API HTTP local, compatible con OpenAI, en el puerto 11434 para integrarla en tus propias aplicaciones.
Cómo instalar llama.cpp en Linux, macOS y Docker
Para instalar llama.cpp tienes cuatro vías: el script de llama.app, que deja un binario llama de 15 MB en ~/.local/bin; Homebrew; la imagen Docker server-v0.4.1; o CMake. Las probé el 14 de septiembre de 2026 en Linux arm64 con Gemma 4 E2B, en la terminal con llama cli y como API compatible con OpenAI.
Gemma 4 en local, qué variante cabe en tu GPU
Gemma 4 llega en cinco tamaños con licencia Apache 2.0. Cuantizados a 4 bits, los pesos van de 2,9 GB en el E2B a 17,5 GB en el 31B según la tabla de Google, así que la variante la decide tu memoria. Y la ventana de 256K suma otros 10 GiB de caché.
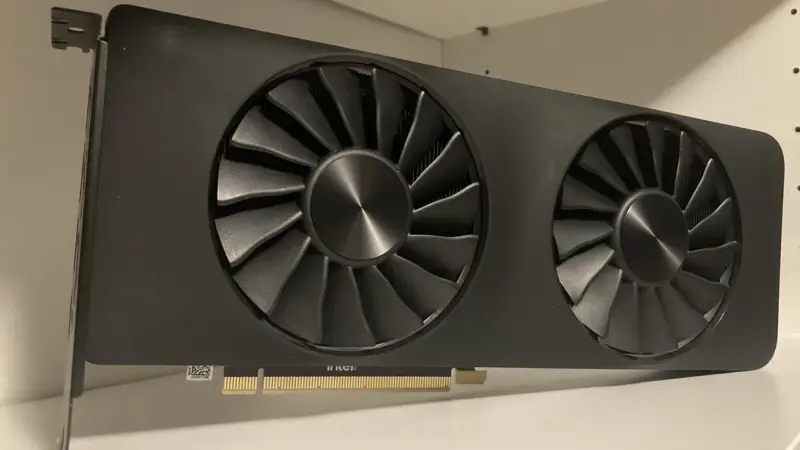
Modelos multimodales en local: la cuenta de VRAM en una tarjeta de 16 GB
Qwen3-VL 8B en Q4_K_M son 4,68 GiB de pesos más 1,08 GiB de torre de visión, y su cache KV cuesta 144 KiB por token. Con 8.192 tokens de contexto la suma ronda los 7 GiB y cabe de sobra en 16 GB; con los 256K nativos pediría 36 GiB solo de cache y no cabe en ninguna tarjeta de consumo.
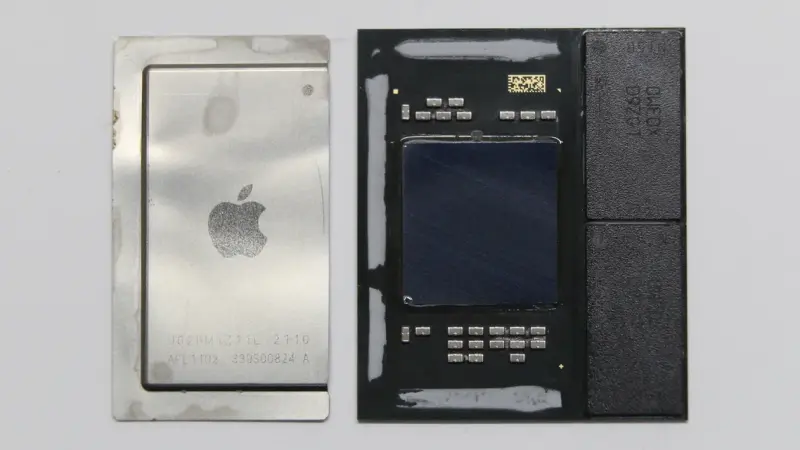
Maple-Preview, MiniCPM5-2B o Spark-X2.5, qué LLM sin GPU elegir para una CPU arm64
Sin GPU, en una CPU arm64 de 18 núcleos con llama.cpp v0.4.1, Maple-Preview generó 172,84 tokens/s con 6 hilos: el doble que MiniCPM5-2B y 3,6 veces Spark-X2.5-4B. A cambio ocupa 5,79 GiB de RAM y siempre razona. MiniCPM5 cabe en 3,27 GiB y Spark escribe mejor en español. Los tres inventaron datos.
Qué es oMLX y en qué se diferencia de MLX, Ollama y LM Studio
oMLX es un servidor de inferencia local para Mac con Apple Silicon que envuelve el framework MLX de Apple y lo expone con las API de OpenAI y de Anthropic. Desde Ollama 0.40 los tres grandes servidores usan MLX en un Mac, así que lo que distingue a oMLX es la memoria: varios modelos cargados con expulsión y fijado, y una caché KV en el SSD que sobrevive a los reinicios.
Cómo instalar oMLX en M5 Max 128 GB y exprimirlo al máximo
Receta para oMLX 0.6.4 en un Mac M5 Max con 128 GB: instalación, Claude Code y ajustes avanzados con capturas (Lightning MTP, VLM MTP y DFlash). Incluye benchmarks propios de septiembre de 2026, con hasta 1,88x más tokens por segundo.

Cómo instalar PostgreSQL con pgvector paso a paso
Esta guía instala PostgreSQL 18.6 con pgvector 0.8.7 en Debian o Ubuntu desde el repositorio PGDG, crea un rol y una base dedicados, ajusta la memoria, construye un índice HNSW y lo verifica con EXPLAIN. La 0.8.7 corrige CVE-2026-103484, un desbordamiento de búfer en la construcción de índices IVFFlat.
Calculadora LLM en local
¿Cabe ese modelo en tu GPU? ¿Sale más barato auto-alojarlo que la API? Calcula la VRAM y el punto de equilibrio de costes.