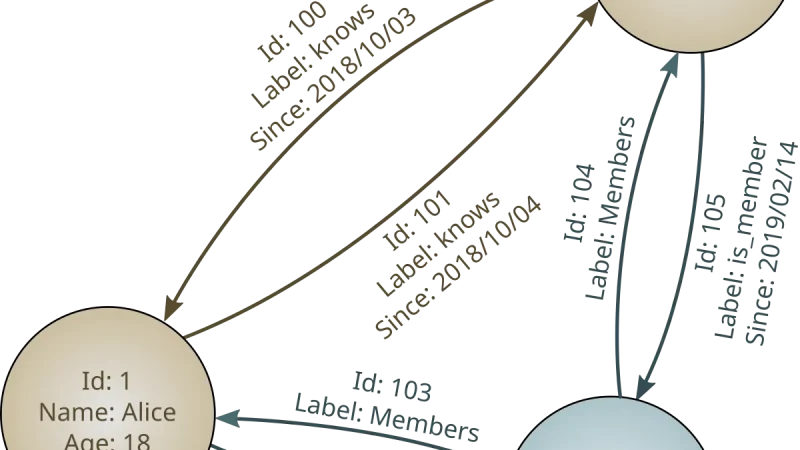
Un año después de que GraphRAG saliera de laboratorio, queda una estadística clara: funciona donde la información corporativa tiene relaciones densas, falla donde solo hay documentos sueltos. Patrones, costes y decisiones de arquitectura que han sobrevivido.
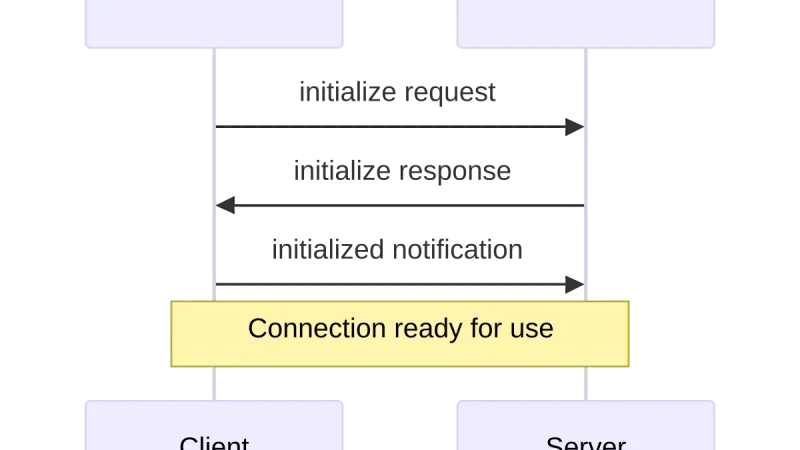
Model Context Protocol ha pasado de propuesta a estándar de facto para conectar editores con herramientas. Guía práctica para levantar un servidor MCP local, conectarlo a VS Code o a tu cliente favorito y entender qué estás exponiendo realmente.
Tras dos años de pilotos y un año de agentes en producción, la gobernanza ha pasado de comité aspiracional a control operativo. Qué piden las auditorías, qué rompió en 2025 y qué barandillas están absorbiendo la mayoría de los incidentes.
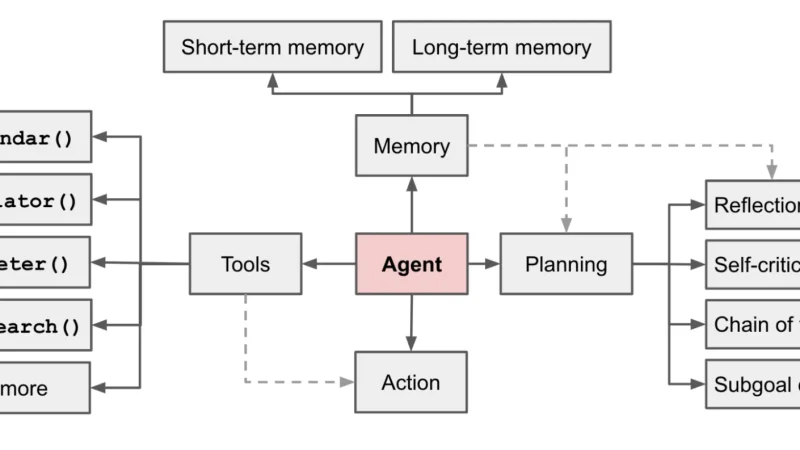
Durante 2025 cientos de equipos pusieron agentes IA en producción real. A principios de 2026, con datos suficientes, emergen lecciones consistentes sobre qué falla, qué funciona, cuánto cuesta y qué tareas no encajan. Repaso ordenado para equipos que empiezan ahora.
Veinte meses después del anuncio inicial, Model Context Protocol pasó de curiosidad a estándar de facto entre clientes y servidores de agentes. Qué hay disponible, qué servidores merecen la pena, qué problemas siguen abiertos y cómo se parece al mapa de protocolos anteriores.
La Ley de IA europea iba a entrar en aplicación plena para sistemas de alto riesgo en agosto de 2026. El Digital Omnibus, aprobado por el Parlamento y el Consejo en junio de 2026, retrasa esa fecha 17 meses, hasta diciembre de 2027. Qué obligaciones rigen ya y qué cambia de verdad.
La factura de IA en las empresas ha dejado de ser anecdótica. Entre tokens de modelos frontera, GPUs reservadas que nadie usa y pipelines RAG con cachés mal configuradas, muchos equipos pagan diez veces lo que deberían. Guía de FinOps específico para IA sin relatos promocionales.
Tras dieciséis meses desde la primera versión de computer use de Anthropic y el empuje paralelo de browser-use, OpenAI Operator y Gemini Computer Use, los agentes que manejan navegador y escritorio han pasado de demo a flujos reales. Toca revisar qué patrones sobreviven cuando los ejecutas todos los días en producción.
Una selección de postmortems publicados entre 2025 y 2026 por equipos que operan sistemas con IA en producción revela patrones repetidos: fallos en guardrails, deriva silenciosa de modelos, dependencia oculta del proveedor y una colección de sustos que vale la pena destilar.
Tres años de valoraciones vertiginosas han empezado a corregirse sin estrépito pero con firmeza: rondas abajo, despidos selectivos y consolidación en torno a propuestas con ingresos reales. Una lectura ordenada de qué sobrevive, qué se quema y qué aprende el ecosistema.
Anthropic publicó Haiku 4.5 en octubre de 2025 y el modelo ha madurado rápido: rendimiento cercano a Sonnet 4 en tareas estructuradas a un tercio del coste, ventana amplia y latencia baja. Es la pieza que faltaba para desplegar agentes a escala sin quemar presupuesto.
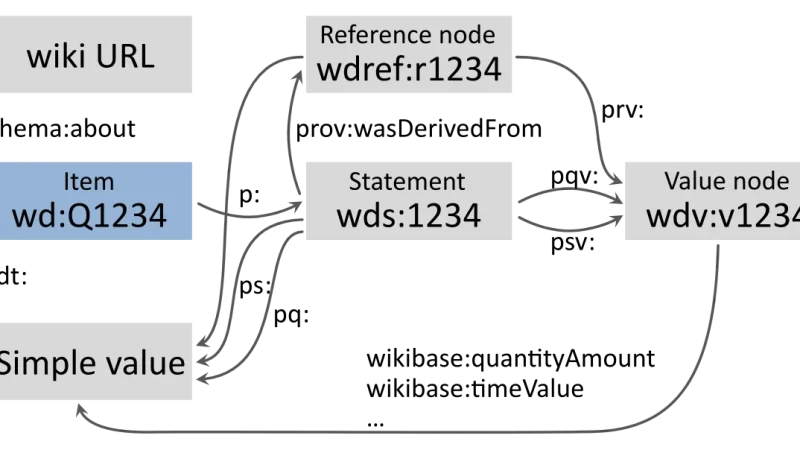
Los grafos de conocimiento llevaban dos décadas esperando su momento. Con los LLM como puente entre texto y ontología, y el patrón GraphRAG ya maduro, la tecnología vuelve al primer plano. Toca revisar por qué ahora sí encaja y dónde conviene usarla.
Después de dos años viendo cómo cada producto inventaba su propia interfaz para hablar con un agente, en enero de 2026 empieza a emerger un consenso estable sobre qué patrones funcionan, cuáles no y qué espera ya el usuario medio. Toca recoger lo que ha quedado.
Seis meses después de que A2A llegara a la Linux Foundation, y tras varios ciclos de implementación por parte de Google, Microsoft y proyectos abiertos, qué significa la versión 1 del protocolo y si ya es seguro construir sobre él.
El discurso de la IA soberana europea lleva tres años alimentando titulares, inversiones públicas y acuerdos interestatales. Empezamos a ver qué parte de la promesa tiene sustancia técnica y qué parte sigue siendo narrativa política, con Mistral, Aleph Alpha y la red de supercomputación EuroHPC como ejes.
Con MCP resolviendo la conexión entre agente y herramientas, el siguiente cuello de botella aparece: cómo hablan entre sí dos agentes de distintos proveedores. Agent2Agent de Google, donado a la Linux Foundation en 2025, intenta ocupar ese hueco.
Phi-3 es la familia de modelos pequeños de lenguaje que Microsoft viene puliendo desde abril de 2024 con variantes de 3.800 millones, 7.000 millones y 14.000 millones de parámetros. Después de año y medio, el panorama del edge con SLM abiertos se ha vuelto serio y Phi-3 ocupa un sitio claro.
Los modelos grandes de lenguaje llevan dos años prometiendo documentar código, APIs y arquitecturas sin esfuerzo. Después de ver docenas de proyectos intentarlo, hay patrones claros de dónde funciona y dónde acaba siendo una deuda más.
Los frameworks de guardrails prometen filtrar entradas y salidas de modelos de lenguaje para bloquear fugas de datos, contenido dañino o alucinaciones. Tras evaluar cuatro de los más populares en producción, repaso qué hacen realmente, qué coste en latencia y factura añaden y cuándo compensan frente a controles más simples.
Los agentes que encadenan llamadas a modelos, herramientas y memoria son difíciles de depurar sin una instrumentación pensada para ellos. Después de un año largo operando agentes en producción, repaso qué hay que medir primero, qué estándares están consolidándose y qué errores caros evita tener trazas bien hechas desde el inicio.
Un proxy con caché delante de un modelo de lenguaje puede reducir la factura de tokens de forma significativa, pero introduce riesgos sutiles si el diseño no es cuidadoso. Qué tipos de caché funcionan en producción, dónde están las trampas habituales y cómo integrarlos sin degradar la experiencia.
Un enrutador de inferencia decide qué modelo atiende cada petición en función de coste, latencia y complejidad. Bien diseñados reducen la factura de tokens sin que el usuario perciba degradación; mal diseñados introducen fallos sutiles difíciles de depurar.
Probar sistemas que incluyen modelos de lenguaje rompe la primera regla del testing: la misma entrada da la misma salida. Analizo las estrategias que han funcionado tras un año largo integrando IA en productos reales, por qué los tests deterministas tradicionales no bastan y cómo plantear un cinturón de pruebas que capture regresiones sin bloquearse en la varianza.
El término Agent OS lleva un año ganando tracción entre investigación y producto. Describe una capa que va más allá de una biblioteca de agentes: planificador, gestión de contexto, memoria persistente y aislamiento. Una lectura del estado real de ese concepto.
Model Context Protocol cumple diez meses desde su anuncio de Anthropic y ya no es una propuesta: hay cientos de servidores, implementaciones cruzadas entre proveedores y un registro público. Repaso de qué ha funcionado, qué sigue flojo y por qué 2025 marca el paso de curiosidad a infraestructura básica.
Tras meses de rumores, OpenAI publicó GPT-5 a principios de agosto. Las primeras semanas de uso real dejan una imagen menos espectacular que el marketing y más útil que lo que muchos esperaban. Vale la pena separar lo nuevo de lo incremental.
Desde el 2 de agosto de 2025 son aplicables las obligaciones de la Ley de IA europea para modelos de propósito general, autoridades nacionales y régimen sancionador. Un repaso a lo que cambia para quienes desplegamos IA en Europa.
Redis 8.2 incorpora la búsqueda vectorial como tipo de dato nativo. La duda real es si sustituye a un motor dedicado como Qdrant, Weaviate o pgvector en cargas con millones de vectores y latencias exigentes, o si solo sirve como complemento del caché que ya tienes.
Los modelos pequeños de lenguaje se han vuelto útiles de verdad. Phi-3.5, Gemma 2 o Llama 3.2 caben en dispositivos modestos y resuelven tareas acotadas sin salir a la nube. Repaso de dónde encajan en planta y cuándo compensa saltarse el modelo grande.
El RAG de 2023 era búsqueda vectorial con un LLM detrás. El de 2025 es un sistema híbrido que combina vectores, búsqueda léxica y grafos de conocimiento. Qué ha cambiado, dónde funciona cada pieza y qué decisiones marcan la diferencia entre un RAG útil y uno decepcionante.
Casi nueve meses después del lanzamiento de Computer Use, algunos equipos lo han llevado a producción para tareas reales. Dónde funciona, dónde todavía no conviene, y qué patrones están emergiendo para que un agente que maneja ratón y teclado no acabe siendo más problema que solución.
Los editores de código han empezado a incorporar MCP como cliente nativo: VS Code, Zed, Cursor y varios forks de Neovim. Esto cambia la forma en que el agente accede al contexto del proyecto y abre preguntas prácticas sobre qué servidores activar y cómo configurarlos sin abrir puertas.
Los agentes de IA empiezan a tener un hueco serio en los pipelines de integración continua: revisar diffs, proponer arreglos, generar tests que faltan. Seis meses de uso real para separar los patrones que funcionan de los que acaban costando más tiempo del que ahorran.
Google publicó Gemini 2.5 Pro en vista previa en marzo y la versión general llegó en junio. El salto respecto a Gemini 2.0 no está solo en puntuaciones sino en dos frentes prácticos: ventana de contexto utilizable en serio y multimodalidad que deja de ser demostración para convertirse en herramienta.
Anthropic presentó Claude Opus 4 y Claude Sonnet 4 el 22 de mayo de 2025, el primer salto grande de nomenclatura desde la serie 3.5. Un mes de uso real en código, documentación técnica y agentes para separar lo que ha mejorado de lo que sigue igual.
Un año después de que la interfaz de chat dejara de ser la única forma aceptable de hablar con un agente, aparecen patrones de UI pensados específicamente para tareas de agente. Repaso los que empiezan a cuajar y los que solo son moda de ciclo.
Revisión de septiembre de 2026 de los servidores MCP que uso a diario: filesystem, git, fetch y memory siguen siendo de referencia, y DBHub sustituye al servidor de Postgres archivado. El registro oficial verifica quién publica, no la seguridad del código, así que aplico cinco criterios y listo las herramientas con el MCP Inspector antes de conectar nada.
Prompt injection es la vulnerabilidad más común en aplicaciones con LLM y mucha gente la defiende con filtros que no sirven. Revisamos capas de defensa con evidencia, qué sí funciona y qué es teatro de seguridad.
Durante una década, los grafos de conocimiento fueron una idea académica con pocos casos de uso reales, frenada por el coste de construir y mantener el esquema. Los LLM han cambiado esa ecuación: ahora extraen entidades automáticamente y sirven para anclar respuestas, auditar razonamiento y sostener agentes sin alucinar.
En sistemas de IA el coste real no está en las instancias EC2, sino en los tokens de entrada de RAG y agentes, las llamadas de herramientas encadenadas y los reindexados frecuentes; esos vectores, sumados a los experimentos sin atribución, concentran la mayor parte de la factura mensual en producción.
Un sistema RAG sin evaluación continua se degrada en silencio. Los índices cambian, los modelos se actualizan, los usuarios preguntan cosas nuevas. Este es un repaso práctico de qué métricas vigilar y cómo montar el cuadro de mando que avisa antes del incidente.
Los datos de Crunchbase y CB Insights del primer trimestre confirman que la financiación global ha repuntado, pero casi todo el crecimiento está concentrado en startups que se presentan como IA. El resto del ecosistema sigue en corrección.
La mitad del ecosistema IA de 2024 era una capa fina sobre la API de OpenAI. Dos años después, unos cuantos se han convertido en producto y el resto ha desaparecido. Revisión de qué separa un wrapper serio de un agujero por donde se va el dinero.
Cuando un LLM pasa de contestar texto a ejecutar herramientas, la superficie de ataque cambia de categoría. La inyección de prompts, la contaminación de memoria y el abuso de protocolos entre agentes son el nuevo OWASP Top 10.
Los agentes de IA han pasado de ser un tema de laboratorio a tener SDKs serios en tres grandes proveedores. Reflexión sobre cómo pasar de la demo llamativa a un caso de uso interno que mueva una métrica real.
Desde que Microsoft abrió GraphRAG, el patrón de usar grafos sobre tus propios datos ha pasado de experimento académico a técnica con aplicaciones prácticas. Reflexión sobre cuándo compensa, cómo se monta y qué errores se repiten.
Las funciones de IA que Figma ha ido integrando desde Config 2024 están cambiando cómo trabajan los equipos de diseño de producto. Repaso de qué aporta cada función, qué se mantiene como trabajo humano y qué hábitos están cuajando.
Con las primeras obligaciones del AI Act europeo ya en vigor, la gobernanza de la IA en empresa deja de ser teórica. Qué comités montar, qué políticas escribir y qué auditar, desde la experiencia de varias implantaciones.
9 min285
Usamos cookies propias y de terceros para analizar el tráfico del sitio. Puedes aceptarlas, rechazarlas o configurar tu elección.
Más información sobre las cookies
Preferencias de cookies
NecesariasImprescindibles para el funcionamiento del sitio. Siempre activas.
AnalíticasNos ayudan a entender cómo se usa el sitio (Google Analytics).