Cómo arreglar error: invalid argument: –mlock en llama.cpp
Índice de contenidos
- Puntos clave
- ¿Qué significa error: invalid argument: --mlock?
- ¿Qué versión de llama.cpp quitó --mlock, --no-mmap y --direct-io?
- Las opciones antes y después, copiadas de --help
- ¿Por qué --mlock pasa a mmap+mlock y no a mlock?
- El comando y el docker-compose.yml corregidos
- Cómo comprobar que el modelo está bloqueado en RAM
- El fallo silencioso: mlock sin permiso y variables antiguas
- Preguntas frecuentes
- ¿Puedo seguir usando --mlock si fijo una imagen antigua?
- ¿Qué pongo en lugar de --no-mmap?
- ¿Afecta también a llama-cli y llama-bench?
- Conclusión
- Fuentes
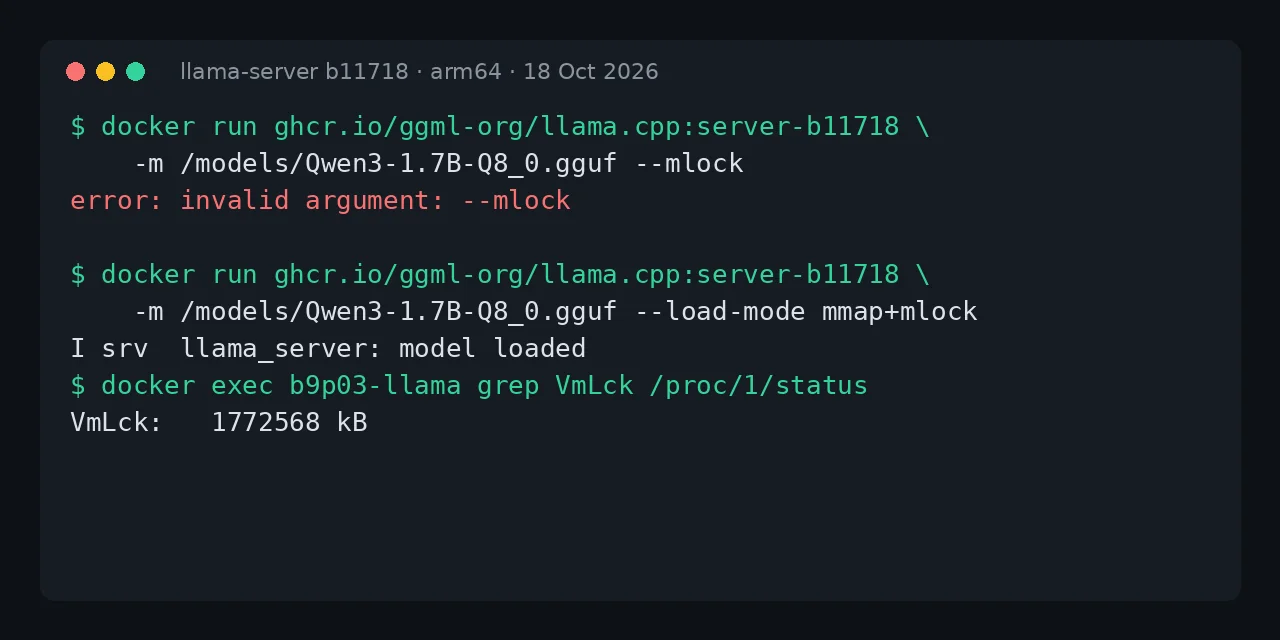
El mensaje error: invalid argument: --mlock aparece porque llama.cpp borró las opciones --mmap, --no-mmap, --mlock y --direct-io en la compilación b10875 (9 de septiembre de 2026), y se arregla cambiándolas por --load-mode. El sustituto de --mlock es --load-mode mmap+mlock, el de --no-mmap es --load-mode none y el de --direct-io es --load-mode dio. Lo reproduje el 18 de octubre de 2026 en Linux arm64 con Docker 29.5.2, la imagen ghcr.io/ggml-org/llama.cpp:server-b11718 y un Qwen3 1.7B en Q8_0 de 1,8 GB. Tienes la versión en inglés de esta guía.
Puntos clave
- Las cinco opciones de carga antiguas (
--mlock,--mmap,--no-mmap,--direct-ioy-dio) devuelveninvalid argumenty el proceso sale con código 1. - La tabla de equivalencias depende de lo que hacía tu
--mlock: desde hace años,--mlocksolo equivalía ammap+mlock, y--no-mmap --mlockequivale amlock. - Las variables
LLAMA_ARG_MLOCK,LLAMA_ARG_MMAPyLLAMA_ARG_DIOya no fallan: el servidor arranca y las ignora. La nueva esLLAMA_ARG_LOAD_MODE. llama-benchtambién cambió:-mmp 0respondeerror: invalid parameter for argument: -mmp.- Con
--load-mode mmap+mlockel proceso bloqueó 1 772 568 kB, el 99 % del archivo del modelo; con un límitememlockde 8 MiB bloqueó 0 y solo dejó un aviso.
¿Qué significa error: invalid argument: –mlock?
Significa que el analizador de argumentos de tu binario ya no conoce esa opción. No hay nada roto en el modelo ni en la imagen: llama.cpp rechaza la línea entera antes de abrir el archivo GGUF. Esta es la salida exacta con la imagen :server del 18 de octubre de 2026, que es la compilación b11718:
$ docker run --rm -v $PWD/models:/models:ro \
    ghcr.io/ggml-org/llama.cpp:server \
    -m /models/Qwen3-1.7B-Q8_0.gguf --mlock
error: invalid argument: --mlock
$ echo $?
1
Las otras opciones de la misma familia fallan igual, cambiando solo el nombre: error: invalid argument: --no-mmap, error: invalid argument: --mmap, error: invalid argument: --direct-io y error: invalid argument: -dio. Como el contenedor sale con código 1, un restart: unless-stopped en Compose lo reinicia en bucle y en docker ps lo verás como Restarting.
¿Qué versión de llama.cpp quitó –mlock, –no-mmap y –direct-io?
La compilación b10875, publicada el 9 de septiembre de 2026, y la primera versión numerada que la incluye es la v0.4.1, del 14 de septiembre. El cambio viene del PR #28334[1], de Aaron Teo, aprobado por Georgi Gerganov. Su autor lo justifica así: "I think it has been a decent amount of time since we deprecated the --mmap, --mlock, and --direct-io flags in favor for --load-mode."
El tiempo de aviso fue de siete semanas. La opción -lm, --load-mode llegó el 23 de julio con el PR #20834[2], que dejó las antiguas como alias obsoletos. Las notas de la v0.4.1[3] lo resumen en una línea: "Removed deprecated --mmap/--mlock/--direct-io args in favor of --load-mode". Para saber si tu imagen está antes o después del corte, mira su número de compilación:
docker run --rm ghcr.io/ggml-org/llama.cpp:server --version
# version: 0.7.0-dev (build 11718, commit 547208dca)
Cualquier compilación igual o superior a 10875 rechaza las opciones antiguas. Comprobé las dos imágenes publicadas más cercanas al corte: server-b10868 aún las acepta con un aviso y server-b10884 ya devuelve invalid argument.
Las opciones antes y después, copiadas de –help
La ayuda de la compilación b10868 todavía listaba las tres opciones marcadas como obsoletas. Esto es lo que imprime llama-server --help en esa imagen, sin recortar:
--mlock          DEPRECATED in favor of `--load-mode`: force system to
                 keep model in RAM rather than swapping or compressing
                 (env: LLAMA_ARG_MLOCK)
--mmap, --no-mmap
                 DEPRECATED in favor of `--load-mode`: whether to
                 memory-map model. (if mmap disabled, slower load but
                 may reduce pageouts if not using mlock)
                 (env: LLAMA_ARG_MMAP)
-dio,  --direct-io, -ndio, --no-direct-io
                 DEPRECATED in favor of `--load-mode`: use DirectIO if
                 available
                 (env: LLAMA_ARG_DIO)
He estrechado la columna de la izquierda en este bloque y en el siguiente para que quepan; el texto es el original. En la b11718 esas tres entradas han desaparecido y solo queda la opción nueva, con sus seis modos:
-lm,   --load-mode MODE   model loading mode (default: auto)
  - auto: mmap, unless a device does not support it
  - none: no special loading mode
  - mmap: memory-map model (if mmap disabled, slower load but may
    reduce pageouts if not using mlock)
  - mlock: force system to keep model in RAM rather than swapping
    or compressing
  - mmap+mlock: mmap + force system to keep model in RAM rather
    than swapping or compressing
  - dio: use DirectIO if available

  (env: LLAMA_ARG_LOAD_MODE)
Para revisar tu propia imagen sin arrancar nada, filtra la ayuda: docker run --rm tu_imagen --help | grep -A12 load-mode.
¿Por qué –mlock pasa a mmap+mlock y no a mlock?
Porque antes del cambio el mapeo en memoria (mmap) estaba activo por defecto, así que --mlock solo significaba "mapea el archivo y bloquéalo en RAM". Lo comprobé en el código de la compilación b8100: use_mmap vale true por defecto y --mlock solo pone use_mlock = true. El modo mlock de --load-mode hace otra cosa: bloquea sin mapear, igual que la antigua combinación --no-mmap --mlock.
Aquí está la confusión que vas a encontrar en otras guías. Durante las seis semanas finales de vida del alias, --mlock cambió de significado: el PR #26135[4], del 27 de julio, lo redirigió al modo mlock sin mapeo. La b10868 lo confirma en su log con DEPRECATED: --mlock is deprecated. use --load-mode mlock instead, y en /proc/1/maps no aparecía el archivo del modelo. Si tu línea de órdenes viene de antes de julio, la equivalencia fiel es mmap+mlock.
La tabla completa, con las variables de entorno que usan las imágenes de Docker:
| Antes (hasta b10874) | Ahora (b10875 o posterior) |
|---|---|
| Ninguna opción | -lm auto (valor por defecto, no hace falta escribirlo) |
--mmap |
-lm mmap |
--no-mmap |
-lm none |
--mlock |
-lm mmap+mlock |
--no-mmap --mlock |
-lm mlock |
--direct-io, -dio |
-lm dio |
--no-direct-io, -ndio |
Quítala |
LLAMA_ARG_MLOCK=1 |
LLAMA_ARG_LOAD_MODE=mmap+mlock |
LLAMA_ARG_MMAP=0 |
LLAMA_ARG_LOAD_MODE=none |
llama-bench -mmp 0 |
llama-bench -lm none |
La incidencia #26110[5] explica por qué existe el modo mlock. Sin él, quien llevaba a la CPU los expertos de un modelo de mezcla de expertos (MoE) con --n-cpu-moe perdía la única combinación que no agotaba la memoria.
El comando y el docker-compose.yml corregidos
El arreglo consiste en cambiar una opción por otra, y en Docker conviene además fijar la compilación. Esta es la orden que antes fallaba, ya corregida:
docker run -d --name llama -p 8080:8080 \
  --ulimit memlock=-1 \
  -v $PWD/models:/models:ro \
  ghcr.io/ggml-org/llama.cpp:server-b11718 \
  -m /models/Qwen3-1.7B-Q8_0.gguf \
  --load-mode mmap+mlock -c 4096 --host 0.0.0.0 --port 8080
La opción --ulimit memlock=-1 quita el límite de memoria bloqueable del contenedor. En Compose el equivalente es la clave ulimits, documentada en la referencia de servicios de Compose[6]. Este es el archivo que levanté con docker compose up -d:
services:
  llama:
    image: ghcr.io/ggml-org/llama.cpp:server-b11718
    command: >
      -m /models/Qwen3-1.7B-Q8_0.gguf
      --load-mode mmap+mlock
      -c 4096 --host 0.0.0.0 --port 8080
    ulimits:
      memlock: -1
    volumes:
      - ./models:/models:ro
    ports:
      - "8080:8080"
El servidor respondió {"status":"ok"} en /health, /props devolvió b11718-547208dca como build_info y una petición a /v1/chat/completions contestó Hola.. Si prefieres variables de entorno, cambia la línea de --load-mode por LLAMA_ARG_LOAD_MODE: "mmap+mlock" dentro de environment; lo probé y bloquea la misma memoria.
Cómo comprobar que el modelo está bloqueado en RAM
El estado del proceso lo dice sin interpretar logs: el campo VmLck de /proc/<pid>/status cuenta los kilobytes bloqueados con mlock. En la imagen, llama-server es el PID 1:
docker exec llama grep VmLck /proc/1/status
# VmLck:   1772568 kB
El archivo del modelo pesa 1 834 426 016 bytes, es decir, 1 791 432 KiB, así que mmap+mlock bloqueó el 99 % de él. Medí los cuatro modos con el mismo modelo, -c 2048 y sin límite de memlock:
El modo mlock sin mapeo solo bloqueó 316 MiB en esta prueba, solo CPU, y no he investigado qué búferes cubre. Si lo que buscas es que los pesos no vayan al swap, mide VmLck con tu modelo antes de dar el cambio por bueno.
El fallo silencioso: mlock sin permiso y variables antiguas
Hay dos situaciones en las que el servidor arranca sin error y aun así no bloquea nada. La primera es un límite memlock bajo: con --ulimit memlock=8388608:8388608, llama.cpp solo dejó este aviso y siguió con VmLck a 0:
W warning: failed to mlock 336572416-byte buffer (after previously
locking 0 bytes): Cannot allocate memory
Try increasing RLIMIT_MEMLOCK ('ulimit -l' as root).
La página de manual de mlock(2)[7] explica la regla: un proceso sin la capacidad CAP_IPC_LOCK no puede bloquear más que su límite RLIMIT_MEMLOCK, y Docker no concede esa capacidad por defecto. En este equipo, con OrbStack, el límite ya era ilimitado; en otro motor puede no serlo, así que declara memlock: -1 siempre.
La segunda es una variable de entorno con el nombre viejo. Con LLAMA_ARG_MLOCK=1 o LLAMA_ARG_MMAP=0, la b11718 arrancó, respondió ok en /health y dejó VmLck a 0 sin imprimir nada. Una opción en la línea de órdenes falla con ruido; una variable obsoleta en environment falla en silencio, así que revisa también tus archivos .env.
Preguntas frecuentes
¿Puedo seguir usando –mlock si fijo una imagen antigua?
Sí, cualquier compilación anterior a la b10875 la acepta con un aviso, por ejemplo ghcr.io/ggml-org/llama.cpp:server-b10868. Te quedas sin las correcciones posteriores, y la b11718 lleva 850 compilaciones más. Cambiar una opción cuesta menos que mantener una imagen congelada.
¿Qué pongo en lugar de –no-mmap?
--load-mode none, o LLAMA_ARG_LOAD_MODE=none en el entorno. Es la equivalencia que confirmó el autor del cambio en el PR #20834, y en mi prueba el archivo del modelo dejó de aparecer en /proc/1/maps.
¿Afecta también a llama-cli y llama-bench?
Sí. llama cli, el binario unificado de la imagen, rechaza las mismas opciones con una mayúscula de diferencia: Error: invalid argument: --no-mmap. llama-bench tiene el suyo: en la b10868 marcaba -mmp, --mmap <0|1> y -dio, --direct-io <0|1> como obsoletas, y en la b11718 -mmp 0 termina con error: invalid parameter for argument: -mmp. Usa -lm con los mismos valores.
Conclusión
error: invalid argument: --mlock no es un fallo del modelo ni de Docker: es la retirada de tres opciones que llevaban siete semanas marcadas como obsoletas. Cambia --mlock por --load-mode mmap+mlock, --no-mmap por --load-mode none y --direct-io por --load-mode dio, renombra las variables LLAMA_ARG_* y comprueba VmLck antes de dar el arreglo por bueno. Fija además la etiqueta server-bNNNNN para que la próxima retirada no te llegue sin avisar.
Si estás montando llama.cpp desde cero, empieza por la guía de cómo instalar llama.cpp en Linux, macOS y Docker. Si lo usas como backend de tus aplicaciones, mira llama-server como API compatible con OpenAI en Docker. Para elegir el archivo GGUF, la guía de cuantización de modelos y llama.cpp explica qué ocupa cada formato.
Fuentes: [1] llama.cpp, PR #28334: retirada de las opciones mmap, mlock y dio[1], [2] llama.cpp, notas de la v0.4.1[3], [3] llama.cpp, compilación b10875[8], [4] llama.cpp, PR #20834: introducción de –load-mode[2], [5] llama.cpp, PR #26135: modo mlock sin mmap[4], [6] llama.cpp, incidencia #26110 sobre –n-cpu-moe[5], [7] Docker, referencia de servicios de Compose (ulimits)[6], [8] Linux man-pages, mlock(2)[7], [9] llama.cpp, imágenes en GitHub Container Registry[9].
Fuentes
Código fuente
Accede a todo el código fuente de este artículo en GitHub.
Ver en GitHub