Cómo instalar llama.cpp en Linux, macOS y Docker
Índice de contenidos
- Puntos clave
- Qué versión de llama.cpp instalar: estable o nocturna
- Cómo instalar llama.cpp con el instalador de llama.app
- Cómo instalar llama.cpp en macOS con Homebrew
- Cómo ejecutar llama.cpp con Docker
- Cómo compilar llama.cpp desde el código fuente
- Cómo descargar un modelo GGUF con -hf
- Cómo chatear con el modelo usando llama cli
- Cómo servir el modelo con llama serve como API compatible con OpenAI
- Cuánto rinde llama.cpp en CPU sin GPU
- Qué cambia en la v0.4.1 si vienes de una versión anterior
- Preguntas frecuentes
- ¿llama.cpp necesita una GPU?
- ¿Dónde guarda llama.cpp los modelos que descarga con -hf?
- ¿Qué canal de instalación elijo para un servidor?
- Conclusión
- Fuentes
Hay cuatro formas oficiales de instalar llama.cpp y el 14 de septiembre de 2026 no daban la misma versión. El instalador de llama.app deja una compilación nocturna, Homebrew empaqueta la versión estable anterior, Docker te deja fijar la etiqueta y CMake compila lo que clones. Probé las cuatro en contenedores limpios sobre Linux arm64, ejecuté Gemma 4 E2B con llama cli y lo serví como API compatible con OpenAI con llama serve.
Esta guía recoge los comandos que funcionaron, el fallo del instalador que encontré por el camino y qué canal elegir según el uso. Tienes también la versión en inglés de esta guía.
Puntos clave
- La versión estable es la v0.4.1, etiquetada el 14 de septiembre de 2026. Las etiquetas
bNNNNson compilaciones nocturnas: ese mismo día se crearon 10. curl -LsSf https://llama.app/install.sh | shinstala un único binariollamade 15 MB en~/.local/bin. En Debian 13 arm64 sin el paquetezstd, falla conVersion mismatch.- En Docker, fija
ghcr.io/ggml-org/llama.cpp:server-v0.4.1. La etiqueta:serverapuntaba a la compilación nocturna b10969. -hf usuario/repositorio:Q4_0descarga el GGUF a~/.cache/huggingface/hub. Sin la etiqueta de cuantización, el programa busca Q4_K_M y después Q8_0.- La v0.4.1 elimina
--mmapy--mlock; su sustituto es--load-mode. - En CPU, con 4 hilos y la máquina compartida, Gemma 4 E2B en Q4_0 generó 41,92 tokens/s de mediana en
llama-bench.
Qué versión de llama.cpp instalar: estable o nocturna
Instala la v0.4.1 salvo que necesites un modelo o una corrección que aún no ha llegado a ella. Desde agosto de 2026 llama.cpp publica dos canales. Las etiquetas vX.Y.Z siguen el versionado semántico y empezaron con la v0.1.0 el 17 de agosto; las etiquetas bNNNN de siempre se crean casi en cada commit a master. Las notas de la v0.2.0, del 21 de agosto, lo anuncian así:
"This version marks the beginning of consistent semantic versioning for llama.cpp." (notas de la versión v0.2.0 de llama.cpp, ggml-org)
Las mismas notas recomiendan las vX.Y.Z para distribuir y para el uso casual, y las bNNNN para desarrolladores que quieren lo último aunque sea menos estable. La v0.4.1 corresponde al commit b29c606, el mismo que la nocturna b10964. Añade Maple 20B-A1B, Tencent Hy 4 y Spark2.5, sube ggml de la 0.23.0 a la 0.24.0 y elimina tres opciones de carga. El problema práctico es que cada canal te entrega otra cosa, y esto es lo que instaló cada uno el 14 de septiembre de 2026:
| Canal | Qué instaló | Tipo | Probado aquí |
|---|---|---|---|
| Instalador de llama.app | 0.4.0-dev, build 10909 | Nocturna | Sí, Debian 13 arm64 |
Homebrew, fórmula llama.cpp |
0.4.0, build 10809 | Estable | Sí, Linux arm64 |
Docker :server |
b10969 | Nocturna | Solo inspección de la imagen |
Docker :server-v0.4.1 |
0.4.1-dev, build 10964 | Estable | Sí, arm64 |
CMake con --branch v0.4.1 |
0.4.1 | Estable | Sí, Ubuntu 24.04 arm64 |
winget, paquete ggml.llamacpp |
b10951, Vulkan x64 | Nocturna | No, sin Windows |
La documentación del proceso de publicación[1] todavía dice que el instalador descarga binarios compilados desde la etiqueta de la versión. Ese día, su puntero latest devolvía b10909, del 11 de septiembre. El proyecto lo mantiene ggml-org, el equipo de Georgi Gerganov, que se unió a Hugging Face[2] el 20 de febrero de 2026. El 3 de septiembre NVIDIA anunció un acuerdo para comprar Hugging Face[3].
Cómo instalar llama.cpp con el instalador de llama.app
El instalador oficial deja un único ejecutable estático, llama, en ~/.local/bin y no modifica tus ficheros de arranque de la shell. Antes de canalizar un script a sh conviene leerlo. El de llama.app[4] tiene 225 líneas y hace esto:
- Detecta la arquitectura (
aarch64ox86_64) y el sistema (Linux, macOS o FreeBSD). - Pide la versión
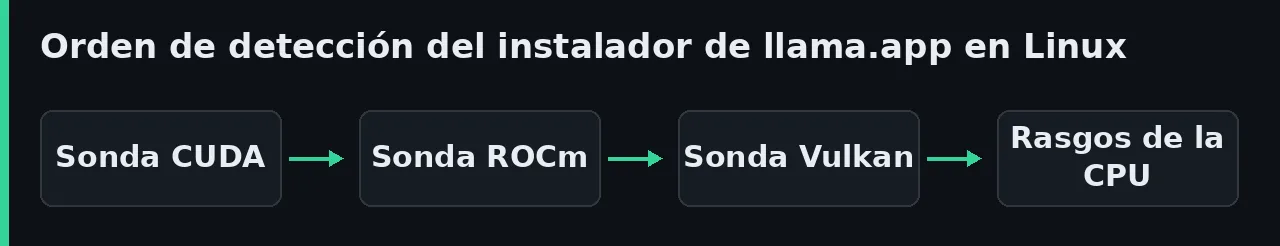
latestal bucketggml-org/install.shde Hugging Face, salvo que fijes la variableLLAMA_VERSION. - En Linux prueba, por este orden, CUDA, ROCm, Vulkan y los rasgos de la CPU; en macOS busca un chip M1 a M5 o A18 para usar Metal.
- Descarga el binario en
~/.llama-app, comprueba quellama versioncoincide con lo pedido y lo copia a~/.local/bin/llama.
En un contenedor limpio de Debian 13 arm64, con curl como única dependencia instalada, el script falló así:
Version: b10909
Probing CUDA...
Downloading cuda-probe...
Probing ROCm...
Downloading rocm-probe...
Found:
Downloading llama...
Version mismatch: expected b10909, got
La causa está en el propio script. El bucket no tiene sonda de ROCm para aarch64 y curl -f falla, pero la tubería termina en el descompresor que el script descarga cuando falta zstd, y ese descompresor devuelve 0 con la entrada vacía. El script da por buena una sonda de 0 bytes, pide el binario de una configuración vacía y termina con un llama que también ocupa 0 bytes. Con el zstd del sistema, la descompresión vacía devuelve error y el script pasa a Vulkan y a la CPU:
sudo apt-get install -y curl zstd
curl -LsSf https://llama.app/install.sh | sh
llama version
La segunda ejecución tardó 4 s, detectó fp16, dotprod, i8mm y sme en la CPU e instaló la compilación nocturna, no la v0.4.1:
Probing CPU...
Found: fp16
Found: dotprod
Found: i8mm
Found: sme
Downloading llama...
Installation completed successfully

version: 0.4.0-dev (build 10909, commit a2878d30d)
built with Clang 22.1.8 for Linux aarch64
El binario ocupa 15 MB y ldd responde "not a dynamic executable". Agrupa las herramientas como subcomandos: serve, cli, download y update aparecen en llama help, y bench, quantize, perplexity o completion en llama help all. Según el código de app/llama.cpp, llama update vuelve a ejecutar el script y solo existe en los binarios instalados así. Para desinstalar, borra ~/.llama-app y ~/.local/bin/llama, y los modelos de ~/.cache/huggingface/hub si ya no los quieres.
Cómo instalar llama.cpp en macOS con Homebrew
En un Mac con Apple Silicon, brew install llama.cpp instala la versión estable empaquetada, y la guía de compilación[5] indica que Metal va activado por defecto en macOS. No tengo un Mac para esta prueba, así que esta parte es documentación contrastada y no una ejecución. La fórmula de Homebrew[6] estaba en la 0.4.0, construida desde la etiqueta v0.4.0, con botellas precompiladas para Apple Silicon, Linux arm64 y Linux x86_64.
brew install llama.cpp
llama-server --version
La misma fórmula sí la probé en Linux arm64 con Homebrew 7.0.1. La instalación tardó 35 s, pero arrastró 28 dependencias, entre ellas gcc 16.2.0 (416 MB) y OpenBLAS, y el prefijo de Homebrew, con el propio Homebrew dentro, acabó en 1,2 GB. Instala llama junto a los binarios clásicos (llama-server, llama-cli, llama-bench) y respondió version: 0.4.0 (build 10809, commit 5266f24da). La v0.4.1 se etiquetó el mismo día de la prueba y aún no había llegado a la fórmula.
El instalador de llama.app también sirve en macOS, pero solo con Apple Silicon: la sonda lee machdep.cpu.brand_string y acepta de M1 a M5 o A18. En un Mac con Intel el script termina con "No prebuilt llama binary is available for your system", y te quedan Homebrew, el zip macOS Intel (x64) de la página de versiones o compilar. Si en el Mac buscas otra pila, compara con Ollama en macOS con Apple Silicon y con oMLX, el servidor basado en MLX.
Cómo ejecutar llama.cpp con Docker
Para un servidor, la imagen server es la opción con menos piezas: 295 MB de descarga, solo llama-server dentro y variantes para linux/amd64, linux/arm64 y linux/s390x. Fija la etiqueta de la versión.
El 14 de septiembre, :server llevaba la etiqueta de versión b10969, mientras que :server-v0.4.1 compartía digest con :server-b10964, el commit de la v0.4.1. Las v0.2.0, v0.3.0 y v0.4.0 no tienen etiqueta de imagen; la primera es la de la v0.4.1, que también existe como server-cuda-v0.4.1 y server-vulkan-v0.4.1.
docker run -d --name llama-server \
  -p 127.0.0.1:8080:8080 \
  -v "$HOME/modelos:/models:ro" \
  ghcr.io/ggml-org/llama.cpp:server-v0.4.1 \
  -m /models/gemma-4-E2B-it-Q4_0.gguf -t 4 \
  --api-key tu_clave_de_api
La imagen ejecuta llama-server como root, escucha en 0.0.0.0 porque define LLAMA_ARG_HOST y trae un healthcheck contra /health. Con --api-key, /health sigue respondiendo 200 sin clave y /v1/models devuelve 401. El binario se presenta como 0.4.1-dev porque la imagen se compila con el valor por defecto LLAMA_BUILD_IS_DEV=ON.
Si prefieres que el contenedor descargue el modelo, monta un volumen para la caché. Así el GGUF sobrevive a docker rm:
docker run -d --name llama-hf -p 127.0.0.1:8080:8080 \
  -v "$HOME/llama-cache:/cache" -e LLAMA_CACHE=/cache \
  ghcr.io/ggml-org/llama.cpp:server-v0.4.1 \
  -hf ggml-org/Qwen3.5-0.8B-GGUF -t 4
Descargar y cargar Qwen3.5 0.8B llevó 24 s hasta el primer 200 de /health, y los ficheros quedaron con propietario root en el volumen. Según la documentación de Docker del proyecto[7], las variantes -cuda, -cuda13 y -vulkan existen para amd64 y arm64, y las de ROCm, SYCL (-intel), MUSA y OpenVINO solo para amd64. No las probé: esta máquina no tiene GPU.
Cómo compilar llama.cpp desde el código fuente
Compila cuando necesites un backend concreto (CUDA, Vulkan, ROCm) o una rama sin publicar. Estos son los pasos que ejecuté en un contenedor de Ubuntu 24.04 limitado a 8 CPU:
sudo apt-get install -y build-essential cmake git libssl-dev
git clone --depth 1 --branch v0.4.1 \
  https://github.com/ggml-org/llama.cpp
cd llama.cpp
cmake -B build -DLLAMA_BUILD_IS_DEV=OFF
cmake --build build --config Release -j 8
Los paquetes tardaron 36 s, el clon 4 s, la configuración 3 s y la compilación 125 s. La carga media era de 47,65 sobre 18 núcleos, porque la máquina tenía otros trabajos en marcha. En build/bin quedan 32 MB con llama, llama-cli, llama-server y llama-bench, entre otros. La opción -DLLAMA_BUILD_IS_DEV=OFF hace que la versión sea 0.4.1 y no 0.4.1-dev, como pide el documento de publicación a quien distribuye binarios.
El --depth 1 tiene un coste que no está documentado. CMake calcula el número de compilación con git rev-list --count HEAD, así que mi binario dijo version: 0.4.1 (build 1, commit b29c606). Con la opción por defecto LLAMA_USE_PREBUILT_UI=ON, la compilación descarga además la interfaz web del bucket ggml-org/llama-ui según ese número: b1 no existe y CMake cayó a latest. En un clon completo, git rev-list --count v0.4.1 devuelve 10964 y b10964 sí está en el bucket, así que quita --depth 1 si quieres la interfaz que corresponde a la versión.
Para GPU, la guía indica -DGGML_CUDA=ON para NVIDIA y -DGGML_VULKAN=ON para Vulkan. En macOS, Metal se compila por defecto y se desactiva con -DGGML_METAL=OFF. Ninguna de las tres rutas está probada aquí.
Cómo descargar un modelo GGUF con -hf
-hf acepta usuario/repositorio:cuantización y guarda el GGUF en la caché estándar de Hugging Face, compartida con otras herramientas. Leído en common/hf-cache.cpp de la v0.4.1, el orden para elegir la carpeta es LLAMA_CACHE, HF_HUB_CACHE, HUGGINGFACE_HUB_CACHE, HF_HOME/hub, XDG_CACHE_HOME/huggingface/hub y, por último, ~/.cache/huggingface/hub.
llama download -hf ggml-org/Qwen3.5-0.8B-GGUF
La etiqueta de cuantización importa. La ayuda dice que, sin ella, se usa Q4_K_M o "the first file in the repo", pero el código prueba Q4_K_M, después Q8_0 y solo entonces el primer fichero. Como ggml-org/Qwen3.5-0.8B-GGUF no tiene Q4_K_M, el comando anterior bajó Qwen3.5-0.8B-Q8_0.gguf (795 MB) en 13 s.
En ggml-org/gemma-4-E2B-it-GGUF pasa lo mismo: sin etiqueta te llevarías 4,97 GB en Q8_0 en lugar de 2,84 GB en Q4_0. Escribe la cuantización:
llama serve -hf ggml-org/gemma-4-E2B-it-GGUF:Q4_0
Si el repositorio incluye un proyector multimodal (mmproj), -hf también lo descarga; --no-mmproj lo evita. Con Gemma 4 E2B, ese comando bajó además mmproj-gemma-4-E2B-it-Q8_0.gguf (557 MB), y el servidor arrancó con visión, vídeo y audio activados. Para un fichero que ya tienes en disco, usa -m ruta/al/modelo.gguf.
Para saber cuánta memoria ocupan un modelo multimodal y su proyector, lee la cuenta de VRAM de los modelos multimodales en una tarjeta de 16 GB. Para estimar tu caso, usa la calculadora de modelos de lenguaje locales.
Cómo chatear con el modelo usando llama cli
llama cli abre un chat en la terminal; con -st y -p responde una sola vez y sale. Con el fichero gemma-4-E2B-it-Q4_0.gguf (2,84 GB) descargado de ggml-org, lo lancé así:
llama cli -m gemma-4-E2B-it-Q4_0.gguf -t 4 \
  --reasoning off -st -n 160 \
  -p "Explica en dos frases qué es un fichero GGUF."
La respuesta llegó en 4 s, con las velocidades que imprime el propio llama cli al final:
Un fichero GGUF es un formato de archivo diseñado específicamente para
almacenar modelos de inteligencia artificial de lenguaje (como los LLMs)
de manera eficiente y optimizada para la ejecución local en hardware de
consumo. Permite que los modelos se carguen rápidamente y se utilicen con
una alta capacidad de cuantización, lo que reduce el tamaño del archivo y
el consumo de memoria sin sacrificar demasiado la calidad.

[ Prompt: 104.8 t/s | Generation: 44.8 t/s ]
Dos detalles salieron en la prueba. La plantilla de Gemma 4 activa el razonamiento con el valor por defecto --reasoning auto, y mi primera ejecución, sin --reasoning off, abrió con [Start thinking] y gastó los tokens pensando.
El segundo es el número de hilos. Sin -t y con una carga media de 33 a 39 en la máquina compartida, el modelo no terminó de procesar la pregunta en 60 s; con -t 4 respondió en 4 s. Si el equipo tiene otros procesos pesados, fija -t por debajo del número de núcleos.
Cómo servir el modelo con llama serve como API compatible con OpenAI
llama serve levanta en 127.0.0.1:8080 una API compatible con OpenAI y una interfaz web de chat. En la imagen Docker el mismo servidor se llama llama-server, un nombre que también instalan Homebrew y la compilación desde código. Arráncalo con clave si alguien más puede llegar al puerto:
llama serve -m gemma-4-E2B-it-Q4_0.gguf -t 4 \
  --api-key tu_clave_de_api
La petición es la misma que harías a la API de OpenAI, con la clave en la cabecera Authorization:
curl -s http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer tu_clave_de_api" \
  -d '{"messages": [{"role": "user",
       "content": "Resume en una frase para qué sirve llama.cpp."}],
       "max_tokens": 120, "reasoning_effort": "none"}'
La respuesta trae, además del texto, un bloque timings con las velocidades medidas por el servidor. Con la compilación v0.4.1, esta petición repetida tres veces generó 40,76, 37,65 y 40,56 tokens/s, con una carga media de 23,71. Contra la imagen server-v0.4.1, con carga de 20,29, dio 32,54, 34,83 y 33,05 tokens/s.
En otra prueba sin "reasoning_effort": "none" y con max_tokens a 200, Gemma 4 gastó los 200 tokens en reasoning_content y devolvió content vacío con finish_reason: length. La alternativa es arrancar el servidor con --reasoning off.
El servidor imprime dos avisos que conviene leer. Sin --api-key avisa de que CORS admite cualquier origen y no hay clave. También anuncia que el puerto por defecto pasará a 9931 en una versión futura (PR 26508[8]), así que escribe --port 8080 en scripts y healthchecks.
En memoria, con el contexto por defecto del modelo (131072 tokens repartidos en 4 ranuras), llama serve ocupó 5,2 GB de RSS. Con -c 8192 se quedó en 4,4 GB.
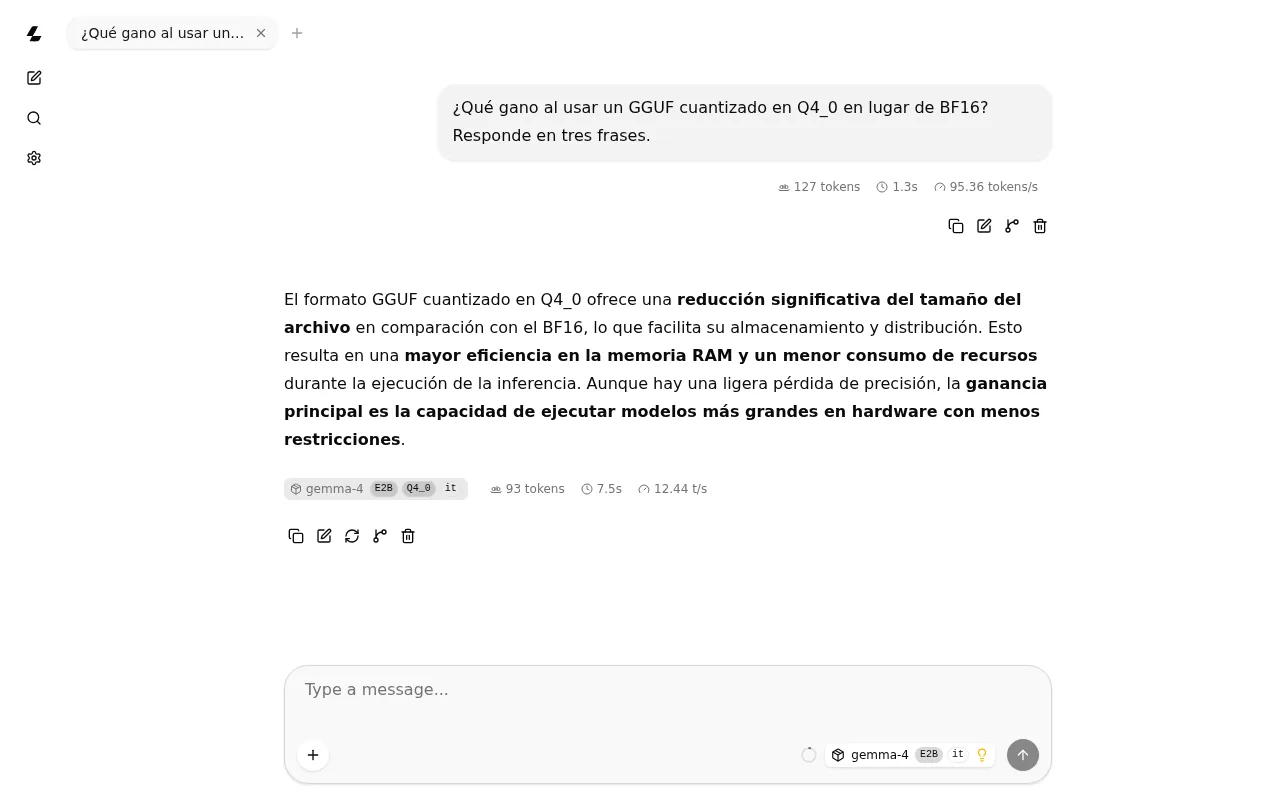
La interfaz web está en la raíz del servidor y muestra por mensaje los tokens, el tiempo y la velocidad. Los 12,44 tokens/s de la captura corresponden a un momento de carga alta en la máquina compartida. Para servir en GPU con concurrencia alta, compara con vLLM en producción.
Cuánto rinde llama.cpp en CPU sin GPU
En esta prueba, Gemma 4 E2B en Q4_0 generó 41,92 tokens/s de mediana con 4 hilos de CPU. El equipo es una máquina virtual Linux arm64 sobre Apple silicon, con 18 núcleos, 121 GB de RAM y sin GPU, compartida con otros trabajos; el contenedor tenía un límite de 8 CPU. Ejecuté llama-bench tres veces, cada una con 5 repeticiones:
llama-bench -m gemma-4-E2B-it-Q4_0.gguf -t 4 -p 128 -n 128 -r 5
| Medida | Ejecución 1 | Ejecución 2 | Ejecución 3 | Mediana |
|---|---|---|---|---|
| Prompt de 128 tokens (tokens/s) | 139,17 | 146,66 | 129,77 | 139,17 |
| Generación de 128 tokens (tokens/s) | 41,92 | 43,73 | 38,45 | 41,92 |
| Carga media a 1 minuto al empezar | 31,07 | 24,34 | 21,58 | 24,34 |
llama-bench informa de 2,63 GiB y 4,63 B de parámetros para este GGUF.
El número depende de lo que haga el resto de la máquina. A través del servidor y con los mismos 4 hilos, el binario del instalador dio 40,72 tokens/s de mediana con una carga de 30. La imagen Docker bajó a entre 2,58 y 4,05 tokens/s cuando la carga subió a 45. Si quieres entender por qué llama.cpp rinde así en CPU, repasa las optimizaciones de llama.cpp que analizamos en 2024.
Qué cambia en la v0.4.1 si vienes de una versión anterior
Las notas de la v0.4.1[9] traen cuatro cambios de comportamiento que afectan a scripts y despliegues de versiones anteriores:
--mmap,--mlocky--direct-io: eliminadas. La imagen v0.4.1 respondeerror: invalid argument: --mlock. Usa--load-modeconauto(mmap salvo que el dispositivo no lo admita),none,mmap,mlock,mmap+mlockodio--reasoning-preserve: activada por defecto; conserva el razonamiento en todo el historial con las plantillas que lo admiten- Dispositivos de
mmprojy del modelo borrador: siguen la selección global de--device - Carga diferida de tensores: desactivada por defecto en GPU integradas
El binario unificado llama es anterior: llegó con el PR 23296, fusionado el 20 de mayo de 2026. llama serve equivale a llama-server y llama cli a llama-cli. La compilación desde código y Homebrew instalan las dos formas; la imagen server, solo llama-server.
Preguntas frecuentes
¿llama.cpp necesita una GPU?
No. En esta prueba, Gemma 4 E2B en Q4_0 generó 41,92 tokens/s con 4 hilos de una CPU arm64. Con GPU, usa las variantes CUDA, Vulkan o ROCm de la imagen Docker, compila con -DGGML_CUDA=ON o -DGGML_VULKAN=ON, o deja que el instalador de llama.app detecte CUDA, ROCm o Vulkan.
¿Dónde guarda llama.cpp los modelos que descarga con -hf?
En Linux, en la caché de Hugging Face, ~/.cache/huggingface/hub/models--usuario--repositorio/, salvo que definas LLAMA_CACHE, HF_HUB_CACHE o HF_HOME. llama cli -cl lista los modelos que ya tienes en caché.
¿Qué canal de instalación elijo para un servidor?
Docker con la etiqueta fijada server-v0.4.1, --api-key y el puerto publicado solo en 127.0.0.1 o detrás de un proxy inverso. Actualizas cambiando la etiqueta, y la versión no se mueve sola como ocurre con :server o con el instalador.
Conclusión
Para un portátil con Linux, el instalador de llama.app es la vía con menos pasos si instalas zstd antes y aceptas una compilación nocturna. Para un servidor, fija server-v0.4.1 en Docker; en un Mac, usa Homebrew; y para un backend de GPU concreto, compila la etiqueta v0.4.1 con el historial completo. Con el modelo en marcha, el siguiente paso es elegir bien el tamaño y la cuantización del modelo. Si prefieres Ollama como capa de gestión encima, Gemma 4 con Ollama en tu propio equipo ejecuta la misma familia de modelos allí.
Fuentes
- documentación del proceso de publicación
- se unió a Hugging Face
- NVIDIA anunció un acuerdo para comprar Hugging Face
- llama.app
- guía de compilación
- fórmula de Homebrew
- documentación de Docker del proyecto
- PR 26508
- notas de la v0.4.1
- Notas de la versión v0.2.0 de llama.cpp: inicio del versionado semántico
- Referencia de opciones de llama-server
- Guía rápida de llama.app
Código fuente
Accede a todo el código fuente de este artículo en GitHub.
Ver en GitHub